O caminho desta parte
- Questionar o substitutoa escala de comprimento decide o que ele acha
- Modelar as boas tentativasdensidades do TPE; espaços define-by-run do Optuna
- Podar e dividir a apostaparar uma tentativa cedo; os brackets do Hyperband
- O pipeline inteiroCASH, sistemas de AutoML, o resto do trabalho
As hipóteses do substituto importam
As quatro iterações da parte fundamental, refeitas a partir de 100 trios iniciais aleatórios, 30 avaliações cada, com a otimização bayesiana e com a busca aleatória. Fração das rodadas que chegaram a 0,81:
| em até 10 | em até 20 | em até 30 | |
|---|---|---|---|
| bayesiana, escala de comprimento 0,15 | 40% | 65% | 65% |
| bayesiana, escala de comprimento 0,10 | 61% | 92% | 92% |
| busca aleatória | 37% | 54% | 65% |
TPE: modelar \(x\) dado o escore
- Tree-structured Parzen Estimator: separe as tentativas nas boas (a melhor fração \(\gamma\)) e no resto.
- Densidade dos valores bons \(\ell(x)\), densidade dos outros \(g(x)\): uma lombada gaussiana por tentativa.
- Amostre onde \(\ell(x)/g(x)\) é maior (Bergstra et al., 2011).
| \(x\) | 0,1 | 0,25 | 0,5 | 0,7 | 0,9 |
|---|---|---|---|---|---|
| \(\ell / g\) | 0,03 | 1,24 | 0,45 | 5,73 | 0,09 |
Optuna: TPE contra busca aleatória, medido
Seis hiperparâmetros: um importa muito, um importa pouco, quatro não importam nada. Melhor possível: 0,870. 20 sementes.
| melhor médio depois de | 10 | 20 | 40 | 60 tentativas |
|---|---|---|---|---|
| aleatória | 0,812 | 0,819 | 0,830 | 0,843 |
| TPE | 0,812 | 0,847 | 0,857 | 0,860 |
Idênticos em 10: as 10 primeiras tentativas do TPE são aleatórias. Depois de 40, ele está acima do que a busca aleatória alcança depois de 60.
Define-by-run: o espaço de busca é código
def build(trial):
    family = trial.suggest_categorical('family', ['logistic', 'boosting'])
    if family == 'logistic':
        C = trial.suggest_float('C', 1e-3, 1e2, log=True)
        return make_pipeline(FunctionTransformer(np.log1p), StandardScaler(),
                             LogisticRegression(C=C, max_iter=2000))
    return HistGradientBoostingClassifier(
        learning_rate=trial.suggest_float('learning_rate', 0.01, 0.5, log=True), ...)
C ≈ 0,03, 0,798, empatada com o boosting escolhido à mão; o TPE gastou 31 das 40 tentativas nela. Um espaço que deixa de fora o modelo simples nunca vai poder lhe dizer que você não precisava do complicado.Poda: pare cedo uma tentativa ruim
- O objetivo informa a média corrente depois de cada fold (
trial.report). - O podador pela mediana para uma tentativa pior do que a mediana das tentativas anteriores no mesmo fold.
Hyperband: vários torneios
Quão agressivo deve ser o torneio do halving sucessivo? O Hyperband roda brackets de agressividade diferente, cada um custando mais ou menos o mesmo (Li et al., 2018).
| bracket | rodadas (configurações × orçamento) | custo |
|---|---|---|
| s = 3 | 27 × 1 → 9 × 3 → 3 × 9 → 1 × 27 | 108 |
| s = 2 | 12 × 3 → 4 × 9 → 1 × 27 | 99 |
| s = 1 | 6 × 9 → 2 × 27 | 108 |
| s = 0 | 4 × 27 (busca aleatória pura) | 108 |
AutoML de pipeline completo: o problema CASH
Combined Algorithm Selection and Hyperparameter optimization: seleção do algoritmo e dos hiperparâmetros juntos (Thornton et al., 2013).
| sistema | como busca | o que devolve |
|---|---|---|
| auto-sklearn | otimização bayesiana, com partida a quente a partir de conjuntos de dados parecidos | um ensemble (ensemble selection) |
| TPOT | programação genética sobre árvores de pipeline | o melhor pipeline, como código scikit-learn |
| AutoGluon-Tabular | pouca busca: bagging e empilhamento em várias camadas | um ensemble empilhado |
| FLAML | atenta ao custo: configurações baratas primeiro | o melhor modelo único num orçamento de tempo |
O resto do trabalho
formular o problema
o que é previsto, para quem, em que momento e quanto custa um erro
escolher a métrica
84,5% dos módulos do kc1 são limpos: uma busca por acurácia aprova um modelo que nunca aponta nada
o desenho da validação
grupos, ordem no tempo e vazamentos são explorados pela busca, não corrigidos
dados e atributos
remover uma coluna vazada mudou a precisão média em 0,18; o ajuste, em 0,007
E a implantação: um ensemble empilhado de 40 modelos pode ser o mais difícil de servir, explicar e retreinar.
Um padrão prático
- Tranque um conjunto de teste e fixe um único
cv. - Baselines primeiro: um dummy, um modelo linear, um boosting com os valores padrão.
- Busca aleatória ou Optuna, de 30 a 100 tentativas, escalas log, o modelo simples no espaço.
- Para dados grandes ou modelos lentos: halving ou poda, com uma unidade de orçamento que não interaja com os botões.
- Pare quando o melhor escore deixar de se mover mais do que o próprio desvio-padrão entre folds.
- Relate o escore de teste trancado ou uma CV aninhada da busca inteira, nunca o melhor escore da própria busca.
Quatro buscas, um orçamento: passos 6 a 10
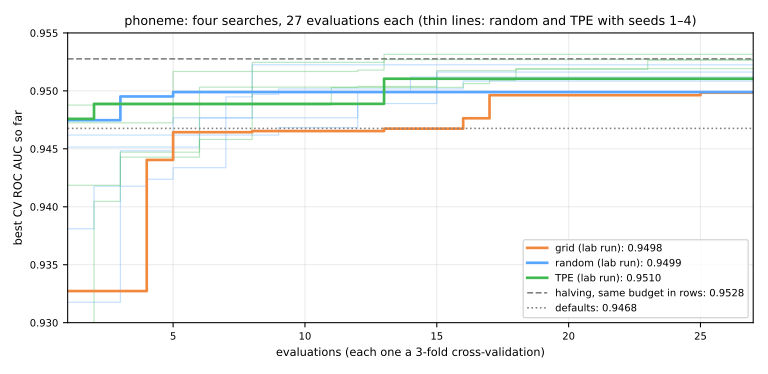
phoneme, continuação: o TPE com Optuna e o halving sucessivo se juntam à grade e à busca aleatória dos passos 4 e 5, com o mesmo orçamento.
Escolhido pelo escore de validação cruzada (CV): o vencedor do halving, CV 0,9528, área sob a curva ROC (ROC AUC) de teste 0,9455; os valores padrão caem o mesmo tanto (0,9468 → 0,9374).
Busca aleatória: best_score_ 0,9499; estimativa aninhada 0,9472 ± 0,0067.
Mesmo notebook do lab, a partir do passo 6 (!pip install optuna). Simulações: árvores como orçamento (passo 7) e os valores padrão nos mesmos folds externos (passo 10).
Ritmo: passos 6, 7 e a primeira simulação em 15 min; 8 e 9 em 10 min; passo 10 e a segunda em 10 min.