A pergunta que nenhuma aula fez
- Todo modelo vem com botões; Seleção de Modelos explicou o que eles fazem, Validação Cruzada como comparar os resultados com honestidade.
- Uma grade com 5 hiperparâmetros e 5 valores cada: 3.125 validações cruzadas, a maioria em regiões que já se mostravam ruins depois das primeiras doze.
otimização de hiperparâmetros
trata a própria busca como um problema de otimização
AutoML (aprendizado de máquina automatizado)
leva a mesma ideia ao pipeline inteiro: pré-processamento, família, hiperparâmetros, o ensemble final
O caminho desta parte
- Enquadrar a buscauma caixa-preta cara e ruidosa; o espaço de busca
- Grade ou aleatóriaBergstra & Bengio, medido
- Uma busca que aprendeum substituto e a melhoria esperada
- Cortar tentativas ruinshalving sucessivo e a sua unidade de orçamento
- Conferir o que ela entregavazamentos e um escore otimista
Uma chamada à caixa-preta
\(\lambda\): uma configuração. \(f(\lambda)\): o seu escore de validação cruzada (CV). Ajustar = encontrar o \(\lambda\) com o maior \(f(\lambda)\).
- kc1: 2.109 módulos de software de um sistema de voo da NASA, 21 métricas de código; alvo: um defeito foi encontrado depois? (15,5% com defeito)
- Uma chamada = a área sob a curva ROC (ROC AUC) em CV 5-fold de um modelo de boosting.
Cara, ruidosa e uma caixa-preta
| ajustes | 5 embaralhamentos dos folds | média |
|---|---|---|
| valores padrão | 0,760 · 0,776 · 0,767 · 0,769 · 0,769 | 0,768 |
| árvores pequenas e lentas | 0,795 · 0,806 · 0,804 · 0,803 · 0,805 | 0,803 |
cara
cada chamada são 5 ajustes; num projeto real, minutos ou horas. O orçamento é o número de chamadas.
ruidosa
de 0,760 a 0,776 para os mesmos ajustes: uma diferença de 0,01 talvez não seja real
caixa-preta
não há gradiente em relação a min_samples_leaf; inteiros, categorias, botões condicionais
Desenhando o espaço (1): a escala
| taxa de aprendizado em | uniforme | log-uniforme |
|---|---|---|
| [0,001; 0,01) | 0,9% | 33,5% |
| [0,01; 0,1) | 9,1% | 33,2% |
| [0,1; 1) | 90,0% | 33,3% |
À mão: \(0{,}009 / 0{,}999 = 0{,}9\%\); na escala log, cada uma das 3 décadas recebe um terço.
C, alpha, número de folhas ou de vizinhos) ganha escala log: loguniform ou log=True no Optuna.Desenhando o espaço (2): botões condicionais
Cpertence à regressão logística,max_leaf_nodesao boosting,gammaa um kernel RBF (de base radial).- Uma grade única sobre todos eles combinaria cada
Ccom cada tamanho de árvore: a mesma regressão logística, ajustada repetidamente.
if.Grade ou aleatória? O argumento
- Um escore que depende de um hiperparâmetro \(x_1\) (uma lombada de largura 0,05); os outros \(d - 1\) não fazem nada.
- Uma grade com \(k\) valores por eixo custa \(k^d\) avaliações, mas testa \(x_1\) em apenas \(k\) valores.
- A busca aleatória com orçamento \(B\) testa \(x_1\) em \(B\) valores, qualquer que seja \(d\).
Grade ou aleatória? Medido em 4.000 problemas
| d | orçamento | grade | aleatória |
|---|---|---|---|
| 2 | 9 | 0,378 | 0,629 |
| 2 | 81 | 0,824 | 0,985 |
| 3 | 27 | 0,378 | 0,900 |
| 4 | 81 | 0,378 | 0,986 |
| 4 | 256 | 0,501 | 0,998 |
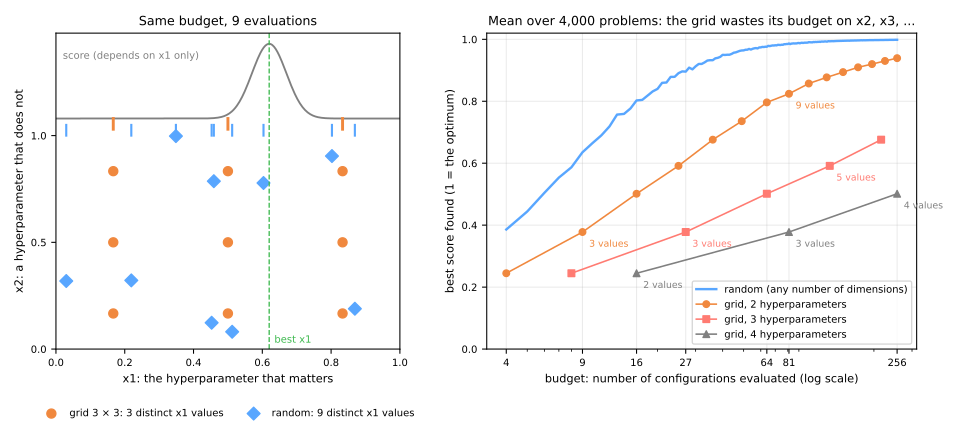
Melhor escore médio. A grade paga cada eixo irrelevante com uma multiplicação do seu custo; a busca aleatória não paga nada (Bergstra & Bengio, 2012).
Simulador: mesmo orçamento, buscas diferentes
Preveja. Orçamento 81: quantos valores distintos de \(x_1\) a grade 9 × 9 testa e quantos a busca aleatória testa?
Otimização bayesiana: uma busca que aprende
A busca aleatória sorteia a 27.ª configuração exatamente como a primeira. Quando cada avaliação custa uma hora, isso é desperdício.
- ajuste um modelo substituto barato aos pares (configuração, escore) vistos até agora: ele prevê o escore em qualquer ponto, com uma incerteza;
- escolha a próxima configuração maximizando uma função de aquisição: exploração local (escore previsto alto) contra exploração (incerteza alta);
- avalie, acrescente ao histórico, repita.
Um escore de mentira, com verdade conhecida: um pico largo de 0,78 em 0,25 e outro, mais alto e mais estreito, de 0,82 em 0,72.
O substituto: um processo gaussiano (GP)
Três avaliações até agora: 0,15 e 0,35 (0,72943), 0,95 (0,700). Melhor até agora: \(f^+ = 0{,}72943\).
| \(x\) | média \(\mu\) | dp \(\sigma\) | leitura |
|---|---|---|---|
| 0,25 | 0,73076 | 0,00419 | entre dois pontos: quase certo, logo acima de \(f^+\) |
| 0,55 | 0,72212 | 0,01246 | longe de qualquer ponto: abaixo de \(f^+\), três vezes mais incerto |
| 0,72 | 0,71390 | 0,01318 | o pico verdadeiro, mas o substituto não sabe nada dele |
Melhoria esperada (EI): a fórmula
Se o escore em \(x\) fosse uma variável normal com a média \(\mu\) e o desvio-padrão \(\sigma\) do substituto, quanto ele superaria, em média, o melhor escore até agora, \(f^+\)? Não superar conta como zero.
\[ \mathrm{EI}(x) = \underbrace{(\mu - f^+)\,\Phi(z)}_{\text{exploração local}} + \underbrace{\sigma\,\varphi(z)}_{\text{exploração}}, \qquad z = \frac{\mu - f^+}{\sigma} \]\(\Phi\): a distribuição acumulada da normal padrão; \(\varphi\): a sua densidade. O primeiro termo premia uma média prevista alta; o segundo, uma incerteza grande. EI vem do inglês expected improvement.
Melhoria esperada, à mão: quatro iterações
As três avaliações acima, 201 candidatas entre 0 e 1, um substituto com escala de comprimento 0,15. Preveja. Depois que a iteração 1 avaliar 0,25, para onde vai a iteração 2, e por quê?
Halving sucessivo: um torneio
A maioria das configurações ruins se mostra ruim cedo: depois de poucas árvores ou treinada em poucas linhas (Jamieson & Talwalkar, 2016).
- comece \(n = 27\) configurações com um orçamento pequeno (10 árvores cada);
- fique com o melhor terço (\(\eta = 3\));
- dê aos sobreviventes 3 × mais orçamento; repita até sobrar uma.
HalvingRandomSearchCV.Halving sucessivo, rodada por rodada
As mesmas 27 configurações de boosting no kc1, com o orçamento contado em árvores (10 → 270) ou em linhas (60 → 1.620). Preveja. O vencedor de qual torneio vai ficar mais bem colocado quando as 27 forem pontuadas com o orçamento completo?
Ele otimiza o vazamento que você deu
bug_reports: preenchida depois do lançamento; o modelo precisa apontar módulos arriscados antes do lançamento, quando a contagem é zero para todo mundo.
| ROC AUC | |
|---|---|
| melhor CV, sem a coluna / com ela | 0,792 / 0,916 |
| teste, vencedor com vazamento, coluna preenchida | 0,962 |
| teste, vencedor honesto | 0,804 |
teste, vencedor com vazamento, como será usado (bug_reports = 0) | 0,782 |
Toda verificação automática passa. O vazamento está nos dados: só quem sabe quando cada coluna é registrada consegue pegá-lo.
Uma busca mais longa sobreajusta os dados de validação
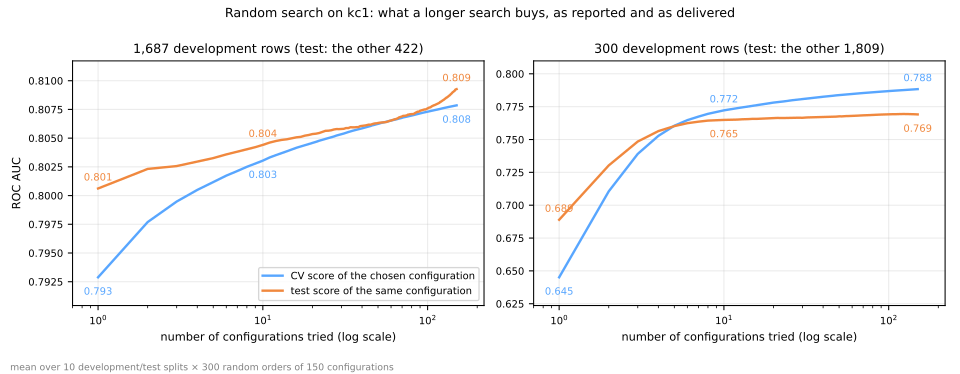
1.687 linhas, de 10 para 150 tentativas: CV de 0,803 para 0,808, teste de 0,804 para 0,809. Honesto.
300 linhas: CV de 0,772 para 0,788, teste de 0,765 para 0,769. Três quartos do ganho relatado são sorte.
Resumo
- Ajustar é uma caixa-preta cara e ruidosa: o orçamento é o número de chamadas.
- Desenhe o espaço primeiro: escalas log e botões condicionais.
- A busca aleatória vence a grade quando só alguns botões importam.
- A otimização bayesiana aprende onde olhar: a melhoria esperada pondera uma média alta contra uma incerteza grande.
- O halving sucessivo corta cedo as tentativas ruins, se a ordem cedo prevê a final: a unidade de orçamento importa.
- Uma busca otimiza seus vazamentos e a própria sorte: avalie-a em dados intocados.
Grade ou aleatória, nas vogais: passos 1 a 5
- phoneme: 5.404 vogais, orais ou nasais, cada uma descrita por 5 amplitudes de harmônicos; um modelo de boosting com parada antecipada, avaliado pelo ROC AUC.
- Tranque um conjunto de teste, defina as baselines, escreva o espaço de busca e ponha uma grade 3 × 3 × 3 contra a busca aleatória com as mesmas 27 avaliações.
- Notebook do lab (Jupyter ou Colab, Arquivo → Fazer upload de notebook); a partir do passo 6 ele precisa de
!pip install optuna. - Em cada passo, responda ao Preveja antes de rodar.
- Simulações: uma grade montada em volta do botão que importa (passo 4) e o vencedor em folds novos (passo 5).
Ritmo: passos 1 a 3 em 10 min; passo 4 e a primeira simulação em 10 min; passo 5 e a segunda em 10 min.