A pergunta que nenhuma aula fez
- Todo modelo vem com botões; Seleção de Modelos explicou o que eles fazem, Validação Cruzada como comparar os resultados com honestidade.
- Uma grade com 5 hiperparâmetros e 5 valores cada: 3.125 validações cruzadas, a maioria em regiões que já se mostravam ruins depois das primeiras doze.
otimização de hiperparâmetros
trata a própria busca como um problema de otimização
AutoML (aprendizado de máquina automatizado)
leva a mesma ideia ao pipeline inteiro: pré-processamento, família, hiperparâmetros, o ensemble final
O caminho desta aula
- Enquadrar a buscauma caixa-preta cara e ruidosa; o espaço de busca
- Grade ou aleatóriaBergstra & Bengio, medido
- Uma busca que aprendeotimização bayesiana, estimador de Parzen, Optuna
- Cortar tentativas ruinspoda, halving sucessivo, Hyperband
- Automatizar e conferiro pipeline inteiro, vazamentos, um escore otimista
Uma chamada à caixa-preta
\(\lambda\): uma configuração. \(f(\lambda)\): o seu escore de validação cruzada (CV). Ajustar = encontrar o \(\lambda\) com o maior \(f(\lambda)\).
- kc1: 2.109 módulos de software de um sistema de voo da NASA, 21 métricas de código; alvo: um defeito foi encontrado depois? (15,5% com defeito)
- Uma chamada = a área sob a curva ROC (ROC AUC) em CV 5-fold de um modelo de boosting.
Cara, ruidosa e uma caixa-preta
| ajustes | 5 embaralhamentos dos folds | média |
|---|---|---|
| valores padrão | 0,760 · 0,776 · 0,767 · 0,769 · 0,769 | 0,768 |
| árvores pequenas e lentas | 0,795 · 0,806 · 0,804 · 0,803 · 0,805 | 0,803 |
cara
cada chamada são 5 ajustes; num projeto real, minutos ou horas. O orçamento é o número de chamadas.
ruidosa
de 0,760 a 0,776 para os mesmos ajustes: uma diferença de 0,01 talvez não seja real
caixa-preta
não há gradiente em relação a min_samples_leaf; inteiros, categorias, botões condicionais
Desenhando o espaço (1): a escala
| taxa de aprendizado em | uniforme | log-uniforme |
|---|---|---|
| [0,001; 0,01) | 0,9% | 33,5% |
| [0,01; 0,1) | 9,1% | 33,2% |
| [0,1; 1) | 90,0% | 33,3% |
À mão: \(0{,}009 / 0{,}999 = 0{,}9\%\); na escala log, cada uma das 3 décadas recebe um terço.
C, alpha, número de folhas ou de vizinhos) ganha escala log: loguniform ou log=True no Optuna.Desenhando o espaço (2): botões condicionais
Cpertence à regressão logística,max_leaf_nodesao boosting,gammaa um kernel RBF (de base radial).- Uma grade única sobre todos eles combinaria cada
Ccom cada tamanho de árvore: a mesma regressão logística, ajustada repetidamente.
if.Grade ou aleatória? O argumento
- Um escore que depende de um hiperparâmetro \(x_1\) (uma lombada de largura 0,05); os outros \(d - 1\) não fazem nada.
- Uma grade com \(k\) valores por eixo custa \(k^d\) avaliações, mas testa \(x_1\) em apenas \(k\) valores.
- A busca aleatória com orçamento \(B\) testa \(x_1\) em \(B\) valores, qualquer que seja \(d\).
Grade ou aleatória? Medido em 4.000 problemas
| d | orçamento | grade | aleatória |
|---|---|---|---|
| 2 | 9 | 0,378 | 0,629 |
| 2 | 81 | 0,824 | 0,985 |
| 3 | 27 | 0,378 | 0,900 |
| 4 | 81 | 0,378 | 0,986 |
| 4 | 256 | 0,501 | 0,998 |
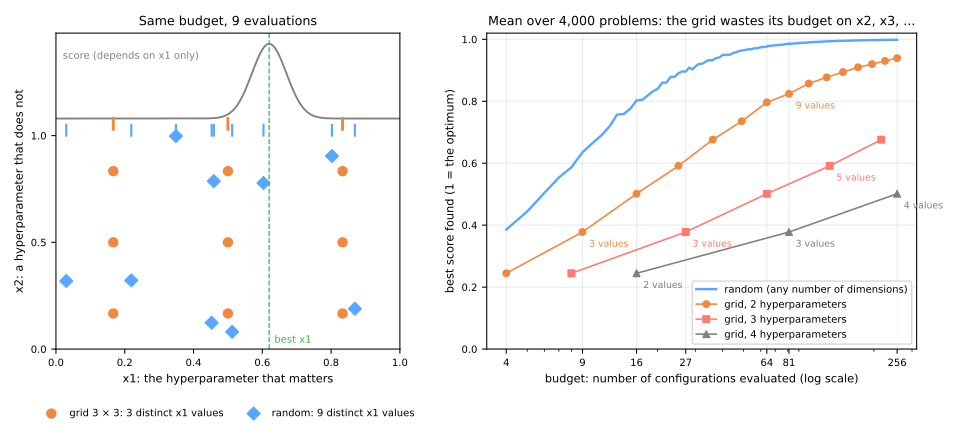
Melhor escore médio. A grade paga cada eixo irrelevante com uma multiplicação do seu custo; a busca aleatória não paga nada (Bergstra & Bengio, 2012).
Simulador: mesmo orçamento, buscas diferentes
Preveja. Orçamento 81: quantos valores distintos de \(x_1\) a grade 9 × 9 testa e quantos a busca aleatória testa?
Otimização bayesiana: uma busca que aprende
A busca aleatória sorteia a 27.ª configuração exatamente como a primeira. Quando cada avaliação custa uma hora, isso é desperdício.
- ajuste um modelo substituto barato aos pares (configuração, escore) vistos até agora: ele prevê o escore em qualquer ponto, com uma incerteza;
- escolha a próxima configuração maximizando uma função de aquisição: exploração local (escore previsto alto) contra exploração (incerteza alta);
- avalie, acrescente ao histórico, repita.
Um escore de mentira, com verdade conhecida: um pico largo de 0,78 em 0,25 e outro, mais alto e mais estreito, de 0,82 em 0,72.
O substituto: um processo gaussiano (GP)
Três avaliações até agora: 0,15 e 0,35 (0,72943), 0,95 (0,700). Melhor até agora: \(f^+ = 0{,}72943\).
| \(x\) | média \(\mu\) | dp \(\sigma\) | leitura |
|---|---|---|---|
| 0,25 | 0,73076 | 0,00419 | entre dois pontos: quase certo, logo acima de \(f^+\) |
| 0,55 | 0,72212 | 0,01246 | longe de qualquer ponto: abaixo de \(f^+\), três vezes mais incerto |
| 0,72 | 0,71390 | 0,01318 | o pico verdadeiro, mas o substituto não sabe nada dele |
Melhoria esperada (EI), à mão
\[ \mathrm{EI}(x) = \underbrace{(\mu - f^+)\,\Phi(z)}_{\text{exploração local}} + \underbrace{\sigma\,\varphi(z)}_{\text{exploração}}, \qquad z = \frac{\mu - f^+}{\sigma} \]| \(x\) | \(z\) | \((\mu - f^+)\Phi(z)\) | \(\sigma\varphi(z)\) | EI |
|---|---|---|---|---|
| 0,25 | +0,32 | +0,00083 | 0,00159 | 0,00242 |
| 0,55 | −0,59 | −0,00203 | 0,00417 | 0,00214 |
| 0,72 | −1,18 | −0,00185 | 0,00262 | 0,00077 |
Quatro iterações
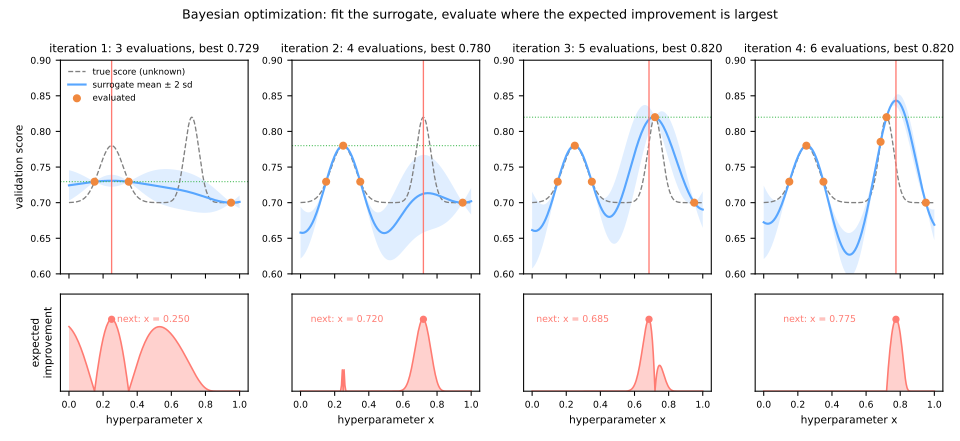
1: explora localmente 0,25 → 0,780. 2: a EI ali desaba, então ela explora o vão → 0,72, 0,820. 3–4: refinam em 0,685 e 0,775. A busca aleatória precisaria de uns 28 sorteios para cair tão perto de 0,72.
As hipóteses do substituto importam
100 rodadas a partir de trios iniciais aleatórios, 30 avaliações cada. Fração das rodadas que chegaram a 0,81:
| em até 10 | em até 20 | em até 30 | |
|---|---|---|---|
| bayesiana, escala de comprimento 0,15 | 40% | 65% | 65% |
| bayesiana, escala de comprimento 0,10 | 61% | 92% | 92% |
| busca aleatória | 37% | 54% | 65% |
TPE: modelar \(x\) dado o escore
- Tree-structured Parzen Estimator: separe as tentativas nas boas (a melhor fração \(\gamma\)) e no resto.
- Densidade dos valores bons \(\ell(x)\), densidade dos outros \(g(x)\): uma lombada gaussiana por tentativa.
- Amostre onde \(\ell(x)/g(x)\) é maior (Bergstra et al., 2011).
| \(x\) | 0,1 | 0,25 | 0,5 | 0,7 | 0,9 |
|---|---|---|---|---|---|
| \(\ell / g\) | 0,03 | 1,24 | 0,45 | 5,73 | 0,09 |
Optuna: TPE contra busca aleatória, medido
Seis hiperparâmetros: um importa muito, um importa pouco, quatro não importam nada. Melhor possível: 0,870. 20 sementes.
| melhor médio depois de | 10 | 20 | 40 | 60 tentativas |
|---|---|---|---|---|
| aleatória | 0,812 | 0,819 | 0,830 | 0,843 |
| TPE | 0,812 | 0,847 | 0,857 | 0,860 |
Idênticos em 10: as 10 primeiras tentativas do TPE são aleatórias. Depois de 40, ele está acima do que a busca aleatória alcança depois de 60.
Define-by-run: o espaço de busca é código
def build(trial):
    family = trial.suggest_categorical('family', ['logistic', 'boosting'])
    if family == 'logistic':
        C = trial.suggest_float('C', 1e-3, 1e2, log=True)
        return make_pipeline(FunctionTransformer(np.log1p), StandardScaler(),
                             LogisticRegression(C=C, max_iter=2000))
    return HistGradientBoostingClassifier(
        learning_rate=trial.suggest_float('learning_rate', 0.01, 0.5, log=True), ...)
C ≈ 0,03, 0,798, empatada com o boosting escolhido à mão; o TPE gastou 31 das 40 tentativas nela. Um espaço que deixa de fora o modelo simples nunca vai poder lhe dizer que você não precisava do complicado.Poda: pare cedo uma tentativa ruim
- O objetivo informa a média corrente depois de cada fold (
trial.report). - O podador pela mediana para uma tentativa pior do que a mediana das tentativas anteriores no mesmo fold.
Halving sucessivo: um torneio
Comece \(n = 27\) configurações com um orçamento pequeno; fique com o melhor terço; dê aos sobreviventes 3 × mais; repita.
| rodada | configurações | árvores cada | custo |
|---|---|---|---|
| 1 | 27 | 10 | 270 |
| 2 | 9 | 30 | 270 |
| 3 | 3 | 90 | 270 |
| 4 | 1 | 270 | 270 |
| total | 1.080 |
HalvingRandomSearchCV).O que o torneio supõe
A ordem depois de um orçamento pequeno prevê a ordem depois do orçamento completo. Dois torneios: orçamento em árvores, orçamento em linhas.
| vencedor, orçamento em | escore completo | posição |
|---|---|---|
| árvores | 0,781 | 13.º de 27 |
| linhas | 0,787 | 5.º de 27 |
| melhor com o orçamento completo | 0,791 | 1.º |
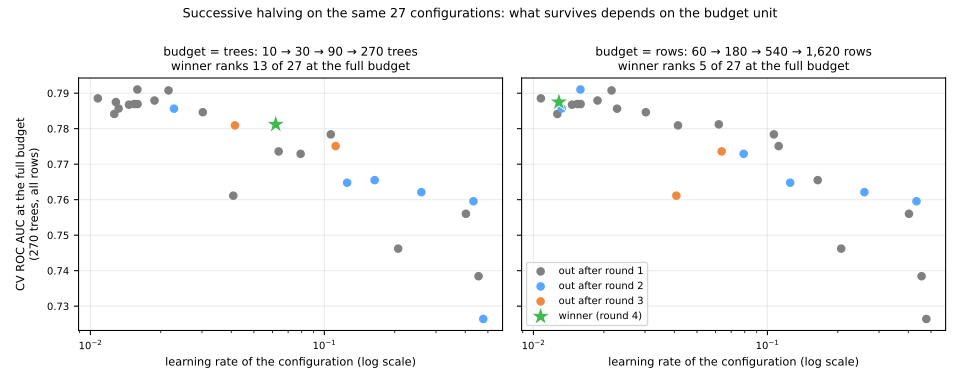
Com uma taxa de aprendizado pequena, 10 árvores mal começaram: quem aprende devagar, o melhor com 270 árvores, foi todo eliminado na rodada 1.
Hyperband: vários torneios
Quão agressivo deve ser o torneio? O Hyperband roda brackets de agressividade diferente, cada um custando mais ou menos o mesmo (Li et al., 2018).
| bracket | rodadas (configurações × orçamento) | custo |
|---|---|---|
| s = 3 | 27 × 1 → 9 × 3 → 3 × 9 → 1 × 27 | 108 |
| s = 2 | 12 × 3 → 4 × 9 → 1 × 27 | 99 |
| s = 1 | 6 × 9 → 2 × 27 | 108 |
| s = 0 | 4 × 27 (busca aleatória pura) | 108 |
AutoML de pipeline completo: o problema CASH
Combined Algorithm Selection and Hyperparameter optimization: seleção do algoritmo e dos hiperparâmetros juntos (Thornton et al., 2013).
| sistema | como busca | o que devolve |
|---|---|---|
| auto-sklearn | otimização bayesiana, com partida a quente a partir de conjuntos de dados parecidos | um ensemble (ensemble selection) |
| TPOT | programação genética sobre árvores de pipeline | o melhor pipeline, como código scikit-learn |
| AutoGluon-Tabular | pouca busca: bagging e empilhamento em várias camadas | um ensemble empilhado |
| FLAML | atenta ao custo: configurações baratas primeiro | o melhor modelo único num orçamento de tempo |
Ele otimiza o vazamento que você deu
bug_reports: preenchida depois do lançamento; o modelo precisa apontar módulos arriscados antes do lançamento, quando a contagem é zero para todo mundo.
| ROC AUC | |
|---|---|
| melhor CV, sem a coluna / com ela | 0,792 / 0,916 |
| teste, vencedor com vazamento, coluna preenchida | 0,962 |
| teste, vencedor honesto | 0,804 |
teste, vencedor com vazamento, como será usado (bug_reports = 0) | 0,782 |
Toda verificação automática passa. O vazamento está nos dados: só quem sabe quando cada coluna é registrada consegue pegá-lo.
Uma busca mais longa sobreajusta os dados de validação
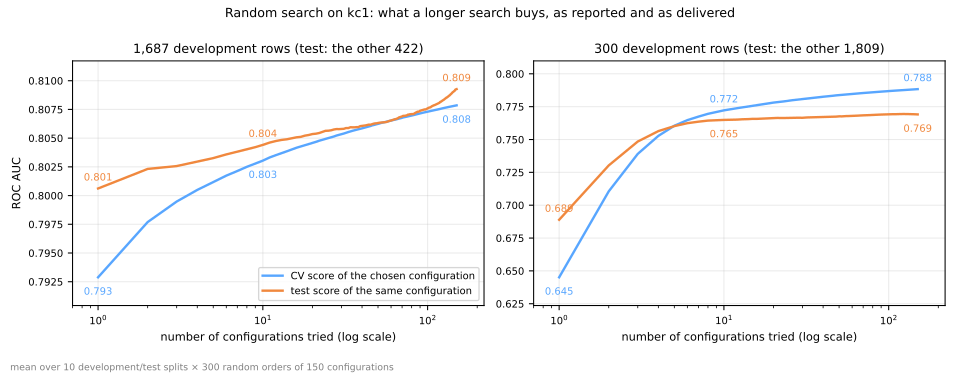
1.687 linhas, de 10 para 150 tentativas: CV de 0,803 para 0,808, teste de 0,804 para 0,809. Honesto.
300 linhas: CV de 0,772 para 0,788, teste de 0,765 para 0,769. Três quartos do ganho relatado são sorte.
O resto do trabalho
formular o problema
o que é previsto, para quem, em que momento e quanto custa um erro
escolher a métrica
84,5% dos módulos do kc1 são limpos: uma busca por acurácia aprova um modelo que nunca aponta nada
o desenho da validação
grupos, ordem no tempo e vazamentos são explorados pela busca, não corrigidos
dados e atributos
remover uma coluna vazada mudou a precisão média em 0,18; o ajuste, em 0,007
E a implantação: um ensemble empilhado de 40 modelos pode ser o mais difícil de servir, explicar e retreinar.
Um padrão prático
- Tranque um conjunto de teste e fixe um único
cv. - Baselines primeiro: um dummy, um modelo linear, um boosting com os valores padrão.
- Busca aleatória ou Optuna, de 30 a 100 tentativas, escalas log, o modelo simples no espaço.
- Para dados grandes ou modelos lentos: halving ou poda, com uma unidade de orçamento que não interaja com os botões.
- Pare quando o melhor escore deixar de se mover mais do que o próprio desvio-padrão entre folds.
- Relate o escore de teste trancado ou uma CV aninhada da busca inteira, nunca o melhor escore da própria busca.
Quatro buscas, um orçamento
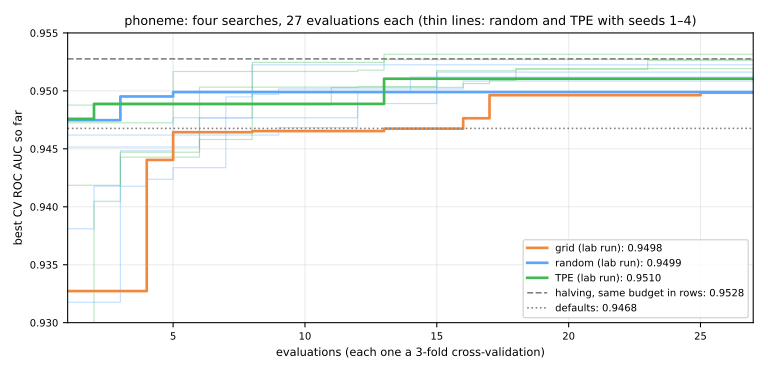
phoneme: 5.404 vogais, orais ou nasais. Grade, busca aleatória, TPE e halving recebem 27 avaliações cada.
Escolhido (melhor CV): o vencedor do halving, CV 0,9528, teste 0,9455; os valores padrão caem o mesmo tanto (0,9468 → 0,9374).
Busca aleatória: best_score_ 0,9499; estimativa aninhada 0,9472 ± 0,0067.
Rode !pip install optuna antes. Notebook do lab (Jupyter ou Colab, Arquivo → Fazer upload de notebook).
Resumo
- Ajustar é uma caixa-preta cara e ruidosa: o orçamento é o número de chamadas.
- Desenhe o espaço: escalas log e botões condicionais.
- A busca aleatória vence a grade quando só alguns botões importam.
- Otimização bayesiana e TPE aprendem onde olhar; as hipóteses deles importam.
- Halving e Hyperband param cedo as configurações ruins, se a ordem inicial estiver certa.
- Uma busca otimiza seus vazamentos e a própria sorte: avalie-a em dados intocados.