Métricas de Classificação
As duas últimas aulas construíram dois classificadores — a regressão logística e o k-NN — e avaliaram ambos com um único número: a acurácia, ao lado de uma baseline DummyClassifier. Esse número esconde quase tudo o que importa. Ele não diz quais erros o modelo comete. Em medicina, finanças ou segurança, os dois tipos de erro raramente custam o mesmo. Esta aula abre a caixa. Cada métrica é calculada à mão em um exemplo pequeno que você pode conferir com uma calculadora; depois, o scikit-learn confirma cada número.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula no Colab; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Quais erros o modelo comete e como medir cada um? | O que quebra essas métricas e qual delas escolher? |
| conteúdo | matriz de confusão, acurácia e o paradoxo dela, precisão, revocação, especificidade, FPR, VPN, limiar, F1 | F-beta, prevalência, acurácia balanceada e MCC, multiclasse, log loss e Brier, como escolher |
| lab em aula | triagem de diabetes, passos 1 a 7 | probabilidades, limiar e multiclasse, passos 8 a 11 |
| ao final, você sabe | ler uma matriz de confusão; calcular cada métrica à mão e no scikit-learn; dizer qual pergunta cada uma responde | prever o efeito da prevalência; escolher entre F1, F2, MCC e log loss; ler um relatório multiclasse |
Os dois labs usam o mesmo notebook no Colab: a parte fundamental vai do passo 1 ao 7; a avançada, do 8 ao 11. Tudo roda no navegador; não é preciso baixar nada.
Abordagem fundamental
Uma pergunta guia esta parte: quais erros o modelo comete e como medir cada um? Tudo sai de uma tabela 2×2 com quatro contagens; cada métrica é uma razão entre elas e cada uma responde a uma pergunta diferente em palavras simples.
Depois de uma palavra sobre por que as métricas importam, a parte segue quatro etapas, desenhadas abaixo: 1. contar os erros numa matriz de confusão; 2. a acurácia não basta e o paradoxo dela mostra por quê; 3. uma pergunta por métrica, cada uma lendo uma linha ou uma coluna; 4. mexer no limiar e resumir precisão e revocação com o F1. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Contar os erros20 pacientes, quatro grupos, a matriz de confusão
- Acurácia não bastaa fração de acertos e o seu paradoxo
- Uma pergunta por métricaprecisão, revocação, especificidade e as outras: uma linha ou uma coluna cada
- Limiar e F1mover a linha troca um erro pelo outro; o F1 resume os dois
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Por que uma aula sobre métricas
Um classificador comete dois tipos de erro, que não são simétricos:
- um câncer não detectado (o modelo diz "saudável" a um paciente doente) pode custar uma vida; um exame de acompanhamento desnecessário (o modelo diz "doente" a um saudável) custa dinheiro e um susto;
- um cartão bloqueado (uma compra legítima marcada como fraude) custa um telefonema e um cliente irritado; uma fraude aprovada custa o valor inteiro.
A acurácia conta os dois erros como se fossem o mesmo. Escolher uma métrica é escolher qual erro você aceita cometer com mais frequência; um modelo ajustado pela métrica errada otimiza, em silêncio, o comportamento errado. O resto da aula dá a cada pergunta o seu próprio número.
2. O exemplo que nos acompanha: 20 pacientes
Etapa 1. Vinte pacientes foram encaminhados a um especialista. Um modelo (pense na regressão logística de duas aulas atrás) deu a cada um deles um escore (a probabilidade prevista de doença); exames posteriores revelaram quem estava de fato doente. Em ordem de escore:
| id | escore | doente | id | escore | doente | |
|---|---|---|---|---|---|---|
| P01 | 0,95 | 1 | P11 | 0,40 | 0 | |
| P02 | 0,90 | 1 | P12 | 0,35 | 1 | |
| P03 | 0,85 | 1 | P13 | 0,30 | 0 | |
| P04 | 0,80 | 1 | P14 | 0,25 | 0 | |
| P05 | 0,75 | 0 | P15 | 0,20 | 1 | |
| P06 | 0,70 | 1 | P16 | 0,15 | 0 | |
| P07 | 0,65 | 1 | P17 | 0,10 | 0 | |
| P08 | 0,60 | 0 | P18 | 0,08 | 0 | |
| P09 | 0,55 | 1 | P19 | 0,05 | 0 | |
| P10 | 0,45 | 1 | P20 | 0,02 | 0 |
Dez estão doentes e dez saudáveis. O modelo não responde "doente" ou "saudável" sozinho: ele produz um escore e nós transformamos o escore em rótulo com um limiar. O padrão é 0,5, que é o que .predict() faz tanto na regressão logística quanto no k-NN. Cada paciente cai então em um de quatro grupos (usamos as siglas em inglês, as mesmas que o scikit-learn e as figuras usam):
- TP, verdadeiro positivo (true positive): doente e marcado como doente;
- FP, falso positivo: saudável, mas marcado como doente (um alarme falso);
- FN, falso negativo: doente, mas chamado de saudável (um escape);
- TN, verdadeiro negativo (true negative): saudável e chamado de saudável.
A classe positiva é a que estamos procurando, aqui "doente". Em geral é a rara ou a interessante (fraude, doença, cancelamento); no código, é a classe 1. Copie os dados e separe os pacientes:
import numpy as np

# 20 pacientes encaminhados a um especialista, em ordem de escore do modelo
ids   = [f"P{i:02d}" for i in range(1, 21)]
score = np.array([0.95, 0.90, 0.85, 0.80, 0.75, 0.70, 0.65, 0.60, 0.55, 0.45,
                  0.40, 0.35, 0.30, 0.25, 0.20, 0.15, 0.10, 0.08, 0.05, 0.02])
y_true = np.array([1, 1, 1, 1, 0, 1, 1, 0, 1, 1,
                   0, 1, 0, 0, 1, 0, 0, 0, 0, 0])      # 1 = doente

y_pred = (score >= 0.5).astype(int)                     # limiar 0,5
cell = {(1, 1): 'TP', (0, 1): 'FP', (1, 0): 'FN', (0, 0): 'TN'}
for name in ['TP', 'FP', 'FN', 'TN']:
    who = [i for i, t, p in zip(ids, y_true, y_pred) if cell[t, p] == name]
    print(f"{name} = {len(who)}:", ' '.join(who))
TP = 7: P01 P02 P03 P04 P06 P07 P09
FP = 2: P05 P08
FN = 3: P10 P12 P15
TN = 8: P11 P13 P14 P16 P17 P18 P19 P20
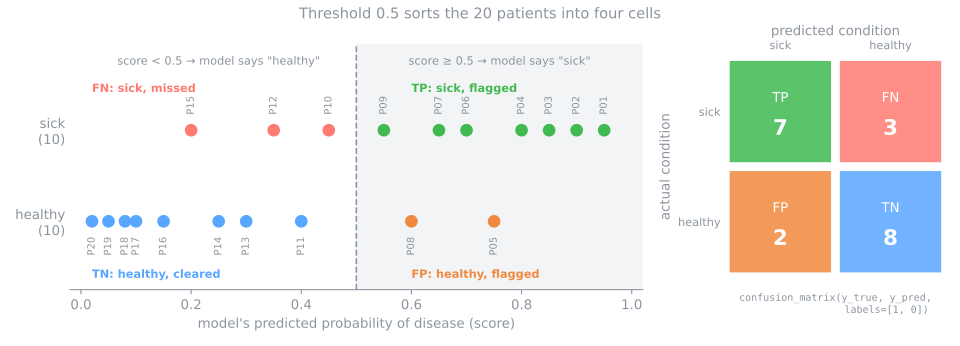
A imagem é a aula inteira em uma linha. O limiar é a linha tracejada. Os três pacientes em vermelho estão doentes mas tiveram escore abaixo de 0,5 (P10, com 0,45, escapou por pouco); os dois em laranja estão saudáveis mas ficaram acima. Cada métrica a seguir é alguma razão entre essas quatro contagens: 7, 2, 3, 8.
3. A matriz de confusão
As quatro contagens organizadas em uma tabela 2×2 formam a matriz de confusão. O layout padrão, o da maioria dos livros e da Wikipedia, tem a condição real nas linhas, a condição prevista nas colunas e a classe positiva primeiro nas duas:
| previsto doente | previsto saudável | |
|---|---|---|
| realmente doente | TP = 7 | FN = 3 (escape) |
| realmente saudável | FP = 2 (alarme falso) | TN = 8 |
O scikit-learn usa as mesmas linhas (real) e colunas (previsto), mas, por padrão, ordena as duas pela ordem crescente dos rótulos: com rótulos 0 e 1, os negativos vêm primeiro e o canto superior esquerdo vira TN. Para obter o layout padrão, passe labels=[1, 0], a classe positiva primeiro. É o que esta aula faz em todo lugar:
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_true, y_pred, labels=[1, 0])    # positivo primeiro: o layout padrão
print(cm)
tp, fn, fp, tn = cm.ravel()
print(f"tp={tp} fn={fn} fp={fp} tn={tn}")
print(confusion_matrix(y_true, y_pred))                  # sem labels: o padrão do scikit-learn
Leia o layout antes de ler os números
Sem labels, o confusion_matrix(y_true, y_pred) do scikit-learn ordena os rótulos em ordem crescente: com 0 e 1, devolve [[TN, FP], [FN, TP]], a última matriz impressa acima, com o TN no canto superior esquerdo; o .ravel() devolve tn, fp, fn, tp. Lida como se estivesse no layout padrão, essa matriz troca TP com TN e FP com FN. Com labels=[1, 0] ela fica no layout padrão, [[TP, FN], [FP, TN]]; o .ravel() devolve tp, fn, fp, tn. Duas outras armadilhas: trocar os argumentos (y_pred, y_true) transpõe a matriz e troca FP com FN sem aviso; com rótulos de texto ("não", "sim") a ordem padrão é alfabética. Passe sempre labels=[...], com a classe positiva primeiro.
Para visualizar, o ConfusionMatrixDisplay aceita o mesmo labels=[1, 0] e desenha a matriz no layout padrão, com os nomes que você escolher:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay

ConfusionMatrixDisplay.from_predictions(y_true, y_pred, labels=[1, 0],
                                        display_labels=['sick', 'healthy'], colorbar=False)
plt.show()
A diagonal guarda os acertos; tudo o que está fora dela é erro. A posição do erro diz de que tipo ele é. ConfusionMatrixDisplay.from_estimator(model, X_test, y_test) faz o mesmo a partir de um modelo ajustado.
4. Acurácia e o paradoxo da acurácia
Etapa 2. A métrica usada até agora é a fração de acertos, a diagonal sobre o total:
Aqui as classes são balanceadas (10 e 10), então um DummyClassifier que sempre responde a classe majoritária marcaria 0,50; 0,75 é uma melhora real. A acurácia é um bom resumo quando as classes são balanceadas e os dois erros custam o mesmo. Tire qualquer uma das condições e ela engana.
Considere 1 000 pacientes dos quais só 10 estão doentes (prevalência de 1%) e compare dois "modelos": um que responde "saudável" para todo mundo e um preguiçoso, que pega metade dos doentes e dispara 10 alarmes falsos:
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score, recall_score

# 1 000 pacientes, 10 deles doentes (prevalência de 1%)
y_1000 = np.array([1] * 10 + [0] * 990)
always_healthy = np.zeros(1000, dtype=int)
lazy = np.array([1] * 5 + [0] * 5 +          # os 10 doentes: 5 pegos, 5 escapam
                [1] * 10 + [0] * 980)        # os 990 saudáveis: 10 alarmes falsos
X_none = np.zeros((1000, 1))                  # o DummyClassifier ignora X
dummy = DummyClassifier(strategy='most_frequent').fit(X_none, y_1000)

for name, pred in [('always healthy', always_healthy), ('lazy model', lazy),
                   ('DummyClassifier', dummy.predict(X_none))]:
    print(f"{name:16s} accuracy {accuracy_score(y_1000, pred):.3f}   "
          f"recall {recall_score(y_1000, pred):.2f}")
always healthy   accuracy 0.990   recall 0.00
lazy model       accuracy 0.985   recall 0.50
DummyClassifier  accuracy 0.990   recall 0.00
A resposta constante marca 99,0% e não encontra ninguém. O modelo preguiçoso, que ao menos acha 5 dos 10 doentes, marca menos: 98,5%. Esse é o paradoxo da acurácia: em dados desbalanceados, a acurácia premia o modelo que ignora a classe rara, porque a classe rara quase não pesa no total. DummyClassifier(strategy='most_frequent') é exatamente a resposta constante; é por isso que ele é a baseline a imprimir ao lado de qualquer acurácia.
Tudo sai de quatro células
Acurácia, precisão, revocação e F1 não são medições independentes — são quatro leituras da mesma tabela 2×2. Mexa nos controles e veja as quatro se moverem juntas:
O botão que vale apertar é o modelo preguiçoso: sensibilidade 50%, especificidade 99%, prevalência 1%. Em 1000 pacientes, 10 estão doentes. O modelo pega 5 deles e dispara 10 alarmes falsos:
Um número de aparência impressionante. Mas o modelo que sempre responde "saudável" marca 99% — então 98,5% não é apenas pouco impressionante, é pior que uma constante. Enquanto isso, a precisão é de 33%: dois de cada três alarmes são falsos, que é o número com que um clínico de fato se importaria.
Sempre reporte a baseline ao lado da métrica. Um escore sem ponto de referência não é resultado.
O paradoxo da acurácia
Em problemas desbalanceados, alta acurácia pode descrever um modelo inútil. Sempre compare com a baseline da classe majoritária (DummyClassifier) e olhe as métricas da próxima seção, que leem a matriz uma linha ou uma coluna de cada vez.
5. Precisão, revocação, especificidade, FPR, VPN
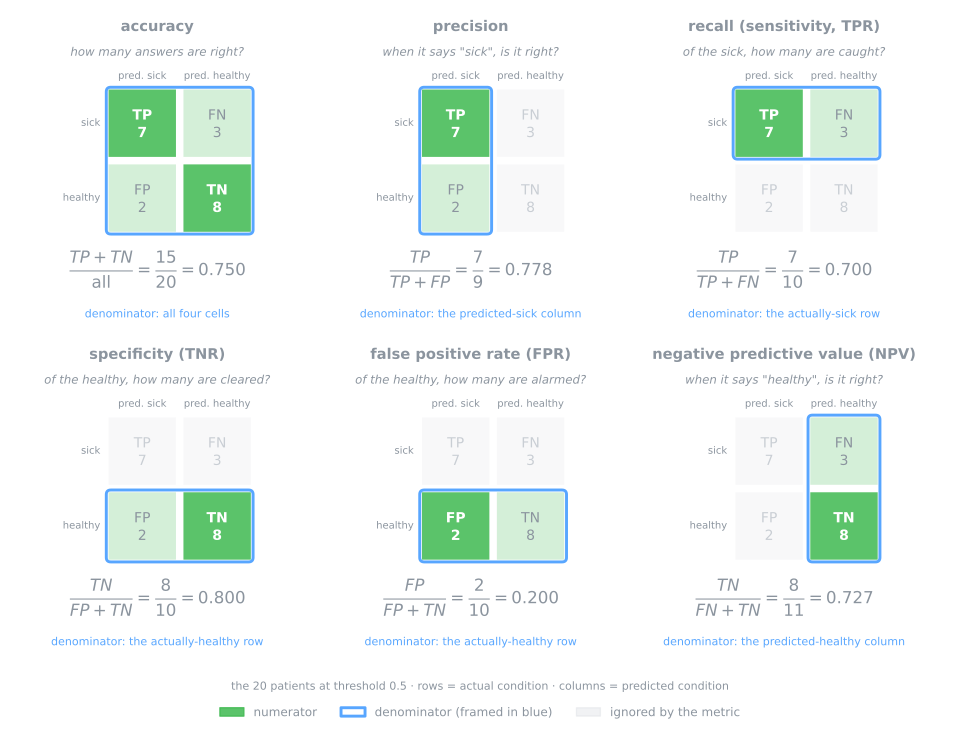
Etapa 3. Cada uma das métricas a seguir responde a uma pergunta em palavras simples; cada pergunta lê uma linha ou uma coluna da matriz. É a única coisa a memorizar: sabendo quais células uma métrica usa, você sabe o que ela mede e o que ela ignora.
Precisão: quando ele diz "doente", acerta?
Ela lê a coluna "previsto doente": dos 9 pacientes que o modelo marcou, 7 estavam doentes. Também é chamada de valor preditivo positivo (VPP). A precisão ignora os doentes que o modelo deixou escapar: um modelo que marca só o P01 tem precisão 1,0.
Quando é ela que importa: quando agir sobre um alarme é caro ou faz mal. Um filtro de spam que manda um e-mail de verdade para a pasta de spam; um exame confirmatório antes de uma cirurgia ou de uma quimioterapia; uma equipe antifraude que só consegue ligar para 50 clientes por dia, em que cada alarme falso desperdiça uma das 50 ligações.
Revocação (sensibilidade): dos doentes, quantos são pegos?
Ela lê a linha "realmente doente": dos 10 doentes, 7 foram encontrados. Tem três nomes: revocação ou recall (aprendizado de máquina), sensibilidade (medicina) e taxa de verdadeiros positivos, TPR (a curva ROC da próxima aula). A revocação ignora os alarmes falsos: um modelo que marca todo mundo tem revocação 1,0.
Quando é ela que importa: quando um escape é caro. O rastreamento de câncer, em que um positivo só leva a um segundo exame, mais preciso; detectar uma fraude antes que o dinheiro saia; inspecionar peças de avião em busca de trincas.
Especificidade e taxa de falsos positivos: dos saudáveis, quantos são deixados em paz?
As duas leem a linha "realmente saudável". A especificidade (taxa de verdadeiros negativos, TNR) é a revocação da classe negativa: dos 10 saudáveis, 8 foram corretamente deixados em paz. A taxa de falsos positivos (FPR, do inglês false positive rate) é o outro lado da mesma linha: 2 dos 10 saudáveis receberam um alarme falso. Pela mesma lógica, a taxa de falsos negativos (taxa de escape) é \(1 - \text{revocação} = 3/10 = 0{,}300\).
Quando é ela que importa: quando os negativos são as pessoas que você não pode incomodar e há muitas delas. No rastreamento em massa de uma população 99% saudável, a FPR decide quantas pessoas saudáveis recebem uma carta assustadora: com FPR 0,20, uma em cada cinco. A FPR também é o eixo horizontal da curva ROC.
Valor preditivo negativo: quando ele diz "saudável", acerta?
Ele lê a coluna "previsto saudável", o espelho da precisão: dos 11 pacientes mandados para casa, 8 estavam de fato saudáveis. Em inglês, negative predictive value (NPV), a sigla que aparece no código.
Quando é ele que importa: quando é a resposta negativa que vira ação. Um pronto-socorro usa um exame de sangue para descartar um infarto e mandar o paciente para casa; o paciente que vai embora está confiando no VPN.
Os mesmos números, em uma tabela e no scikit-learn
| métrica | pergunta | fórmula | células | valor |
|---|---|---|---|---|
| acurácia | quantas respostas estão certas? | (TP + TN) / todos | (7 + 8) / 20 | 0,750 |
| precisão (VPP) | quando diz "doente", acerta? | TP / (TP + FP) | 7 / 9 | 0,778 |
| revocação, sensibilidade, TPR | dos doentes, quantos são pegos? | TP / (TP + FN) | 7 / 10 | 0,700 |
| especificidade, TNR | dos saudáveis, quantos ficam em paz? | TN / (TN + FP) | 8 / 10 | 0,800 |
| taxa de falsos positivos (FPR) | dos saudáveis, quantos recebem alarme? | FP / (FP + TN) | 2 / 10 | 0,200 |
| taxa de falsos negativos (FNR) | dos doentes, quantos escapam? | FN / (FN + TP) | 3 / 10 | 0,300 |
| valor preditivo negativo (VPN) | quando diz "saudável", acerta? | TN / (TN + FN) | 8 / 11 | 0,727 |
O scikit-learn só tem funções para precisão e revocação, mas não precisa de mais: a especificidade é a revocação da classe 0; o VPN é a precisão da classe 0. Assim, pos_label=0 dá as duas:
from sklearn.metrics import precision_score

prec = precision_score(y_true, y_pred)             # TP / (TP + FP)
rec  = recall_score(y_true, y_pred)                # TP / (TP + FN)
spec = recall_score(y_true, y_pred, pos_label=0)   # TN / (TN + FP): revocação da classe 0
npv  = precision_score(y_true, y_pred, pos_label=0)  # TN / (TN + FN): precisão da classe 0
print(f"accuracy    {accuracy_score(y_true, y_pred):.3f}")
print(f"precision   {prec:.3f}")
print(f"recall      {rec:.3f}")
print(f"specificity {spec:.3f}")
print(f"FPR         {1 - spec:.3f}")
print(f"NPV         {npv:.3f}")
Todos os valores batem com a conta à mão. Guarde o truque do pos_label=0: o classification_report, usado no lab, imprime uma linha por classe; a linha da classe 0 traz a especificidade (a revocação dela) e o VPN (a precisão dela).
6. A tensão: mexendo no limiar
Etapa 4. Nada obriga o limiar a ser 0,5. Teste 0,3 e 0,7 nos mesmos 20 pacientes:
for t in [0.3, 0.5, 0.7]:
    pred = (score >= t).astype(int)
    tp, fn, fp, tn = confusion_matrix(y_true, pred, labels=[1, 0]).ravel()
    print(f"threshold {t}: TP={tp} FP={fp} FN={fn} TN={tn}   "
          f"precision {precision_score(y_true, pred):.3f}   recall {recall_score(y_true, pred):.3f}")
threshold 0.3: TP=9 FP=4 FN=1 TN=6   precision 0.692   recall 0.900
threshold 0.5: TP=7 FP=2 FN=3 TN=8   precision 0.778   recall 0.700
threshold 0.7: TP=5 FP=1 FN=5 TN=9   precision 0.833   recall 0.500
| limiar | marcados | TP | FP | FN | TN | precisão | revocação |
|---|---|---|---|---|---|---|---|
| 0,3 | 13 | 9 | 4 | 1 | 6 | 9/13 = 0,692 | 9/10 = 0,900 |
| 0,5 | 9 | 7 | 2 | 3 | 8 | 7/9 = 0,778 | 7/10 = 0,700 |
| 0,7 | 6 | 5 | 1 | 5 | 9 | 5/6 = 0,833 | 5/10 = 0,500 |
Baixar o limiar para 0,3 deixa entrar P10 e P12 (revocação 0,900, só o P15 escapa), mas também P11 e P13, dois alarmes falsos a mais (precisão 0,692). Subir para 0,7 tira P07, P08 e P09 do grupo marcado: um alarme falso a menos (P08) e dois escapes a mais (P07 e P09); a revocação cai para 0,500. Revocação e precisão andam em sentidos opostos, com o mesmo modelo nas três linhas. Só a regra de decisão mudou.
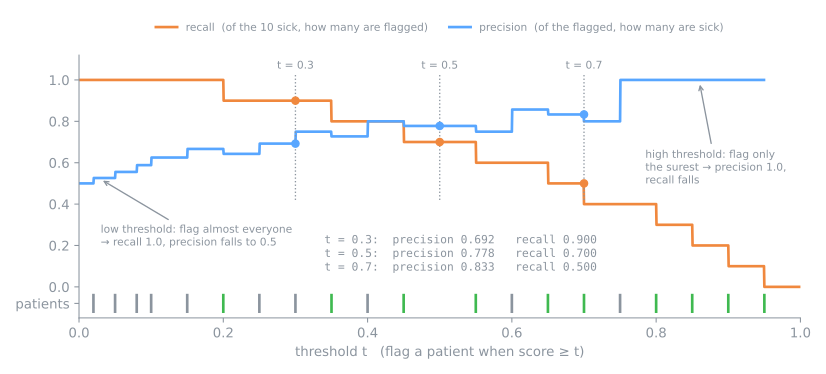
As duas curvas são escadas: só mudam quando o limiar cruza o escore de um paciente (os tracinhos embaixo). A revocação só pode cair à medida que o limiar sobe, um degrau por doente deixado para trás. A precisão tende a subir, mas nem sempre: ir de 0,60 para 0,65 tira o alarme falso P08 e a precisão salta de 0,750 para 0,857; seguir até 0,70 tira o P07 (doente) e a precisão cai para 0,833.
O limiar é uma decisão, não uma propriedade do modelo. O modelo fornece a ordenação (os escores); o limiar diz quantos pacientes o hospital está disposto a mandar para uma biópsia. Escolhê-lo de forma sistemática, com curvas que mostram todos os limiares de uma vez, é o tema da próxima aula.
7. F1: um número a partir de dois
Às vezes é preciso um número só: para ordenar modelos, para escolher um hiperparâmetro. O F1 combina precisão e revocação com uma média harmônica:
Escrito com as contagens, é a mesma coisa: \(F_1 = \frac{2\,TP}{2\,TP + FP + FN} = \frac{14}{14 + 2 + 3} = \frac{14}{19} = 0{,}737\). Repare no que não está ali: TN. O F1 não se importa com quantos saudáveis foram corretamente deixados em paz.
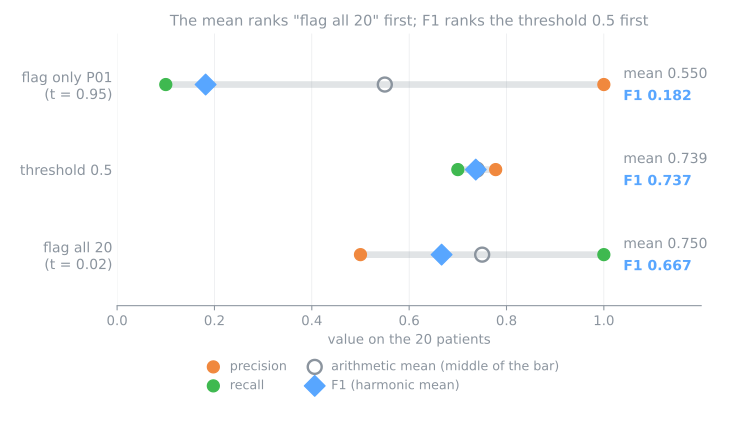
Por que harmônica e não a média comum? Porque a média harmônica é puxada para o menor dos dois. Compare três cortes dos 20 pacientes. Marcar só o P01 (\(t = 0{,}95\)) acerta o único marcado, precisão 1,0, mas pega 1 de 10 doentes, revocação 0,1: a média aritmética dá 0,55; o F1, 0,18. Marcar os 20 (\(t = 0{,}02\)) tem revocação 1,0 e precisão 0,5: a média dá 0,750, um pouco acima dos 0,739 do limiar 0,5. Pela média, "mandar todo mundo para o especialista" seria o melhor dos três cortes. O F1 (0,667 contra 0,737) põe o limiar 0,5 na frente, porque ele só fica alto quando os dois lados ficam altos. Não dá para comprar um bom F1 maximizando um lado e abandonando o outro.
Ideia-chave
Toda métrica desta parte é uma razão entre as mesmas quatro contagens. Saber quais células ela usa já diz o que ela mede e o que ela ignora: a revocação nunca olha os alarmes falsos, a precisão nunca olha os escapes e o F1 nunca olha os TN.
8. Resumo: as quatro células e as perguntas
- Monte a matriz antes de qualquer número único, no layout padrão: real nas linhas, previsto nas colunas, positivo primeiro. No scikit-learn,
confusion_matrix(y_true, y_pred, labels=[1, 0]).ravel()devolve tp, fn, fp, tn, nessa ordem. - Escolha a métrica pela pergunta, não pelo hábito: a tabela da seção 5 liga cada pergunta a uma linha ou coluna.
- Imprima a baseline ao lado (
DummyClassifier). Um escore sem ponto de referência não é resultado. - Lembre que o limiar é seu. O modelo dá a ordenação; 0,5 é só a convenção do
.predict().
| erro comum | sintoma | correção |
|---|---|---|
ler a matriz padrão do scikit-learn (sem labels) como se TP fosse o canto superior esquerdo | TP trocado com TN e FP com FN em todas as contas | sem labels o canto superior esquerdo é TN; passe labels=[1, 0] |
| reportar só a acurácia | um modelo que ignora a classe rara parece ótimo | acurácia ao lado da baseline, mais revocação e precisão |
| comparar modelos por uma métrica só | o vencedor muda quando a métrica muda | um placar com várias métricas, como no passo 7 |
| mexer no limiar olhando o teste | o número final deixa de ser honesto | escolher o limiar na validação |
Lab fundamental — a ferramenta de triagem
O conjunto Pima Indians Diabetes registra 8 medidas de 768 mulheres de origem pima (com 21 anos ou mais) e se cada uma recebeu diagnóstico de diabetes. O cenário: uma ferramenta de triagem que decide quem é encaminhado para um exame diagnóstico completo. O lab treina os dois modelos das aulas anteriores e os avalia com todas as métricas desta página. No caminho, mostra que o "melhor modelo" depende da métrica e que o limiar muda a resposta. No fim, trata de um problema multiclasse.
O protocolo é hold-out: um conjunto de treino para ajustar, um conjunto de validação para toda comparação e escolha e um conjunto de teste tocado uma vez, no fim. A validação cruzada, algumas aulas adiante, vai tornar essas escolhas mais robustas.
Como fazer este lab em aula (cerca de 40 min, em duplas)
- Abra o notebook do lab no Colab. Não é preciso baixar nem instalar nada: o Colab roda no navegador. Para guardar as suas respostas, salve uma cópia no seu Drive (Arquivo → Salvar uma cópia no Drive) antes de editar. Rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 7 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 8.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 a 3 em 12 min; passos 4 a 6 em 15 min; passo 7 e a simulação em 13 min.
Passo 1 — carregar e olhar o alvo
Preveja. O conjunto reúne mulheres encaminhadas a um estudo sobre diabetes, não a população geral. Você espera que as duas classes estejam equilibradas? Um modelo que sempre responde "sem diabetes" acertaria mais ou menos que a metade das vezes?
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_openml

pima = fetch_openml(data_id=37, as_frame=True)
X = pima.data.copy()                                       # 8 medidas por mulher
y = (pima.target == 'tested_positive').astype(int)         # 1 = diabetes, 0 = sem diabetes
print(X.shape)
print(y.value_counts())
print(f"prevalence: {y.mean():.3f}")
O alvo chega como as strings 'tested_positive' e 'tested_negative'. Nós mesmos as convertemos em 1 e 0, para que 1 seja a classe que queremos encontrar e precision_score/recall_score (que usam pos_label=1 por padrão) meçam a coisa certa. 268 das 768 mulheres têm diabetes: uma prevalência de 34,9%. Um modelo que sempre responde "sem diabetes" acerta, portanto, 65,1% das vezes: essa é a acurácia a bater.
Passo 2 — zeros que significam "não medido"
Preveja. A coluna de insulina tem centenas de zeros. Um zero de insulina é uma medida de verdade ou o código de "não medido"? Se ele ficasse como zero, o valor seria lido como uma medida muito baixa ou muito alta?
print((X == 0).sum().to_frame('zeros').T)

missing = ['plas', 'pres', 'skin', 'insu', 'mass']   # um zero aqui é impossível: "não medido"
X[missing] = X[missing].replace(0, np.nan)
print(f"rows with at least one missing value: {X.isna().any(axis=1).sum()}")
       preg  plas  pres  skin  insu  mass  pedi  age
zeros   111     5    35   227   374    11     0    0
rows with at least one missing value: 376
As colunas são: número de gestações (preg), glicose plasmática duas horas após um teste de tolerância à glicose (plas), pressão diastólica (pres), espessura da dobra cutânea do tríceps (skin), insulina sérica (insu), índice de massa corporal (mass), um escore de histórico familiar (pedi) e idade. Zero gestações é um valor real. Glicose, pressão ou IMC iguais a zero são impossíveis em uma pessoa viva; dobra cutânea ou insulina iguais a zero significam que o exame não foi feito: neste arquivo, 0 é o código de "faltante". Deixado como 0, seria lido como uma medida extrema.
Transformamos esses zeros em NaN. Descartar as linhas incompletas jogaria fora 376 das 768 mulheres (quase todas por causa da insulina), então imputamos a mediana, com um SimpleImputer colocado dentro do pipeline do passo 4. Ali, as medianas são aprendidas só nas linhas de treino; as linhas de validação e de teste nunca as influenciam.
Passo 3 — três divisões
Preveja. Para que serve cada uma das três partes? Qual delas pode ser olhada quantas vezes você quiser e qual só pode ser tocada uma vez?
from sklearn.model_selection import train_test_split

X_temp, X_test, y_temp, y_test = train_test_split(X, y, test_size=0.2, stratify=y,
                                                  random_state=42)
X_train, X_val, y_train, y_val = train_test_split(X_temp, y_temp, test_size=0.25,
                                                  stratify=y_temp, random_state=42)
for name, part in [('train', y_train), ('validation', y_val), ('test', y_test)]:
    print(f"{name:10s} {len(part):3d} rows · {part.sum():3d} positive ({part.mean():.1%})")
train      460 rows · 160 positive (34.8%)
validation 154 rows ·  54 positive (35.1%)
test       154 rows ·  54 positive (35.1%)
60/20/20, com stratify mantendo a prevalência em torno de 35% nas três partes. O conjunto de teste fica agora trancado até o passo 10. Guarde os tamanhos: com 54 positivos na validação, uma mulher vale 1,9 ponto de revocação, então diferenças de um ou dois pontos entre modelos estão dentro do ruído.
Passo 4 — dois modelos, duas matrizes de confusão
Preveja. Os dois modelos vão errar nas mesmas mulheres? Numa ferramenta de triagem, qual dos dois erros você preferiria evitar: mandar para casa uma mulher com diabetes ou encaminhar uma sem diabetes a um exame a mais?
import matplotlib.pyplot as plt
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import ConfusionMatrixDisplay, confusion_matrix
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

logreg = make_pipeline(SimpleImputer(strategy='median'), StandardScaler(),
                       LogisticRegression(max_iter=1000)).fit(X_train, y_train)
knn = make_pipeline(SimpleImputer(strategy='median'), StandardScaler(),
                    KNeighborsClassifier(n_neighbors=5)).fit(X_train, y_train)

pred_lr, pred_knn = logreg.predict(X_val), knn.predict(X_val)
print("logistic regression:\n", confusion_matrix(y_val, pred_lr, labels=[1, 0]))
print("k-NN (k = 5):\n", confusion_matrix(y_val, pred_knn, labels=[1, 0]))

fig, axes = plt.subplots(1, 2, figsize=(8, 3.5))
for ax, pred, title in [(axes[0], pred_lr, 'logistic regression'), (axes[1], pred_knn, 'k-NN')]:
    ConfusionMatrixDisplay.from_predictions(y_val, pred, labels=[1, 0],
                                            display_labels=['diabetes', 'no diabetes'], ax=ax, colorbar=False)
    ax.set_title(title)
plt.show()
As matrizes estão no layout padrão: a primeira linha são as 54 mulheres com diabetes, a segunda as 100 sem diabetes; o canto superior esquerdo é TP. A regressão logística encontra 32 das 54 mulheres com diabetes e deixa escapar 22 (canto superior direito). O k-NN encontra 35 e deixa escapar 19, ao preço de um alarme falso a mais (13 contra 12). Os dois pipelines imputam, depois padronizam (o k-NN precisa disso, como visto na aula dele) e só então ajustam. A regressão logística fica com as configurações padrão do scikit-learn, inclusive a penalidade L2 leve que a aula dela desligou com C=np.inf; ajustar essa penalidade fica para a validação cruzada.
Passo 5 — as métricas à mão a partir do .ravel()
Preveja. A acurácia da regressão logística na validação vai ficar perto de 78%. Olhando só esse número, você diria que a ferramenta está pronta para ser usada? O que ele não conta?
from sklearn.metrics import accuracy_score, f1_score, precision_score, recall_score

tp, fn, fp, tn = confusion_matrix(y_val, pred_lr, labels=[1, 0]).ravel()
print(f"tp={tp} fn={fn} fp={fp} tn={tn}")
by_hand = {'accuracy':    (tp + tn) / (tp + tn + fp + fn),
           'precision':   tp / (tp + fp),
           'recall':      tp / (tp + fn),
           'specificity': tn / (tn + fp),
           'F1':          2 * tp / (2 * tp + fp + fn)}
library = {'accuracy':    accuracy_score(y_val, pred_lr),
           'precision':   precision_score(y_val, pred_lr),
           'recall':      recall_score(y_val, pred_lr),
           'specificity': recall_score(y_val, pred_lr, pos_label=0),
           'F1':          f1_score(y_val, pred_lr)}
for name in by_hand:
    print(f"{name:12s} by hand {by_hand[name]:.3f}   sklearn {library[name]:.3f}")
tp=32 fn=22 fp=12 tn=88
accuracy     by hand 0.779   sklearn 0.779
precision    by hand 0.727   sklearn 0.727
recall       by hand 0.593   sklearn 0.593
specificity  by hand 0.880   sklearn 0.880
F1           by hand 0.653   sklearn 0.653
As quatro contagens são tudo de que as funções precisam: acurácia \((32 + 88)/154 = 0{,}779\), precisão \(32/44 = 0{,}727\), revocação \(32/54 = 0{,}593\), especificidade \(88/100 = 0{,}880\), F1 \(64/98 = 0{,}653\). Lida como ferramenta de triagem, a regressão logística com limiar 0,5 não é boa o bastante: ela manda para casa 4 em cada 10 mulheres que têm diabetes. A acurácia (77,9%) esconde isso por completo.
Simulação: de quem são os escapes? A regressão logística em 0,5 deixa escapar 22 das 54 mulheres com diabetes. Pegue a probabilidade prevista de cada uma dessas 22 e veja onde esses escores caem: elas ficaram logo abaixo de 0,5, hesitando, ou bem mais longe? Se o limiar baixasse para 0,3, quantas seriam recuperadas?
Solução
proba_val = logreg.predict_proba(X_val)[:, 1]
escaped = proba_val[(y_val == 1) & (pred_lr == 0)]          # as 22 mulheres que escaparam
print(f"escapes: {len(escaped)}   escore médio {escaped.mean():.3f}")
for lo, hi in [(0.4, 0.5), (0.3, 0.4), (0.2, 0.3), (0.0, 0.2)]:
    n = ((escaped >= lo) & (escaped < hi)).sum()
    print(f"escore entre {lo:.1f} e {hi:.1f}: {n:2d} mulheres")
escapes: 22   escore médio 0.273
escore entre 0.4 e 0.5:  4 mulheres
escore entre 0.3 e 0.4:  4 mulheres
escore entre 0.2 e 0.3:  8 mulheres
escore entre 0.0 e 0.2:  6 mulheres
Só 4 das 22 estavam hesitando na beira do limiar. O escore médio dos escapes é 0,273 e 14 delas estão abaixo de 0,3: para essas, o modelo não está em dúvida, está confiantemente errado. Baixar o limiar para 0,3 recupera 8 das 22 (as duas primeiras faixas) e é exatamente o que o passo 9 vai medir, quando os escapes caem de 22 para 14. A lição é que mexer no limiar ajuda, mas não conserta um modelo que colocou uma mulher doente em 0,1; para isso seriam precisos melhores atributos ou um modelo melhor.
Passo 6 — classification_report
Preveja. O relatório imprime uma linha por classe. A linha no diabetes mede o quê, em palavras? (Dica: qual é a "revocação" da classe negativa?)
from sklearn.metrics import classification_report

print(classification_report(y_val, pred_lr, target_names=['no diabetes', 'diabetes'], digits=3))
              precision    recall  f1-score   support

 no diabetes      0.800     0.880     0.838       100
    diabetes      0.727     0.593     0.653        54

    accuracy                          0.779       154
   macro avg      0.764     0.736     0.746       154
weighted avg      0.774     0.779     0.773       154
Como ler:
- a linha diabetes é a classe positiva: precisão 0,727, revocação 0,593, F1 0,653, exatamente o passo 5;
- a linha no diabetes é a mesma matriz lida pela outra classe: a revocação dela (0,880) é a especificidade e a precisão dela (0,800 = 88/110) é o VPN;
- a revocação da macro avg (0,736) é a acurácia balanceada do passo 7; a revocação da weighted avg (0,779) é a acurácia, como sempre.
Passo 7 — um placar com as baselines
Preveja. Entre a regressão logística e o k-NN, quem vence? Antes de olhar: vence em qual métrica? E quanto de acurácia um modelo que sempre responde "sem diabetes" consegue aqui?
from sklearn.dummy import DummyClassifier
from sklearn.metrics import balanced_accuracy_score, matthews_corrcoef

def scores(y_true, y_pred):
    return {'accuracy':    accuracy_score(y_true, y_pred),
            'precision':   precision_score(y_true, y_pred, zero_division=0),
            'recall':      recall_score(y_true, y_pred),
            'specificity': recall_score(y_true, y_pred, pos_label=0),
            'F1':          f1_score(y_true, y_pred),
            'balanced':    balanced_accuracy_score(y_true, y_pred),
            'MCC':         matthews_corrcoef(y_true, y_pred)}

models = {'dummy majority':   DummyClassifier(strategy='most_frequent'),
          'dummy stratified': DummyClassifier(strategy='stratified', random_state=0),
          'logistic':         logreg,
          'k-NN':             knn}
board = pd.DataFrame({name: scores(y_val, m.fit(X_train, y_train).predict(X_val))
                      for name, m in models.items()}).T
print(board.round(3).to_string())
                  accuracy  precision  recall  specificity     F1  balanced    MCC
dummy majority       0.649      0.000   0.000         1.00  0.000     0.500  0.000
dummy stratified     0.513      0.302   0.296         0.63  0.299     0.463 -0.074
logistic             0.779      0.727   0.593         0.88  0.653     0.736  0.499
k-NN                 0.792      0.729   0.648         0.87  0.686     0.759  0.534
Como ler:
- Duas colunas ainda não vistas. A
balanced(acurácia balanceada) e oMCCsão resumos de um número só que não se deixam enganar por classes desbalanceadas; a seção 11 os define. Por ora, leia-os como "a acurácia de quem não ganha ponto ignorando a classe rara". - Baselines. "Sempre sem diabetes" chega a 64,9% de acurácia com revocação 0 e MCC 0; a precisão dela é indefinida (nenhuma previsão positiva) e aparece como 0 por causa do
zero_division=0. O dummy estratificado chuta ao acaso com as proporções das classes: revocação e precisão perto da prevalência, MCC perto de 0 (−0,074). Toda métrica real deve ser lida contra essas linhas: os modelos ganham de 13 a 14 pontos de acurácia sobre a baseline e de 0,50 a 0,53 de MCC sobre o 0 dela. - Qual modelo é melhor? O k-NN lidera em seis colunas, a regressão logística na especificidade (0,88 contra 0,87). Mas olhe o tamanho das diferenças: a revocação melhor do k-NN é 35 contra 32 mulheres, três pessoas em 54. Em 154 linhas de validação, isso não é uma vitória clara; o passo 8, já na abordagem avançada, mostra uma métrica em que a ordem se inverte por completo.
Simulação: e se o diabetes fosse raro? O conjunto Pima tem 34,9% de prevalência, muito acima da população geral. Monte uma validação com as mesmas mulheres, mas com a doença rara: fique com as 100 sem diabetes e sorteie só 5 com diabetes. Refaça o placar nessa validação. Quem lidera a acurácia agora? A acurácia balanceada e o MCC mudam de opinião?
Solução
rng = np.random.default_rng(0)
pos = np.flatnonzero(y_val.to_numpy() == 1)
neg = np.flatnonzero(y_val.to_numpy() == 0)
keep = np.sort(np.concatenate([neg, rng.choice(pos, size=5, replace=False)]))
Xr, yr = X_val.iloc[keep], y_val.iloc[keep]                 # mesma população, doença rara
print(f"{len(yr)} mulheres, {yr.sum()} com diabetes (prevalência {yr.mean():.1%})")

rare = {name: scores(yr, m.predict(Xr))
        for name, m in [('dummy majority', DummyClassifier(strategy='most_frequent').fit(X_train, y_train)),
                        ('logistic', logreg), ('k-NN', knn)]}
print(pd.DataFrame(rare).T[['accuracy', 'recall', 'F1', 'balanced', 'MCC']].round(3).to_string())
105 mulheres, 5 com diabetes (prevalência 4.8%)
                accuracy  recall     F1  balanced    MCC
dummy majority     0.952     0.0  0.000     0.500  0.000
logistic           0.876     0.8  0.381     0.840  0.403
k-NN               0.867     0.8  0.364     0.835  0.387
Nenhum modelo foi reajustado e nenhuma mulher mudou de diagnóstico: só a mistura da validação mudou. Mesmo assim, a baseline que não encontra ninguém passa a liderar a acurácia (0,952 contra 0,876), que é o paradoxo da acurácia acontecendo nos dados do lab. A acurácia balanceada (0,840 contra 0,500) e o MCC (0,403 contra 0) não se deixam enganar, porque leem as duas linhas da matriz separadamente. O F1 despenca para 0,381 porque contém a precisão e a precisão piora quando há muito mais saudáveis para gerar alarmes falsos — a seção 10 mede esse efeito. Um aviso de leitura: com só 5 positivos, a revocação 0,8 são 4 mulheres; ela não "melhorou" em relação aos 0,593 do passo 7, apenas foi medida em uma amostra pequena demais.
Para fechar a parte fundamental. Em uma frase cada: (1) por que 77,9% de acurácia não bastam para aprovar uma ferramenta de triagem? (2) Qual métrica lê a linha dos doentes e qual lê a coluna dos marcados? (3) O que acontece com as quatro contagens quando o limiar sobe?
Sua vez (fundamental)
Para casa:
- Outra divisão. Troque
random_state=42no passo 3 por outros valores e refaça os passos 4 e 5. Quanto a revocação da regressão logística se mexe entre uma divisão e outra? Com 54 positivos na validação, quanto de revocação vale uma mulher? - A outra classe. No passo 5, calcule precisão e revocação com
pos_label=0. Que métricas da tabela da seção 5 você obtém? Confira com a linhano diabetesdo passo 6. - Sem imputação. Refaça o passo 4 mantendo os zeros originais (sem transformá-los em
NaNe sem oSimpleImputer). A matriz de confusão muda? Por que tratar "não medido" como zero é pior que imputar a mediana?
Abordagem avançada
A parte fundamental deixou uma caixa de ferramentas: a matriz, as métricas que saem dela e o limiar. Esta parte pergunta o que quebra essas ferramentas e como escolher entre elas: o que acontece quando a doença é rara, quando as classes são muitas e quando o que interessa é a probabilidade, não o rótulo. Os blocos de código continuam os das seções 1 a 7 (o código dos labs roda à parte, no Colab): os 20 pacientes (y_true, y_pred, score) e o exemplo de 1 000 pacientes (y_1000, lazy, always_healthy) já estão definidos.
Esta parte fecha com uma tabela para escolher a métrica e, antes dela, segue quatro etapas, desenhadas abaixo: 1. pesar os erros com o F-beta; 2. quando os positivos são raros, a precisão se move e só algumas métricas resistem; 3. muitas classes, resumidas num número só; 4. avaliar a probabilidade, não só o rótulo. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Pesar os errosF-beta: o β diz quanto a revocação importa mais
- Quando os positivos são rarosa prevalência move a precisão; a acurácia balanceada e o MCC resistem
- Muitas classesum contra o resto, depois a média macro, ponderada ou micro
- Avaliar a probabilidadelog loss, escore de Brier, calibração
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
9. F-beta: quando um lado importa mais
Etapa 1. O F1 pesa precisão e revocação por igual. O F-beta torna a troca explícita. Na formulação de van Rijsbergen, ele mede a efetividade para um usuário que atribui à revocação \(\beta\) vezes a importância que atribui à precisão:
A forma com contagens mostra o mecanismo: um escape (FN) pesa \(\beta^2\) vezes um alarme falso (FP). Nos 20 pacientes, com limiar 0,5:
- \(F_2\) (um escape pesa 4 vezes um alarme falso): \(\frac{5 \cdot 7}{5 \cdot 7 + 4 \cdot 3 + 2} = \frac{35}{49} = 0{,}714\). Fica abaixo do F1 porque o lado mais fraco deste modelo é a revocação (0,700).
- \(F_{0,5}\) (um alarme falso pesa 4 vezes um escape): \(\frac{1{,}25 \cdot 7}{1{,}25 \cdot 7 + 0{,}25 \cdot 3 + 2} = \frac{8{,}75}{11{,}5} = 0{,}761\).
from sklearn.metrics import f1_score, fbeta_score

print(f"F1   {f1_score(y_true, y_pred):.3f}")
print(f"F2   {fbeta_score(y_true, y_pred, beta=2):.3f}")
print(f"F0.5 {fbeta_score(y_true, y_pred, beta=0.5):.3f}")
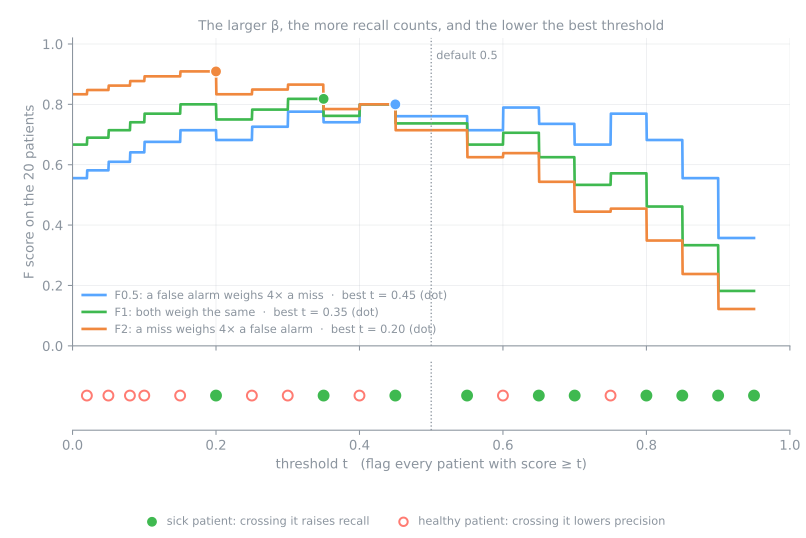
Use o F2 em rastreamento (pegar os doentes importa mais, um alarme falso só custa um segundo exame) e o F0,5 quando alarmes são caros (filtro de spam, exame confirmatório, uma equipe com pouco tempo para checar alertas). A figura mostra a consequência prática. O eixo x é o limiar \(t\) e a faixa de baixo mostra os 20 pacientes nos seus escores: cada vez que o limiar desce além de um paciente, as três curvas dão um degrau. Um doente (●) aumenta a revocação; um saudável (○) derruba a precisão. Os pontos marcam o melhor limiar de cada métrica: o F2 é máximo em um limiar baixo (0,20, onde os 10 doentes são marcados), o F1 em 0,35 e o F0,5 em um mais alto (0,45). Escolher \(\beta\) é uma afirmação sobre custos e desloca o ponto de operação.
10. A prevalência muda a precisão
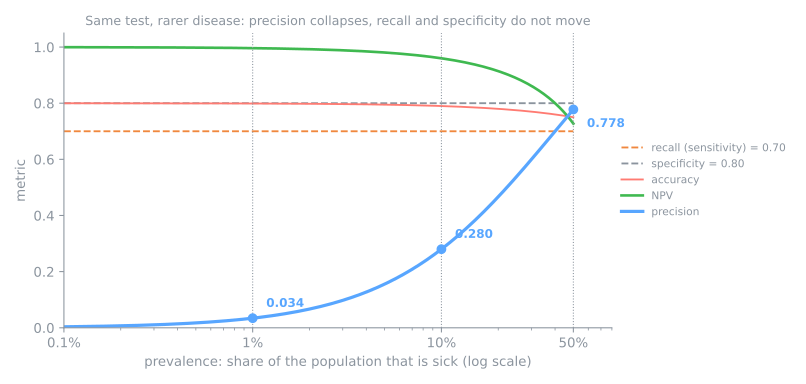
Etapa 2. Os 20 pacientes foram encaminhados a um especialista, por isso metade está doente. Suponha que o mesmo modelo, com a mesma revocação 0,70 e especificidade 0,80, seja usado para rastrear a população geral, onde a doença é mais rara. Conte 10 000 pessoas em três prevalências:
sens, spec = 0.70, 0.80          # as taxas do nosso modelo no limiar 0,5
for prevalence in [0.50, 0.10, 0.01]:
    sick = round(10_000 * prevalence); healthy = 10_000 - sick
    tp = sens * sick;  fn = sick - tp
    tn = spec * healthy; fp = healthy - tn
    print(f"prevalence {prevalence:4.0%}: TP={tp:5.0f} FP={fp:5.0f}  precision {tp / (tp + fp):.3f}"
          f"   NPV {tn / (tn + fn):.4f}   accuracy {(tp + tn) / 10_000:.3f}")
prevalence  50%: TP= 3500 FP= 1000  precision 0.778   NPV 0.7273   accuracy 0.750
prevalence  10%: TP=  700 FP= 1800  precision 0.280   NPV 0.9600   accuracy 0.790
prevalence   1%: TP=   70 FP= 1980  precision 0.034   NPV 0.9962   accuracy 0.799
À mão, com 1%: 100 pessoas estão doentes; o modelo acha \(0{,}70 \times 100 = 70\). As outras 9 900 estão saudáveis; 20% delas recebem um alarme falso: \(0{,}20 \times 9\,900 = 1\,980\). A precisão é \(70 / (70 + 1\,980) = 0{,}034\). De cada 30 pessoas que o modelo marca, 29 estão saudáveis, com exatamente o mesmo modelo que tinha precisão 0,778 no consultório do especialista.
A regra por trás da figura é, de novo, a matriz:
- a revocação usa só a linha dos doentes e a especificidade só a dos saudáveis. Cada uma é uma proporção dentro de uma classe, então não depende de quantos pacientes há em cada classe;
- a precisão, o VPN e a acurácia misturam as duas linhas. Quando a linha dos saudáveis fica 99 vezes maior que a dos doentes, mesmo uma FPR pequena produz uma enxurrada de alarmes falsos que afoga os verdadeiros positivos.
É o efeito da taxa de base. Duas consequências práticas: uma precisão medida em um conjunto de teste com uma prevalência não vale em produção se a prevalência mudar; o F1 (que contém a precisão) herda a mesma dependência. Ao reportar precisão, reporte a prevalência dos dados em que ela foi medida.
11. Métricas que resistem ao desbalanceamento: acurácia balanceada e MCC
Dois números únicos foram desenhados para resistir ao paradoxo da acurácia.
A acurácia balanceada é a média da revocação de cada classe, o que para duas classes é a média de revocação e especificidade:
- 20 pacientes: \((0{,}700 + 0{,}800) / 2 = 0{,}750\) (igual à acurácia, porque as classes são balanceadas);
- o modelo preguiçoso: revocação \(5/10 = 0{,}5\), especificidade \(980/990 = 0{,}990\), logo \((0{,}5 + 0{,}990) / 2 = 0{,}745\);
- sempre saudável: revocação 0, especificidade 1, logo 0,500, que é a acurácia balanceada de qualquer resposta constante.
O coeficiente de correlação de Matthews (MCC) é a correlação entre os rótulos verdadeiros e os previstos; ele usa as quatro células:
- 20 pacientes: \(\frac{7 \cdot 8 - 2 \cdot 3}{\sqrt{9 \cdot 10 \cdot 10 \cdot 11}} = \frac{50}{\sqrt{9\,900}} = \frac{50}{99{,}5} = 0{,}503\);
- o modelo preguiçoso: \(\frac{5 \cdot 980 - 10 \cdot 5}{\sqrt{15 \cdot 10 \cdot 990 \cdot 985}} = \frac{4\,850}{12\,094} = 0{,}401\);
- sempre saudável: TP = FP = 0, então um fator do denominador é zero; o scikit-learn devolve 0.
O MCC vai de −1 (sempre errado), passando por 0 (não melhor que o acaso ou que uma constante), até +1 (perfeito). Ele só é alto se o modelo for bem nas quatro células ao mesmo tempo; é por isso que Chicco & Jurman (2020) o recomendam no lugar da acurácia e do F1 em problemas binários.
from sklearn.metrics import balanced_accuracy_score, matthews_corrcoef, cohen_kappa_score

for name, yt, yp in [('20 patients', y_true, y_pred),
                     ('lazy model', y_1000, lazy),
                     ('always healthy', y_1000, always_healthy)]:
    print(f"{name:15s} accuracy {accuracy_score(yt, yp):.3f}   balanced {balanced_accuracy_score(yt, yp):.3f}"
          f"   MCC {matthews_corrcoef(yt, yp):.3f}   kappa {cohen_kappa_score(yt, yp):.3f}")
20 patients     accuracy 0.750   balanced 0.750   MCC 0.503   kappa 0.500
lazy model      accuracy 0.985   balanced 0.745   MCC 0.401   kappa 0.393
always healthy  accuracy 0.990   balanced 0.500   MCC 0.000   kappa 0.000
A acurácia põe a resposta constante em primeiro lugar (0,990 contra 0,985). A acurácia balanceada e o MCC invertem a ordem e a desmascaram: 0,500 e 0,000, o valor de um modelo que não aprendeu nada. A última coluna, o kappa de Cohen, é uma terceira opção no mesmo espírito: a acurácia corrigida pela concordância que um chute aleatório com as mesmas proporções de classe atingiria por acaso (0 = acaso, 1 = perfeito).
12. Multiclasse: um contra o resto, depois a média
Etapa 3. Com \(k\) classes a matriz de confusão é \(k \times k\): as linhas continuam sendo a verdade, as colunas a previsão e a diagonal os acertos. Considere um modelo de triagem que classifica 200 pacientes em risco baixo, médio e alto:
| verdade previsto | baixo | médio | alto | total |
|---|---|---|---|---|
| baixo | 110 | 9 | 1 | 120 |
| médio | 8 | 46 | 6 | 60 |
| alto | 2 | 8 | 10 | 20 |
| total | 120 | 63 | 17 | 200 |
Precisão, revocação e F1 são calculados por classe, um contra o resto (one-vs-rest): trate uma classe como "positiva" e junte as outras duas como "negativa". Para alto: TP = 10 (a célula da diagonal), FN = 2 + 8 = 10 (o resto da linha: pacientes de alto risco mandados para baixo ou médio), FP = 1 + 6 = 7 (o resto da coluna: pacientes mandados indevidamente para alto), TN = os 173 restantes. Assim:
| classe | precisão = diagonal / coluna | revocação = diagonal / linha | F1 | suporte |
|---|---|---|---|---|
| baixo | 110 / 120 = 0,917 | 110 / 120 = 0,917 | 0,917 | 120 |
| médio | 46 / 63 = 0,730 | 46 / 60 = 0,767 | 0,748 | 60 |
| alto | 10 / 17 = 0,588 | 10 / 20 = 0,500 | 0,541 | 20 |
Metade dos pacientes de alto risco, justamente aqueles para os quais a triagem existe, é mandada para um nível mais baixo. Para reportar um número só, os escores por classe são combinados de uma de três formas:
- macro: média simples sobre as classes, cada classe conta igual. \(F_1^{macro} = (0{,}917 + 0{,}748 + 0{,}541)/3 = 0{,}735\);
- ponderada (weighted): média ponderada pelo suporte de cada classe. \(F_1^{pond} = (120 \cdot 0{,}917 + 60 \cdot 0{,}748 + 20 \cdot 0{,}541)/200 = 0{,}828\);
- micro: primeiro somam-se as contagens de todas as classes. Todo erro é um FP para uma classe e um FN para outra, então FP total = FN total = 34 (todas as células fora da diagonal); logo, precisão = revocação = F1 = 166/200 = 0,830 = acurácia. Em problemas de rótulo único, o micro-F1 é sempre igual à acurácia.
from sklearn.metrics import classification_report

labels = ['low', 'medium', 'high']
counts = np.array([[110,  9,  1],     # verdade = baixo  (120 pacientes)
                   [  8, 46,  6],     # verdade = médio  ( 60 pacientes)
                   [  2,  8, 10]])    # verdade = alto   ( 20 pacientes)
# reconstrói uma linha por paciente a partir das contagens
y_t = [labels[i] for i in range(3) for j in range(3) for _ in range(counts[i, j])]
y_p = [labels[j] for i in range(3) for j in range(3) for _ in range(counts[i, j])]

print(confusion_matrix(y_t, y_p, labels=labels))
print(classification_report(y_t, y_p, labels=labels, digits=3))
print(f"micro F1 {f1_score(y_t, y_p, average='micro'):.3f} = accuracy {accuracy_score(y_t, y_p):.3f}")
[[110   9   1]
 [  8  46   6]
 [  2   8  10]]
              precision    recall  f1-score   support

         low      0.917     0.917     0.917       120
      medium      0.730     0.767     0.748        60
        high      0.588     0.500     0.541        20

    accuracy                          0.830       200
   macro avg      0.745     0.728     0.735       200
weighted avg      0.828     0.830     0.828       200

micro F1 0.830 = accuracy 0.830
O relatório confirma cada número da tabela feita à mão. Repare no argumento labels=labels: sem ele, as strings seriam ordenadas em ordem alfabética (high, low, medium).
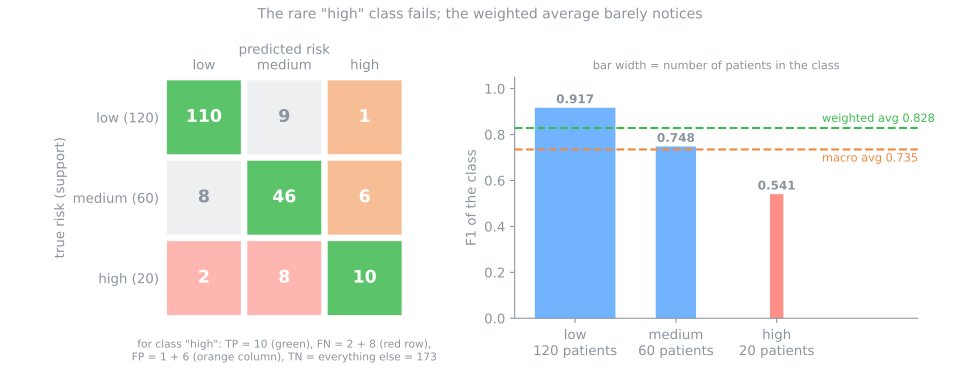
O F1 ponderado (0,828) parece quase tão bom quanto a grande classe baixo, porque baixo carrega 60% do peso. O F1 macro (0,735) dá aos 20 pacientes de alto risco a mesma voz dos 120 de baixo risco e cai 9 pontos. Quando a classe rara é a importante, reporte o macro-F1 e a revocação por classe e leia as células fora da diagonal: 8 pacientes de alto risco mandados para médio é um problema diferente de 2 mandados para baixo. Um detalhe: a revocação ponderada é sempre igual à acurácia (0,830 aqui), porque ponderar a revocação de cada classe pelo seu suporte simplesmente conta todos os acertos da diagonal.
13. Escores, limiares e calibração
Etapa 4. Tudo até aqui avaliou rótulos: o escore do modelo foi cortado em um limiar; só importava de que lado da linha ele ficava. P01 (0,95) e P09 (0,55) contam igual, um TP cada. Quando as próprias probabilidades são usadas como números (para precificar um risco, ordenar uma fila, dizer a um paciente "seu risco é de 30%"), elas precisam de uma nota própria. Duas métricas avaliam a probabilidade diretamente, sem limiar nenhum. Nas duas, menor é melhor.
A log loss (entropia cruzada) é a perda que a regressão logística minimiza no treino. Cada paciente custa \(-\ln\) da probabilidade que o modelo deu ao que de fato aconteceu:
O escore de Brier é o erro quadrático médio entre a probabilidade e o desfecho (0 ou 1):
À mão, para três dos pacientes:
| paciente | escore \(p\) | doente \(y\) | termo da log loss | termo do Brier |
|---|---|---|---|---|
| P01 | 0,95 | 1 | \(-\ln 0{,}95 = 0{,}051\) | \((0{,}95 - 1)^2 = 0{,}0025\) |
| P05 | 0,75 | 0 | \(-\ln (1 - 0{,}75) = 1{,}386\) | \((0{,}75 - 0)^2 = 0{,}5625\) |
| P15 | 0,20 | 1 | \(-\ln 0{,}20 = 1{,}609\) | \((0{,}20 - 1)^2 = 0{,}64\) |
Uma resposta certa e confiante (P01) quase não custa nada; uma resposta errada e confiante custa muito. A log loss a pune bem mais que o Brier (−ln cresce sem limite quando \(p \to 0\); o quadrado nunca passa de 1). Veja a média nos 20 pacientes e a de um segundo modelo que toma as mesmas decisões em 0,5, mas declara toda probabilidade como 0,99 ou 0,01:
from sklearn.metrics import log_loss, brier_score_loss

print(f"log loss {log_loss(y_true, score):.3f}   Brier {brier_score_loss(y_true, score):.3f}")

# mesmos rótulos em 0,5, mas toda probabilidade empurrada para 0,99 / 0,01
bold = np.where(score >= 0.5, 0.99, 0.01)
print(f"accuracy {accuracy_score(y_true, bold >= 0.5):.2f} (was {accuracy_score(y_true, y_pred):.2f})")
print(f"log loss {log_loss(y_true, bold):.3f}   Brier {brier_score_loss(y_true, bold):.3f}")
O modelo ousado tem a mesma matriz de confusão, logo a mesma acurácia, precisão, revocação e F1: todas as métricas das seções anteriores são cegas à diferença. A log loss e o Brier não são. Os cinco erros, agora declarados com 99% de confiança, custam \(-\ln 0{,}01 = 4{,}6\) cada; a log loss sobe de 0,463 para 1,159. As probabilidades dele são piores, mesmo com rótulos idênticos.
A pergunta vizinha é a calibração: entre os pacientes a quem o modelo diz "70%", cerca de 70% estão de fato doentes? Uma curva de calibração (sklearn.calibration.CalibrationDisplay) responde agrupando as previsões em faixas e comparando o escore médio de cada faixa com a fração observada de positivos; a log loss e o Brier resumem a mesma qualidade em um número. O lado de ordenação dos escores, o quanto eles separam doentes de saudáveis em todos os limiares, é avaliado pelas curvas ROC e precisão–revocação da próxima aula.
14. Como escolher uma métrica
Não existe a melhor métrica, só a métrica que corresponde ao custo dos erros do seu problema. Decida antes de treinar, registre a escolha e sempre imprima a baseline ao lado.
| cenário | o erro caro | acompanhe | por quê |
|---|---|---|---|
| rastreamento de câncer (um positivo leva a um segundo exame) | FN: um tumor não detectado | revocação, F2; especificidade ao lado | um alarme falso custa um exame, um escape pode custar uma vida |
| exame confirmatório antes de cirurgia ou quimioterapia | FP: tratar uma pessoa saudável | precisão, especificidade | a ação tomada sobre um positivo é invasiva |
| filtro de spam | FP: um e-mail de verdade perdido | precisão, F0,5 | spam na caixa de entrada incomoda, uma oferta de emprego perdida não tem volta |
| triagem de fraude, analistas conseguem checar 50 alertas por dia | os dois, com capacidade fixa | precisão entre os 50 maiores escores; revocação como segundo número | a capacidade fixa quantos alertas são disparados |
| descartar uma doença e mandar o paciente para casa | FN: um doente mandado para casa | VPN, revocação | é a resposta negativa que vira ação |
| aprovação de crédito | emprestar a quem não paga vs recusar um bom pagador | o custo esperado de cada célula, em dinheiro; revocação e precisão de "inadimplente" | cada célula tem um preço |
| um número para um benchmark binário desbalanceado | qualquer | MCC ou acurácia balanceada, mais a baseline | acurácia e F1 ignoram parte da matriz |
| multiclasse com uma classe rara e importante | falhar na classe rara | macro-F1 e revocação por classe | as médias ponderada e micro seguem as classes grandes |
| probabilidades usadas como números (precificação de risco, ordem de fila) | probabilidades erradas | log loss, Brier, curva de calibração | as métricas de rótulo nunca olham para a probabilidade |
Lab avançado — probabilidades, limiar e multiclasse
Os passos 8 a 11 retomam quatro temas desta parte: a log loss e o Brier avaliando as probabilidades, o F-beta escolhendo o ponto de operação, o teste tocado uma única vez e um relatório multiclasse.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Use o mesmo notebook do Colab do lab fundamental e vá até o passo 8. Nada para baixar.
- Os passos 8 a 11 usam os modelos ajustados nos passos 3 e 4. Se a sessão do Colab for nova (ou tiver expirado), clique na célula do passo 8 e use Ambiente de execução → Executar anteriores (Ctrl+F8) antes de continuar.
- A dinâmica é a mesma: Preveja antes de rodar, compare com a página e tente as Simulações antes de abrir a solução.
- Ritmo sugerido: passos 8 e 9 em 15 min; passos 10 e 11 em 10 min; discussão final em 5 min.
Passo 8 — avaliando as probabilidades
Preveja. Com k = 5, a "probabilidade" do k-NN é uma contagem de votos dividida por 5. Se uma mulher com diabetes tiver as cinco vizinhas mais próximas sem diabetes, que probabilidade ela recebe? O que uma resposta dessas faz com a log loss?
from sklearn.metrics import brier_score_loss, log_loss

prior = DummyClassifier(strategy='prior').fit(X_train, y_train)   # sempre responde 34,8%
for name, m in [('dummy prior', prior), ('logistic', logreg), ('k-NN', knn)]:
    p = m.predict_proba(X_val)[:, 1]
    print(f"{name:12s} log loss {log_loss(y_val, p):.3f}   Brier {brier_score_loss(y_val, p):.3f}")

votes = knn.predict_proba(X_val)[:, 1]          # fração dos 5 vizinhos com diabetes
print(pd.crosstab(votes, y_val, rownames=['k-NN probability'], colnames=['diabetes']))
dummy prior  log loss 0.648   Brier 0.228
logistic     log loss 0.452   Brier 0.148
k-NN         log loss 1.290   Brier 0.146
diabetes           0   1
k-NN probability
0.0               51   3
0.2               25   7
0.4               11   9
0.6               11  18
0.8                1  13
1.0                1   4
Na log loss a ordem se inverte: a regressão logística (0,452) vence a baseline que sempre diz 34,8% (0,648), enquanto o k-NN fica pior que a baseline (1,290). A tabela explica por quê. Com k = 5, uma "probabilidade" do k-NN é uma contagem de votos dividida por 5, então só pode valer 0, 0,2, …, 1. Três mulheres com diabetes tinham cinco vizinhas saudáveis e receberam probabilidade exatamente 0; uma mulher saudável recebeu exatamente 1. A log loss de uma resposta dada com certeza absoluta que se revela errada é infinita; o scikit-learn a limita a \(-\ln(2{,}2\times10^{-16}) \approx 36\) por paciente. Só essas 4 mulheres somam 0,94 à média. O Brier, limitado a 1 por paciente, quase não percebe (0,146 contra 0,148).
Então qual modelo é melhor depende da métrica: o k-NN nos rótulos em 0,5, a regressão logística, de longe, nas probabilidades. Para uma ferramenta de triagem cujo limiar vamos mover em seguida, são as probabilidades que vamos cortar; probabilidades de 5 votos oferecem só seis pontos de corte possíveis. Os próximos passos seguem com a regressão logística.
Simulação: um k maior conserta as probabilidades? O problema do k-NN aqui é a granularidade grosseira dos votos: com k = 5 só existem seis probabilidades possíveis e duas delas são 0 e 1. Refaça a medida com k = 25 e k = 75, contando quantos valores distintos aparecem e quantas previsões saem exatamente em 0 ou 1. A log loss consegue descer abaixo da baseline? E o Brier, acompanha?
Solução
for k in [5, 25, 75]:
    m = make_pipeline(SimpleImputer(strategy='median'), StandardScaler(),
                      KNeighborsClassifier(n_neighbors=k)).fit(X_train, y_train)
    p = m.predict_proba(X_val)[:, 1]
    print(f"k={k:3d}  valores distintos {len(np.unique(p)):3d}  p=0 ou 1: {((p == 0) | (p == 1)).sum():3d}"
          f"   log loss {log_loss(y_val, p):.3f}   Brier {brier_score_loss(y_val, p):.3f}")
print(f"baseline (sempre 34,8%)                          log loss {log_loss(y_val, np.full(len(y_val), y_train.mean())):.3f}")
k=  5  valores distintos   6  p=0 ou 1:  59   log loss 1.290   Brier 0.146
k= 25  valores distintos  21  p=0 ou 1:  10   log loss 0.443   Brier 0.147
k= 75  valores distintos  47  p=0 ou 1:   0   log loss 0.467   Brier 0.154
baseline (sempre 34,8%)                          log loss 0.648
Com k = 5, 59 das 154 mulheres recebem 0 ou 1, uma certeza absoluta que o modelo não tem; basta uma dessas estar errada para a log loss disparar. Com k = 25 sobram 10 respostas extremas e a log loss cai de 1,290 para 0,443, agora bem abaixo da baseline de 0,648; com k = 75 nenhuma previsão é extrema, mas a log loss volta a subir um pouco (0,467), porque uma média sobre 75 vizinhas é vaga demais. O Brier mal se move nas três (0,146 a 0,154): ele é limitado a 1 por paciente e por isso quase não enxerga o problema que derruba a log loss. Duas métricas de probabilidade, dois diagnósticos diferentes — vale olhar as duas.
Passo 9 — mexendo no limiar, na validação
Preveja. Baixar o limiar de 0,5 para 0,3 encontra mais mulheres com diabetes. O que piora em troca? Você espera que o F1 registre bem essa troca?
from sklearn.metrics import fbeta_score

proba_val = logreg.predict_proba(X_val)[:, 1]
rows = []
for t in [0.3, 0.5, 0.7]:
    pred = (proba_val >= t).astype(int)
    tp, fn, fp, tn = confusion_matrix(y_val, pred, labels=[1, 0]).ravel()
    rows.append({'threshold': t, 'TP': tp, 'FP': fp, 'FN': fn, 'TN': tn,
                 'precision': precision_score(y_val, pred), 'recall': recall_score(y_val, pred),
                 'F1': f1_score(y_val, pred), 'F2': fbeta_score(y_val, pred, beta=2)})
table = pd.DataFrame(rows)
print(table.round(3).to_string(index=False))
best_t = table.loc[table['F2'].idxmax(), 'threshold']
print(f"highest F2 on validation: threshold {best_t}")
 threshold  TP  FP  FN  TN  precision  recall    F1    F2
       0.3  40  28  14  72      0.588   0.741 0.656 0.704
       0.5  32  12  22  88      0.727   0.593 0.653 0.615
       0.7  24   4  30  96      0.857   0.444 0.585 0.492
highest F2 on validation: threshold 0.3
O mesmo modelo, três decisões. Em 0,7 a ferramenta é precisa (86% dos alarmes estão certos), mas deixa escapar 30 das 54 mulheres com diabetes. Em 0,3 deixa escapar 14, ao preço de 28 alarmes falsos em vez de 4. O F1 quase não se mexe entre 0,3 e 0,5 (0,656 contra 0,653): ele pesa os dois erros por igual e não vê razão para preferir um ao outro. Na triagem, em que um alarme falso custa um exame de glicose confirmatório e um escape custa anos de diabetes sem tratamento, dissemos que o escape importa mais; o F2 traduz isso: 0,704 em 0,3 contra 0,615 em 0,5. A escolha é feita na validação, entre apenas três candidatos; assim, o conjunto de teste continua honesto.
Simulação: o β escolhe o limiar. O passo 9 comparou três limiares escolhidos à mão. Varra o limiar de 0,10 a 0,90, de 0,05 em 0,05 e encontre o limiar que maximiza cada um de F0,5, F1 e F2 na validação. Quantos escapes e quantos alarmes falsos cada escolha produz?
Solução
proba_val = logreg.predict_proba(X_val)[:, 1]
grid = np.arange(0.10, 0.91, 0.05)
for beta, name in [(0.5, 'F0.5'), (1, 'F1'), (2, 'F2')]:
    sc = [fbeta_score(y_val, (proba_val >= t).astype(int), beta=beta) for t in grid]
    best = grid[int(np.argmax(sc))]
    pred = (proba_val >= best).astype(int)
    print(f"{name:4s} melhor limiar {best:.2f}  ->  escapes {((y_val == 1) & (pred == 0)).sum():2d}"
          f"   alarmes falsos {((y_val == 0) & (pred == 1)).sum():2d}   {name} {max(sc):.3f}")
F0.5 melhor limiar 0.60  ->  escapes 25   alarmes falsos  7   F0.5 0.732
F1   melhor limiar 0.25  ->  escapes 10   alarmes falsos 30   F1 0.688
F2   melhor limiar 0.10  ->  escapes  1   alarmes falsos 64   F2 0.796
O mesmo modelo e a mesma validação produzem três ferramentas de triagem bem diferentes e quem escolhe é o \(\beta\). O F0,5 protege os saudáveis: 7 alarmes falsos, mas 25 mulheres com diabetes mandadas para casa. O F2 faz o oposto e quase não deixa escapar ninguém (1 escape), ao preço de encaminhar 64 das 100 mulheres sem diabetes. Repare que maximizar o F2 sozinho empurra o limiar para a ponta da grade: a métrica não conhece a capacidade do laboratório. Por isso, na prática, o \(\beta\) é escolhido junto com uma restrição operacional ("no máximo 30 encaminhamentos por semana") e não maximizado no vácuo.
Passo 10 — o único teste
Preveja. O limiar 0,3 foi escolhido na validação. No teste, você espera um resultado parecido, melhor ou pior? E a acurácia no teste vai ser maior ou menor que a do limiar 0,5 do passo 5?
pred_test = (logreg.predict_proba(X_test)[:, 1] >= best_t).astype(int)
print(confusion_matrix(y_test, pred_test, labels=[1, 0]))
final = scores(y_test, pred_test)
final['F2'] = fbeta_score(y_test, pred_test, beta=2)
print(pd.Series(final).round(3).to_string())
[[43 11]
 [28 72]]
accuracy       0.747
precision      0.606
recall         0.796
specificity    0.720
F1             0.688
balanced       0.758
MCC            0.494
F2             0.749
Em 154 mulheres que nunca viu, a ferramenta de triagem encontra 43 das 54 mulheres com diabetes (revocação 0,796) e manda 28 de 100 mulheres saudáveis para um exame confirmatório desnecessário (especificidade 0,720, precisão 0,606). Os números estão de acordo com a linha de 0,3 na validação (revocação 0,741, F2 0,704); o teste saiu um pouco melhor, o que com 54 positivos é uma diferença de três mulheres. Repare que a acurácia (0,747) é menor que os 0,779 do limiar 0,5 no passo 5: trocamos acurácia por revocação de propósito; olhando só a acurácia, teríamos desfeito a troca. Este é o número a reportar, junto com a baseline do passo 7 (acurácia balanceada 0,500, MCC 0).
Passo 11 — multiclasse: quais dígitos se confundem?
Preveja. Em dígitos manuscritos, que pares você espera ver confundidos? Com dez classes de tamanho quase igual, os F1 macro, ponderado e micro vão diferir muito?
from sklearn.datasets import load_digits

Xd, yd = load_digits(return_X_y=True)                     # imagens 8x8 dos dígitos 0-9
Xd_train, Xd_test, yd_train, yd_test = train_test_split(Xd, yd, test_size=0.3, stratify=yd,
                                                        random_state=42)
digits = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(Xd_train, yd_train)
pred_d = digits.predict(Xd_test)

cm = confusion_matrix(yd_test, pred_d)
print(cm)
off = cm.copy()
np.fill_diagonal(off, 0)                                  # fica só com os erros
for i, j in zip(*np.nonzero(off >= 2)):
    print(f"true {i} predicted as {j}: {off[i, j]} times")
print(f"lowest recall: digit {np.argmin(recall_score(yd_test, pred_d, average=None))}")
for avg in ['macro', 'weighted', 'micro']:
    print(f"{avg:8s} F1 {f1_score(yd_test, pred_d, average=avg):.4f}")
print(f"accuracy    {accuracy_score(yd_test, pred_d):.4f}")
ConfusionMatrixDisplay.from_predictions(yd_test, pred_d, colorbar=False)
plt.show()
[[54  0  0  0  0  0  0  0  0  0]
 [ 0 52  0  0  1  0  0  0  2  0]
 [ 0  0 53  0  0  0  0  0  0  0]
 [ 0  0  0 55  0  0  0  0  0  0]
 [ 0  0  0  0 53  0  0  0  1  0]
 [ 0  0  0  0  0 54  0  0  0  1]
 [ 0  0  0  0  0  0 53  0  1  0]
 [ 0  0  0  0  0  0  0 54  0  0]
 [ 0  3  0  0  0  0  0  0 49  0]
 [ 0  0  0  0  0  0  0  0  1 53]]
true 1 predicted as 8: 2 times
true 8 predicted as 1: 3 times
lowest recall: digit 8
macro    F1 0.9814
weighted F1 0.9816
micro    F1 0.9815
accuracy    0.9815
Uma matriz 10×10 de 540 imagens de teste. Quase tudo está na diagonal (98,15% de acurácia). As células fora dela mostram onde estão os 10 erros: o único par confundido mais de uma vez é 1 ↔ 8 (cinco erros entre os dois); a coluna 8 reúne cinco dos dez erros, ou seja, o modelo usa o "8" como palpite para traços ambíguos. O dígito 8 tem a menor revocação (49/52 = 0,942). Aqui os F1 macro, ponderado e micro concordam até a terceira casa, porque as dez classes têm quase a mesma frequência (de 52 a 55 imagens de teste cada): as médias só discordam quando as classes diferem em tamanho e em qualidade, como no exemplo da triagem. O micro-F1 é igual à acurácia, como sempre em problemas de rótulo único.
Para fechar a aula. Em uma frase cada: (1) por que o k-NN com k = 5 ficou pior que a baseline na log loss, mesmo ganhando em F1? (2) Por que uma precisão medida neste conjunto não vale na população geral? (3) Em que situação o F1 macro e o ponderado discordam?
Sua vez (avançado)
Para casa, com mais tempo:
- O outro modelo. Repita o passo 9 com
knnno lugar delogreg. Quais dos limiares 0,3, 0,5 e 0,7 dão matrizes de confusão diferentes e por quê? (Dica: que valores uma probabilidade de 5 votos pode assumir?) - Limiar com restrição. Varra o limiar de 0,10 a 0,90 na validação, faça o gráfico de precisão e revocação em função do limiar e encontre o menor limiar com precisão ≥ 0,6. Que revocação você obtém? Compare com o limiar que o F2 escolheu na simulação do passo 9.
- Pesos de classe. Ajuste
LogisticRegression(max_iter=1000, class_weight='balanced')no pipeline e refaça os passos 5 e 7 com limiar 0,5. Compare com o modelo sem pesos no limiar 0,3. As duas maneiras de trocar precisão por revocação são muito diferentes? - Uma classe rara. No passo 11, descarte 90% das imagens de treino e de teste do dígito 8 (fique com 10%), reajuste e compare de novo os F1 macro e ponderado. Qual deles se mexe e por quê?
Referências
- van Rijsbergen, C. J. Information Retrieval. 2. ed. Butterworths, 1979 — o capítulo 7 (Evaluation) define a medida de efetividade da qual vêm a medida F e o \(F_\beta\). Texto completo
- Matthews, B. W. "Comparison of the Predicted and Observed Secondary Structure of T4 Phage Lysozyme." Biochimica et Biophysica Acta — Protein Structure 405, n. 2 (1975): 442–451 — o coeficiente de correlação hoje conhecido como MCC. DOI
- Brier, G. W. "Verification of Forecasts Expressed in Terms of Probability." Monthly Weather Review 78, n. 1 (1950): 1–3 — o escore de Brier, usado primeiro em previsões do tempo. DOI
- Fawcett, T. "An Introduction to ROC Analysis." Pattern Recognition Letters 27 (2006): 861–874 — a matriz de confusão, as métricas derivadas dela e a curva ROC da próxima aula. DOI
- Chicco, D.; Jurman, G. "The Advantages of the Matthews Correlation Coefficient (MCC) over F1 Score and Accuracy in Binary Classification Evaluation." BMC Genomics 21 (2020): 6. DOI
Quiz
O quiz cobre a abordagem fundamental.