O caminho desta parte
- Pesar os errosF-beta: o β diz quanto a revocação importa mais
- Quando os positivos são rarosa prevalência move a precisão; a acurácia balanceada e o MCC (coeficiente de correlação de Matthews) resistem
- Muitas classesum contra o resto, depois a média macro, ponderada ou micro
- Avaliar a probabilidadelog loss, escore de Brier, calibração
F-beta: tornando a troca explícita
\[ F_\beta = \frac{(1 + \beta^2)\,P \cdot R}{\beta^2 P + R} = \frac{(1 + \beta^2)\,TP}{(1 + \beta^2)\,TP + \beta^2\,FN + FP} \]| significado | nos 20 pacientes | |
|---|---|---|
| \(F_{0,5}\) | um alarme falso pesa 4× um escape | 0,761 |
| \(F_1\) | os dois pesam igual | 0,737 |
| \(F_2\) | um escape pesa 4× um alarme falso | 0,714 |
\(P\) = precisão, \(R\) = revocação; TP, FP, FN e TN = verdadeiros positivos, falsos positivos, falsos negativos e verdadeiros negativos. Use F2 em rastreamento e F0,5 quando alarmes são caros. Escolher \(\beta\) é uma afirmação sobre custos.
O \(\beta\) desloca o ponto de operação
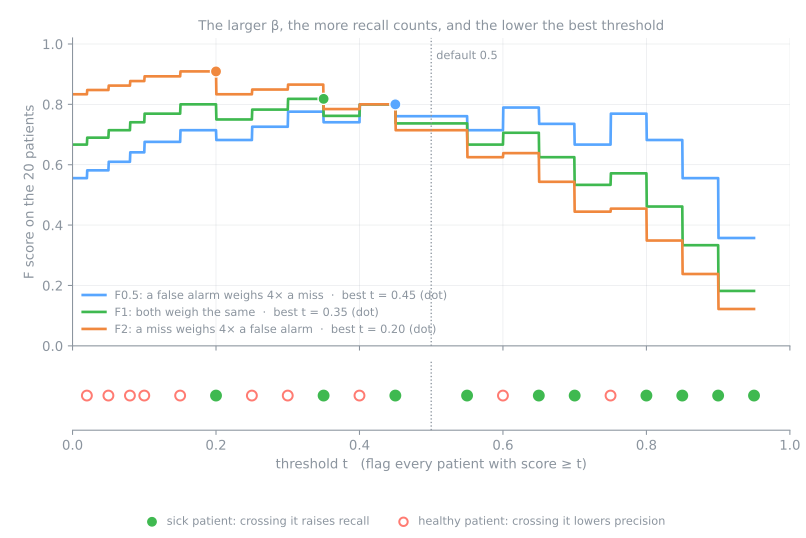
Como ler
- eixo x: o limiar \(t\); a faixa de baixo mostra os 20 pacientes nos seus escores;
- cada degrau: o limiar cruza um paciente. Um doente (●) sobe a revocação; um saudável (○) derruba a precisão;
- eixo y: o valor de F0,5, F1 e F2 naquele limiar;
- ponto: o limiar que maximiza cada um.
A prevalência muda a precisão
O mesmo modelo (sensibilidade 0,70, especificidade 0,80) em 10.000 pessoas; VPN = valor preditivo negativo:
| prevalência | TP | FP | precisão | VPN | acurácia |
|---|---|---|---|---|---|
| 50% | 3500 | 1000 | 0,778 | 0,727 | 0,750 |
| 10% | 700 | 1800 | 0,280 | 0,960 | 0,790 |
| 1% | 70 | 1980 | 0,034 | 0,996 | 0,799 |
Por que algumas métricas não se mexem
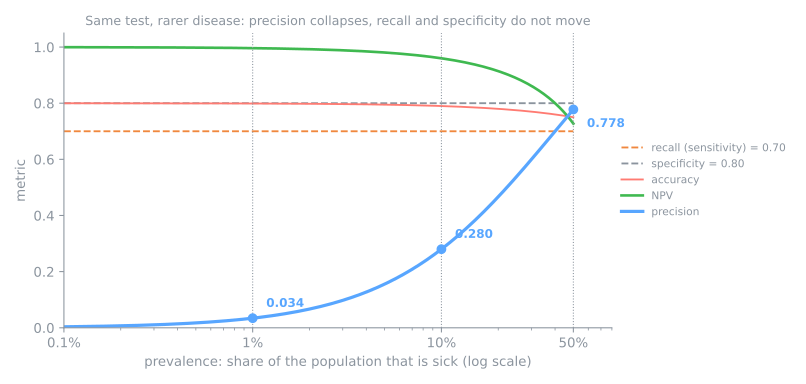
- Revocação usa só a linha dos doentes e especificidade só a dos saudáveis: são proporções dentro de uma classe, então não dependem do tamanho das classes — as retas horizontais.
- Precisão, VPN e acurácia misturam as duas linhas e por isso se movem.
Métricas que resistem ao desbalanceamento
\[ \text{acurácia balanceada} = \frac{\text{revocação} + \text{especificidade}}{2} \qquad \text{MCC} = \frac{TP \cdot TN - FP \cdot FN}{\sqrt{(TP{+}FP)(TP{+}FN)(TN{+}FP)(TN{+}FN)}} \]| acurácia | balanceada | MCC | kappa de Cohen | |
|---|---|---|---|---|
| 20 pacientes | 0,750 | 0,750 | 0,503 | 0,500 |
| modelo preguiçoso | 0,985 | 0,745 | 0,401 | 0,393 |
| sempre "saudável" | 0,990 | 0,500 | 0,000 | 0,000 |
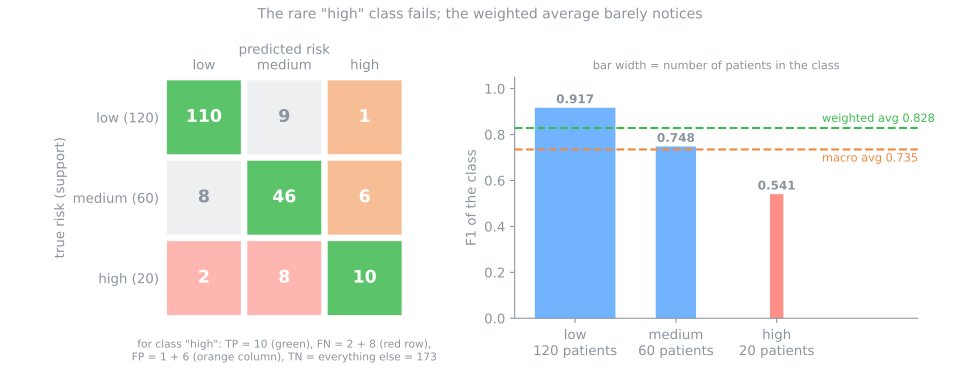
Multiclasse: a matriz cresce
| verdade \ prev. | baixo | médio | alto |
|---|---|---|---|
| baixo | 110 | 9 | 1 |
| médio | 8 | 46 | 6 |
| alto | 2 | 8 | 10 |
200 pacientes triados em risco baixo, médio e alto.
Precisão e revocação são calculadas por classe, um contra o resto. Para alto:
- TP = 10 (a diagonal)
- FN = 2 + 8 = 10 (o resto da linha)
- FP = 1 + 6 = 7 (o resto da coluna)
Três maneiras de virar um número só
| classe | F1 | suporte |
|---|---|---|
| baixo | 0,917 | 120 |
| médio | 0,748 | 60 |
| alto | 0,541 | 20 |
- macro = 0,735 · cada classe conta igual
- ponderada = 0,828 · pesa pelo suporte
- micro = 0,830 = acurácia
Avaliando a probabilidade, não o rótulo
\[ \text{log loss} = -\frac{1}{n}\sum_i \big[ y_i \ln p_i + (1 - y_i)\ln(1 - p_i) \big] \qquad \text{Brier} = \frac{1}{n}\sum_i (p_i - y_i)^2 \]| paciente | escore | doente | log loss | Brier |
|---|---|---|---|---|
| P01 | 0,95 | 1 | 0,051 | 0,0025 |
| P05 | 0,75 | 0 | 1,386 | 0,5625 |
| P15 | 0,20 | 1 | 1,609 | 0,64 |
Mesmos rótulos, probabilidades piores
Um segundo modelo toma as mesmas decisões em 0,5, mas declara toda probabilidade como 0,99 ou 0,01:
| modelo | acurácia | precisão | F1 | log loss | Brier |
|---|---|---|---|---|---|
| original | 0,75 | 0,778 | 0,737 | 0,463 | 0,157 |
| ousado (0,99 / 0,01) | 0,75 | 0,778 | 0,737 | 1,159 | 0,245 |
A pergunta vizinha é a calibração: entre os pacientes a quem o modelo diz "70%", cerca de 70% estão de fato doentes?
Como escolher uma métrica
| cenário | o erro caro | acompanhe |
|---|---|---|
| rastreamento de câncer | FN: um tumor não detectado | revocação, F2 |
| exame confirmatório antes de cirurgia | FP: tratar uma pessoa saudável | precisão, especificidade |
| filtro de spam | FP: um e-mail de verdade perdido | precisão, F0,5 |
| descartar doença e mandar para casa | FN: um doente liberado | VPN, revocação |
| benchmark binário desbalanceado | qualquer | MCC ou acurácia balanceada |
| multiclasse com classe rara importante | falhar na classe rara | macro-F1 e revocação por classe |
| probabilidades usadas como números | probabilidades erradas | log loss, Brier, calibração |
Probabilidades, limiar e multiclasse: passos 8 a 11
- Mesmo notebook do Colab, a partir do passo 8. Sessão nova? Ambiente de execução → Executar anteriores.
- Passo 8: a log loss derruba o k-NN (1,290, pior que a baseline); simulação: um k maior conserta as probabilidades?
- Passo 9: o limiar na validação; simulação: o β escolhe o limiar.
- Passos 10 e 11: o teste tocado uma vez e um relatório multiclasse.
Ritmo: passos 8 e 9 em 15 min; 10 e 11 em 10 min; discussão em 5 min.