Dois erros, dois preços
Escape (falso negativo)
- um câncer não detectado pode custar uma vida;
- uma fraude aprovada custa o valor inteiro.
Alarme falso (falso positivo)
- um exame de acompanhamento custa dinheiro e um susto;
- um cartão bloqueado custa um telefonema.
O caminho desta parte
- Contar os erros20 pacientes, quatro grupos, a matriz de confusão
- Acurácia não bastaa fração de acertos e o seu paradoxo
- Uma pergunta por métricaprecisão, revocação, especificidade e as outras: uma linha ou uma coluna cada
- Limiar e F1mover a linha troca um erro pelo outro; o F1 resume os dois
O exemplo da aula: 20 pacientes
Um modelo deu a cada paciente um escore; exames posteriores revelaram quem estava doente. Dez doentes, dez saudáveis.
| id | escore | doente | id | escore | doente | |
|---|---|---|---|---|---|---|
| P01 | 0,95 | 1 | P10 | 0,45 | 1 | |
| P05 | 0,75 | 0 | P12 | 0,35 | 1 | |
| P08 | 0,60 | 0 | P15 | 0,20 | 1 | |
| … | … | … | … | … | … |
Quatro grupos, quatro contagens
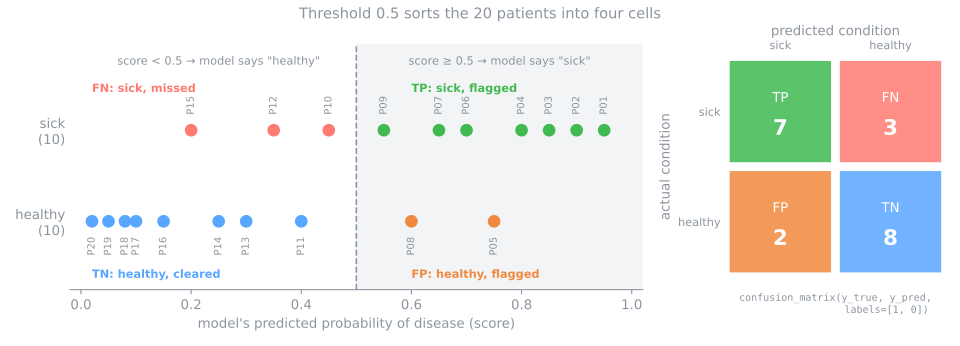
- TP = 7 verdadeiro positivo: doente e marcado
- FP = 2 falso positivo: saudável, marcado (alarme falso)
- FN = 3 falso negativo: doente, não marcado (escape)
- TN = 8 verdadeiro negativo: saudável, não marcado
As siglas vêm do inglês: true/false positive/negative.
A matriz de confusão
O layout padrão: real nas linhas, previsto nas colunas, positivo primeiro.
| prev. doente | prev. saudável | |
|---|---|---|
| doente | TP = 7 | FN = 3 |
| saudável | FP = 2 | TN = 8 |
No scikit-learn, com labels=[1, 0]:
cm = confusion_matrix(y_true, y_pred, labels=[1, 0])
# [[7 3]      TP FN
#  [2 8]]     FP TN
tp, fn, fp, tn = cm.ravel()
labels, o scikit-learn ordena os rótulos (0 primeiro) e devolve [[TN, FP], [FN, TP]]: o canto superior esquerdo vira TN. Trocar os argumentos transpõe a matriz e troca FP com FN sem aviso.Acurácia: a diagonal sobre o total
\[ \text{acurácia} = \frac{TP + TN}{\text{todos}} = \frac{7 + 8}{20} = 0{,}750 \]- Aqui as classes são equilibradas (10 e 10), então uma resposta constante marcaria 0,50: 0,75 é uma melhora real.
- A acurácia é um bom resumo quando as classes são equilibradas e os dois erros custam o mesmo.
O paradoxo da acurácia
1.000 pacientes, 10 deles doentes (prevalência de 1%):
| modelo | acurácia | revocação |
|---|---|---|
| sempre "saudável" | 0,990 | 0,00 |
| preguiçoso (acha 5 de 10, 10 alarmes falsos) | 0,985 | 0,50 |
- A resposta constante marca 99,0% e não encontra ninguém.
- O modelo que ao menos acha metade dos doentes marca menos.
DummyClassifier).Simulador: uma matriz, todas as métricas
Preveja. Aperte o modelo preguiçoso (sensibilidade 50%, especificidade 99%, prevalência 1%). A acurácia dele vai superar a baseline que sempre prevê a maioria?
Cada métrica lê uma linha ou uma coluna (1/2): as linhas
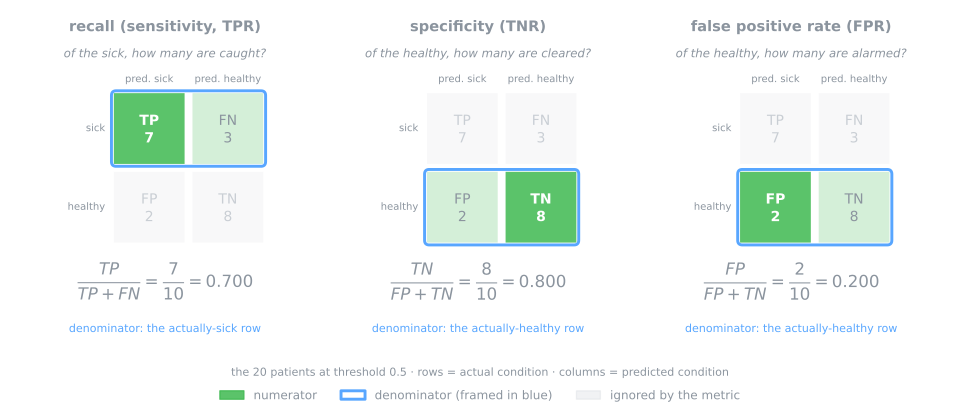
Verde = numerador; moldura azul = denominador. As linhas são a condição real: revocação, especificidade e FPR perguntam "dos que de fato eram doentes (ou saudáveis), quantos…?".
Cada métrica lê uma linha ou uma coluna (2/2): as colunas
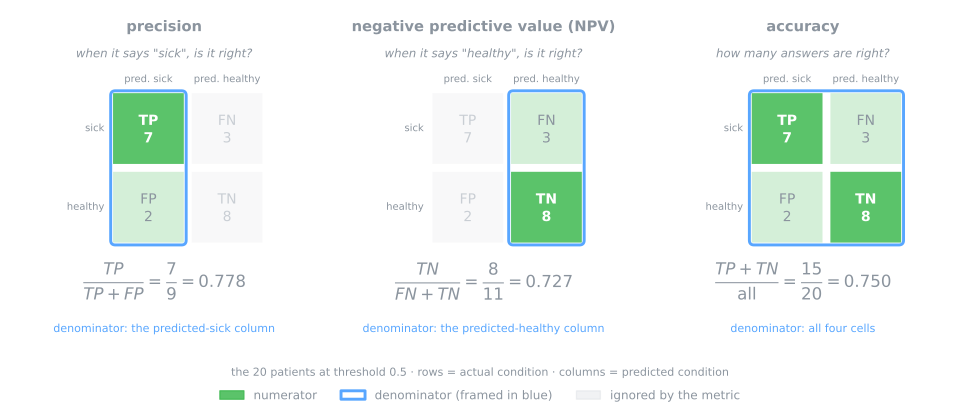
As colunas são a previsão: precisão e VPN perguntam "quando o modelo disse doente (ou saudável), acertou?". Sabendo quais células a métrica usa, você sabe o que ela mede e o que ela ignora.
Precisão e revocação
Precisão — a coluna dos marcados
\[ \frac{TP}{TP + FP} = \frac{7}{9} = 0{,}778 \]Quando ele diz "doente", acerta? Ignora os escapes.
Importa quando agir sobre um alarme é caro: filtro de spam, cirurgia, equipe com 50 ligações por dia.
Revocação — a linha dos doentes
\[ \frac{TP}{TP + FN} = \frac{7}{10} = 0{,}700 \]Dos doentes, quantos são pegos? Ignora os alarmes falsos.
Importa quando um escape é caro: rastreamento de câncer, fraude, trinca em avião.
Também chamadas de VPP (valor preditivo positivo) e de sensibilidade (a TPR, true positive rate, taxa de verdadeiros positivos), o eixo vertical da curva ROC (receiver operating characteristic).
Especificidade, FPR e VPN
Especificidade
\[ \frac{TN}{TN + FP} \] \[ = \frac{8}{10} = 0{,}800 \]FPR
\[ \frac{FP}{FP + TN} \] \[ = \frac{2}{10} = 0{,}200 \]= 1 − especificidade
VPN
\[ \frac{TN}{TN + FN} \] \[ = \frac{8}{11} = 0{,}727 \]- Especificidade (ou TNR, true negative rate) e FPR (false positive rate, taxa de falsos positivos) leem a linha dos saudáveis: dos 10 saudáveis, 8 foram deixados em paz e 2 receberam alarme falso.
- O VPN (valor preditivo negativo) lê a coluna dos mandados para casa: dos 11 liberados, 8 estavam de fato saudáveis. É ele que importa quando é a resposta negativa que vira ação.
Tudo num lugar só
| métrica | pergunta | células | valor |
|---|---|---|---|
| acurácia | quantas respostas estão certas? | (7 + 8) / 20 | 0,750 |
| precisão (VPP) | quando diz "doente", acerta? | 7 / 9 | 0,778 |
| revocação (TPR) | dos doentes, quantos são pegos? | 7 / 10 | 0,700 |
| especificidade (TNR) | dos saudáveis, quantos ficam em paz? | 8 / 10 | 0,800 |
| FPR | dos saudáveis, quantos recebem alarme? | 2 / 10 | 0,200 |
| VPN | quando diz "saudável", acerta? | 8 / 11 | 0,727 |
pos_label=0.O limiar é uma decisão
| limiar | TP | FP | FN | TN | precisão | revocação |
|---|---|---|---|---|---|---|
| 0,3 | 9 | 4 | 1 | 6 | 0,692 | 0,900 |
| 0,5 | 7 | 2 | 3 | 8 | 0,778 | 0,700 |
| 0,7 | 5 | 1 | 5 | 9 | 0,833 | 0,500 |
As duas curvas são escadas
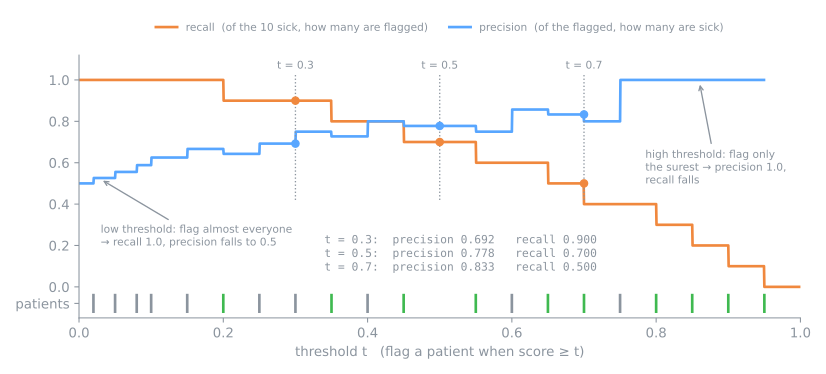
Elas só mudam quando o limiar cruza o escore de um paciente. A revocação só pode cair; a precisão tende a subir, com recuos (de 0,65 para 0,70 ela cai, porque o P07 é doente).
F1: um número a partir de dois
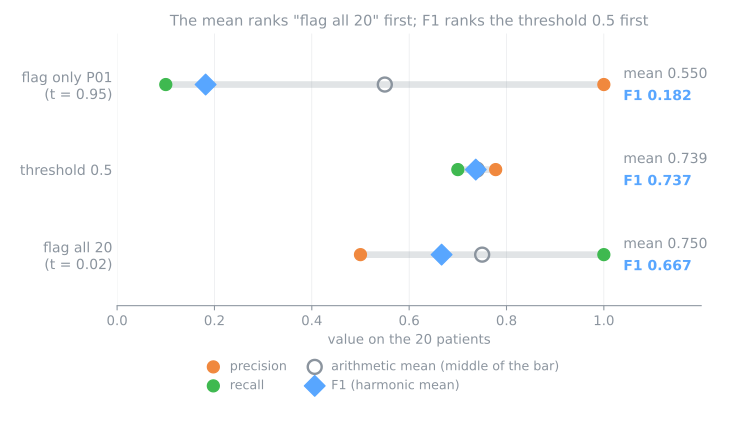
\[ F_1 = \frac{2 \cdot P \cdot R}{P + R} = \frac{2\,TP}{2\,TP + FP + FN} = \frac{14}{19} = 0{,}737 \]\(P\) = precisão, \(R\) = revocação (recall). Repare no que não está ali: TN.
A receita
- Monte a matriz antes de qualquer número único.
- Escolha a métrica pela pergunta, não pelo hábito.
- Imprima a baseline ao lado. Um escore sem referência não é resultado.
- Lembre que o limiar é seu e escolha-o na validação.
| erro comum | correção |
|---|---|
ler a matriz padrão do scikit-learn (sem labels) como se TP fosse o canto superior esquerdo | passe labels=[1, 0] |
| reportar só a acurácia | acurácia ao lado da baseline, mais revocação |
| comparar modelos por uma métrica só | um placar com várias |
Triagem de diabetes: passos 1 a 7
- 768 mulheres, 8 medidas, uma ferramenta que decide quem é encaminhado a um exame completo.
- Notebook no Colab: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: de quem são os escapes? (passo 5) e e se o diabetes fosse raro? (passo 7).
Ritmo: passos 1 a 3 em 12 min; 4 a 6 em 15 min; passo 7 e a simulação em 13 min.