Estrutura é de graça e rótulo é caro
O agrupamento (clustering) recebe só a tabela \(X\) (sem rótulos) e devolve grupos de linhas parecidas.
segmentar
clientes
comprimir
uma paleta de \(k\) cores é um agrupamento dos pixels
organizar
documentos: o caminho até a modelagem de tópicos
O caminho desta parte
- Definir e julgardistância, índices internos e externos
- k-meanso algoritmo de Lloyd à mão, mínimos locais
- Escolher kcotovelo, silhueta, mais dois índices
- Desconfiar do índiceruído tira 0,40; a escala muda a régua
- Interpretaro que é cada grupo, nas unidades originais
O que é agrupar e como se julga um agrupamento
| classificação | agrupamento | |
|---|---|---|
| entrada | \(X\) e \(y\) | só \(X\) |
| "acertar" é | prever \(y\) em linhas novas | satisfazer um critério que você escolheu |
| validado com | um conjunto de teste separado | sem rótulos, não há conjunto de teste possível |
o que "parecido" significa
uma distância soma colunas: gramas afogam milímetros. Escalonar faz parte do agrupamento.
como se julga
índices internos usam só \(X\); os externos (o Índice de Rand Ajustado, ARI, Adjusted Rand Index) comparam com rótulos conhecidos, aqui só para conferir os internos.
O Índice de Rand Ajustado, à mão
Verdade: \(\{1,2,3\}, \{4,5,6\}\). Um agrupamento: \(\{1,2\}, \{3,4\}, \{5,6\}\).
- Dos 15 pares, as duas partições concordam em 10: (1,2) e (5,6) juntos nas duas; 8 pares cruzados separados nas duas.
- Índice de Rand \(= 10/15 = 0{,}667\). Mas rótulos aleatórios também concordam em muitos pares.
- O ARI desconta o que o acaso daria: 0,242.
Respostas: 1,0 (o ARI ignora nomes) e 0,0.
k-means: pontos perto de um centro
\[ J = \sum_{j=1}^{k} \sum_{x_i \in C_j} \lVert x_i - \mu_j \rVert^2, \qquad \mu_j = \text{média de } C_j \]A inércia: o quadrado da distância de cada ponto ao centro \(\mu_j\) do seu grupo \(C_j\). É circular: os centros dependem dos grupos; os grupos, dos centros. O algoritmo de Lloyd alterna:
- atribuir: cada ponto vai para o centro mais próximo;
- atualizar: cada centro vai para a média dos pontos que recebeu.
Lloyd à mão: um começo ruim
Dois quadrados unitários, em torno de \((1{,}5; 1{,}5)\) e \((6{,}5; 5{,}5)\); os dois centros começam no da esquerda, \(c_1 = (1,1)\) e \(c_2 = (2,2)\). Preveja. \(x_4 = (2,2)\) está sobre \(c_2\): em que grupo ele entra, e o algoritmo vai perceber?
Simulador: Lloyd, um passo de cada vez
Os traços ligam cada ponto ao seu centro; a inércia é a soma dos quadrados dos seus comprimentos. O histórico dela nunca sobe.
Simulador: tente vencer a média
Tente. Arraste os centros e veja qual grupo contribui mais para a inércia. Depois leve cada centro à sua média.
Inicialização e mínimos locais
300 pontos em três bolhas bem separadas; k-means com um começo, 100 sementes.
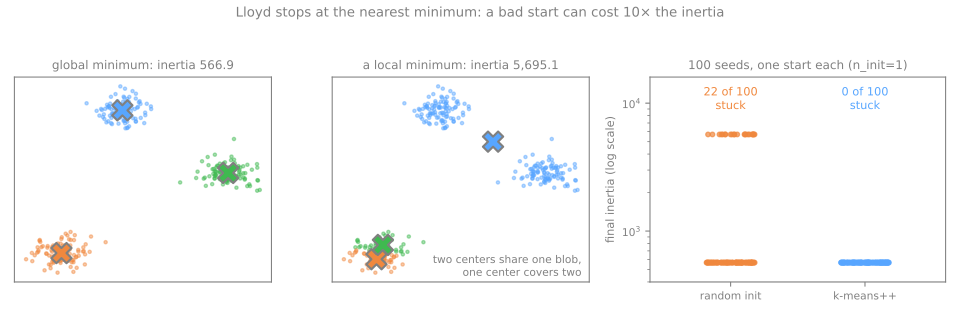
Começos sorteados: presos em 22 de 100 execuções (inércia de até 5.703,3, dez vezes a melhor, 566,9). k-means++: 0. Sorteados com n_init=10 (reiniciar e ficar com a menor inércia): 0. Dois centros dividem uma bolha e mover um único centro ou um único ponto piora a inércia.
Escolhendo \(k\): a inércia não consegue
- Acrescentar um centro só pode baixar a inércia; com \(k = n\), ela é 0.
- O cotovelo: o \(k\) a partir do qual um grupo novo rende bem menos. Uma heurística muitas vezes ambígua, lida numa curva que sempre desce.
A silhueta, à mão
\(s(i) = \dfrac{b(i) - a(i)}{\max(a(i), b(i))}\), com \(a\) = distância média ao próprio grupo e \(b\) = ao grupo vizinho mais próximo. Preveja. \(x_1\) é o vértice mais distante do outro quadrado: \(s(x_1)\) vai ficar perto de 1, perto de 0 ou negativa?
Simulador: a silhueta de cada ponto
Clique num ponto para ver os seus dois círculos: \(a\) na cor do próprio grupo, \(b\) na do vizinho. As barras são a silhueta de todos os pontos, ordenadas por grupo.
Mais dois índices internos
Calinski–Harabasz, CH (quanto maior, melhor)
\[ \mathrm{CH} = \frac{B/(k-1)}{W/(n-k)} \]\(W\) = a inércia; \(B\) = o espalhamento dos centros em torno da média geral, cada um pesado pelo tamanho do grupo. Oito pontos: \(B = 82\), \(W = 4\): \(\mathrm{CH} = (82/1)/(4/6) = 123\)
Davies–Bouldin, DB (quanto menor, melhor)
para cada grupo, o seu pior vizinho: \((s_i + s_j)/d(\mu_i, \mu_j)\), com \(s_i\) a distância média dos pontos do grupo \(i\) ao seu centro
Oito pontos: \((0{,}7071 + 0{,}7071)/6{,}4031 = 0{,}2209\)
Em dados reais: 342 pinguins
Quatro medidas padronizadas; a espécie (Adélia 151, gentoo 123, de barbicha 68) fica de lado, só para o ARI.
| \(k\) | inércia | silhueta | CH | DB | ARI (conferência) |
|---|---|---|---|---|---|
| 2 | 565,7 | 0,532 | 482,2 | 0,714 | 0,655 |
| 3 | 379,4 | 0,447 | 441,7 | 0,944 | 0,793 |
| 4 | 300,4 | 0,400 | 400,4 | 0,944 | 0,637 |
| 5 | 232,6 | 0,378 | 411,2 | 0,973 | 0,572 |
Duas perguntas diferentes
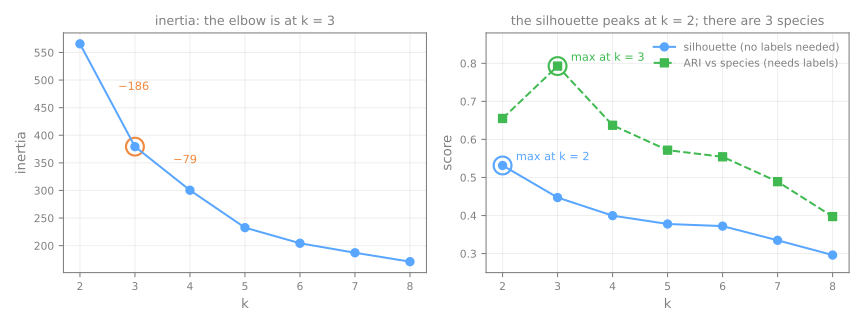
- O cotovelo diz 3 (a inércia cai 186 de 2 para 3 e depois só 79); a silhueta, o CH e o DB dizem 2; as espécies são 3.
- Adélia e de barbicha diferem principalmente no comprimento do bico: juntá-las dá de fato uma partição mais coesa.
Simulador: varra o \(k\) em oito conjuntos
Tente. Bolhas limpas, tamanhos desiguais, círculos, ruído: quando o cotovelo e a silhueta concordam?
A silhueta do ruído puro
300 pontos uniformes: nenhuma estrutura.
| \(k\) | 2 | 3 | 4 | 5 |
|---|---|---|---|---|
| silhueta | 0,359 | 0,379 | 0,4 | 0,382 |
Uma régua: rodar o mesmo pipeline com cada coluna embaralhada de forma independente e relatar as duas silhuetas. O lab faz isso, no passo 4.
A escala importa (e a silhueta não vai avisar)
Desvios padrão: massa corporal 801,95 g, profundidade do bico 1,97 mm, cerca de 400 vezes menor.
| silhueta | ARI com a espécie | |
|---|---|---|
| unidades originais | 0,580 | 0,331 |
| padronizadas | 0,447 | 0,793 |
Nas unidades originais: três faixas de peso, bem separadas. Um índice interno compara partições do mesmo espaço; quando a escala muda, a régua muda junto. Escalone por um argumento sobre as unidades.
Interpretando os grupos
De volta às colunas originais, com um groupby:
| grupo | comprimento do bico | profundidade do bico | nadadeira | massa (g) | n |
|---|---|---|---|---|---|
| 0 | 47,5 | 15,0 | 217,2 | 5.076,0 | 123 |
| 1 | 38,2 | 18,1 | 188,4 | 3.584,7 | 132 |
| 2 | 47,5 | 18,8 | 196,9 | 3.902,0 | 87 |
Aves pesadas, de nadadeiras longas e bico raso; aves pequenas de bico curto; bicos longos e profundos. (O grupo 0 é exatamente o dos pinguins-gentoo; a única confusão é entre Adélia e de barbicha.)
Resumo
- Sem rótulos, sem gabarito: o algoritmo sempre devolve uma partição.
- O k-means minimiza a inércia alternando atribuir e atualizar; ele para num mínimo local, então reinicie-o (
n_init). - A inércia não escolhe \(k\); silhueta, CH e DB medem separação, não se a partição é a que você quer.
- Um índice não é um atestado: ruído tira 0,40 e uma mudança de escala muda a régua.
- Um grupo precisa ser descrito, nas colunas originais: uma escolha, não uma descoberta.
Quatro perguntas antes de acreditar num agrupamento
- Padronizei? Se não, ele provavelmente está ordenando pela coluna de maior unidade.
- Reiniciei o suficiente? Uma inércia dez vezes maior que a melhor é possível.
- De onde veio o \(k\)? A silhueta preferiu 2 grupos de pinguins onde há 3 espécies.
- Comparei com dados embaralhados? Ruído puro chega a uma silhueta de 0,40.
Agrupar 178 vinhos sem rótulos, passos 1 a 6
- 178 vinhos italianos, 13 medidas químicas; a coluna da cultivar fica lacrada até o passo 9: toda decisão é tomada sem rótulos.
- Baixe o notebook do lab e abra no Jupyter ou no Colab. Em cada passo, responda ao Preveja antes de rodar.
- Simulações: a distância bruta é a prolina (passo 2) e um embaralhamento é um sorteio (passo 4).
1. carregar e lacrar a cultivar
2. escalonar e por que os índices não podem decidir isso
3. escolher \(k\): cotovelo e silhueta
4. a régua: dados embaralhados
5. ajustar \(k = 3\) e inspecionar cada grupo
6. o perfil nas unidades originais
Ritmo: passos 1 e 2 e a primeira simulação em 12 min; passos 3 e 4 e a segunda em 13 min; passos 5 e 6 em 10 min.