Estrutura é de graça e rótulo é caro
O agrupamento (clustering) recebe só a tabela \(X\) (sem rótulos) e devolve grupos de linhas parecidas.
segmentar
clientes
comprimir
uma paleta de \(k\) cores é um agrupamento dos pixels
organizar
documentos: o caminho até a modelagem de tópicos
O caminho desta aula
- Definir e julgardistância, índices internos e externos
- k-meanso algoritmo de Lloyd à mão, mínimos locais
- Escolher kcotovelo, silhueta, outros índices, escala
- Além dos centrosonde o k-means falha; DBSCAN, HDBSCAN
- Escolher e interpretarqual algoritmo, o que é cada grupo
O que é agrupar e como se julga um agrupamento
| classificação | agrupamento | |
|---|---|---|
| entrada | \(X\) e \(y\) | só \(X\) |
| "acertar" é | prever \(y\) em linhas novas | satisfazer um critério que você escolheu |
| validado com | um conjunto de teste separado | sem rótulos, não há conjunto de teste possível |
o que "parecido" significa
uma distância soma colunas: gramas afogam milímetros. Escalonar faz parte do agrupamento.
como se julga
índices internos usam só \(X\); os externos (o Índice de Rand Ajustado, ARI, Adjusted Rand Index) comparam com rótulos conhecidos, aqui só para conferir os internos.
O Índice de Rand Ajustado, à mão
Verdade: \(\{1,2,3\}, \{4,5,6\}\). Um agrupamento: \(\{1,2\}, \{3,4\}, \{5,6\}\).
- Dos 15 pares, as duas partições concordam em 10: (1,2) e (5,6) juntos nas duas; 8 pares cruzados separados nas duas.
- Índice de Rand \(= 10/15 = 0{,}667\). Mas rótulos aleatórios também concordam em muitos pares.
- O ARI desconta o que o acaso daria: 0,242.
Respostas: 1,0 (o ARI ignora nomes) e 0,0.
k-means: pontos perto de um centro
\[ J = \sum_{j=1}^{k} \sum_{x_i \in C_j} \lVert x_i - \mu_j \rVert^2, \qquad \mu_j = \text{média de } C_j \]A inércia: o quadrado da distância de cada ponto ao centro do próprio grupo. É circular: os centros dependem dos grupos; os grupos, dos centros. O algoritmo de Lloyd alterna:
- atribuir: cada ponto vai para o centro mais próximo;
- atualizar: cada centro vai para a média dos pontos que recebeu.
Lloyd à mão: um começo ruim
Dois quadrados de lado 1, em torno de \((1{,}5;\ 1{,}5)\) e de \((6{,}5;\ 5{,}5)\). Os dois centros começam no da esquerda: \(c_1 = (1, 1)\), \(c_2 = (2, 2)\).
| ponto | coordenadas | \(d^2\) a \(c_1\) | \(d^2\) a \(c_2\) | grupo |
|---|---|---|---|---|
| \(x_1, x_2, x_3\) | (1, 1), (2, 1), (1, 2) | 0, 1, 1 | 2, 1, 1 | 1 (empates vão para o primeiro) |
| \(x_4\) | (2, 2) | 2 | 0 | 2 |
| \(x_5 \dots x_8\) | o quadrado da direita | 41 a 61 | 25 a 41 | 2 |
Três iterações
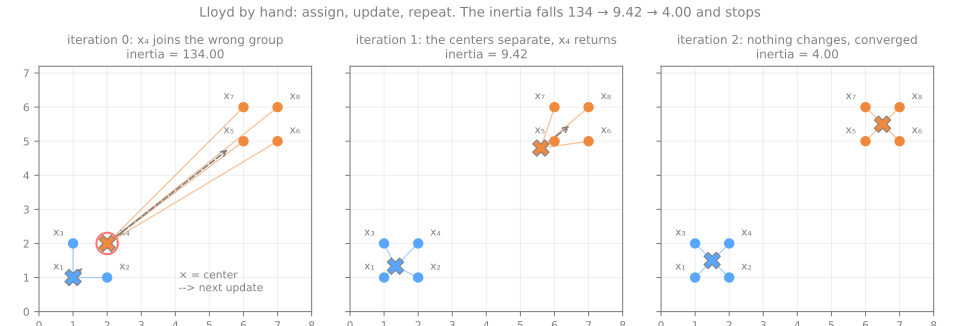
- Atualizar: \(c_2\) = média de \(x_4 \dots x_8\) = \((5{,}6;\ 4{,}8)\), arrastado para a direita; \(x_4\) fica muito mais perto de \(c_1\) (0,89 contra 20,80) e volta.
- Inércia 134 → 9,42 → 4,00: a primeira iteração faz quase todo o trabalho. Convergir = nenhuma atribuição mudou.
Simulador: Lloyd, um passo de cada vez
Os traços ligam cada ponto ao seu centro; a inércia é a soma dos quadrados dos seus comprimentos. O histórico dela nunca sobe.
Simulador: tente vencer a média
Tente. Arraste os centros e veja qual grupo contribui mais para a inércia. Depois leve cada centro à sua média.
Inicialização e mínimos locais
300 pontos em três bolhas bem separadas; k-means com um começo, 100 sementes.
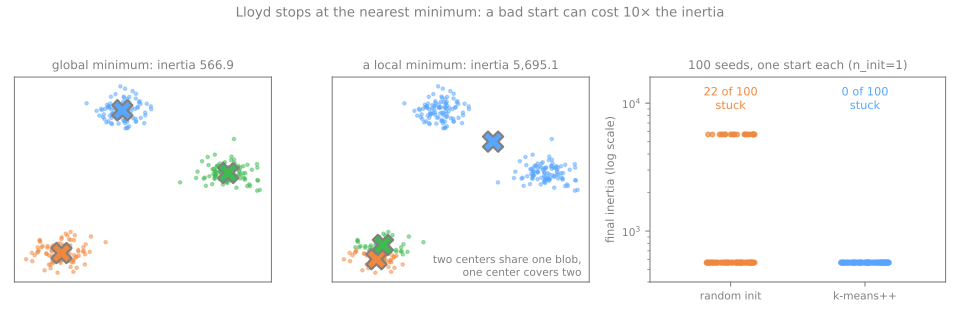
Começos sorteados: presos em 22 de 100 execuções (inércia de até 5.703,3, dez vezes a melhor, 566,9). k-means++: 0. Sorteados com n_init=10 (reiniciar e ficar com a menor inércia): 0. Dois centros dividem uma bolha e mover um único centro ou um único ponto piora a inércia.
Escolhendo \(k\): a inércia não consegue
- Acrescentar um centro só pode baixar a inércia; com \(k = n\), ela é 0.
- O cotovelo: o \(k\) a partir do qual um grupo novo rende bem menos. Uma heurística muitas vezes ambígua, lida numa curva que sempre desce.
A silhueta, à mão
\[ s(i) = \frac{b(i) - a(i)}{\max(a(i), b(i))} \in [-1, 1] \]\(a\): distância média ao próprio grupo; \(b\): ao grupo vizinho mais próximo. Perto de 1: bem instalado; perto de 0: na fronteira; negativo: mais perto de outro grupo.
\(x_1 = (1,1)\), os quadrados convergidos
\(a = (1 + 1 + 1{,}414)/3 = 1{,}1381\)
\(b\) = média de 6,403; 7,211; 7,071; 7,810 = 7,1239
\(s = (7{,}1239 - 1{,}1381)/7{,}1239 = \mathbf{0{,}8402}\)
os oito pontos
vértices de fora 0,8402, vértices de dentro 0,8011
Simulador: a silhueta de cada ponto
Clique num ponto para ver os seus dois círculos: \(a\) na cor do próprio grupo, \(b\) na do vizinho. As barras são a silhueta de todos os pontos, ordenadas por grupo.
Mais dois índices internos
Calinski–Harabasz, CH (quanto maior, melhor)
\[ \mathrm{CH} = \frac{B/(k-1)}{W/(n-k)} \]Oito pontos: \(B = 82\), \(W = 4\): \(\mathrm{CH} = (82/1)/(4/6) = 123\)
Davies–Bouldin, DB (quanto menor, melhor)
para cada grupo, o seu pior vizinho: \((s_i + s_j)/d(\mu_i, \mu_j)\)
Oito pontos: \((0{,}7071 + 0{,}7071)/6{,}4031 = 0{,}2209\)
Em dados reais: 342 pinguins
Quatro medidas padronizadas; a espécie (Adélia 151, gentoo 123, de barbicha 68) fica de lado, só para o ARI.
| \(k\) | inércia | silhueta | CH | DB | ARI (conferência) |
|---|---|---|---|---|---|
| 2 | 565,7 | 0,532 | 482,2 | 0,714 | 0,655 |
| 3 | 379,4 | 0,447 | 441,7 | 0,944 | 0,793 |
| 4 | 300,4 | 0,400 | 400,4 | 0,944 | 0,637 |
| 5 | 232,6 | 0,378 | 411,2 | 0,973 | 0,572 |
Duas perguntas diferentes
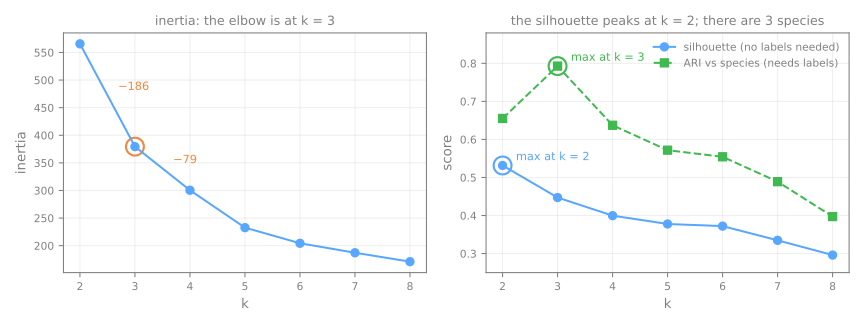
- O cotovelo diz 3 (a inércia cai 186 de 2 para 3 e depois só 79); a silhueta, o CH e o DB dizem 2; as espécies são 3.
- Adélia e de barbicha diferem principalmente no comprimento do bico: juntá-las dá de fato uma partição mais coesa.
Simulador: varra o \(k\) em oito conjuntos
Tente. Bolhas limpas, tamanhos desiguais, círculos, ruído: quando o cotovelo e a silhueta concordam?
A silhueta do ruído puro
300 pontos uniformes: nenhuma estrutura.
| \(k\) | 2 | 3 | 4 | 5 |
|---|---|---|---|---|
| silhueta | 0,359 | 0,379 | 0,4 | 0,382 |
Uma régua: rodar o mesmo pipeline com cada coluna embaralhada de forma independente e relatar as duas silhuetas. O lab faz isso.
A escala importa (e a silhueta não vai avisar)
Desvios padrão: massa corporal 801,95 g, profundidade do bico 1,97 mm, cerca de 400 vezes menor.
| silhueta | ARI com a espécie | |
|---|---|---|
| unidades originais | 0,580 | 0,331 |
| padronizadas | 0,447 | 0,793 |
Nas unidades originais: três faixas de peso, bem separadas. Um índice interno compara partições do mesmo espaço; quando a escala muda, a régua muda junto. Escalone por um argumento sobre as unidades.
O que o k-means supõe
Cada grupo é uma célula convexa com fronteiras retas a meio caminho entre os centros e todo ponto paga o mesmo quadrado da distância:
- os grupos são convexos e mais ou menos redondos;
- os grupos têm espalhamento parecido;
- não há ruído: todo ponto vai para algum grupo;
- você sabe o \(k\).
Cinco formatos, o k-means recebe o \(k\) certo
| dados | \(k\) | silhueta | ARI |
|---|---|---|---|
| bolhas | 3 | 0,823 | 1,000 |
| luas | 2 | 0,489 | 0,253 |
| círculos | 2 | 0,356 | −0,002 |
| esticados | 3 | 0,501 | 0,555 |
| densities | 3 | 0,605 | 0,436 |
Simulador: onde o k-means falha
Tente. Percorra os formatos e varie o \(k\). Existe um \(k\) que conserte um anel?
Agrupamento hierárquico
O k-means devolve uma partição plana para um \(k\) escolhido. O agrupamento aglomerativo constrói a árvore inteira de fusões (o dendrograma) e deixa você escolher o número de grupos depois, cortando-a.
DBSCAN: regiões densas
Um grupo é uma região densa, separada das outras por regiões esparsas. Dois parâmetros, eps e min_samples:
central
pelo menos min_samples pontos a até eps, contando ele mesmo
borda
não é central, mas está a até eps de um ponto central
ruído
nenhum dos dois: rótulo −1, não é forçado para um grupo
DBSCAN à mão: dez pontos, eps = 1,5, min_samples = 4
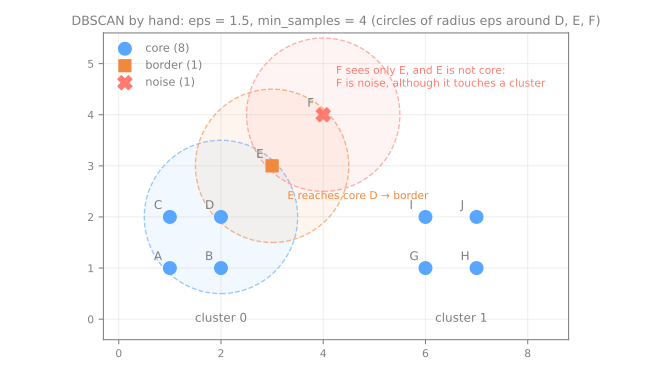
A, B, C, D: o quadrado da esquerda (D também vê E); G, H, I, J: o da direita. E = (3, 3) vê D e F; F = (4, 4) só vê E.
eps de E e E pertence a um grupo. F está no grupo?Não: E tem só 3 pontos a até 1,5, então é ponto de borda e os grupos só crescem através de pontos centrais. F é ruído.
Escolhendo o eps: um valor, uma densidade
O gráfico de k-distâncias: a distância de cada ponto ao seu \(k\)-ésimo vizinho, em ordem crescente; o eps é lido no joelho. Em densities, os grupos compactos pedem cerca de 0,07; o frouxo, cerca de 0,3.
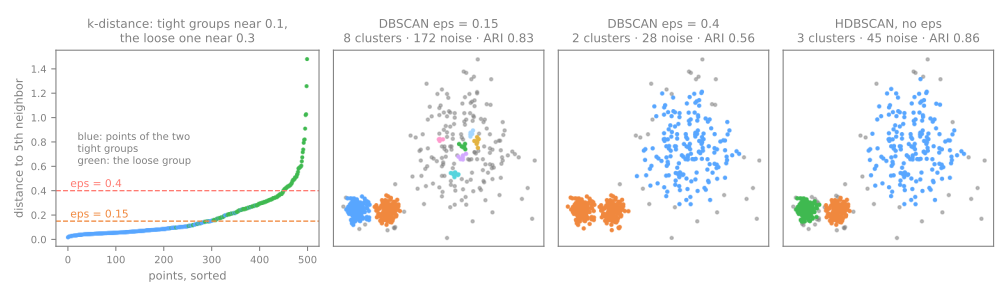
eps | 0,15 | 0,3 | 0,6 | 0,8 |
|---|---|---|---|---|
| grupos | 8 | 6 | 2 | 1 |
| ruído | 172 | 63 | 5 | 4 |
| ARI | 0,825 | 0,397 | 0,619 | −0,003 |
eps global significa uma densidade.HDBSCAN: todos os eps de uma vez
Roda o DBSCAN para todo eps, constrói uma hierarquia de grupos e fica com os que persistem por mais tempo, cada um na sua própria densidade. Um parâmetro: min_cluster_size.
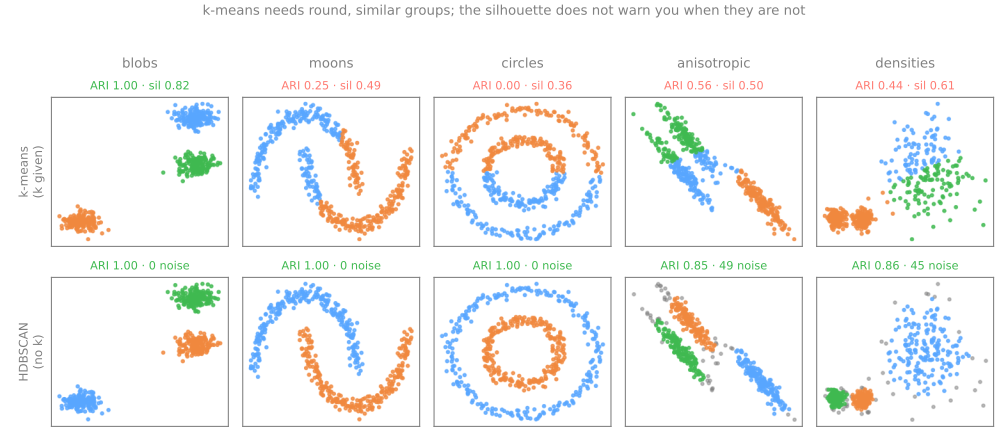
| HDBSCAN, sem \(k\) | bolhas | luas | círculos | esticados | densities |
|---|---|---|---|---|---|
| grupos · ruído | 3 · 0 | 2 · 0 | 2 · 0 | 3 · 49 | 3 · 45 |
| ARI | 1,000 | 1,000 | 1,000 | 0,852 | 0,856 |
Os pontos de ruído são caudas e franjas; os atribuídos estão todos no grupo certo. É por isso que o BERTopic usa o HDBSCAN.
Escolhendo um algoritmo
| k-means | hierárquico (Ward) | DBSCAN | HDBSCAN | |
|---|---|---|---|---|
| um grupo é | o mais perto de um centro | um ramo de fusões | uma região densa | densa, na sua própria densidade |
| você escolhe | \(k\) | o corte (\(k\)) | eps, min_samples | min_cluster_size |
| formas | convexas, redondas | depende da ligação | quaisquer | quaisquer, densidades diferentes |
| ruído | forçado para um grupo | forçado para um grupo | −1 | −1 |
| pontos novos | predict | não | não | não |
Quatro perguntas antes de acreditar num agrupamento
- Padronizei? Se não, ele provavelmente está ordenando pela coluna de maior unidade.
- Reiniciei o suficiente? Uma inércia dez vezes maior que a melhor é possível.
- De onde veio o \(k\)? A silhueta preferiu 2 grupos de pinguins onde há 3 espécies.
- Comparei com dados embaralhados? Ruído puro chega a uma silhueta de 0,40.
Interpretando os grupos
De volta às colunas originais, com um groupby:
| grupo | comprimento do bico | profundidade do bico | nadadeira | massa (g) | n |
|---|---|---|---|---|---|
| 0 | 47,5 | 15,0 | 217,2 | 5.076,0 | 123 |
| 1 | 38,2 | 18,1 | 188,4 | 3.584,7 | 132 |
| 2 | 47,5 | 18,8 | 196,9 | 3.902,0 | 87 |
Aves pesadas, de nadadeiras longas e bico raso; bicos longos e profundos; aves pequenas de bico curto. (O grupo 0 é exatamente o dos pinguins-gentoo; a única confusão é entre Adélia e de barbicha.)
Resumo
- Sem rótulos, sem gabarito: o algoritmo sempre devolve uma partição.
- O k-means minimiza a inércia alternando atribuir e atualizar; reinicie-o (
n_init). - Silhueta, CH e DB medem separação, não se a partição é a que você quer; ruído tira 0,40.
- Escalone por um argumento sobre as unidades, não por um índice.
- O k-means quer grupos redondos; o DBSCAN e o HDBSCAN encontram regiões densas e marcam ruído.
Agrupar 178 vinhos
- 13 medidas químicas; a coluna da cultivar fica lacrada até o último passo: toda decisão é tomada sem rótulos.
- Baixe o notebook do lab e abra no Jupyter ou no Colab.
1. carregar e lacrar a cultivar
2. escalonar e por que os índices não podem decidir isso
3. escolher \(k\): cotovelo e silhueta
4. a régua: dados embaralhados
5. ajustar \(k = 3\) e inspecionar cada grupo
6. o perfil nas unidades originais
7. experimentar o DBSCAN e o HDBSCAN
8. olhar os grupos com a PCA (análise de componentes principais)
9. abrir o lacre: auditar cada decisão