O caminho desta parte
- Medir o corteimpureza, não erros; variância na regressão
- Podar depois de crescerpoda por custo-complexidade e a escolha de α
- Encarar a instabilidadeuma pequena mudança nos dados, outra árvore
- Forças e limitesescala, escadas,
NaN, importância
Por que não simplesmente contar erros?
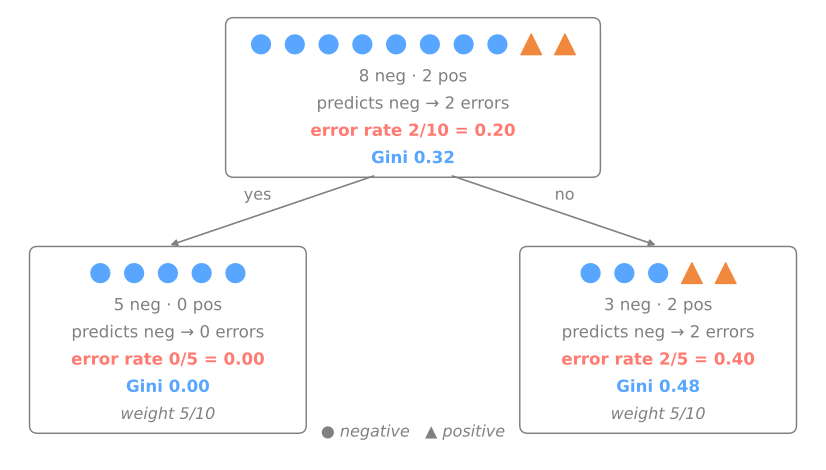
Taxa de erro
fração fora da classe majoritária do nó
\[ 0{,}20 \;\to\; \tfrac{5}{10}\cdot 0 + \tfrac{5}{10}\cdot 0{,}40 = 0{,}20 \]não se mexe: o corte parece inútil
Gini
\(1 - \sum_c p_c^2\), \(p_c\) = fração da classe \(c\) no nó
\[ 0{,}32 \;\to\; \tfrac{5}{10}\cdot 0 + \tfrac{5}{10}\cdot 0{,}48 = 0{,}24 \]cai: um filho já está resolvido
Por que o Gini enxerga e o erro não
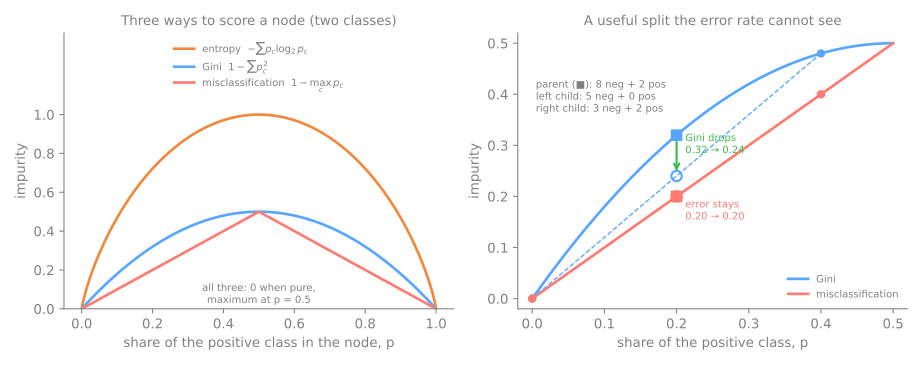
- \(p\) = fração de positivos no nó. ■ o pai na curva (\(p = 0{,}2\)); ● os filhos (\(p = 0\) e \(0{,}4\)); ○ a média ponderada dos filhos, no meio da corda tracejada.
- A taxa de erro é uma reta até 0,5: a corda fica em cima dela e a queda é zero. O Gini é curvo (estritamente côncavo): a corda passa por baixo e a queda aparece.
Árvores de regressão
A folha prevê a média do alvo; a impureza é o erro quadrático médio (MSE, mean squared error) em torno dela, a variância do alvo no nó: \( I = \frac{1}{n}\sum_{i} (y_i - \bar y)^2 \), com \(n\) apartamentos no nó e \(\bar y\) a média deles.
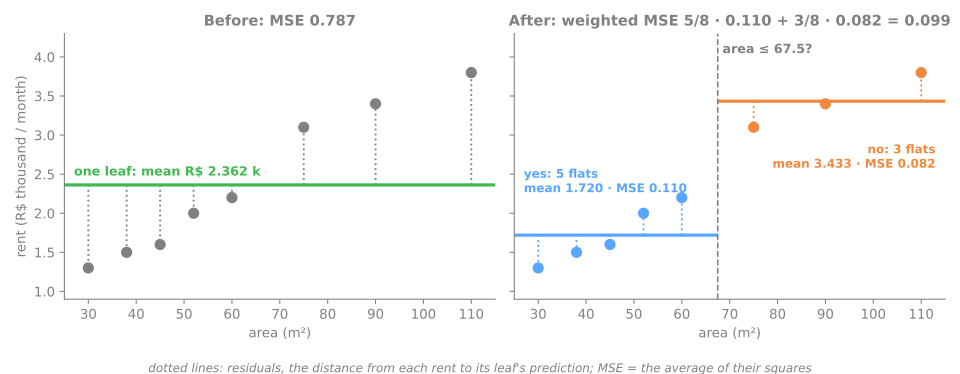
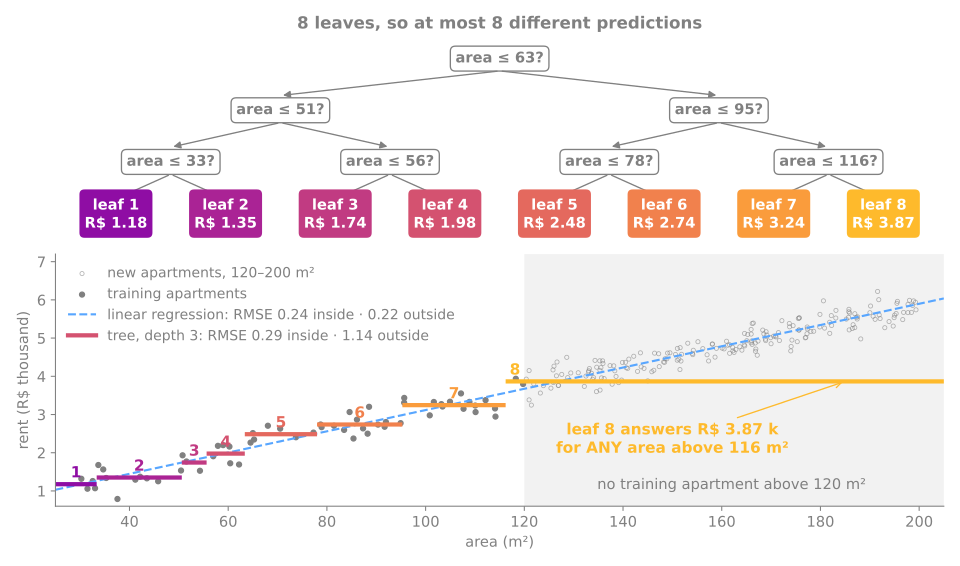
Uma escada que não extrapola
Pós-poda: o elo mais fraco, passo a passo
Cresça a árvore inteira e cobre \(\alpha\) por folha: \(R_\alpha(T) = R(T) + \alpha|T|\), com \(R(T)\) o Gini das folhas pesado pela fração de linhas. Colapsar \(t\) compensa quando \(\alpha \ge \alpha_{\text{ef}}(t) = \frac{R(t) - R(T_t)}{|T_t| - 1}\).
A poda no Spambase
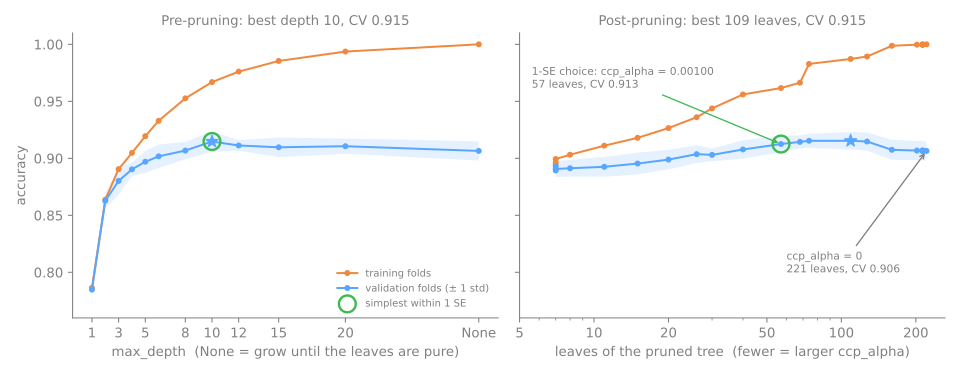
- Sem poda: 221 folhas, 0,906. Melhor \(\alpha\): 109 folhas, 0,915.
- Regra de um erro padrão (Breiman et al., 1984): 57 folhas, 0,913 — um quarto da árvore.
Instabilidade: uma pequena mudança, outra árvore
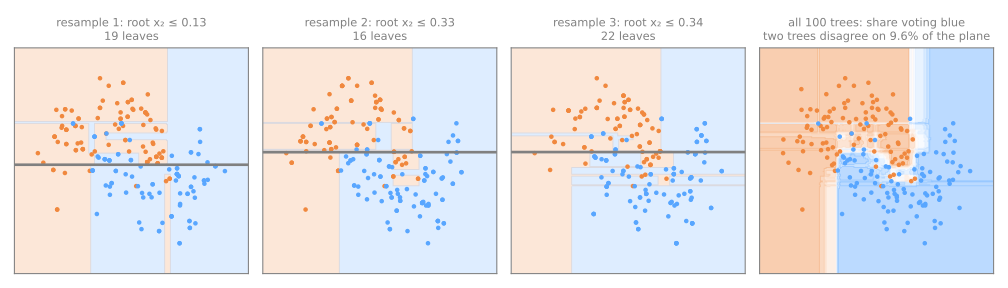
50 reamostras bootstrap do Spambase:
- a raiz muda:
$em 29,!em 19, outras duas palavras uma vez cada; - 136 a 186 folhas;
- acurácia 0,895 em média, mas duas árvores discordam em 11,8% dos e-mails.
O que as árvores dispensam
Escalonamento
Um corte só usa a ordem. Padronizar: as mesmas previsões em 100% do teste. log1p: 99,3% (só os limiares entre valores mudam).
Interações
"O tempo de casa importa quando a conta é alta": a árvore diz isso aninhando perguntas, sem atributo-produto.
Imputação
Desde o scikit-learn 1.3, NaN entra direto: cada corte aprende para que lado mandar o faltante.
Categorias
O DecisionTreeClassifier ainda pede números: one-hot para poucas categorias.
Onde elas sofrem: diagonais viram escadas
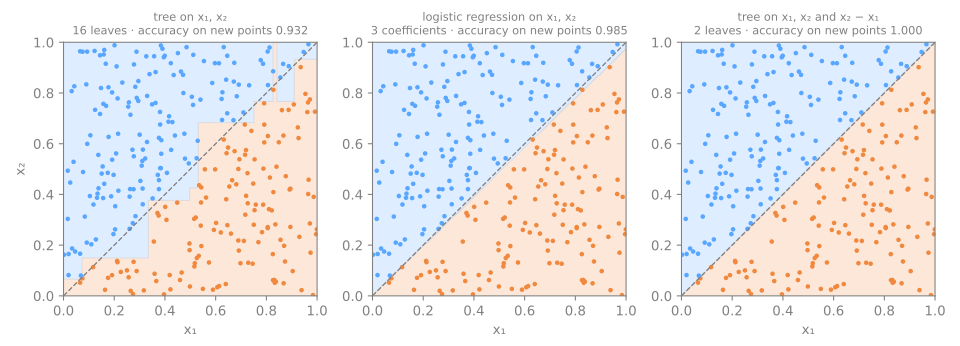
Importância de atributos e seu viés
feature_importances_soma a queda de impureza dos cortes de cada atributo, nos dados de treino.- Uma coluna de números aleatórios fica em 12º lugar entre 59, à frente de 46 atributos reais; uma moeda aleatória, em 41º.
- Atributos com muitos valores oferecem muitos limiares; um deles separa algumas linhas ruidosas por acaso (Strobl et al., 2007).
Perfil prático
| Pontos fortes | regras legíveis; sem escalonamento; interações automáticas; aceita NaN; rápida |
| Pontos fracos | sobreajusta sem poda; instável; escadas para diagonais; não extrapola; importância enviesada; probabilidades grosseiras |
| Use quando | o modelo precisa ser lido, auditado ou aplicado à mão |
A chave final e o que ela vale, passos 6 a 10
- Mesmo notebook, mesma sessão: os passos usam
X,X_train,y_train,cvecv_report. - Ajustar profundidade, folhas e poda; comparar com regressão logística e k-NN nos mesmos folds; testar uma vez; medir a estabilidade da chave.
- Notebook no Colab, a partir do passo 6.
- Simulações: dê a diagonal à árvore (passo 7) e bagging à mão (passo 10).
Ritmo: passos 6 e 7 e a primeira simulação em 15 min; passos 8 e 9 em 10 min; passo 10 e a segunda em 10 min.