Redução de Dimensionalidade
Conjuntos de dados reais costumam ter dezenas, centenas ou, no caso de texto e imagens, milhares de colunas. A redução de dimensionalidade as substitui por poucas colunas novas que guardam o que importa. O método certo depende do motivo da redução; confundir os motivos está por trás de quase todo mau uso desses métodos:
| Objetivo | O que se exige do método | Método típico |
|---|---|---|
| Ver os dados | uma figura em 2D ou 3D; fidelidade local basta | t-SNE, UMAP |
| Comprimir / acelerar | reconstrução e uma transformação que funcione em dados novos | PCA |
| Remover ruído / colinearidade | descartar as direções de baixa variância | PCA |
| Alimentar outro modelo | fit/transform honestos, sem vazamento | PCA (quase sempre) |
Há ainda uma razão estatística, a maldição da dimensionalidade: em muitas dimensões as distâncias perdem contraste e tudo o que depende de distância sofre. A aula começa por ela, depois constrói o PCA à mão (todo número abaixo pode ser conferido com uma calculadora) e segue para os mapas não lineares t-SNE e UMAP, cujas figuras são fáceis de fazer e fáceis de interpretar mal. Toda afirmação é medida: as figuras saem de pequenos scripts Python ao lado desta página; cada bloco de código é seguido da saída que ele imprime.
A aula segue um pipeline em quatro etapas, desenhado abaixo: 1. a maldição, medindo como as distâncias perdem contraste quando as colunas se acumulam; 2. linear: PCA, construído à mão, com a questão da escala, a escolha de k e a reconstrução; 3. não linear: t-SNE e UMAP, os mapas para a estrutura que o PCA não consegue desdobrar, junto com o que eles não dizem; 4. comparar e escolher, os três métodos lado a lado e o objetivo que escolhe um deles. Cada etapa leva à sua seção; nos slides, uma faixa embaixo mostra em que etapa você está.
- A maldiçãoas distâncias perdem contraste
- Linear: PCAà mão, escala, escolha de k, reconstrução
- Não linear: t-SNE, UMAPonde o PCA se esgota, o que um mapa não diz
- Comparar e escolherlado a lado, afirmações proibidas, o objetivo decide
Slides
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
A maldição da dimensionalidade, medida
Etapa 1. Em dimensão alta acontece algo contraintuitivo com a própria distância: todos os pares de pontos acabam mais ou menos igualmente distantes.
Sorteie n pontos uniformemente no cubo unitário e olhe todas as distâncias par a par. Em duas dimensões o histograma é largo: alguns pares estão perto e outros longe, de modo que "vizinho mais próximo" seleciona algo com significado. Aumente a dimensão e o histograma colapsa num pico estreito:
O número a observar é o contraste relativo de um ponto, \((d_{\max} - d_{\min})/d_{\min}\): quanto o vizinho mais distante está mais longe que o mais próximo. O código abaixo o mede (mediana sobre 400 pontos) para dois tipos de dados com o mesmo número de colunas:
- colunas de ruído: cada coordenada independente e uniforme, de modo que cada coluna nova é uma direção nova e irrelevante;
- uma folha 2D girada para \(d\) colunas: 400 pontos numa folha plana 2D, depois girados ao acaso para \(d\) dimensões. Todas as colunas são não nulas, mas só existem dois graus de liberdade de verdade.
import numpy as np
from sklearn.metrics import pairwise_distances

def relative_contrast(X):
    """Para cada ponto: (mais distante - mais próximo) / mais próximo. Mediana sobre os pontos."""
    D = pairwise_distances(X)
    np.fill_diagonal(D, np.nan)                 # um ponto não é vizinho de si mesmo
    nearest, farthest = np.nanmin(D, axis=1), np.nanmax(D, axis=1)
    return np.median((farthest - nearest) / nearest)

print("   d   noise columns   2-D sheet in d columns")
for d in [2, 10, 100, 1000]:
    rng = np.random.default_rng(d)
    noise = rng.random((400, d))                                   # d colunas independentes
    sheet = np.hstack([rng.random((400, 2)), np.zeros((400, d - 2))])
    Q, _ = np.linalg.qr(rng.normal(size=(d, d)))                   # uma rotação aleatória
    print(f"{d:4d}   {relative_contrast(noise):13.2f}   {relative_contrast(sheet @ Q):10.2f}")
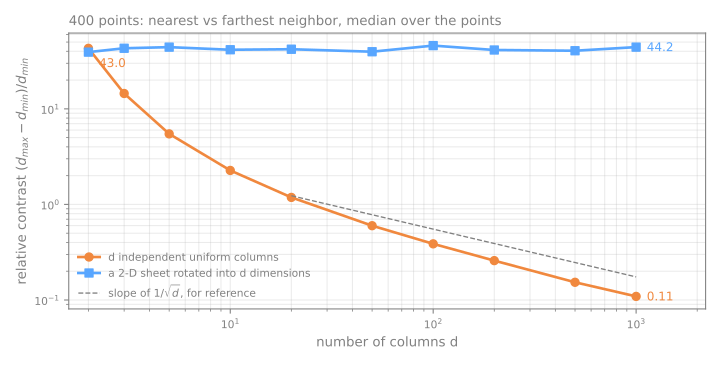
Com colunas de ruído, em \(d = 2\) o ponto mais distante costuma estar dezenas de vezes mais longe que o mais próximo; em \(d = 1000\), só uns 10% mais longe. "Mais próximo" deixou de significar muita coisa. Tudo o que se apoia em distância se degrada junto: k-NN, k-means, núcleos RBF e os próprios t-SNE e UMAP.
A linha azul é a parte da história que costuma ficar de fora. A concentração não é causada pelo número de colunas. A folha girada também tem 1.000 colunas, mas seu contraste não se mexe, porque os pontos continuam sobre uma superfície 2D. O que prejudica são colunas que não carregam informação sobre a estrutura: cada uma soma seu próprio ruído a toda distância, enquanto o sinal continua o mesmo. Dados reais ficam entre as duas linhas: imagens, embeddings de texto e leituras de sensores têm muitas colunas, mas bem menos direções independentes de variação. Então a pergunta prática não é "quantas colunas?", mas "quantas direções de fato variam?"; a variância explicada do PCA, logo abaixo, estima justamente isso. É também por isso que t-SNE e UMAP recomendam rodar PCA antes quando a entrada tem centenas de dimensões: não só pela velocidade, mas para entregar a eles vizinhanças que ainda significam alguma coisa.
PCA — Análise de Componentes Principais
Etapa 2. O PCA (Pearson, 1901; Hotelling, 1933) é o método clássico e linear: encontrar as direções ortogonais de variância máxima e projetar os dados sobre as primeiras.
A matemática
Dados centrados \(X \in \mathbb{R}^{n \times d}\) (cada coluna com média zero), a matriz de covariância amostral é
O primeiro componente principal é o vetor unitário \(w\) que maximiza a variância da projeção:
A solução é o autovetor de \(C\) com o maior autovalor \(\lambda_1\); o segundo componente é o próximo autovetor (ortogonal ao primeiro) e assim por diante. O autovalor \(\lambda_k\) é a variância capturada pelo componente \(k\), o que dá a razão de variância explicada:
Há uma segunda forma de pedir "a melhor reta": a que minimiza as distâncias ao quadrado dos pontos até ela (os resíduos). Por Pitágoras, a distância ao quadrado de cada ponto ao centro se divide na parte ao longo da reta mais a parte perpendicular a ela. O total é fixo, então maximizar a primeira é o mesmo que minimizar a segunda: variância máxima e erro de reconstrução mínimo são a mesma otimização.
PCA à mão
Cinco pontos, escolhidos para que todo número saia inteiro:
| \(x\) | \(y\) | \(x-\bar{x}\) | \(y-\bar{y}\) |
|---|---|---|---|
| 2 | 4 | −3 | −1 |
| 4 | 2 | −1 | −3 |
| 5 | 5 | 0 | 0 |
| 6 | 8 | 1 | 3 |
| 8 | 6 | 3 | 1 |
Passo 1 — centralizar. A média é \((5, 5)\); subtraia-a (duas últimas colunas).
Passo 2 — matriz de covariância. Com \(n - 1 = 4\): a variância de \(x\) é \((9+1+0+1+9)/4 = 5\), a de \(y\) também; a covariância é \((3+3+0+3+3)/4 = 3\):
Passo 3 — autovalores. Resolva \(\det(C - \lambda I) = 0\), que para uma 2×2 é uma equação do segundo grau cujos coeficientes são o traço e o determinante:
Duas conferências que vale interiorizar: os autovalores somam o traço (8 + 2 = 10 = 5 + 5) e o traço é a variância total. Logo \(\text{EVR}_1 = 8/10 = 80\%\).
Passo 4 — autovetores. Substituindo \(\lambda_1 = 8\) em \((C - 8I)w = 0\) obtém-se \(-3w_1 + 3w_2 = 0\), ou seja, \(w_1 = w_2\): a PC1 é \((1,1)/\sqrt{2}\), exatamente a diagonal de 45°, para onde a nuvem visivelmente aponta. A PC2 é forçada a ser \((-1,1)/\sqrt{2}\), perpendicular a ela.
Passo 5 — projetar. O escore de um ponto na PC1 é o produto escalar de suas coordenadas centralizadas com \(w_1\): para \((2, 4)\), \((-3 - 1)/\sqrt2 = -2\sqrt2 \approx -2{,}828\). Os cinco escores são \(-2\sqrt2,\ -2\sqrt2,\ 0,\ 2\sqrt2,\ 2\sqrt2\), cuja variância é \(4 \cdot 8/4 = 8\): de novo o autovalor. O autovalor não é uma aproximação da variância ao longo do componente; ele é essa variância.
Passo 6 — reconstruir. Manter só a PC1 significa trocar cada ponto por sua sombra na diagonal, \(\text{média} + (\text{escore})\, w_1\): \((2,4)\) e \((4,2)\) viram ambos \((3,3)\), \((6,8)\) e \((8,6)\) viram \((7,7)\). Cada um desses quatro se desloca \(\sqrt2\), então o erro quadrático é \(4 \times 2 = 8\); dividido por \(n-1\), dá \(8/(n-1) = 2 = \lambda_2\). O erro de reconstrução é exatamente a variância que você jogou fora.
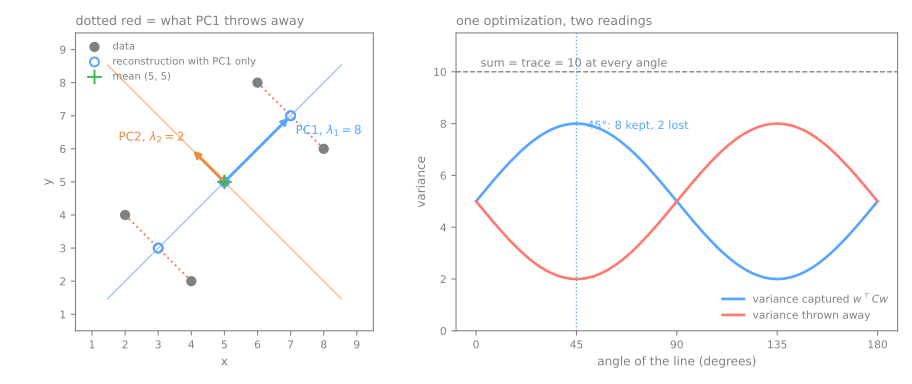
Agora os mesmos seis passos em numpy. Antes, uma armadilha: np.linalg.eigh (a rotina para matrizes simétricas) devolve os autovalores em ordem crescente, então a melhor direção vem por último. Esquecer de ordenar é um bug silencioso: o código roda, os formatos batem e você guardou a pior direção.
X = np.array([[2, 4], [4, 2], [5, 5], [6, 8], [8, 6]], dtype=float)

mean = X.mean(axis=0)                  # passo 1: centralizar
Xc = X - mean
C = Xc.T @ Xc / (len(X) - 1)           # passo 2: matriz de covariância (divisor n - 1)
lam, V = np.linalg.eigh(C)             # passos 3-4: autovalores, autovetores (colunas de V)
print("mean:", mean)
print("C:", C.tolist())
print("eigh order:", lam)              # crescente: a melhor direção vem POR ÚLTIMO
order = np.argsort(lam)[::-1]          # do maior para o menor
lam, V = lam[order], V[:, order]
print("sorted:    ", lam)
print("PC1:", V[:, 0].round(4), "  PC2:", V[:, 1].round(4))
mean: [5. 5.]
C: [[5.0, 3.0], [3.0, 5.0]]
eigh order: [2. 8.]
sorted:     [8. 2.]
PC1: [0.7071 0.7071]   PC2: [-0.7071  0.7071]
Z = Xc @ V                              # passo 5: escores = coordenadas nos novos eixos
print("PC1 scores:", Z[:, 0].round(3))
print("variance of the scores:", Z.var(axis=0, ddof=1))     # = os autovalores
print("explained variance ratio:", lam / lam.sum())

W = V[:, :1]                            # passo 6: manter só a PC1 ...
X_rec = Xc @ W @ W.T + mean             # ... projetar e voltar para x, y
print("reconstruction:", X_rec.tolist())
print("squared error / (n - 1):", ((X - X_rec) ** 2).sum() / (len(X) - 1))   # = lambda_2
PC1 scores: [-2.828 -2.828  0.     2.828  2.828]
variance of the scores: [8. 2.]
explained variance ratio: [0.8 0.2]
reconstruction: [[3.0000000000000004, 3.0000000000000004], [3.0000000000000004, 3.0000000000000004], [5.0, 5.0], [7.0, 7.0], [7.0, 7.0]]
squared error / (n - 1): 2.0
O scikit-learn faz o mesmo numa chamada e sempre ordena os componentes do maior para o menor (internamente ele usa a SVD de \(X_c\) em vez de formar \(C\), o que é numericamente mais seguro):
from sklearn.decomposition import PCA

pca = PCA(n_components=2).fit(X)
print("components_:", pca.components_.round(4).tolist())    # uma linha por componente
print("explained_variance_:", pca.explained_variance_)
print("explained_variance_ratio_:", pca.explained_variance_ratio_)
print("same scores up to sign?", np.allclose(np.abs(pca.transform(X)), np.abs(Z)))

x_new = np.array([[9, 7]])                                  # um ponto que o PCA nunca viu
print("transform:", pca.transform(x_new).round(3), "  by hand:", ((x_new - mean) @ V).round(3))
components_: [[0.7071, 0.7071], [-0.7071, 0.7071]]
explained_variance_: [8. 2.]
explained_variance_ratio_: [0.8 0.2]
same scores up to sign? True
transform: [[ 4.243 -1.414]]   by hand: [[ 4.243 -1.414]]
A biblioteca concorda com a conta à mão. Dois detalhes merecem ser conhecidos antes que surpreendam:
- Os sinais são arbitrários. Se \(w\) é autovetor, \(-w\) também é. Outra biblioteca (ou outra versão) pode devolver a PC1 como \((-0{,}707; -0{,}707)\); os escores trocam de sinal e o gráfico sai espelhado. Por isso a conferência acima compara valores absolutos. Interprete os sinais relativos dentro de um componente ("\(x\) e \(y\) andam juntos"), nunca o sinal absoluto.
- Pontos novos não exigem reajuste.
transformsubtrai a média do treino e multiplica pelos componentes guardados: \((9, 7) - (5, 5) = (4, 2)\) e \((4 + 2)/\sqrt2 = 4{,}243\). É isso que permite ao PCA ficar dentro de um pipeline e processar dados que ele nunca viu. Guarde isto: o t-SNE não consegue fazer o mesmo.
Divisor \(n\) ou \(n-1\)?
O exercício em papel do handout da aula divide por \(n\) (a covariância populacional); o np.cov do numpy e o explained_variance_ do scikit-learn dividem por \(n-1\). Os autovalores então diferem pelo fator \(n/(n-1)\), mas os autovetores, os escores e as razões de variância explicada são idênticos, porque o fator se cancela.
Gire a reta você mesmo: a barra à direita é a variância capturada naquele ângulo; os segmentos cinza são o que se joga fora. Existe exatamente um ângulo em que a barra chega ao máximo. Aperte encontrar PC1 para ir até ele e confirmar que é aquele para onde você estava convergindo.
A questão da escala
O PCA persegue variância, que tem unidade. O dataset de vinhos tem 13 medidas químicas de 178 vinhos de três cultivares; uma delas, a prolina, é medida na casa das centenas, enquanto a tonalidade (hue) fica em torno de 1. Ajuste o PCA duas vezes, nas colunas brutas e nas padronizadas (Pré-processamento):
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.preprocessing import StandardScaler

X_wine, y_wine = load_wine(return_X_y=True, as_frame=True)
print(X_wine.std().round(1).sort_values(ascending=False).head(3).to_dict())

raw = PCA().fit(X_wine)
std = PCA().fit(StandardScaler().fit_transform(X_wine))
print("variance ratio, raw columns:         ", raw.explained_variance_ratio_[:3].round(3))
print("variance ratio, standardized columns:", std.explained_variance_ratio_[:3].round(3))
print("largest |weights| in PC1, raw:", pd.Series(raw.components_[0], X_wine.columns).abs().nlargest(2).round(3).to_dict())
print("largest |weights| in PC1, std:", pd.Series(std.components_[0], X_wine.columns).abs().nlargest(3).round(3).to_dict())
print("sum of eigenvalues, standardized:", std.explained_variance_.sum().round(3))
{'proline': 314.9, 'magnesium': 14.3, 'alcalinity_of_ash': 3.3}
variance ratio, raw columns:          [0.998 0.002 0.   ]
variance ratio, standardized columns: [0.362 0.192 0.111]
largest |weights| in PC1, raw: {'proline': 1.0, 'magnesium': 0.018}
largest |weights| in PC1, std: {'flavanoids': 0.423, 'total_phenols': 0.395, 'od280/od315_of_diluted_wines': 0.376}
sum of eigenvalues, standardized: 13.073
Nas colunas brutas, a PC1 "explica" 99,8% da variância e é, essencialmente, a coluna prolina sozinha (peso 1,000). Isso não é uma descoberta sobre vinho, é uma medida da unidade da prolina. Depois de padronizar, a variância se espalha (36,2%, 19,2%, 11,1%) e a PC1 vira uma mistura de flavonoides, fenóis totais e a razão OD280, química que de fato varia junto. Padronizar é o mesmo que rodar o PCA sobre a matriz de correlação, cujo traço é o número de colunas: os autovalores somam 13, vezes \(n/(n-1) = 178/177\), porque o scaler divide por \(n\) e o PCA por \(n-1\).
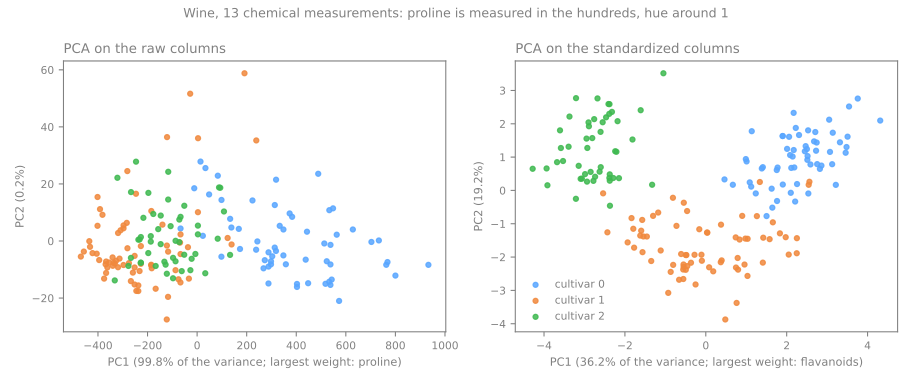
Isso importa mais adiante? Use um modelo como caixa-preta por um momento: um classificador k-NN (ele tem aula própria mais tarde) que vê apenas as duas coordenadas do PCA, ajustado em 70% dos vinhos e avaliado nos outros 30%:
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline

X_tr, X_te, y_tr, y_te = train_test_split(X_wine, y_wine, test_size=0.3,
                                          stratify=y_wine, random_state=0)
for name, pipe in [("raw -> PCA(2) -> k-NN", make_pipeline(PCA(2), KNeighborsClassifier())),
                   ("scaled -> PCA(2) -> k-NN", make_pipeline(StandardScaler(), PCA(2),
                                                             KNeighborsClassifier()))]:
    print(f"{name:25s} test accuracy {pipe.fit(X_tr, y_tr).score(X_te, y_te):.3f}")
De 72,2% para 92,6% dos vinhos separados para teste, com o mesmo resumo de dois números; a única diferença é se a prolina teve permissão para gritar. Repare também onde fica o PCA: dentro do pipeline, para ser ajustado só nos vinhos de treino (ajustá-lo em todos os dados antes vazaria o teste para dentro da projeção, o mesmo erro de ajustar um scaler antes da divisão).
Quando padronizar
Padronize quando as colunas estão em unidades diferentes (reais e anos, mg/L e pH). Não padronize às cegas quando elas compartilham a unidade e a variância tem significado, como nos pixels de uma imagem: ali um pixel de borda quase constante seria inflado até a mesma importância dos traços do meio.
Escolhendo k
Com mais colunas, a questão passa a ser quantos componentes manter. O dataset digits tem 1.797 imagens de 8×8 = 64 pixels, todos na mesma unidade (intensidade de tinta de 0 a 16), portanto sem padronização:
from sklearn.datasets import load_digits

X_dig, y_dig = load_digits(return_X_y=True)
pca = PCA().fit(X_dig)
cum = np.cumsum(pca.explained_variance_ratio_)
print("first 5 ratios:", pca.explained_variance_ratio_[:5].round(3))
print("cumulative at k = 2, 10, 20:", cum[[1, 9, 19]].round(3))
for target in [0.90, 0.95, 0.99]:
    print(f"k for {target:.0%}: {np.searchsorted(cum, target) + 1}")
print("PCA(n_components=0.95) keeps", PCA(n_components=0.95).fit(X_dig).n_components_, "components")
first 5 ratios: [0.149 0.136 0.118 0.084 0.058]
cumulative at k = 2, 10, 20: [0.285 0.738 0.894]
k for 90%: 21
k for 95%: 29
k for 99%: 41
PCA(n_components=0.95) keeps 29 components
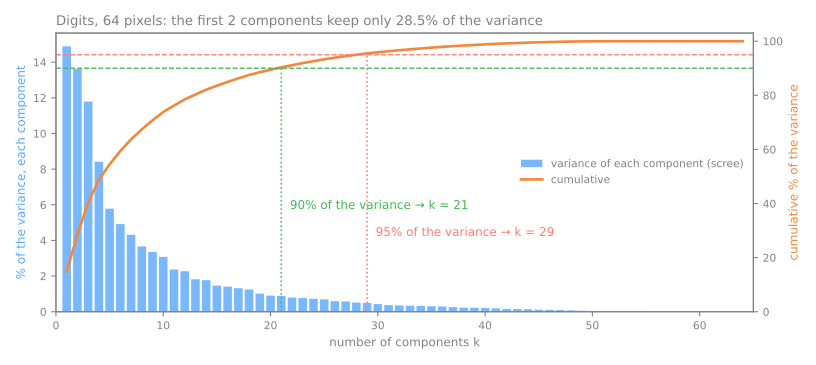
Os dois primeiros componentes guardam só 28,5% da variância: uma figura 2D de PCA dos dígitos mostra menos de um terço do que existe. Os critérios usuais, em ordem decrescente de quanto você deve confiar neles:
- Limiar de variância acumulada (90%, 95%, 99%): simples e defensável, o padrão em compressão. Aqui, 95% exige 29 de 64 componentes;
PCA(n_components=0.95)faz a busca por você; - Cotovelo do scree plot: visual e subjetivo; útil quando há uma quebra clara, o que não é o caso aqui;
- Desempenho a jusante: tratar \(k\) como hiperparâmetro do modelo que usa os componentes e escolhê-lo em dados de validação. É o único critério válido quando o PCA é pré-processamento de um classificador; a validação cruzada tornará essa escolha robusta mais adiante no curso;
- Critério de Kaiser (manter \(\lambda > 1\) em dados padronizados): comum em estatística aplicada, mas frágil.
A mesma curva é uma estimativa barata da dimensão intrínseca da seção sobre a maldição da dimensionalidade: 64 pixels, mas umas 29 direções que importam.
Reconstrução: o que k componentes de fato guardam
O PCA é reversível. Desça de \(d\) dimensões para \(k\) e projete de volta (inverse_transform): você obtém uma aproximação cujo erro é exatamente a variância descartada, \(\sum_{j>k}\lambda_j\), como no passo 6 da conta à mão. Nos dígitos:
n = len(X_dig)
print(" k    kept   error/image   discarded eigenvalues")
for k in [1, 2, 5, 10, 20, 29, 40, 64]:
    p = PCA(n_components=k).fit(X_dig)
    X_rec = p.inverse_transform(p.transform(X_dig))
    error = ((X_dig - X_rec) ** 2).sum(axis=1).mean()           # erro quadrático por imagem
    discarded = pca.explained_variance_[k:].sum() * (n - 1) / n
    print(f"{k:2d}  {cum[k - 1]:6.1%}   {error:10.1f}   {discarded:12.1f}")
 k    kept   error/image   discarded eigenvalues
 1   14.9%       1022.6         1022.6
 2   28.5%        858.9          858.9
 5   54.5%        546.7          546.7
10   73.8%        314.5          314.5
20   89.4%        127.0          127.0
29   95.5%         54.3           54.3
40   98.8%         14.2           14.2
64  100.0%          0.0            0.0
As duas últimas colunas são o mesmo número, linha a linha: o erro quadrático médio de reconstrução por imagem é a soma dos autovalores descartados (a menos do fator \(n-1\) contra \(n\)). É a segunda derivação do PCA, conferida numericamente.
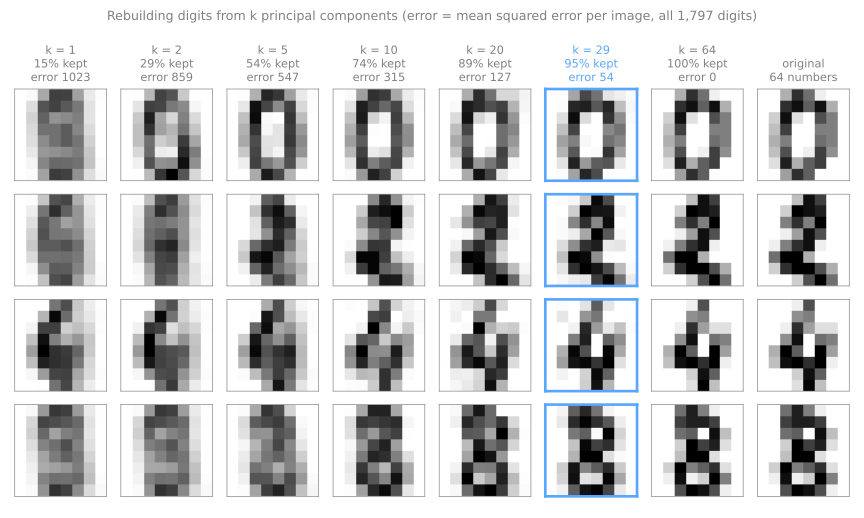
Com 29 números por imagem (mais uma média e 29 imagens-componente, guardadas uma única vez), os dígitos ficam quase indistinguíveis dos originais de 64 pixels. É por isso que o PCA também serve de compressão e de remoção de ruído: as direções descartadas são as de baixa variância, justamente onde o ruído costuma ficar. O simulador faz o mesmo com imagens 12×12. Deslize \(k\) e veja de quão poucos componentes o olho precisa até parar de reclamar:
Cinco armadilhas do PCA
- Não padronizar colunas em unidades diferentes: você mede a escolha da unidade, não a estrutura (os vinhos, acima).
- Ajustar antes da divisão.
PCA().fit(X_todo)deixa as linhas de teste moldarem a projeção. Ajuste só nos dados de treino, o que um pipeline faz por você. - Supor que os componentes de alta variância são os úteis para prever. O PCA nunca olha o alvo; nada garante que o sinal esteja nos primeiros componentes; há casos clássicos em que ele está no último.
- Ler componentes como fatores do mundo real. Os sinais são arbitrários; além disso, quando dois autovalores são próximos, qualquer rotação dentro do plano deles é igualmente válida.
- PCA em colunas one-hot sem pensar. Roda, mas uma coluna 0/1 tem variância \(p(1-p)\), então categorias raras são descartadas quase automaticamente.
Onde a PCA se esgota
Etapa 3. O PCA só pode rotacionar e projetar: move os eixos, nunca os dobra. Quando a estrutura dos dados é uma dobra, isso é fatal.
O rocambole suíço (swiss roll) é o contraexemplo padrão: uma folha 2D enrolada em 3D. Dois pontos em camadas opostas do rolo podem estar perto em linha reta e muito longe ao longo da folha. Marque marcar par de pontos para ver um desses pares, depois projete com PCA e veja as duas cores se misturarem:
A distinção que o simulador torna visível é entre a distância euclidiana (atravessando o espaço vazio entre as camadas) e a distância geodésica (caminhando sobre a superfície). Os métodos de variedade (manifold) são os que usam a segunda.
Para medir a "mistura", precisamos de uma nota para um mapa 2D. A trustworthiness (confiabilidade; Venna & Kaski, 2001), sklearn.manifold.trustworthiness, pergunta: dos \(k\) vizinhos mais próximos de cada ponto no mapa, quantos eram vizinhos de verdade no espaço de referência? Os intrusos são penalizados por quão longe estavam de fato. 1 significa nenhum intruso; um mapa aleatório fica em torno de 0,5. No rocambole, a referência é a posição de cada ponto na folha desenrolada, que o make_swiss_roll nos dá:
from sklearn.datasets import make_swiss_roll
from sklearn.manifold import Isomap, trustworthiness

X_roll, t = make_swiss_roll(n_samples=1000, noise=0.1, random_state=0)
sheet = np.column_stack([t, X_roll[:, 1]])      # posição na folha desenrolada

for name, model in [("PCA", PCA(n_components=2)), ("Isomap", Isomap(n_neighbors=10))]:
    E = model.fit_transform(X_roll)
    print(f"{name:7s} trustworthiness vs the sheet: {trustworthiness(sheet, E, n_neighbors=12):.3f}")
O mapa do PCA tem intrusos por toda parte (0,810): pontos de camadas diferentes caem uns sobre os outros. O Isomap (Tenenbaum, de Silva & Langford, 2000) constrói um grafo ligando cada ponto a seus 10 vizinhos mais próximos, mede distâncias caminhando por esse grafo (uma aproximação da geodésica) e então dispõe os pontos respeitando essas distâncias. Ele desenrola a folha (0,976).
O Isomap é um de uma família de métodos não lineares. Todos fazem a mesma aposta: a distância euclidiana só é confiável localmente. Construa um grafo de vizinhança onde ela vale e deduza a forma global a partir do grafo.
| Método | Ideia | Situação hoje |
|---|---|---|
| Kernel PCA | PCA no espaço de atributos implícito de um kernel | útil, mas exige escolher o kernel; memória \(O(n^2)\) |
| MDS | preservar todas as distâncias par a par | base histórica; sofre com o amontoamento |
| Isomap | MDS sobre distâncias geodésicas de um grafo de vizinhos | elegante; sensível a arestas de "atalho" entre camadas |
| LLE / Laplacian eigenmaps | preservar reconstruções lineares locais / autovetores do laplaciano do grafo | ancestrais teóricos do UMAP |
| t-SNE | casar distribuições de vizinhança | o padrão de visualização desde 2008 |
| UMAP | grafo difuso de vizinhança + layout por otimização | o padrão atual em escala |
| Autoencoder | aprender o mapa e seu inverso com uma rede neural | paramétrico e reversível; a ponte com deep learning |
Métodos não lineares: t-SNE e UMAP
t-SNE (van der Maaten & Hinton, 2008)
A ideia em uma frase: transformar distâncias em probabilidades de vizinhança nos dois espaços e mover os pontos de um mapa 2D até que os dois conjuntos de probabilidades coincidam.
- Vizinhanças no espaço original. Para cada ponto \(i\), uma gaussiana centrada nele dá a cada outro ponto \(j\) uma probabilidade \(p_{j|i}\) de ser seu vizinho. A largura \(\sigma_i\) é ajustada separadamente para cada ponto até que a vizinhança tenha um tamanho prescrito, a perplexidade, grosso modo "o número efetivo de vizinhos". Regiões densas ganham \(\sigma_i\) pequeno, regiões esparsas um grande: o t-SNE adapta sozinho sua escala à densidade local (guarde isso; é o motivo de o tamanho dos grupos no mapa não significar nada).
- Vizinhanças no mapa, \(q_{ij}\), usam uma distribuição t de Student com um grau de liberdade, cujas caudas são bem mais pesadas que as de uma gaussiana. Em 10 dimensões, um ponto tem espaço para muitos vizinhos a distância moderada; em 2D esse espaço não existe (o problema do amontoamento). A cauda pesada permite colocar pares moderadamente distantes muito longe a baixo custo, o que libera espaço para separar os grupos. Efeito colateral: as distâncias entre grupos no mapa deixam de ser interpretáveis.
- Minimizar a divergência de Kullback–Leibler \(\text{KL}(P\,\|\,Q) = \sum p_{ij} \log (p_{ij}/q_{ij})\) por gradiente descendente. A KL é assimétrica: vizinhos de verdade desenhados longe (\(p\) alto, \(q\) baixo) custam caro; pontos distantes desenhados perto (\(p\) baixo, \(q\) alto) saem quase de graça. Daí: o que está perto no mapa pode não estar perto nos dados; o que está perto nos dados costuma estar perto no mapa.
O simulador abaixo roda gradiente descendente de verdade sobre a divergência KL, no seu navegador; nada é pré-calculado:
Três experimentos que vale fazer antes de confiar em qualquer gráfico de t-SNE que você não fez:
- escolha ruído uniforme e rode. O t-SNE ainda vai produzir bolhas com aparência organizada. O método sempre devolve agrupamentos; os dados nem sempre os contêm.
- mantenha o conjunto e mude só a perplexidade. O número de grupos aparentes pode mudar. Informe a perplexidade junto de qualquer figura de t-SNE, como você informaria uma semente aleatória;
- escolha grupos de tamanhos diferentes e compare os tamanhos na tela com os reais. Eles não batem.
O que um mapa t-SNE não diz, medido
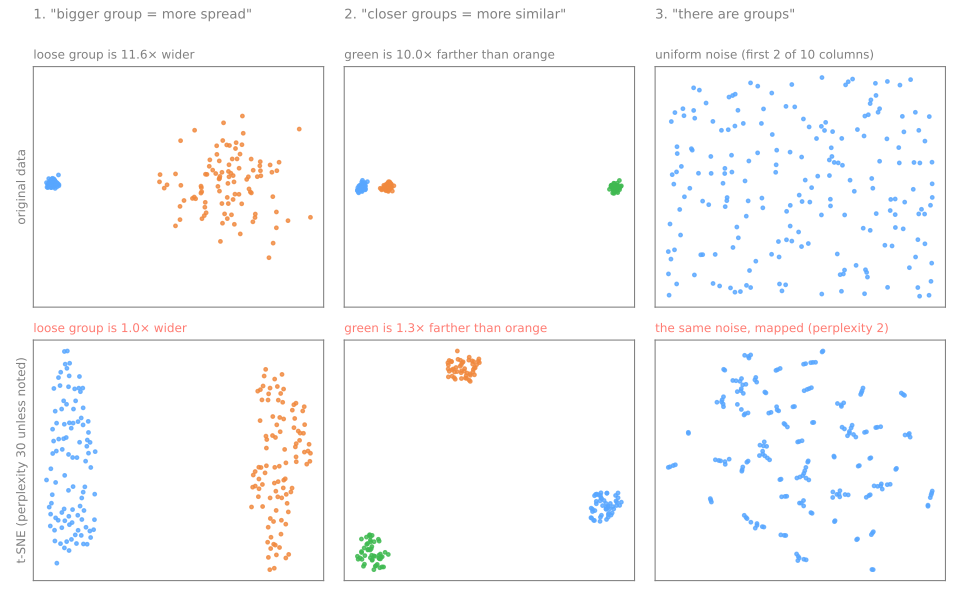
O simulador mostra; agora meça. Três pequenos conjuntos em que a verdade é conhecida (Wattenberg, Viégas & Johnson, 2016, construíram muitos outros): dois grupos de 100 pontos, um dez vezes mais largo que o outro; três grupos compactos numa reta, azul em 0, laranja em 10 e verde em 100; e 200 pontos de ruído puro em 10 dimensões.
from sklearn.manifold import TSNE

rng = np.random.default_rng(42)
sizes = np.vstack([rng.normal(0, 1, (100, 2)),                 # grupo compacto, desvio 1
                   rng.normal(0, 10, (100, 2)) + [60, 0]])     # grupo espalhado, desvio 10
g_sizes = np.repeat([0, 1], 100)
dists = np.vstack([rng.normal(0, 1, (50, 2)) + c for c in [[0, 0], [10, 0], [100, 0]]])
g_dists = np.repeat([0, 1, 2], 50)                             # azul, laranja, verde
noise = rng.random((200, 10))                                  # 10 colunas de ruído puro

def spread(Z):          # distância quadrática média dos pontos de um grupo ao seu centro
    return np.sqrt(((Z - Z.mean(axis=0)) ** 2).sum(axis=1).mean())

def size_ratio(Z):      # quantas vezes mais largo é o grupo espalhado
    return spread(Z[g_sizes == 1]) / spread(Z[g_sizes == 0])

def dist_ratio(Z):      # distância(azul, verde) / distância(azul, laranja), entre centros
    m = [Z[g_dists == k].mean(axis=0) for k in range(3)]
    return np.linalg.norm(m[0] - m[2]) / np.linalg.norm(m[0] - m[1])

E_sizes = TSNE(perplexity=30, random_state=0).fit_transform(sizes)
E_dists = TSNE(perplexity=30, random_state=0).fit_transform(dists)
print(f"size ratio:     data {size_ratio(sizes):5.1f}   t-SNE {size_ratio(E_sizes):4.1f}")
print(f"distance ratio: data {dist_ratio(dists):5.1f}   t-SNE {dist_ratio(E_dists):4.1f}")
O grupo espalhado é 11,6 vezes mais largo que o compacto; no mapa, os dois têm o mesmo tamanho (1,0). O verde está 10 vezes mais longe do azul que o laranja; no mapa, 1,3 vez. As duas coisas são consequência do projeto, não defeitos: o \(\sigma_i\) por ponto iguala grupos densos e esparsos; a cauda pesada faz "longe" e "muito longe" custarem o mesmo.
A perplexidade muda a figura. Os mesmos três grupos, a mesma semente, quatro perplexidades:
for p in [2, 5, 30, 100]:
    E = TSNE(perplexity=p, random_state=0).fit_transform(dists)
    print(f"perplexity {p:3d}: distance ratio {dist_ratio(E):.1f}")
perplexity   2: distance ratio 3.3
perplexity   5: distance ratio 1.1
perplexity  30: distance ratio 1.3
perplexity 100: distance ratio 7.0
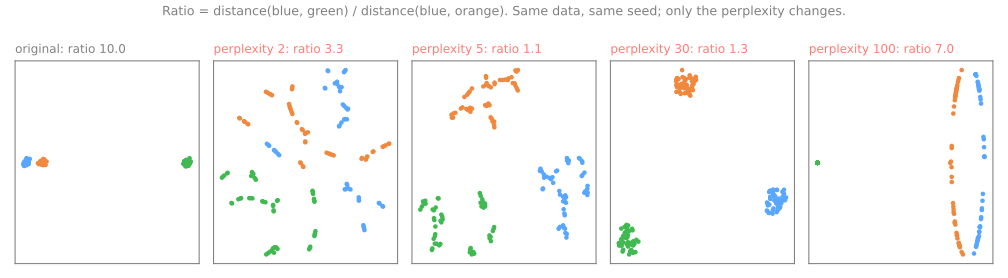
Com perplexidade 2 cada ponto olha para um par de vizinhos e todo grupo se estilhaça em fragmentos que não existem. Com 30 os grupos saem limpos, mas equidistantes. Com 100 as vizinhanças abrangem a maior parte dos 150 pontos e parte da geometria global volta (7,0), ao preço de grupos deformados. Não existe perplexidade "certa". A faixa usual vai de 5 a 50 e o valor precisa ser menor que o menor grupo que você quer enxergar; a prática honesta é rodar várias e confiar só no que persiste.
O t-SNE encontra grupos no ruído. Um agrupamento k-means avaliado pela silhueta (os dois são da próxima aula; aqui são caixas-pretas: a silhueta fica perto de 1 para grupos bem separados e perto de 0 quando não há grupos) diz quão "agrupado" parece um conjunto de pontos:
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

def best_silhouette(Z):         # k-means com k = 2..6; a melhor silhueta encontrada
    return max(silhouette_score(Z, KMeans(k, n_init=10, random_state=0).fit_predict(Z))
               for k in range(2, 7))

print(f"10-column noise itself: silhouette {best_silhouette(noise):.2f}")
for p in [2, 30]:
    E = TSNE(perplexity=p, random_state=0).fit_transform(noise)
    print(f"  t-SNE, perplexity {p:2d}: silhouette {best_silhouette(E):.2f}   "
          f"trustworthiness {trustworthiness(noise, E, n_neighbors=12):.2f}")
low = np.random.default_rng(0).random((200, 4))               # ruído em só 4 colunas
E = TSNE(perplexity=30, random_state=0).fit_transform(low)
print(f"4-column noise itself:  silhouette {best_silhouette(low):.2f}")
print(f"  t-SNE, perplexity 30: silhouette {best_silhouette(E):.2f}   "
      f"trustworthiness {trustworthiness(low, E, n_neighbors=12):.2f}")
10-column noise itself: silhouette 0.09
  t-SNE, perplexity  2: silhouette 0.42   trustworthiness 0.79
  t-SNE, perplexity 30: silhouette 0.38   trustworthiness 0.86
4-column noise itself:  silhouette 0.23
  t-SNE, perplexity 30: silhouette 0.43   trustworthiness 0.97
O ruído de 10 colunas não tem grupos (silhueta 0,09); seus mapas t-SNE parecem de quatro a cinco vezes mais "agrupados". A trustworthiness não resolve o problema. Aqui ela é mais baixa que em estrutura real (0,86, contra 0,99 para os dígitos mais abaixo), mas com ruído em 4 colunas ela chega a 0,97, quase tão boa quanto a de um mapa real: a trustworthiness mede se as vizinhanças locais foram mantidas, mas o ruído também tem vizinhanças locais. Uma boa nota de fidelidade não certifica que a estrutura é real; só diz que o mapa é fiel ao que quer que estivesse lá. O remédio é uma comparação nula: embaralhe cada coluna de forma independente (isso destrói as relações entre colunas mas mantém a distribuição de cada uma), rode o mesmo pipeline e compare. Se os dados embaralhados parecerem igualmente estruturados, o que você viu foi o algoritmo, não os dados.
Eixos e execuções. A perda KL depende só das distâncias entre os pontos do mapa, então girar ou espelhar um mapa não muda nada: o otimizador não tem orientação preferida. Com inicialização aleatória, duas sementes produzem duas figuras diferentes:
from sklearn.neighbors import NearestNeighbors

def neighbor_overlap(A, B, k=10):   # fração dos 10 vizinhos de cada ponto em que dois mapas concordam
    na = NearestNeighbors(n_neighbors=k + 1).fit(A).kneighbors(A, return_distance=False)[:, 1:]
    nb = NearestNeighbors(n_neighbors=k + 1).fit(B).kneighbors(B, return_distance=False)[:, 1:]
    return np.mean([len(set(a) & set(b)) / k for a, b in zip(na, nb)])

E0 = TSNE(init="random", random_state=0).fit_transform(X_dig)
for seed in [1, 2, 3]:
    E = TSNE(init="random", random_state=seed).fit_transform(X_dig)
    r = np.corrcoef(E0[:, 0], E[:, 0])[0, 1]
    print(f"digits, seed 0 vs {seed}: horizontal axes |correlation| {abs(r):.1f}, "
          f"neighbor overlap {neighbor_overlap(E0, E):.0%}")
N0, N1 = [TSNE(init="random", random_state=s).fit_transform(noise) for s in [0, 1]]
print(f"noise,  seed 0 vs 1: neighbor overlap {neighbor_overlap(N0, N1):.0%}")
same = np.allclose(TSNE(random_state=0).fit_transform(noise), TSNE(random_state=1).fit_transform(noise))
print("default init='pca', seeds 0 and 1 give the same map:", same)
digits, seed 0 vs 1: horizontal axes |correlation| 1.0, neighbor overlap 90%
digits, seed 0 vs 2: horizontal axes |correlation| 0.0, neighbor overlap 94%
digits, seed 0 vs 3: horizontal axes |correlation| 0.1, neighbor overlap 85%
noise,  seed 0 vs 1: neighbor overlap 47%
default init='pca', seeds 0 and 1 give the same map: True
Nos dígitos (todas as 1.797 imagens, os mesmos dígitos de Escolhendo k), o eixo horizontal de uma execução tem correlação quase perfeita com o da semente 1 (|r| ≈ 1,0), nenhuma com o da semente 2 (|r| ≈ 0,0: aquele mapa saiu girado de um quarto de volta) e quase nenhuma com o da semente 3 (|r| ≈ 0,1), enquanto 85–94% dos dez vizinhos de cada ponto são os mesmos em todos os pares. As vizinhanças são reais; a orientação não. No ruído, só 47% dos vizinhos sobrevivem a uma troca de semente: estrutura que é artefato muda de lugar de uma execução para outra. Desde o scikit-learn 1.2, init="pca" é o padrão e torna o mapa reprodutível entre sementes; é conveniente, mas reprodutível não é o mesmo que estável. A estabilidade precisa ser verificada variando o que importa: a perplexidade, a amostra, a inicialização.
UMAP (McInnes, Healy & Melville, 2018)
O UMAP chega a uma figura parecida por outro caminho. Em vez de probabilidades sobre todos os pares, ele constrói explicitamente um grafo de k vizinhos mais próximos:
- cada ponto é ligado a seus
n_neighborspontos mais próximos, com pesos difusos que decaem com a distância; a escala é ajustada por ponto e todo ponto tem garantida ao menos uma aresta de peso 1, de modo que nenhum fica isolado; - os pesos direcionados são fundidos num único grafo difuso simétrico (o análogo da simetrização do t-SNE);
- um layout 2D é encontrado por gradiente descendente estocástico com amostragem negativa: a cada passo uma aresta é sorteada e suas duas pontas se atraem; alguns pontos aleatórios são sorteados e se repelem. A perda é uma entropia cruzada com uma penalidade explícita por aproximar pontos distantes (o termo que o t-SNE não tem); é daí que vem a estrutura global um pouco melhor do UMAP. Amostrar em vez de somar sobre todos os pares é o que o torna rápido.
Os dois parâmetros que importam:
n_neighbors(padrão 15): a escala na qual você declara que a distância euclidiana é confiável. Valores pequenos guardam detalhe local fino, mas podem partir o grafo em pedaços desconexos; valores grandes enxergam mais estrutura global e, num rocambole, começam a acrescentar arestas de atalho entre camadas, que é o que o PCA faz;min_dist(padrão 0,1): quão apertados os pontos podem ficar no mapa. Ele não muda quem é vizinho de quem, só quão compactos os grupos são desenhados: valores baixos produzem bolhas densas e muito convincentes; valores altos as espalham. É cosmético, não estrutural.
E a propriedade que o torna utilizável num pipeline: o UMAP tem transform. Depois de ajustado uma vez, ele posiciona pontos novos no mesmo mapa sem reajuste. O t-SNE não tem esse método; o único jeito de acrescentar pontos é recalcular o mapa inteiro, o que mexe em tudo. É exatamente esse o papel do UMAP dentro do BERTopic, onde ele reduz embeddings de texto antes do agrupamento.
O UMAP não faz parte do scikit-learn: instale o umap-learn (no Colab, rode !pip install umap-learn uma vez). Os mesmos dígitos: o UMAP é ajustado em 80% deles e posiciona os outros 20%:
import umap

print("PCA has transform:  ", hasattr(PCA(), "transform"))
print("TSNE has transform: ", hasattr(TSNE(), "transform"))

X_tr, X_te, y_tr, y_te = train_test_split(X_dig, y_dig, test_size=0.2,
                                          stratify=y_dig, random_state=0)
reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=0).fit(X_tr)
E_tr, E_te = reducer.embedding_, reducer.transform(X_te)       # imagens novas, mesmo mapa
nearest = NearestNeighbors(n_neighbors=1).fit(E_tr).kneighbors(E_te, return_distance=False)[:, 0]
print(E_tr.shape, E_te.shape)
print(f"new images whose nearest training image on the map is the same digit: {(y_tr[nearest] == y_te).mean():.1%}")
PCA has transform:   True
TSNE has transform:  False
(1437, 2) (360, 2)
new images whose nearest training image on the map is the same digit: 96.4%
As 360 imagens novas caem junto das do próprio dígito: 96,4% delas têm, como imagem de treino mais próxima no mapa, uma imagem do mesmo dígito. O mapa construído com as imagens de treino é uma função que você pode aplicar a dados novos, como a projeção do PCA e ao contrário do t-SNE.
PCA vs t-SNE vs UMAP, lado a lado
Etapa 4. Os dígitos e o rocambole suíço, cada um mapeado por PCA e t-SNE (os scripts das figuras usam só o scikit-learn, então o UMAP aparece na tabela abaixo e no lab):
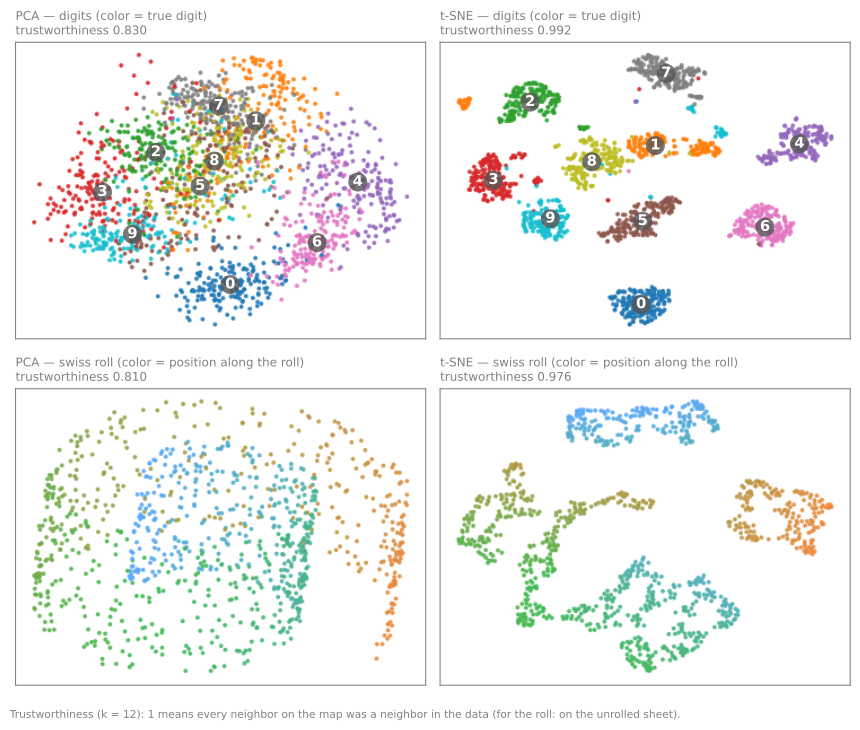
O PCA, a melhor visão linear, sobrepõe várias classes de dígitos: duas direções de variância máxima (28,5% dela) não bastam. O t-SNE separa as dez classes preservando as vizinhanças locais. O preço também é visível: os 1 são partidos em várias ilhas, o rocambole é cortado em pedaços cujas posições relativas não significam nada; eixos, tamanhos de grupos e distâncias entre grupos não têm interpretação.
Qual é "melhor" depende da escala que interessa. A trustworthiness recebe o tamanho da vizinhança \(k\) como parâmetro; \(k\) pequeno pergunta sobre os vizinhos imediatos, \(k\) grande sobre uma estrutura mais ampla:
maps = {"PCA": PCA(n_components=2).fit_transform(X_dig),
        "t-SNE": TSNE(random_state=0).fit_transform(X_dig),
        "UMAP": umap.UMAP(random_state=0).fit_transform(X_dig)}
print("         k=5    k=12   k=30   k=100")
for name, E in maps.items():
    print(f"{name:6s}", "  ".join(f"{trustworthiness(X_dig, E, n_neighbors=k):.3f}" for k in [5, 12, 30, 100]))
         k=5    k=12   k=30   k=100
PCA    0.830  0.830  0.830  0.835
t-SNE  0.995  0.992  0.985  0.963
UMAP   0.989  0.988  0.983  0.961
Nos dígitos, os dois mapas não lineares batem o PCA em todas as escalas. Ambos perdem fidelidade conforme \(k\) cresce, enquanto o PCA fica estável: t-SNE e UMAP gastam seu esforço nos vizinhos imediatos. Em outros dados o PCA pode vencer com \(k\) grande (o handout da aula mostra isso no Iris): não há vencedor até você dizer qual escala lhe interessa. Informe a trustworthiness para mais de um \(k\).
A tabela comparativa
| PCA | t-SNE | UMAP | |
|---|---|---|---|
| Natureza | linear, determinístico | não linear, estocástico | não linear, estocástico |
| Objetivo | variância máxima | divergência KL entre vizinhanças | entropia cruzada sobre um grafo difuso |
| Preserva estrutura local | fraco | muito bom | muito bom |
| Preserva estrutura global | ótimo (variância) | fraco | moderado |
| Distância entre grupos é interpretável? | sim | não | parcialmente |
| Tamanho dos grupos é interpretável? | sim | não | não |
| Reconstrução (inversa) | sim, exata dentro do subespaço | não | aproximada |
Aplicar a dados novos (transform) | sim, trivial | não | sim |
| Custo típico | muito rápido | lento (\(O(n \log n)\) com Barnes-Hut) | rápido (\(O(n \log n)\), constante menor) |
| Hiperparâmetros críticos | \(k\), padronização | perplexidade, iterações, taxa de aprendizado | n_neighbors, min_dist |
| Como pré-processamento de um modelo | recomendado | desaconselhado | com cautela, dentro do pipeline |
As sete afirmações proibidas sobre um gráfico t-SNE/UMAP
- "Este grupo é maior, logo varia mais." O tamanho no mapa é artefato da densidade local (medido acima: 11,6× mais largo nos dados, 1,0× no mapa).
- "Estes dois grupos estão próximos, logo são parecidos." As distâncias entre grupos não são preservadas (10× mais longe nos dados e 1,3× no mapa; a razão ainda muda com a perplexidade).
- "Há 5 grupos nos dados." Há 5 manchas no gráfico. Grupos se validam no espaço original (o t-SNE transformou ruído puro numa silhueta quatro a cinco vezes maior).
- "O eixo horizontal representa X." Os eixos não têm significado; rotação e reflexão são arbitrárias (quatro sementes nos dígitos: os eixos horizontais se correlacionam de |r| ≈ 0,0 a 1,0, com as mesmas vizinhanças).
- "Rodei uma vez e vi isso." Os resultados variam com a semente, a perplexidade e a amostra; reporte várias execuções e confie no que persiste.
- "Usei os 2 componentes do t-SNE como atributos do meu classificador." Não há
transformhonesto para dados novos; além disso, você comprimiu centenas de dimensões em 2 escolhidas para agradar aos olhos. - "Rodei o t-SNE no conjunto todo e depois dividi em treino/teste." Vazamento: o mapa foi construído usando as linhas de teste (veja vazamento de dados).
Um gráfico é uma hipótese, não um resultado. Se uma redução sustenta uma afirmação, ela precisa de um número: erro de reconstrução (PCA), trustworthiness em mais de uma escala, uma comparação nula contra dados embaralhados ou o desempenho de um modelo treinado sobre os dados reduzidos.
Escolhendo um método
| Objetivo | Método |
|---|---|
| Pré-processar atributos para um modelo subsequente | PCA (rápido, determinístico, tem transform) |
| Entender/interpretar direções de variação | PCA (os componentes são combinações lineares) |
| Visualizar estrutura de agrupamentos | t-SNE ou UMAP, com PCA antes se \(d\) for grande |
| Posicionar pontos novos num mapa existente | UMAP (o t-SNE não consegue) |
| Reduzir antes de agrupamento por densidade (ex.: HDBSCAN, BERTopic) | UMAP |
| Comprimir/remover ruído de imagens ou sinais | PCA |
A regra de decisão, em quatro linhas:
- vai alimentar outro modelo ou você precisa de reversibilidade → PCA. Ponto final;
- você quer olhar os dados para gerar hipóteses, com até alguns milhares de pontos → t-SNE ou UMAP, sempre com PCA antes se \(d\) for grande;
- \(n\) é grande ou você precisa projetar dados novos no mesmo mapa → UMAP;
- você precisa de estrutura global confiável numa figura → nenhum dos três é ideal; mostre e reporte os dois: o PCA (para a geometria) e o t-SNE/UMAP (para o detalhe local).
Exercícios
- À mão. Sem computador, para os pontos (2,1), (3,3), (4,3), (5,5): centralize os dados, escreva a matriz de covariância 2×2 com divisor \(n\), encontre os dois autovalores e diga que fração da variância a PC1 explica. Confira que os autovalores somam o traço e multiplicam o determinante.
- Ache o vazamento. Um colega reduz 5.000 colunas para 50 assim:
Z = PCA(50).fit_transform(StandardScaler().fit_transform(X)), depoistrain_test_split(Z, y), treina um modelo e reporta a acurácia de teste. O que está errado e como um pipeline resolve? Por que o problema piora quando o número de colunas é muito maior que o de linhas? - Escolha o método. Para cada caso, escolha PCA, t-SNE ou UMAP e justifique em uma frase: (a) comprimir 1.024 colunas de sensores para acelerar um modelo que roda 50.000 vezes por segundo; (b) explorar 8.000 células × 20.000 genes em busca de tipos celulares desconhecidos; (c) descobrir por que um classificador confunde duas classes, usando suas representações internas; (d) um mapa de produtos que precisa aceitar itens novos todo dia sem ser recalculado.
- Perplexidade. No simulador de t-SNE, rode 3 grupos iguais com perplexidade 2, 30 e 80; depois, ruído uniforme com perplexidade 5. O que uma perplexidade baixa faz com um grupo compacto? E uma alta? Que evidência você pediria a um colega antes de aceitar que os grupos do gráfico t-SNE dele são reais?
- Dimensão intrínseca. Um colega diz: "meu conjunto tem 5.000 colunas, então o t-SNE não vai funcionar por causa da maldição da dimensionalidade." O que você precisa saber antes de concordar? Como estimaria isso com uma ferramenta desta aula?
Respostas
- Média (3,5; 3); covariância \(\begin{pmatrix}1{,}25 & 1{,}5\\ 1{,}5 & 2\end{pmatrix}\); traço 3,25, determinante 0,25; \(\lambda = (3{,}25 \pm \sqrt{3{,}25^2 - 1})/2 = 3{,}1712\) e \(0{,}0788\); a PC1 explica 97,6%, porque os quatro pontos quase caem sobre uma reta.
- O scaler e o PCA foram ajustados em todas as linhas, teste incluído: a projeção "viu" o conjunto de teste e a nota sai otimista, tanto mais quando \(d \gg n\), porque com poucas linhas e muitas colunas as direções de variância máxima se ajustam às linhas particulares. Correção:
make_pipeline(StandardScaler(), PCA(50), modelo), dividir primeiro,fitsó nas linhas de treino. - (a) PCA: uma única multiplicação de matrizes na inferência, determinística. (b) PCA para ~50 componentes, depois UMAP; validar os grupos com marcadores conhecidos, não com o gráfico. (c) t-SNE ou UMAP coloridos por classe e por acerto/erro: diagnóstico visual local, nada é usado adiante. (d) UMAP, porque tem
transform. - Perplexidade baixa quebra um grupo real em vários subgrupos artificiais; perplexidade alta suaviza em direção à estrutura global e pode fundir grupos distintos. Evidências aceitáveis: um agrupamento medido no espaço original; estabilidade entre sementes e perplexidades; uma comparação nula com colunas embaralhadas; um modelo que separe os grupos usando as colunas originais.
- O que importa é quantas direções independentes de variação os dados têm, não o número de colunas (a folha girada acima tinha 1.000 colunas e nenhuma concentração). Estime com a variância explicada acumulada do PCA: se 30 componentes guardam 95%, a dimensão intrínseca linear é da ordem de 30, não de 5.000. É também por isso que PCA antes do t-SNE é o padrão.
Lab: mapeando CEPs manuscritos
O dataset USPS (Hull, 1994) reúne 9.298 dígitos manuscritos digitalizados de envelopes pelo serviço postal dos EUA, cada um uma imagem cinza de 16×16: 256 colunas, o dobro de pixels por lado dos dígitos acima. Você vai medir quantas dimensões ele realmente tem, comprimi-lo, desenhá-lo com PCA, t-SNE e UMAP, dar nota aos três mapas e verificar com números uma das afirmações proibidas.
Rode os blocos em ordem, numa mesma sessão (cerca de um minuto num notebook). Toda saída abaixo é o que o código imprime. Para trabalhar direto nele, baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook).
Passo 1 — carregar uma amostra
# No Colab, rode antes, numa célula separada:  !pip install umap-learn
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import fetch_openml
from sklearn.model_selection import train_test_split

usps = fetch_openml(data_id=41082, as_frame=True)          # dígitos USPS, 16x16 pixels
X_all = usps.data.to_numpy()
y_all = usps.target.astype(int).to_numpy() - 1              # o OpenML guarda o dígito d como classe d + 1
X, X_new, y, y_new = train_test_split(X_all, y_all, train_size=1500, test_size=500,
                                      stratify=y_all, random_state=0)
print(X_all.shape, "->", X.shape, "+", X_new.shape)
print("pixel range:", X.min(), "to", X.max())
print("images per digit:", np.bincount(y))

fig, axes = plt.subplots(1, 10, figsize=(10, 1.4))
for d, ax in enumerate(axes):
    ax.imshow(X[y == d][0].reshape(16, 16), cmap="gray_r")
    ax.set_title(d)
    ax.axis("off")
plt.show()
(9298, 256) -> (1500, 256) + (500, 256)
pixel range: -1.0 to 0.999663
images per digit: [251 205 150 133 137 115 135 128 114 132]
Como ler. Guardamos uma amostra estratificada de 1.500 imagens para mapear e outras 500 que os mapas só vão ver no passo 7. Confira o rótulo antes de qualquer coisa: o OpenML codifica o dígito 0 como classe "1", então subtraímos um; a fileira de imagens confirma que o rótulo d mostra o dígito d. Os pixels foram reescalados para [−1, 1] pelos autores do dataset e compartilham uma unidade, então não vamos padronizá-los. As classes são desbalanceadas (0 é o dígito mais comum nos envelopes, 8 o menos comum), o que não atrapalha nada do que vem a seguir.
Passo 2 — quantas dimensões o USPS realmente tem?
from sklearn.decomposition import PCA

pca = PCA().fit(X)
cum = np.cumsum(pca.explained_variance_ratio_)
print("first 3 components:", pca.explained_variance_ratio_[:3].round(3))
print("2 components keep:", cum[1].round(3))
for target in [0.90, 0.95, 0.99]:
    print(f"k for {target:.0%}: {np.searchsorted(cum, target) + 1} of 256")

plt.plot(np.arange(1, 257), cum)
plt.axhline(0.95, ls="--", color="gray")
plt.xlabel("number of components k")
plt.ylabel("cumulative explained variance")
plt.show()
first 3 components: [0.25  0.113 0.09 ]
2 components keep: 0.363
k for 90%: 22 of 256
k for 95%: 32 of 256
k for 99%: 62 of 256
Como ler. 256 pixels, mas 95% da variância cabe em umas 30 direções: pixels vizinhos são fortemente correlacionados (um traço cobre vários de uma vez), então a dimensão intrínseca fica muito abaixo do número de colunas. O primeiro componente sozinho guarda um quarto da variância; dois componentes guardam um pouco mais de um terço, que é o que um gráfico 2D de PCA vai mostrar.
Passo 3 — compressão e erro de reconstrução
n = len(X)
print("  k    kept   error/image   discarded eigenvalues")
for k in [1, 2, 5, 10, 20, 50, 100]:
    p = PCA(n_components=k).fit(X)
    X_rec = p.inverse_transform(p.transform(X))
    error = ((X - X_rec) ** 2).sum(axis=1).mean()
    discarded = pca.explained_variance_[k:].sum() * (n - 1) / n
    print(f"{k:3d}  {cum[k - 1]:6.1%}   {error:10.2f}   {discarded:12.2f}")

fig, axes = plt.subplots(1, 6, figsize=(9, 1.8))
for ax, k in zip(axes, [1, 5, 10, 20, 50, 256]):
    p = PCA(n_components=k).fit(X)
    ax.imshow(p.inverse_transform(p.transform(X[:1]))[0].reshape(16, 16), cmap="gray_r")
    ax.set_title(f"k = {k}")
    ax.axis("off")
plt.show()
  k    kept   error/image   discarded eigenvalues
  1   25.0%        50.99          50.99
  2   36.3%        43.28          43.28
  5   58.5%        28.23          28.23
 10   75.9%        16.40          16.40
 20   89.2%         7.34           7.34
 50   98.2%         1.21           1.21
100   99.8%         0.12           0.12
Como ler. Leia cada linha de ponta a ponta: o erro de reconstrução por imagem é igual à variância dos componentes descartados, até a última casa decimal. Com 20 de 256 números por imagem, o erro cai para cerca de um sétimo do erro com um componente e as imagens mostram um dígito claramente legível. Isso é o PCA como compressão: 20 números por imagem mais 20 imagens-componente guardadas uma vez, em vez de 256 números por imagem.
Passo 4 — três mapas das mesmas imagens
import umap
from sklearn.manifold import TSNE

reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=0).fit(X)
maps = {"PCA": PCA(n_components=2).fit_transform(X),
        "t-SNE": TSNE(perplexity=30, random_state=0).fit_transform(X),
        "UMAP": reducer.embedding_}
print({name: E.shape for name, E in maps.items()})

fig, axes = plt.subplots(1, 3, figsize=(15, 4.5))
for ax, (name, E) in zip(axes, maps.items()):
    points = ax.scatter(E[:, 0], E[:, 1], c=y, cmap="tab10", s=5)
    ax.set_title(name)
    ax.set_xticks([])
    ax.set_yticks([])
fig.colorbar(points, ax=axes, ticks=range(10))
plt.show()
Como ler. Olhe antes de medir. O PCA mostra algumas regiões reconhecíveis (os 1 e os 0 em extremos opostos da PC1) e um grande miolo sobreposto. O t-SNE desenha dez ilhas. O UMAP desenha ilhas mais apertadas (é o min_dist agindo) e reúne algumas delas em agrupamentos de agrupamentos, como 4, 7 e 9, ou 3, 5 e 8: dígitos que compartilham traços. Antes de confiar no que vê, lembre-se das sete afirmações proibidas: os próximos passos põem números nas figuras.
Passo 5 — dar nota aos mapas com a trustworthiness
from sklearn.manifold import trustworthiness

print("        k=5    k=12   k=30")
for name, E in maps.items():
    print(f"{name:6s}", "  ".join(f"{trustworthiness(X, E, n_neighbors=k):.3f}" for k in [5, 12, 30]))
Como ler. O primeiro argumento é sempre o espaço original (todos os 256 pixels), o segundo é o mapa; trocá-los dá um número diferente e sem sentido. O mapa 2D do PCA é o menos confiável em todas as escalas: muitos de seus vizinhos são intrusos de outras regiões. O t-SNE é o mais fiel para os vizinhos imediatos. Os dois mapas não lineares perdem um pouco conforme \(k\) cresce, já que gastam seu esforço na escala local.
Passo 6 — perplexidade
fig, axes = plt.subplots(1, 3, figsize=(15, 4.5))
for ax, p in zip(axes, [5, 30, 100]):
    E = maps["t-SNE"] if p == 30 else TSNE(perplexity=p, random_state=0).fit_transform(X)
    print(f"perplexity {p:3d}: trustworthiness {trustworthiness(X, E, n_neighbors=12):.3f}")
    ax.scatter(E[:, 0], E[:, 1], c=y, cmap="tab10", s=5)
    ax.set_title(f"perplexity {p}")
    ax.set_xticks([])
    ax.set_yticks([])
plt.show()
perplexity   5: trustworthiness 0.975
perplexity  30: trustworthiness 0.980
perplexity 100: trustworthiness 0.978
Como ler. As três notas ficam a poucos milésimos umas das outras, mas as figuras não: com perplexidade 5 as ilhas ficam irregulares e alguns dígitos se partem em vários pedaços; com 100 elas ficam mais redondas e mais apertadas umas contra as outras; 4, 7 e 9 começam a se fundir. A trustworthiness com \(k = 12\) mal percebe, porque as vizinhanças locais são mantidas nas três. O que muda é o arranjo das ilhas, que é exatamente a parte que você não pode interpretar. Informe a perplexidade em toda figura de t-SNE.
Passo 7 — UMAP: n_neighbors, min_dist e imagens novas
from sklearn.metrics import silhouette_score
from sklearn.neighbors import NearestNeighbors

print("                          trustworthiness   digits look separated (silhouette)")
for nn, md in [(5, 0.1), (15, 0.1), (50, 0.1), (15, 0.0), (15, 0.5)]:
    E = reducer.embedding_ if (nn, md) == (15, 0.1) else \
        umap.UMAP(n_neighbors=nn, min_dist=md, random_state=0).fit_transform(X)
    print(f"n_neighbors {nn:2d}, min_dist {md}   {trustworthiness(X, E, n_neighbors=12):.3f}"
          f"             {silhouette_score(E, y):.2f}")

E_new = reducer.transform(X_new)                    # 500 imagens que o mapa nunca viu
on_map = NearestNeighbors(n_neighbors=1).fit(reducer.embedding_).kneighbors(E_new, return_distance=False)[:, 0]
in_pixels = NearestNeighbors(n_neighbors=1).fit(X).kneighbors(X_new, return_distance=False)[:, 0]
print(f"new image next to its own digit - on the UMAP map: {(y[on_map] == y_new).mean():.1%}"
      f",  in the 256 pixels: {(y[in_pixels] == y_new).mean():.1%}")

plt.scatter(*reducer.embedding_.T, c="lightgray", s=4)
plt.scatter(*E_new.T, c=y_new, cmap="tab10", s=8)
plt.title("500 new images placed with reducer.transform")
plt.show()
                          trustworthiness   digits look separated (silhouette)
n_neighbors  5, min_dist 0.1   0.972             0.51
n_neighbors 15, min_dist 0.1   0.971             0.48
n_neighbors 50, min_dist 0.1   0.963             0.44
n_neighbors 15, min_dist 0.0   0.972             0.53
n_neighbors 15, min_dist 0.5   0.958             0.36
new image next to its own digit - on the UMAP map: 87.6%,  in the 256 pixels: 95.4%
Como ler. A silhueta (ensinada na próxima aula, de agrupamento; usada aqui como caixa-preta) dá nota a quão separados os dígitos verdadeiros parecem no mapa. O min_dist quase não mexe na trustworthiness, mas mexe muito na silhueta: com 0,0 as ilhas ficam compactas e muito convincentes, com 0,5 ficam espalhadas. Mesmos vizinhos, impressão diferente. É por isso que o min_dist é chamado de cosmético. O n_neighbors mexe um pouco nas duas: valores pequenos favorecem o detalhe local, valores grandes uma figura mais suave e global. A última linha mostra o transform em ação: imagens novas caem ao lado de uma imagem do próprio dígito na maior parte das vezes, embora menos do que no espaço completo de 256 pixels, porque parte da informação se perdeu na compressão para dois números.
Passo 8 — testar uma afirmação proibida: "um grupo maior varia mais"
def spread(Z):                       # distância quadrática média ao centro do grupo
    return np.sqrt(((Z - Z.mean(axis=0)) ** 2).sum(axis=1).mean())

print("digit   pixels   PCA   t-SNE   UMAP     (each group's spread / average spread)")
rel = {}
for name, E in [("pixels", X)] + list(maps.items()):
    s = np.array([spread(E[y == d]) for d in range(10)])
    rel[name] = s / s.mean()
for d in range(10):
    print(f"{d:5d}   " + "   ".join(f"{rel[name][d]:5.2f}" for name in rel))
digit   pixels   PCA   t-SNE   UMAP     (each group's spread / average spread)
    0    1.20    1.34    1.00    0.94
    1    0.48    0.28    0.88    0.89
    2    1.23    1.10    1.15    1.11
    3    1.05    0.98    0.77    0.73
    4    1.08    1.13    1.22    1.14
    5    1.19    1.15    1.26    1.34
    6    0.96    1.10    0.96    1.19
    7    0.88    0.83    1.02    0.73
    8    1.03    1.15    0.86    1.19
    9    0.92    0.95    0.86    0.73
Como ler. No espaço de 256 pixels, os 1 são de longe o grupo mais compacto: um 1 é um único traço e todos os 1 se parecem, então seu espalhamento é cerca de metade da média. O PCA mantém esse fato (os 1 são o grupo mais compacto no mapa dele também). Nos mapas do t-SNE e do UMAP, os 1 são desenhados com tamanho quase médio, indistinguíveis de dígitos que variam duas vezes mais. A afirmação 1 cai, medida em dados reais: o tamanho de uma ilha num mapa t-SNE ou UMAP não diz nada sobre quão variável é o grupo.
Sua vez
- O teste nulo. Embaralhe cada coluna de pixels de forma independente (
rng.permuted(X, axis=0)comrng = np.random.default_rng(0)), rode o t-SNE nas imagens embaralhadas e ponha lado a lado os mapas real e embaralhado. O mapa embaralhado ainda mostra grupos? Compare as duas trustworthiness com \(k = 12\). Aqui, ao contrário do ruído de 10 colunas da aula, a nota separa claramente os dois casos; por que ela funciona com 256 colunas? - PCA antes do t-SNE. Reduza para 50 componentes com PCA e rode o t-SNE nessas 50 colunas. Cronometre as duas versões com
time.perf_counter()e calcule a trustworthiness contra o espaço de 256 pixels (não contra os 50 componentes, o que esconderia o que a primeira redução perdeu). O ganho de velocidade valeu a pena? - Afirmação 2. Calcule os dez centros de dígito no espaço de pixels e em cada mapa; depois, a correlação de postos entre as 45 distâncias centro a centro (
scipy.stats.spearmanrsobrescipy.spatial.distance.pdist). Qual mapa preserva melhor as distâncias entre grupos? Subir a perplexidade para 100 ajuda o t-SNE? - Sementes. Rode o t-SNE com
init="random"e sementes 0, 1 e 2. Quais pares de dígitos são vizinhos nos três mapas? E quais só em um? Só os primeiros merecem ser relatados.
Lab de revisão: do EDA à redução de dimensionalidade
Este lab revisa o primeiro bloco do curso, EDA, pré-processamento, pipelines e esta aula, num único conjunto de dados do começo ao fim. Palmer Penguins: 344 pinguins, 6 colunas de entrada e 19 valores ausentes vindos de duas causas diferentes.
- análise univariada, depois bivariada;
- a separação treino/teste antes de qualquer transformação;
- um pipeline que trata ausentes e escalas sem vazar;
- os mesmos dados projetados por PCA, t-SNE e UMAP, comparados sob um único critério e depois aplicados a pontos novos.
Abrir o lab de revisão no Colab · 8 etapas, cada uma terminando num valor de verificação.
Material de aula
Roteiro — Redução de Dimensionalidade
Iris e MNIST, de 4 a 784 dimensões: PCA por duas derivações, escolha de \(k\), reconstrução e interpretação; onde o PCA falha em variedades não lineares e então t-SNE e UMAP, o que cada um preserva e distorce e uma regra de decisão para escolher entre eles. Anexo sobre a maldição da dimensionalidade. Cerca de 3 h, 12 simuladores ao vivo, um lab do Iris em 8 passos e 5 tarefas do MNIST.
Vídeo
Latent Space Visualisation: PCA, t-SNE, UMAP
Referências
- Pearson, K. "On Lines and Planes of Closest Fit to Systems of Points in Space." The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, Series 6, 2, n. 11 (1901): 559–572 — o PCA como a reta e o plano de melhor ajuste. DOI
- Hotelling, H. "Analysis of a Complex of Statistical Variables into Principal Components." Journal of Educational Psychology 24, n. 6 (1933): 417–441 — o PCA como variância máxima e a origem do nome. DOI
- Beyer, K.; Goldstein, J.; Ramakrishnan, R.; Shaft, U. "When Is 'Nearest Neighbor' Meaningful?" Database Theory — ICDT'99, LNCS 1540, Springer (1999): 217–235 — a concentração de distâncias em dimensão alta. DOI
- Tenenbaum, J. B.; de Silva, V.; Langford, J. C. "A Global Geometric Framework for Nonlinear Dimensionality Reduction." Science 290, n. 5500 (2000): 2319–2323 — o Isomap e o rocambole suíço. DOI
- Venna, J.; Kaski, S. "Neighborhood Preservation in Nonlinear Projection Methods: An Experimental Study." Artificial Neural Networks — ICANN 2001, LNCS 2130, Springer (2001): 485–491 — a medida de trustworthiness. DOI
- van der Maaten, L.; Hinton, G. "Visualizing Data using t-SNE." Journal of Machine Learning Research 9 (2008): 2579–2605. texto completo
- Wattenberg, M.; Viégas, F.; Johnson, I. "How to Use t-SNE Effectively." Distill (2016) — catálogo interativo do que os gráficos de t-SNE mostram e não mostram. DOI
- McInnes, L.; Healy, J.; Melville, J. "UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction." arXiv (2018). arXiv:1802.03426
- Kobak, D.; Berens, P. "The Art of Using t-SNE for Single-Cell Transcriptomics." Nature Communications 10 (2019): 5416 — inicialização por PCA, perplexidade e mapas t-SNE reprodutíveis. DOI
- Hull, J. J. "A Database for Handwritten Text Recognition Research." IEEE Transactions on Pattern Analysis and Machine Intelligence 16, n. 5 (1994): 550–554 — os dígitos USPS do lab (OpenML 41082). DOI