Por que reduzir? O motivo escolhe o método
| objetivo | o que se exige do método | método típico |
|---|---|---|
| ver os dados | uma figura em 2D ou 3D; fidelidade local basta | t-SNE, UMAP |
| comprimir / acelerar | reconstrução e uma transformação para dados novos | PCA |
| remover ruído / colinearidade | descartar as direções de baixa variância | PCA |
| alimentar outro modelo | fit/transform honestos, sem vazamento | PCA (quase sempre) |
O caminho desta parte
- A maldiçãoas distâncias perdem contraste
- PCA à mãocentralizar, covariância, autovetores, projetar
- Escala, k, reconstruçãounidades, variância explicada, erro de reconstrução
- Dobrar: t-SNE e UMAPonde o PCA se esgota; vizinhos em vez de variância
- Ler e escolhersete afirmações proibidas; o objetivo decide
A maldição da dimensionalidade
Sorteie pontos no cubo unitário e olhe as distâncias entre eles.
Simulador: distâncias em \(d\) dimensões
Aumente \(d\) e veja o histograma das distâncias colapsar num pico.
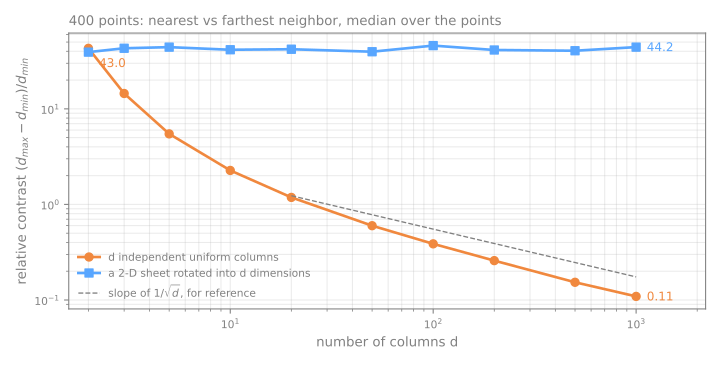
Contraste relativo, medido
\((d_{\max} - d_{\min})/d_{\min}\), mediana sobre 400 pontos:
| \(d\) | colunas de ruído | folha 2D em \(d\) colunas |
|---|---|---|
| 2 | 42,97 | 39,23 |
| 10 | 2,27 | 41,51 |
| 100 | 0,39 | 45,88 |
| 1000 | 0,11 | 44,24 |
PCA: as direções de variância máxima
Dados centrados \(X\); covariância \(C = \frac{1}{n-1} X^\top X\).
\[ w_1 = \arg\max_{\|w\|=1} w^\top C\, w \qquad \text{EVR}_k = \frac{\lambda_k}{\sum_j \lambda_j} \]- \(w_1\) é o autovetor de \(C\) com o maior autovalor \(\lambda_1\); o próximo é ortogonal a ele e assim por diante.
- \(\lambda_k\) é a variância capturada pelo componente \(k\); EVR é a razão de variância explicada (explained variance ratio).
PCA à mão, passo a passo
Cinco pontos: (2, 4), (4, 2), (5, 5), (6, 8), (8, 6). Preveja. Para onde a PC1 vai apontar e que fração da variância ela vai guardar? Depois percorra centralizar → covariância → autovalores → autovetor → projetar → reconstruir.
O mesmo em código e dois detalhes
np.linalg.eighdevolve os autovalores em ordem crescente: a melhor direção vem por último. Esquecer de ordenar é um bug silencioso.- O
PCAdo scikit-learn concorda:explained_variance_ratio_= [0,8; 0,2]. - Os sinais são arbitrários: \(w\) e \(-w\) são ambos autovetores; interprete os sinais relativos dentro de um componente, nunca o sinal absoluto.
- Pontos novos não exigem reajuste: \((9,7) - (5,5) = (4,2)\) e \((4+2)/\sqrt2 = 4{,}243\), exatamente o
pca.transform.
Simulador: gire a reta
Preveja. Conforme você gira a reta, em quantos ângulos a variância capturada chega ao máximo? Depois aperte encontrar PC1.
A questão da escala
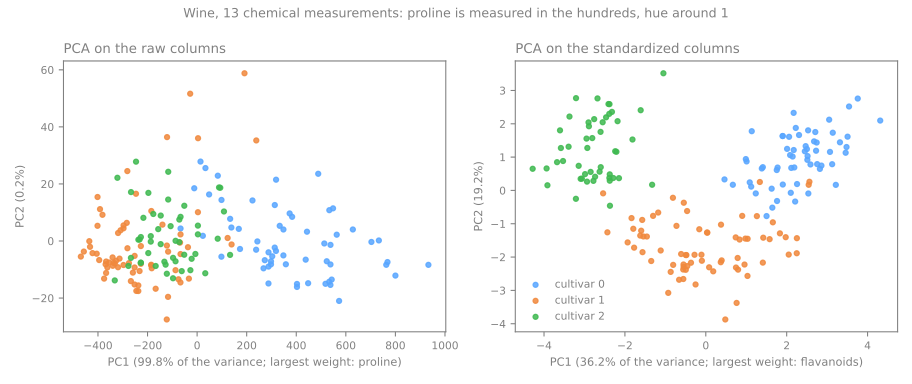
Vinhos: 13 medidas químicas de 178 vinhos. A prolina tem desvio-padrão 314,9; a tonalidade fica em torno de 1.
| razão de variância de PC1, PC2, PC3 | maiores pesos na PC1 | |
|---|---|---|
| colunas brutas | 0,998; 0,002; 0,0 | prolina 1,000 |
| padronizadas | 0,362; 0,192; 0,111 | flavonoides, fenóis totais, OD280 |
99,8% não é uma descoberta sobre vinho: é uma medida da unidade da prolina.
Isso importa mais adiante?
Um classificador k-NN (k vizinhos mais próximos) que só vê as duas coordenadas do PCA, em 30% dos vinhos:
bruto → PCA(2)
padronizado → PCA(2)
Escolhendo \(k\): 64 pixels de dígitos
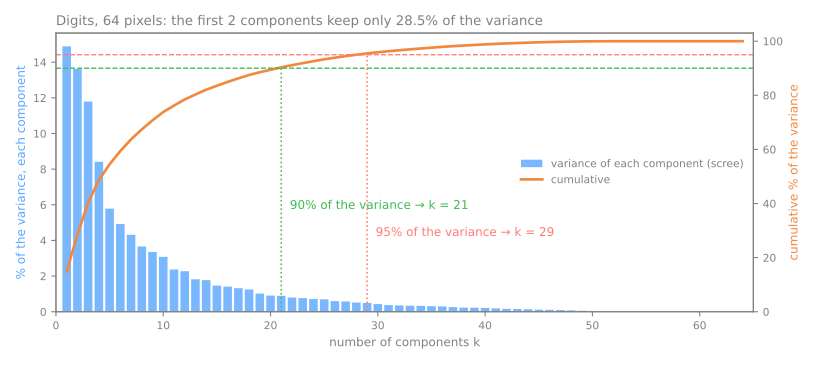
- 2 componentes guardam 28,5%: uma figura 2D de PCA mostra menos de um terço.
- 90% exige 21, 95% exige 29, 99% exige 41.
PCA(n_components=0.95)faz a busca por você.
Critérios, do mais confiável ao menos: um limiar de variância acumulada; o cotovelo (subjetivo); o desempenho a jusante em dados de validação; o critério de Kaiser (frágil).
Reconstrução: o que \(k\) componentes guardam
| \(k\) | guardado | erro / imagem | \(\lambda\) descartados |
|---|---|---|---|
| 1 | 14,9% | 1022,6 | 1022,6 |
| 2 | 28,5% | 858,9 | 858,9 |
| 10 | 73,8% | 314,5 | 314,5 |
| 29 | 95,5% | 54,3 | 54,3 |
| 64 | 100,0% | 0,0 | 0,0 |
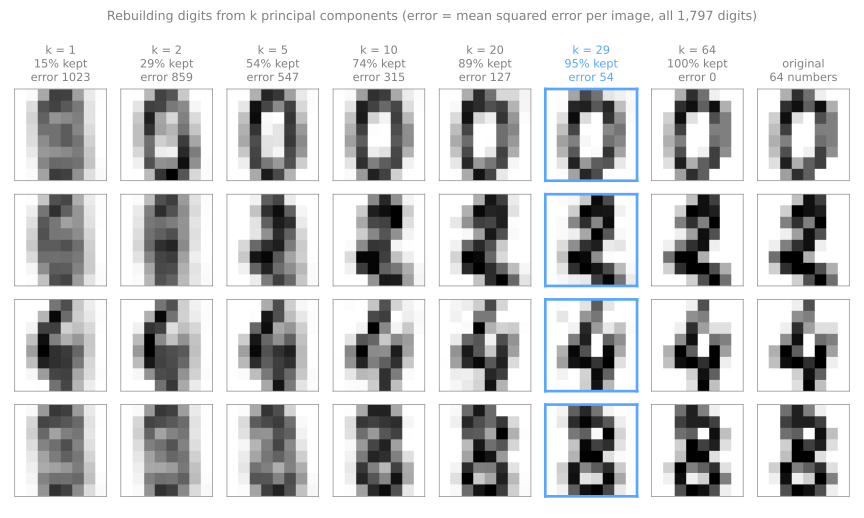
Simulador: reconstrua uma imagem com \(k\) componentes
Preveja. De quão poucos componentes o olho precisa até parar de reclamar?
Onde o PCA se esgota
O PCA só pode rotacionar e projetar: move os eixos, nunca os dobra.
O rocambole suíço (swiss roll): uma folha 2D enrolada em 3D. Dois pontos em camadas opostas estão perto em linha reta e longe ao longo da folha.
Simulador: o rocambole suíço
Marque marcar par de pontos e depois projete com PCA. A distância euclidiana atravessa o espaço vazio; a geodésica caminha sobre a folha.
O t-SNE em três passos
- Vizinhanças nos dados: uma gaussiana em torno de cada ponto, com a largura ajustada ponto a ponto até uma perplexidade ("número efetivo de vizinhos"). Regiões densas e esparsas ganham larguras diferentes.
- Vizinhanças no mapa: uma t de Student, de caudas pesadas, para abrir espaço em 2D. Efeito colateral: as distâncias entre grupos deixam de ser interpretáveis.
- Minimizar a divergência de Kullback–Leibler \(\text{KL}(P\,\|\,Q)\): vizinhos de verdade desenhados longe custam caro; pontos distantes desenhados perto saem quase de graça.
Simulador: t-SNE de verdade, no navegador
Experimente. Rode em ruído uniforme; mude só a perplexidade; compare grupos de tamanhos diferentes.
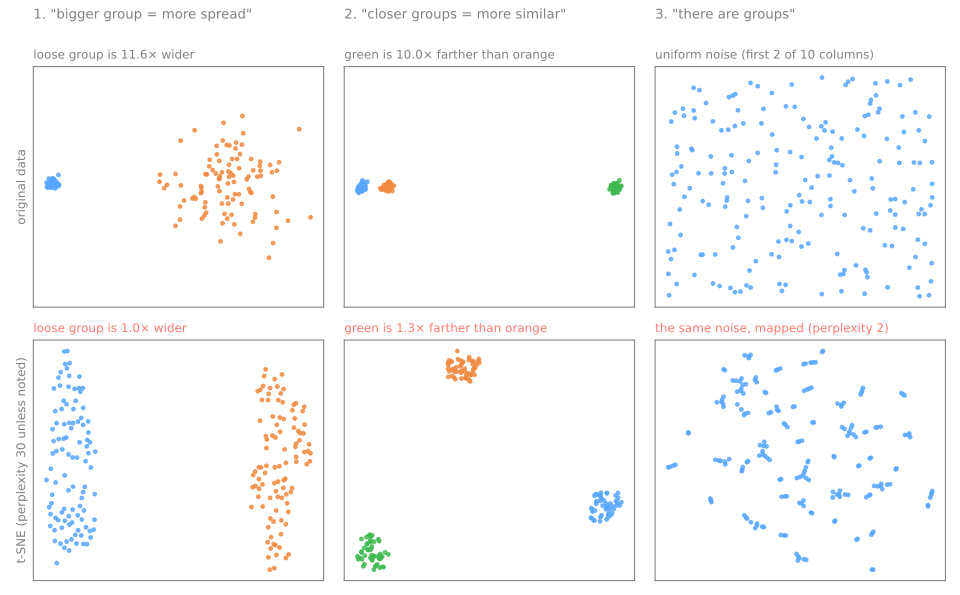
O que um mapa t-SNE não diz, medido
| dados | t-SNE | |
|---|---|---|
| quantas vezes mais largo é o grupo espalhado | 11,6 | 1,0 |
| quantas vezes mais longe está o grupo distante | 10,0 | 1,3 |
A perplexidade muda a figura
| perplexidade | razão de distâncias |
|---|---|
| 2 | 3,3 |
| 5 | 1,1 |
| 30 | 1,3 |
| 100 | 7,0 |
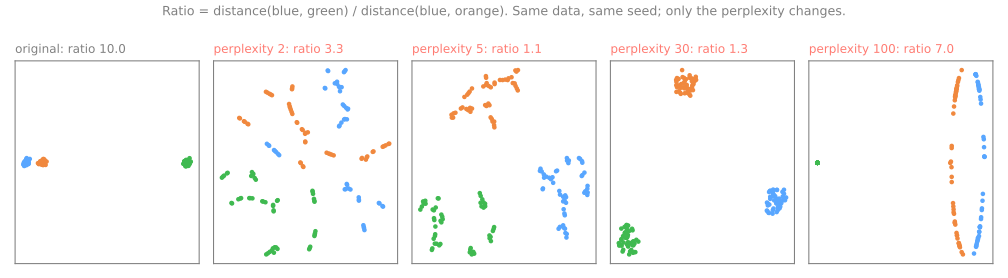
Com 2 e 5 todo grupo se estilhaça em fragmentos que não existem. Não há perplexidade "certa": em geral de 5 a 50, menor que o menor grupo que você quer enxergar.
UMAP: um grafo de vizinhos
- Cada ponto é ligado a seus
n_neighborspontos mais próximos, com pesos difusos; nenhum ponto fica isolado. - Os pesos são fundidos num único grafo difuso simétrico.
- Um layout 2D por gradiente descendente estocástico: as arestas atraem, pontos aleatórios sorteados repelem; uma penalidade explícita por aproximar pontos distantes.
n_neighbors (15)
a escala em que a distância euclidiana é confiável: detalhe local contra estrutura global
min_dist (0,1)
quão apertados os pontos ficam: cosmético, não estrutural
transform: ajustado em 80% dos dígitos, 96,4% das imagens novas caem ao lado de uma imagem do mesmo dígito.A tabela comparativa
| PCA | t-SNE | UMAP | |
|---|---|---|---|
| natureza | linear, determinístico | não linear, estocástico | não linear, estocástico |
| estrutura local | fraco | muito bom | muito bom |
| estrutura global | ótimo (variância) | fraco | moderado |
| distâncias / tamanhos dos grupos | sim / sim | não / não | parcialmente / não |
transform em dados novos | sim, trivial | não | sim |
| hiperparâmetros críticos | \(k\), padronização | perplexidade, iterações | n_neighbors, min_dist |
| pré-processamento de um modelo | recomendado | desaconselhado | com cautela, dentro do pipeline |
Sete afirmações proibidas sobre um gráfico t-SNE/UMAP
- "Este grupo é maior, logo varia mais." (11,6× nos dados, 1,0× no mapa)
- "Estes dois grupos estão próximos, logo são parecidos." (10× nos dados, 1,3× no mapa)
- "Há 5 grupos nos dados." Há 5 manchas no gráfico.
- "O eixo horizontal representa X." Rotação e reflexão são arbitrárias.
- "Rodei uma vez e vi isso." Varie a semente, a perplexidade, a amostra.
- "Usei os 2 componentes do t-SNE como atributos." Não há
transformhonesto. - "Rodei o t-SNE no conjunto todo e depois dividi." Vazamento.
Escolhendo um método
- Vai alimentar outro modelo ou você precisa de reversibilidade → PCA. Ponto final.
- Você quer olhar os dados para gerar hipóteses, com até alguns milhares de pontos → t-SNE ou UMAP, com PCA antes se \(d\) for grande.
- \(n\) é grande ou você precisa projetar dados novos no mesmo mapa → UMAP.
- Você precisa de estrutura global confiável numa figura → nenhum é ideal: mostre o PCA e o t-SNE/UMAP.
Resumo
- Muitas colunas só atrapalham quando não carregam estrutura; pergunte quantas direções de fato variam.
- PCA = autovetores da covariância, ordenados pelo autovalor; \(\lambda_k\) é a variância ao longo do componente \(k\).
- O guardado e o descartado dividem um orçamento: a variância explicada escolhe \(k\); o erro de reconstrução é a soma dos autovalores descartados.
- Padronize colunas em unidades diferentes, não pixels; ajuste o PCA dentro do pipeline.
- O t-SNE e o UMAP guardam vizinhos e nada mais; só o PCA e o UMAP posicionam pontos novos.
| sintoma | o que fazer |
|---|---|
| a PC1 explica 99% e é uma única coluna | padronizar e ajustar de novo |
| grupos bem arrumados num mapa t-SNE | validá-los no espaço original |
| um classificador alimentado com 2 coordenadas do t-SNE | PCA (ou UMAP) dentro do pipeline |
Mapeando CEPs manuscritos, passos 1 a 4
- Dígitos do USPS (serviço postal dos EUA): 9.298 dígitos manuscritos de envelopes, 16×16 = 256 colunas; mapeamos uma amostra de 1.500.
- Baixe o notebook do lab e abra no Jupyter ou no Colab; no Colab, rode antes
!pip install umap-learn. - Passos: 1. carregar uma amostra · 2. quantas dimensões? · 3. compressão e erro de reconstrução · 4. três mapas das mesmas imagens.
- Em cada passo, responda ao Preveja antes de rodar.
- Simulações: padronizar os pixels mesmo assim (passo 2) e comprimir imagens que o PCA nunca viu (passo 3).
Ritmo: passo 1 em 5 min; passo 2 e a primeira simulação em 10 min; passo 3 e a segunda em 10 min; passo 4 em 5 min.