Por que reduzir? O motivo escolhe o método
| objetivo | o que se exige do método | método típico |
|---|---|---|
| ver os dados | uma figura em 2D ou 3D; fidelidade local basta | t-SNE, UMAP |
| comprimir / acelerar | reconstrução e uma transformação para dados novos | PCA |
| remover ruído / colinearidade | descartar as direções de baixa variância | PCA |
| alimentar outro modelo | fit/transform honestos, sem vazamento | PCA (quase sempre) |
O caminho desta aula
- A maldiçãoas distâncias perdem contraste
- Linear: PCAà mão, escala, escolha de k, reconstrução
- Não linear: t-SNE, UMAPonde o PCA se esgota, o que um mapa não diz
- Comparar e escolherlado a lado, afirmações proibidas, o objetivo decide
A maldição da dimensionalidade
Sorteie pontos no cubo unitário e olhe as distâncias entre eles.
Simulador: distâncias em \(d\) dimensões
Aumente \(d\) e veja o histograma das distâncias colapsar num pico.
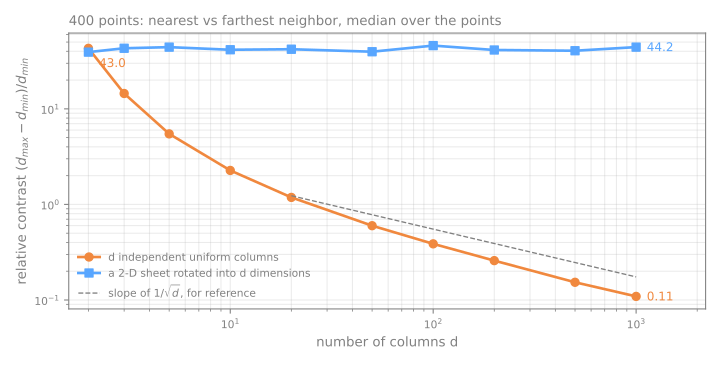
Contraste relativo, medido
\((d_{\max} - d_{\min})/d_{\min}\), mediana sobre 400 pontos:
| \(d\) | colunas de ruído | folha 2D em \(d\) colunas |
|---|---|---|
| 2 | 42,97 | 39,23 |
| 10 | 2,27 | 41,51 |
| 100 | 0,39 | 45,88 |
| 1000 | 0,11 | 44,24 |
PCA: as direções de variância máxima
Dados centrados \(X\); covariância \(C = \frac{1}{n-1} X^\top X\).
\[ w_1 = \arg\max_{\|w\|=1} w^\top C\, w \qquad \text{EVR}_k = \frac{\lambda_k}{\sum_j \lambda_j} \]- \(w_1\) é o autovetor de \(C\) com o maior autovalor \(\lambda_1\); o próximo é ortogonal a ele e assim por diante.
- \(\lambda_k\) é a variância capturada pelo componente \(k\); EVR é a razão de variância explicada (explained variance ratio).
PCA à mão: centralizar, depois a covariância
| \(x\) | \(y\) | \(x-\bar x\) | \(y-\bar y\) |
|---|---|---|---|
| 2 | 4 | −3 | −1 |
| 4 | 2 | −1 | −3 |
| 5 | 5 | 0 | 0 |
| 6 | 8 | 1 | 3 |
| 8 | 6 | 3 | 1 |
1. A média é \((5, 5)\).
2. Com \(n - 1 = 4\): a variância de \(x\) é \((9+1+0+1+9)/4 = 5\), a de \(y\) também; a covariância é \((3+3+0+3+3)/4 = 3\).
\[ C = \begin{pmatrix} 5 & 3 \\ 3 & 5 \end{pmatrix} \]PCA à mão: autovalores e direções
3. \(\det(C - \lambda I) = 0\):
\[ \lambda^2 - \underbrace{10}_{\text{traço}}\lambda + \underbrace{16}_{\det} = 0 \quad\Rightarrow\quad \lambda_1 = 8,\ \lambda_2 = 2 \]Conferência: \(8 + 2 = 10 = 5 + 5\), a variância total. Logo \(\text{EVR}_1 = 8/10 = 80\%\).
4. \((C - 8I)w = 0\) dá \(w_1 = w_2\): a PC1, o primeiro componente principal, é \((1,1)/\sqrt{2}\), a diagonal de 45°. A PC2 é \((-1,1)/\sqrt{2}\).
PCA à mão: projetar e reconstruir
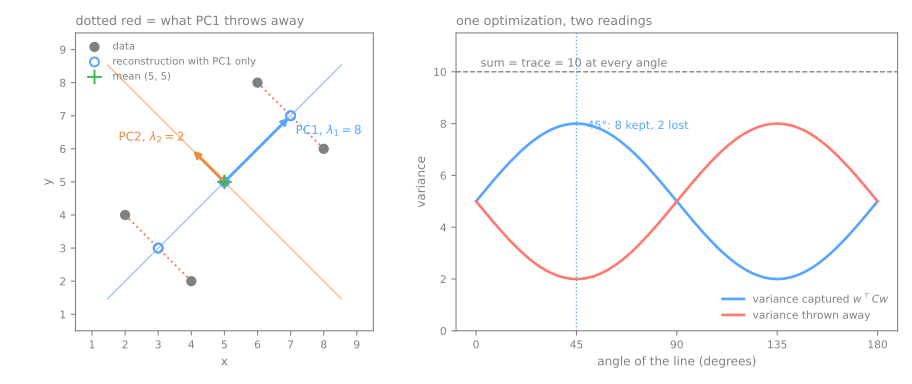
5. Escores na PC1: \(-2\sqrt2, -2\sqrt2, 0, 2\sqrt2, 2\sqrt2\). A variância deles é 8: o autovalor.
6. Só a PC1: \((2,4)\) e \((4,2)\) viram \((3,3)\); erro quadrático \(4 \times 2 = 8\) e \(8/4 = 2 = \lambda_2\).
O mesmo em código e dois detalhes
np.linalg.eighdevolve os autovalores em ordem crescente: a melhor direção vem por último. Esquecer de ordenar é um bug silencioso.- O
PCAdo scikit-learn concorda:explained_variance_ratio_= [0,8; 0,2]. - Os sinais são arbitrários: \(w\) e \(-w\) são ambos autovetores; interprete os sinais relativos dentro de um componente, nunca o sinal absoluto.
- Pontos novos não exigem reajuste: \((9,7) - (5,5) = (4,2)\) e \((4+2)/\sqrt2 = 4{,}243\), exatamente o
pca.transform.
Simulador: gire a reta
Preveja. Conforme você gira a reta, em quantos ângulos a variância capturada chega ao máximo? Depois aperte encontrar PC1.
A questão da escala
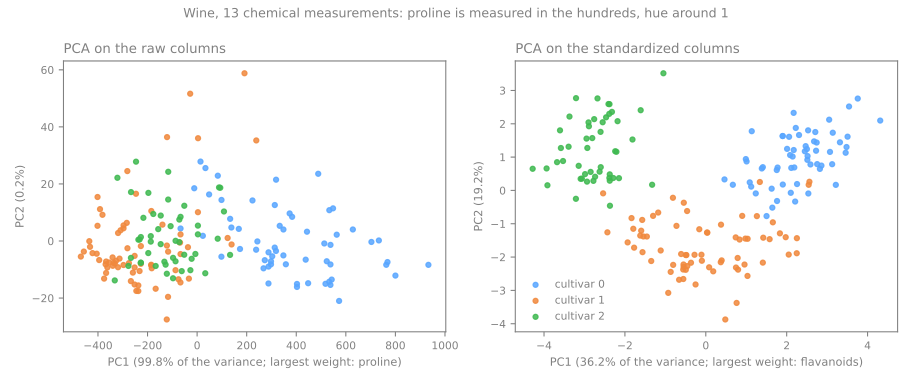
Vinhos: 13 medidas químicas de 178 vinhos. A prolina tem desvio-padrão 314,9; a tonalidade fica em torno de 1.
| razão de variância de PC1, PC2, PC3 | maiores pesos na PC1 | |
|---|---|---|
| colunas brutas | 0,998; 0,002; 0,0 | prolina 1,000 |
| padronizadas | 0,362; 0,192; 0,111 | flavonoides, fenóis totais, OD280 |
99,8% não é uma descoberta sobre vinho: é uma medida da unidade da prolina.
Isso importa mais adiante?
Um classificador k-NN (k vizinhos mais próximos) que só vê as duas coordenadas do PCA, em 30% dos vinhos:
bruto → PCA(2)
padronizado → PCA(2)
Escolhendo \(k\): 64 pixels de dígitos
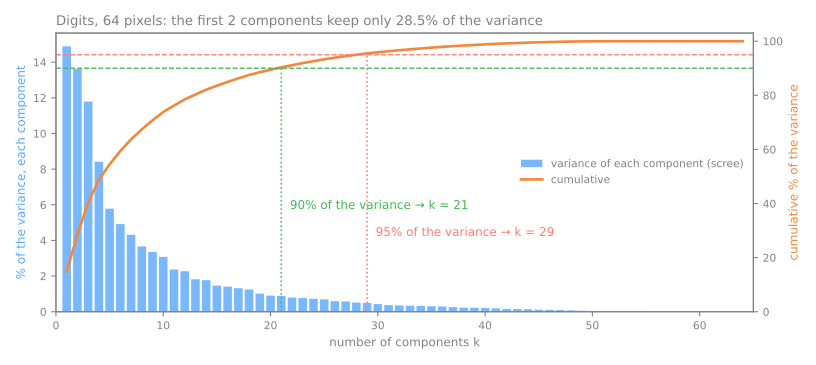
- 2 componentes guardam 28,5%: uma figura 2D de PCA mostra menos de um terço.
- 90% exige 21, 95% exige 29, 99% exige 41.
PCA(n_components=0.95)faz a busca por você.
Critérios, do mais confiável ao menos: um limiar de variância acumulada; o cotovelo (subjetivo); o desempenho a jusante em dados de validação; o critério de Kaiser (frágil).
Reconstrução: o que \(k\) componentes guardam
| \(k\) | guardado | erro / imagem | \(\lambda\) descartados |
|---|---|---|---|
| 1 | 14,9% | 1022,6 | 1022,6 |
| 2 | 28,5% | 858,9 | 858,9 |
| 10 | 73,8% | 314,5 | 314,5 |
| 29 | 95,5% | 54,3 | 54,3 |
| 64 | 100,0% | 0,0 | 0,0 |
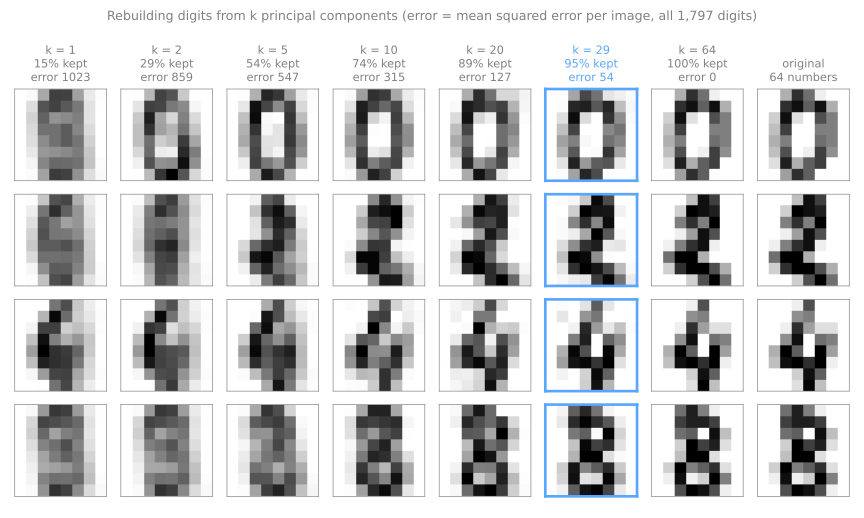
Simulador: reconstrua uma imagem com \(k\) componentes
Preveja. De quão poucos componentes o olho precisa até parar de reclamar?
Cinco armadilhas do PCA
- Não padronizar colunas em unidades diferentes: você mede a unidade.
- Ajustar antes da divisão: as linhas de teste moldam a projeção.
- Supor que os componentes de alta variância são os úteis para prever: o PCA nunca olha o alvo.
- Ler componentes como fatores do mundo real: os sinais são arbitrários; autovalores próximos admitem qualquer rotação.
- PCA em colunas one-hot sem pensar: uma coluna 0/1 tem variância \(p(1-p)\), então categorias raras somem.
Onde o PCA se esgota
O PCA só pode rotacionar e projetar: move os eixos, nunca os dobra.
O rocambole suíço (swiss roll): uma folha 2D enrolada em 3D. Dois pontos em camadas opostas estão perto em linha reta e longe ao longo da folha.
Simulador: o rocambole suíço
Marque marcar par de pontos e depois projete com PCA. A distância euclidiana atravessa o espaço vazio; a geodésica caminha sobre a folha.
Uma nota para um mapa: a trustworthiness
Dos \(k\) vizinhos mais próximos de cada ponto no mapa, quantos eram vizinhos de verdade? 1 = nenhum intruso; um mapa aleatório ≈ 0,5.
PCA no rocambole
Isomap
O t-SNE em três passos
- Vizinhanças nos dados: uma gaussiana em torno de cada ponto, com a largura ajustada ponto a ponto até uma perplexidade ("número efetivo de vizinhos"). Regiões densas e esparsas ganham larguras diferentes.
- Vizinhanças no mapa: uma t de Student, de caudas pesadas, para abrir espaço em 2D. Efeito colateral: as distâncias entre grupos deixam de ser interpretáveis.
- Minimizar a divergência de Kullback–Leibler \(\text{KL}(P\,\|\,Q)\): vizinhos de verdade desenhados longe custam caro; pontos distantes desenhados perto saem quase de graça.
Simulador: t-SNE de verdade, no navegador
Experimente. Rode em ruído uniforme; mude só a perplexidade; compare grupos de tamanhos diferentes.
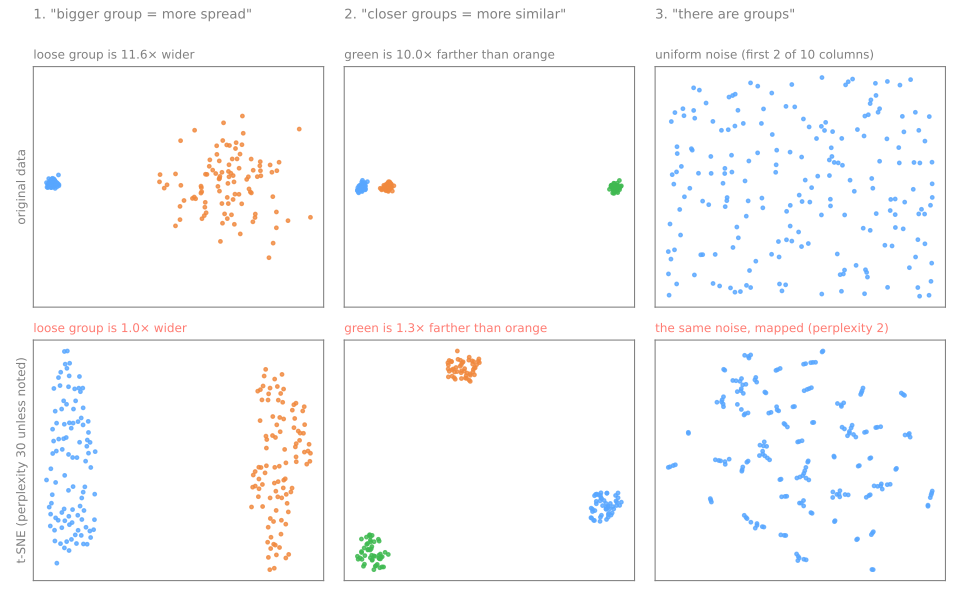
O que um mapa t-SNE não diz, medido
| dados | t-SNE | |
|---|---|---|
| quantas vezes mais largo é o grupo espalhado | 11,6 | 1,0 |
| quantas vezes mais longe está o grupo distante | 10,0 | 1,3 |
A perplexidade muda a figura
| perplexidade | razão de distâncias |
|---|---|
| 2 | 3,3 |
| 5 | 1,1 |
| 30 | 1,3 |
| 100 | 7,0 |
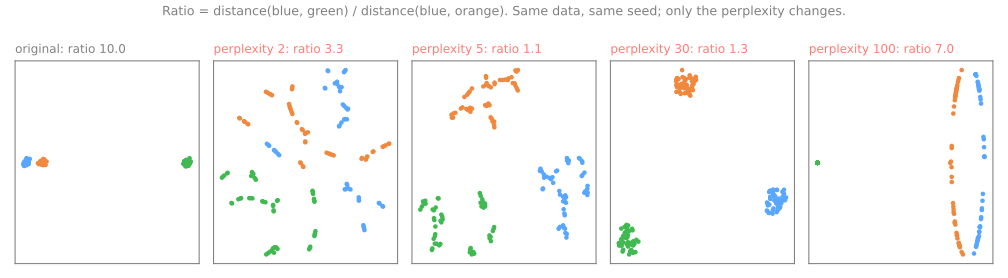
Com 2 e 5 todo grupo se estilhaça em fragmentos que não existem. Não há perplexidade "certa": em geral de 5 a 50, menor que o menor grupo que você quer enxergar.
O t-SNE encontra grupos no ruído
| melhor silhueta | trustworthiness | |
|---|---|---|
| o próprio ruído de 10 colunas | 0,09 | |
| o mapa t-SNE dele, perplexidade 30 | 0,38 | 0,86 |
| ruído de 4 colunas, mapa t-SNE | 0,43 | 0,97 |
- O mapa parece de quatro a cinco vezes mais "agrupado" que os dados.
- Uma boa trustworthiness não certifica a estrutura: o ruído também tem vizinhanças locais.
Eixos e execuções
A perda depende só das distâncias no mapa: girá-lo ou espelhá-lo não muda nada. Dígitos, inicialização aleatória, semente 0 contra as sementes 1, 2 e 3:
|correlação| dos eixos horizontais
1,0; 0,0; 0,1
a semente 2 saiu girada de um quarto de volta
vizinhos em comum
90%, 94%, 85%
no ruído: só 47%
init="pca" (o padrão) torna o mapa reprodutível, o que não é o mesmo que estável.UMAP: um grafo de vizinhos
- Cada ponto é ligado a seus
n_neighborspontos mais próximos, com pesos difusos; nenhum ponto fica isolado. - Os pesos são fundidos num único grafo difuso simétrico.
- Um layout 2D por gradiente descendente estocástico: as arestas atraem, pontos aleatórios sorteados repelem; uma penalidade explícita por aproximar pontos distantes.
n_neighbors (15)
a escala em que a distância euclidiana é confiável: detalhe local contra estrutura global
min_dist (0,1)
quão apertados os pontos ficam: cosmético, não estrutural
transform: ajustado em 80% dos dígitos, 96,4% das imagens novas caem ao lado de uma imagem do mesmo dígito.PCA vs t-SNE, lado a lado
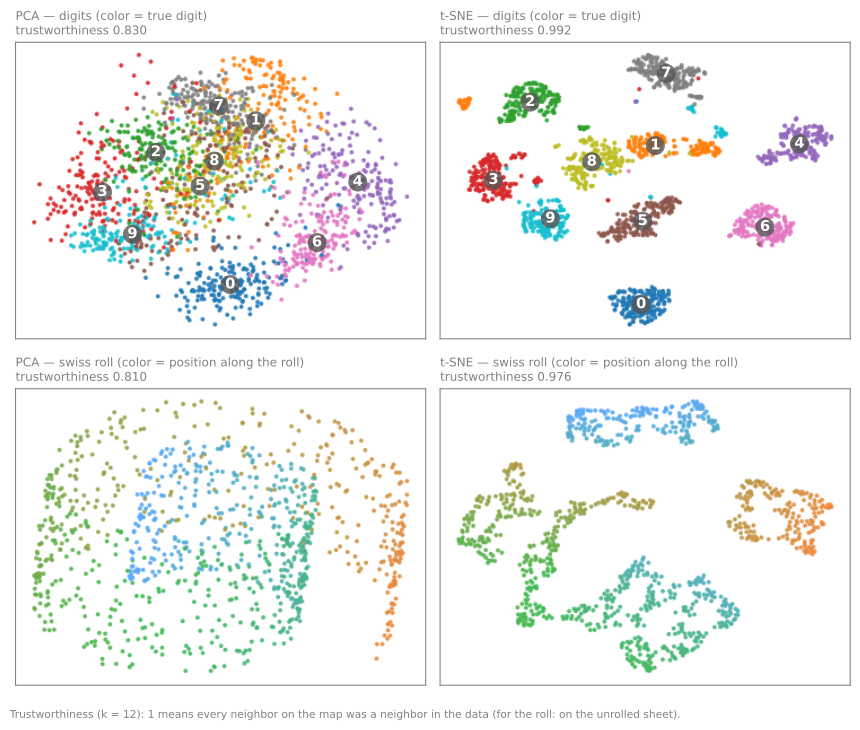
Trustworthiness nos dígitos, para vizinhanças de tamanho \(k\):
| k=5 | k=30 | k=100 | |
|---|---|---|---|
| PCA | 0,830 | 0,830 | 0,835 |
| t-SNE | 0,995 | 0,985 | 0,963 |
| UMAP | 0,989 | 0,983 | 0,961 |
O t-SNE parte os 1 em ilhas e corta o rocambole em pedaços. Não há vencedor até você dizer qual escala lhe interessa.
A tabela comparativa
| PCA | t-SNE | UMAP | |
|---|---|---|---|
| natureza | linear, determinístico | não linear, estocástico | não linear, estocástico |
| estrutura local | fraco | muito bom | muito bom |
| estrutura global | ótimo (variância) | fraco | moderado |
| distâncias / tamanhos dos grupos | sim / sim | não / não | parcialmente / não |
transform em dados novos | sim, trivial | não | sim |
| hiperparâmetros críticos | \(k\), padronização | perplexidade, iterações | n_neighbors, min_dist |
| pré-processamento de um modelo | recomendado | desaconselhado | com cautela, dentro do pipeline |
Sete afirmações proibidas sobre um gráfico t-SNE/UMAP
- "Este grupo é maior, logo varia mais." (11,6× nos dados, 1,0× no mapa)
- "Estes dois grupos estão próximos, logo são parecidos." (10× nos dados, 1,3× no mapa)
- "Há 5 grupos nos dados." Há 5 manchas no gráfico.
- "O eixo horizontal representa X." Rotação e reflexão são arbitrárias.
- "Rodei uma vez e vi isso." Varie a semente, a perplexidade, a amostra.
- "Usei os 2 componentes do t-SNE como atributos." Não há
transformhonesto. - "Rodei o t-SNE no conjunto todo e depois dividi." Vazamento.
Escolhendo um método
- Vai alimentar outro modelo ou você precisa de reversibilidade → PCA. Ponto final.
- Você quer olhar os dados para gerar hipóteses, com até alguns milhares de pontos → t-SNE ou UMAP, com PCA antes se \(d\) for grande.
- \(n\) é grande ou você precisa projetar dados novos no mesmo mapa → UMAP.
- Você precisa de estrutura global confiável numa figura → nenhum é ideal: mostre o PCA e o t-SNE/UMAP.
Resumo
- As distâncias se concentram quando as colunas não carregam informação; pergunte quantas direções variam.
- PCA = autovetores da covariância; \(\lambda\) é a variância guardada; o erro é a variância jogada fora.
- Padronize colunas em unidades diferentes; ajuste o PCA dentro do pipeline.
- O t-SNE e o UMAP guardam as vizinhanças locais; tamanhos, distâncias e eixos nos mapas deles não significam nada.
- Só o UMAP e o PCA posicionam pontos novos.
Mapeando CEPs manuscritos
- USPS (serviço postal dos EUA): 9.298 dígitos manuscritos de envelopes, 16×16 = 256 colunas.
- Baixe o notebook do lab e abra no Jupyter ou no Colab; no Colab, rode antes
!pip install umap-learn.
1. carregar uma amostra
2. quantas dimensões o USPS realmente tem?
3. compressão e erro de reconstrução
4. três mapas das mesmas imagens
5. dar nota aos mapas com a trustworthiness
6. perplexidade
7. UMAP: n_neighbors, min_dist, imagens novas
8. testar uma afirmação proibida