O caminho desta parte
- Achar a redundânciaatributos que dizem a mesma coisa; colunas vazadas
- Condicionar numa terceira variávelcorrelação não é causalidade; paradoxo de Simpson
- Julgar os valores estranhosregras que discordam; erro ou raro mas real
- Encarar o tetovalores truncados, alvos censurados
Atributos redundantes
- As quatro contagens (cômodos, quartos, população, domicílios) se correlacionam entre 0,86 e 0,98: todas medem o tamanho do distrito.
- Iris: comprimento e largura da pétala, \(r = 0{,}963\).
- Não é um erro, mas vale registrar: modelos lineares ficam com coeficientes instáveis; a redução de dimensionalidade explora isso; para as contagens, divida pelo tamanho.
Correlação não é causalidade
- Renda e valor do imóvel: \(r = 0{,}69\). Aumentar a renda de um distrito não aumenta os preços nem o contrário.
- As duas respondem a uma terceira coisa: a demanda por morar ali (empregos, litoral, escolas).
- Vendas de sorvete e afogamentos se correlacionam por causa do verão.
O paradoxo de Simpson: cálculos renais
| taxa de sucesso | tratamento A | tratamento B |
|---|---|---|
| cálculos pequenos | 0,931 | 0,867 |
| cálculos grandes | 0,730 | 0,688 |
No total: A 0,780, B 0,826. A perde: \(273/350\) para A.
A foi dado sobretudo a cálculos grandes (263 de 350), mais difíceis de tratar. O tamanho do cálculo é um confundidor: influencia a escolha do tratamento e o sucesso.
A mesma armadilha nos dados de imóveis
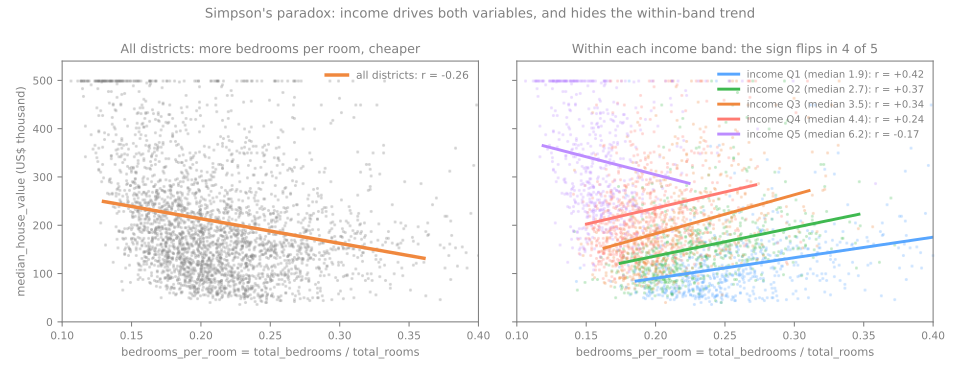
Fração dos cômodos que são quartos vs valor:
no total \(r = -0{,}256\); dentro das faixas de renda Q1–Q4, +0,24 a +0,42.
A renda move as duas (\(r = -0{,}616\) com a fração de quartos).
Em dados reais as regras discordam
population, IQR
population, \(|z| > 3\)
log(population), IQR
Uma cauda longa à direita põe muitos distritos grandes e comuns além das cercas de 1,5 IQR (amplitude interquartil: \(Q_3 - Q_1\)).
Erro ou raro-mas-real?
age = 190numa tabela de clientes: erro de digitação → corrija ou marque como faltante.- O salário de 26 do dono: real → mantenha; prefira estatísticas robustas (mediana, quantis, log).
- No meio: valores corretos que significam outra coisa.
Valores truncados (censurados)
valor em 500.001
idade em 52
renda em 15,0001
Top-coding: 500.001 quer dizer "pelo menos 500.000"; o valor verdadeiro se perdeu. Os distritos no teto não são aleatórios: renda média 7,83 contra 3,87 no total.
Como achar um teto e o que ele faz
histograma
um pico na borda, mais alto que os vizinhos (com bins suficientes)
gráfico de dispersão
uma linha horizontal: 965 distritos em 500.001
o máximo
compartilhado exatamente por muitas linhas: 1.273 distritos com idade 52
- Um modelo treinado nesses valores aprende que nenhum distrito vale mais que cerca de 500.000.
- As relações achatam no topo: renda contra valor parece se nivelar depois de uma renda de cerca de 8, em parte por causa do teto.
Resumo
| sintoma | o que está acontecendo | o que fazer |
|---|---|---|
| dois atributos com \(|r|\) acima de 0,9 | medem a mesma coisa | fique com um ou faça uma razão |
| um atributo quase perfeito em prever o alvo | talvez o alvo disfarçado | descubra como foi produzido |
| uma correlação que troca de sinal nos grupos | uma terceira variável move as duas | reporte dentro dos grupos |
| a regra do IQR sinaliza milhares de linhas | uma cauda longa, não erros | olhe as linhas; tente um log ou uma razão |
| muitas linhas compartilham exatamente o máximo | a coluna tem teto | documente; declare a faixa que o modelo cobre |
Do mapa à ficha dos dados, passos 8 a 11
- Mesmo notebook, mesma sessão: continue do passo 8.
- O mapa (latitude contra valor, faixa por faixa) → contagens e razões → outliers e distritos estranhos → a ficha dos dados escrita: fatos, problemas a corrigir, hipóteses a testar.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: dê uma direção à localização (passo 8) e limpe todas as colunas com a regra do IQR (passo 10).
Ritmo: passo 8 e a primeira simulação em 10 min; passo 9 em 5 min; passo 10 e a segunda simulação em 10 min; passo 11 em 5 min.