Por que olhar primeiro?
- Análise Exploratória de Dados (EDA, do inglês Exploratory Data Analysis): gráficos, resumos e anomalias antes de qualquer modelo.
- É o passo 2 do fluxo de trabalho de machine learning (ML). Pulá-la é a fonte mais comum de falha silenciosa: dados mal compreendidos dão absurdos com confiança.
- O objetivo: sair com uma lista curta de fatos, de problemas a corrigir e de perguntas a testar.
O caminho desta parte
- Conhecer os dadostamanho, o que é uma linha, tipos das colunas, describe()
- Resumir à mãocentro, dispersão e forma de uma coluna
- Olhar a formaAnscombe, histogramas, densidade, escala log
- Duas variáveisdispersão, Pearson e Spearman, grupos
- Problemas a corrigirfaltantes, outliers; dividir antes de explorar
O exemplo da aula: California Housing
- 20.640 linhas do censo americano de 1990, 10 colunas: 9 numéricas e 1 de texto (
ocean_proximity). - O alvo:
median_house_value. ocean_proximitytem 5 níveis;ISLANDtem só 5 linhas,<1H OCEANtem 9.136.
total_rooms = 39.320. O que é uma linha desta tabela: uma casa?Uma linha não é uma casa
É um block group do censo (um "distrito"), tipicamente com 600 a 3.000 habitantes. Toda coluna descreve o distrito como um todo.
| coluna | significado | nota |
|---|---|---|
total_rooms, population, … | somados no distrito | medem o seu tamanho |
housing_median_age | idade mediana das casas | teto em 52 |
median_income | dezenas de milhares de US$ (3,87 = US$ 38.700) | teto em 15,0001 |
median_house_value | o alvo, em US$ de 1990 | teto em 500.001 |
describe(): três pistas
count
em total_bedrooms, 20.640 nas demais: 207 faltando
média vs mediana
cômodos: a média bem acima da mediana, uma cauda longa à direita
mín. e máx.
máximos suspeitamente redondos: tetos
O resto da aula explica como ler cada pista direito.
Primeiro à mão: os salários de um escritório pequeno
Nove pessoas, em R$ mil por mês: oito funcionários e o dono.
O centro: média e mediana
média
\(\frac{2+2+3+3+3+4+5+6+26}{9} = \frac{54}{9}\)
mediana
o 5º dos 9 valores ordenados
- Uma pessoa levou a média de 3,5 para 6; sete das nove ganham menos que 6.
- A média é puxada por uma cauda longa; a mediana só conta posições.
total_rooms: 2.635,8 contra 2.127,0.A dispersão: desvio padrão, à mão
| \(x_i\) | 2 | 2 | 3 | 3 | 3 | 4 | 5 | 6 | 26 | soma |
|---|---|---|---|---|---|---|---|---|---|---|
| \(x_i - \bar x\) | −4 | −4 | −3 | −3 | −3 | −2 | −1 | 0 | 20 | 0 |
| \((x_i - \bar x)^2\) | 16 | 16 | 9 | 9 | 9 | 4 | 1 | 0 | 400 | 464 |
Quantis e IQR: uma dispersão robusta
Ordenados: 2 2 3 3 3 4 5 6 26 — o pandas usa a posição \(p\,(n-1)\), contando a partir de 0.
\(Q_1\) (posição 2)
mediana (posição 4)
\(Q_3\) (posição 6)
A forma: assimetria
\[ \text{assimetria} = \frac{1}{n}\sum_{i=1}^{n}\left(\frac{x_i - \bar{x}}{\sigma}\right)^3 \]- O cubo mantém o sinal: valores muito acima da média a puxam para cima. Simétrica → 0.
- Salários: 2,34 pela fórmula; o pandas imprime 2,83 (multiplica por uma correção de amostra pequena, 1,21 para \(n = 9\)).
\(|\text{assim.}| < 0{,}5\)
mais ou menos simétrica
de 0,5 a 1
moderada
acima de 1
forte
Por que estatísticas não bastam
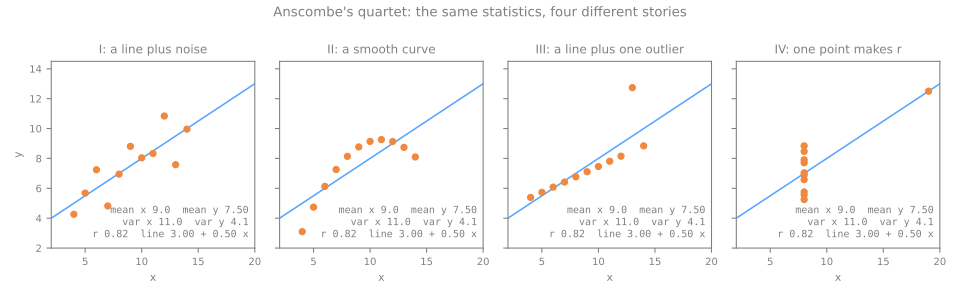
O quarteto de Anscombe, lido
II
uma curva suave: uma reta é o resumo errado
III
uma reta perfeita, exceto por um outlier, que inclina o ajuste
IV
um ponto cria a correlação inteira; sem ele, \(x\) nem varia
Histogramas: a largura do bin muda a história
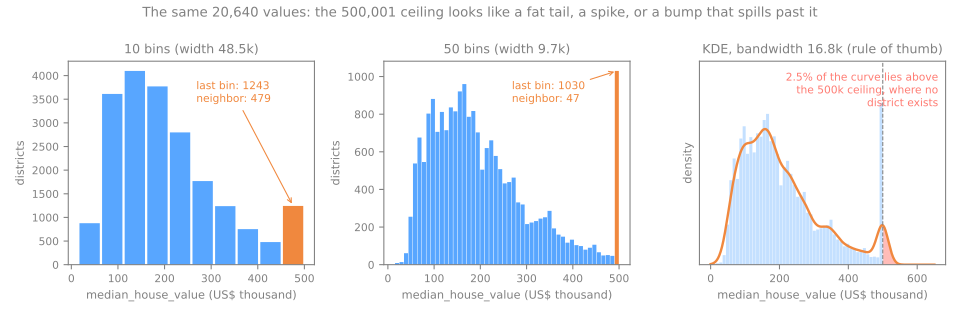
O que os 50 bins revelaram
10 bins
a última barra, 1.243 distritos, é um calombo modesto: 30% da mais alta. Uma cauda um pouco gorda?
50 bins
a última barra, 1.030, é a mais alta de todas, 22 vezes a vizinha (47)
O valor mais frequente da coluna é exatamente 500.001, em 965 distritos: o teto.
- Tente mais de um número de bins (30–50 para alguns milhares de linhas);
bins='fd'(Freedman–Diaconis) escolhe 46 aqui. - Uma estimativa de densidade por kernel (KDE) é suave, mas transforma o pico num calombo e põe 2,5% da área acima de 500.001, onde não existe distrito.
Contagens assimétricas e a escala log
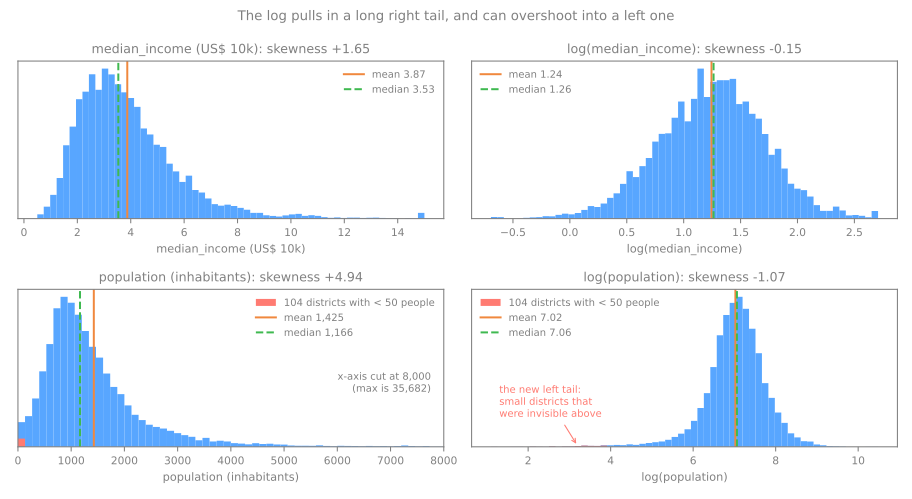
median_income: assimetria 1,65 → −0,15. Funciona como prometido.
population: 4,94 → −1,07. Passa do ponto: os 104 distritos com menos de 50 pessoas viram uma nova cauda à esquerda (o menor tem 3).
20.640 pontos: sobreposição
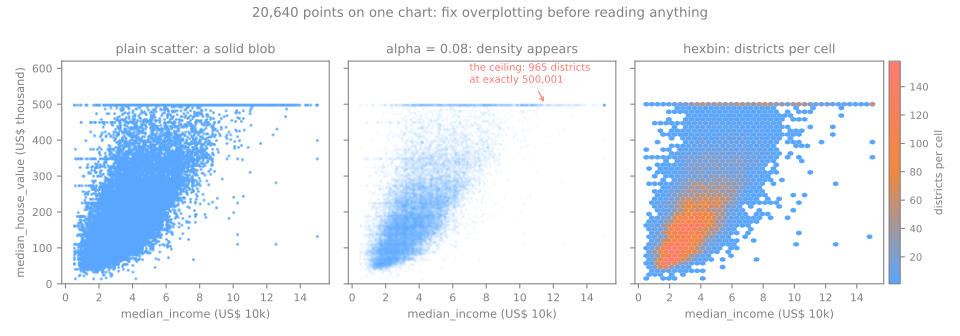
- Transparência (
alpha=0.08) revela o núcleo, a linha do teto com 965 distritos e linhas em valores redondos (137.500 aparece 122 vezes). - Hexbin conta pontos por célula. O valor sobe com a renda e a dispersão também cresce com ela.
Pearson e Spearman, passo a passo
Cinco pontos, \(x\) = 1 a 5 e \(y\) = 1, 2, 3, 4, 20. Preveja. \(y\) sempre sobe com \(x\): a correlação é 1? Qual ponto vai pesar mais nas somas?
Nos dados de imóveis, contra o alvo
| atributo | Pearson | Spearman |
|---|---|---|
| median_income | 0,688 | 0,677 |
| total_rooms | 0,134 | 0,206 |
| housing_median_age | 0,106 | 0,075 |
| population | −0,025 | 0,004 |
| latitude | −0,144 | −0,166 |
- a renda domina, quase linearmente (ambos ≈ 0,68);
- cômodos: Spearman acima de Pearson, uma relação monótona distorcida pela cauda;
- a latitude parece fraca, mas o valor mediano oscila de 84.500 a 236.500 entre faixas, sobe e desce duas vezes: não é monótona.
Simulador: Pearson lê a reta, Spearman a ordem
Preveja. Carregue com um outlier e arraste o ponto vermelho ainda mais para cima. Qual coeficiente continua se mexendo e qual para?
Categórica vs numérica: agrupe, com o \(n\)
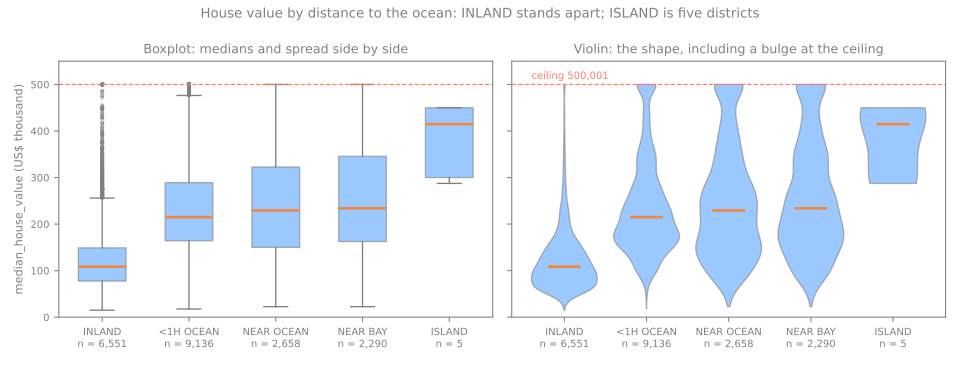
- INLAND se destaca: mediana 108.500 contra 214.850–233.800 no litoral.
- Os violinos incham no teto de 500.001 nos grupos do litoral.
- ISLAND tem 5 distritos: a maior mediana (414.700) e a menos confiável.
- INLAND também tem rendas menores (2,99 vs 3,65–3,88): parte da diferença é renda.
Valores faltantes: o porquê importa
total_bedrooms: 207 faltando (1,00%). A pergunta importante é por quê (Rubin, 1976).
| mecanismo | a chance de faltar depende de… | exemplo |
|---|---|---|
| MCAR | nada: faltando completamente ao acaso (missing completely at random) | um sensor perde pacotes ao acaso |
| MAR | outras colunas observadas (missing at random) | usuários mais jovens pulam o campo de renda |
| MNAR | o próprio valor que falta (missing not at random) | rendas altas não são declaradas de propósito |
Os três mecanismos em ação
10.000 pessoas simuladas, a renda cresce com a idade; esconda ~30% das rendas e preencha cada uma pela média da sua faixa de idade. Média verdadeira: 6,89.
| média do que vemos | depois de preencher pela idade | |
|---|---|---|
| MCAR | 6,82 | 6,85 |
| MAR: os jovens escondem mais | 7,48 | 6,88 |
| MNAR: os ricos escondem mais | 5,91 | 6,11 |
O que fazer na EDA
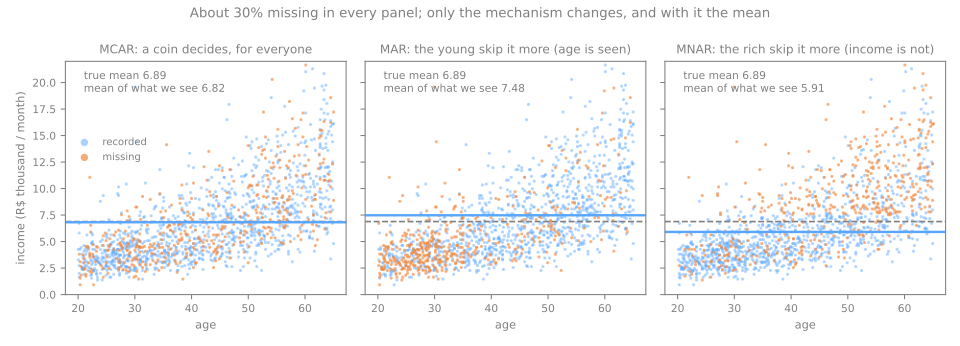
- Apagar linhas só é inofensivo sob MCAR. Dá para juntar evidência contra MCAR: compare as linhas com e sem o valor nas outras colunas.
- MNAR é indetectável só pelos dados. Guarde uma coluna-indicador para que um modelo possa usar o fato de que o valor faltava.
Outliers: duas regras, passo a passo
De volta aos nove salários. Preveja. A regra do IQR (interquartile range, amplitude interquartil) ou "\(|z| > 3\)" (\(z\) = distância até a média em desvios padrão): qual sinaliza o 26 do dono?
Não bisbilhote: divida antes de explorar
from sklearn.model_selection import train_test_split
train, test = train_test_split(df, test_size=0.2, random_state=42)
# daqui em diante, explore só `train`; `test` espera até o fim
- Fatos sobre como o arquivo foi produzido (unidades, tetos) são inofensivos de saber.
- Tudo o que é estimado e alimenta uma decisão (um valor de imputação, um limiar de outlier, quais atributos se correlacionam melhor) vem só da parte de treino.
Resumo
- Saiba o que é uma linha antes de qualquer coisa.
- Média e \(s\) seguem a cauda; mediana e IQR resistem a ela.
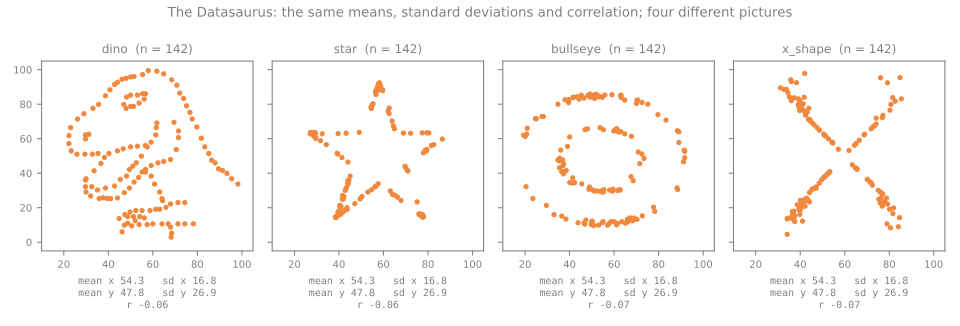
- Sempre faça o gráfico: estatísticas iguais podem esconder dados diferentes; tente vários números de bins.
- Pearson e Spearman juntos: \(r \approx 0\) não é "nenhuma relação"; reporte estatísticas de grupo com o seu \(n\).
- Pergunte por que faltam valores; regras de outlier só sinalizam candidatos.
- Divida antes de explorar: o teste é sagrado.
Uma primeira EDA do California Housing, passos 1 a 7
- Divida primeiro e explore só a parte de treino. Não há modelos.
- Carregar → dividir → auditoria (faltantes, duplicatas, linhas impossíveis) → estatísticas → distribuições e tetos → a coluna categórica → correlações com o alvo.
- Baixe o notebook do lab e abra no Jupyter ou no Colab; roda em poucos segundos.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: a checagem pegaria um mecanismo MAR? (passo 3) e um erro de digitação contra os dois coeficientes (passo 7).
Ritmo: passos 1 e 2 em 5 min; passo 3 e a primeira simulação em 10 min; passos 4 a 6 em 10 min; passo 7 e a segunda simulação em 10 min.