Três ferramentas, uma hipótese escondida
importância por permutação
embaralhe uma coluna, mantenha as outras
dependência parcial (PDP)
fixe um atributo em \(v\) em todas as linhas, mantenha os outros
SHAP (SHapley Additive exPlanations)
preencha os atributos que faltam com um fundo, um por um
As três mudam um atributo e seguram os outros, exista ou não essa combinação.
O caminho desta parte
- Atributos correlacionadoscrédito dividido e linhas impossíveis
- Fora do mapaum PDP feito de lugares que não existem
- Outra resposta localo LIME e a largura do "local"
- Estimativas, não certificadostrês rankings, escolhas dentro, um checklist
Atributos correlacionados (1): crédito dividido
Some uma cópia exata da renda e reajuste a random forest. Preveja. A importância por permutação de cada cópia cai para 0,196. Quanto dá embaralhar as duas juntas?
| MDI | perm. no teste | |
|---|---|---|
| renda sozinha | 0,516 | 0,754 |
| renda | 0,262 | 0,196 |
| cópia da renda | 0,259 | 0,196 |
| as duas embaralhadas juntas | 0,748 |
MDI (do inglês mean decrease in impurity): a importância que as árvores calculam nas divisões do treino.
Embaralhe uma cópia e as árvores que dividem pela outra continuam funcionando.
Juntas, as duas cópias valem 0,392, metade do que a informação vale.
Atributos correlacionados (2): linhas impossíveis
- Latitude e longitude: correlação −0,92, porque a Califórnia é uma faixa diagonal.
- Embaralhe só a latitude: uma longitude de San Francisco recebe uma latitude de San Diego, um ponto no Pacífico.
O modelo nunca viu lugares assim. Parte do 1,330 mede a latitude; parte mede quão mal o modelo se comporta fora do mapa.
A armadilha da extrapolação
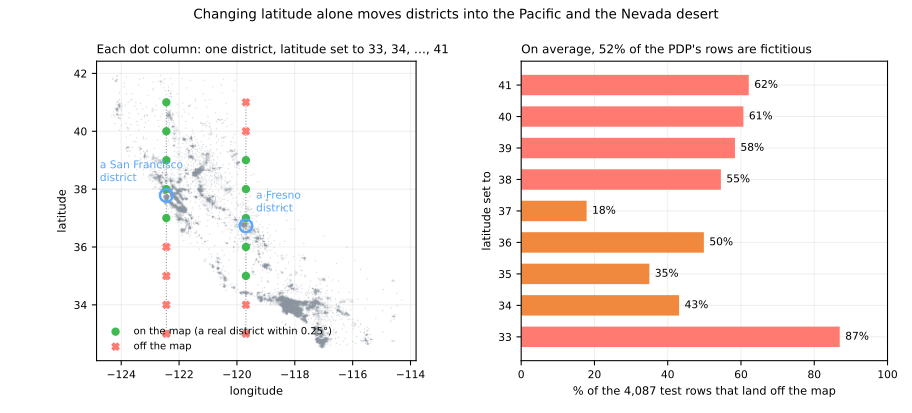
| latitude fixada em | 33° | 35° | 37° | 39° | 41° |
|---|---|---|---|---|---|
| linhas fora do mapa | 87% | 35% | 18% | 58% | 62% |
LIME: um modelo linear em volta de uma linha
- perturbar: milhares de pontos em volta da linha
- prever: perguntar à caixa-preta sobre cada um
- ponderar: quanto mais perto, mais peso (kernel de largura \(w\))
- ajustar um modelo linear ponderado
| San Francisco | à mão | lime |
|---|---|---|
| renda | 42,1 | 42,0 |
| ocupação | −49,9 | −48,9 |
| latitude | −89,3 | −91,8 |
| longitude | −53,6 | −55,5 |
LIME: Local Interpretable Model-agnostic Explanations (Ribeiro, Singh & Guestrin, 2016). Os coeficientes são inclinações, em US$ 1.000 por desvio padrão.
SHAP ou LIME? Respondem a perguntas diferentes
SHAP
quanto a renda real deste distrito afasta sua previsão da média? A renda é comum: afasta pouco.
"por que esta casa é cara?"
LIME
o que aconteceria se a renda mudasse? A inclinação local, que é íngreme.
"o que mudaria o preço?"
O KernelSHAP é o LIME rodado sobre coalizões, com um kernel específico e sem regularização: essa escolha faz a regressão devolver valores de Shapley.
Quão local é "local"?
| largura | 0,5 | 1,0 | 2,12 | 5,0 | dp, 5 sementes |
|---|---|---|---|---|---|
| renda | 54,7 | 54,8 | 42,1 | 38,2 | 1,5 |
| house_age | −9,9 | 1,3 | 1,3 | 1,0 | 1,3 |
| ocupação | −71,0 | −67,4 | −49,9 | −45,0 | 0,9 |
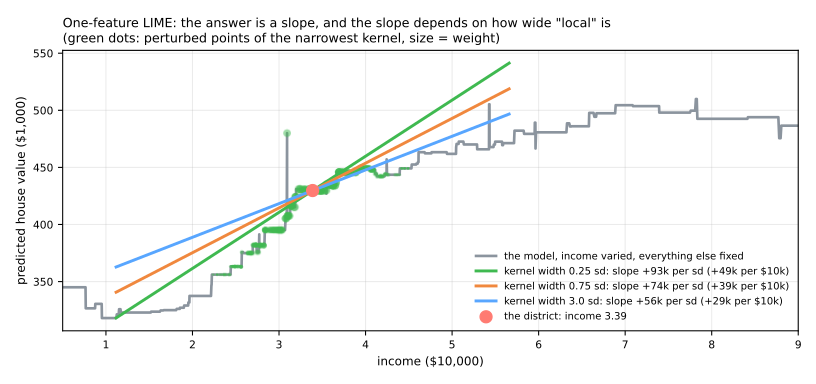
house_age chega a trocar de sinal. O padrão \(0{,}75\sqrt{d} = 2{,}12\), com \(d = 8\) atributos, é uma convenção, não uma lei.Três rankings, três perguntas
MDI
renda em primeiro (0,567)
o que o treino usou?
permutação
latitude em primeiro, uma queda maior que 1, inflada por linhas impossíveis
de que o escore precisa?
média de |SHAP|
latitude em primeiro, 76,6 contra 44,2 da renda, em US$ 1.000
quanto cada atributo move as previsões?
Explicações são estimativas, com escolhas dentro
escolhas medidas nesta aula
- o fundo define o valor base do SHAP
- a largura do kernel muda as inclinações do LIME
- atributos correlacionados dividem o crédito de forma arbitrária
- permutação e PDP consultam linhas impossíveis
dá até para manipulá-las
Slack et al. (2020) construíram modelos que discriminam nas entradas reais enquanto mostram explicações inocentes ao LIME e ao SHAP, que os sondam com pontos fora da distribuição.
Um checklist para explicar um modelo
- Tente primeiro um modelo interpretável; se ele for tão bom quanto nos mesmos folds, use-o.
- Calcule importâncias em dados separados.
- Procure grupos correlacionados e embaralhe ou explique esses grupos juntos.
- Olhe as curvas ICE, não só o PDP; confira se os valores do gráfico estão dentro dos dados.
- Use SHAP para explicações locais; informe o fundo que você usou.
- Quando um atributo domina, pergunte quando esse valor é registrado? (vazamento).
- Nunca leia uma explicação como uma afirmação causal.
Um atributo protegido e um vazamento plantado, passos 8 e 9
- Mesmo notebook, mesma sessão: continue do passo 8 (se a sessão caiu, rode antes os passos 1 a 7).
- Passo 8: a floresta precisa de
personal_status? Retreine sem ele e compare a AUC (área sob a curva ROC, do inglês receiver operating characteristic); depois, veja quantos solicitantes ele move. - Passo 9: plante um vazamento (cartas de cobrança, enviadas depois que um empréstimo dá errado) e veja se a validação cruzada ou as explicações o pegam.
- Simulações: quem o
personal_statusempurra para cima? (passo 8) e um vazamento mais sutil (passo 9). - Notebook do lab, para o Jupyter ou o Colab.
Ritmo: passo 8 e a simulação dele em 12 min; passo 9 e a simulação dele em 13 min.