Uma boa previsão que ninguém consegue ler
- Random forests, gradient boosting e redes neurais venceram as últimas aulas.
- Um ensemble de 200 árvores com boosting faz uma boa previsão, mas "por que este número?" não tem resposta que caiba numa página.
global
em quais atributos o modelo se apoia, no geral?
local
por que ele fez esta previsão para esta linha?
Por que explicar um modelo?
depuração
desconfie de um modelo bom demais: uma coluna vazada aparece no topo de qualquer ranking de importância
confiança
um médico, um analista de crédito ou um juiz não vai agir com base num número que não pode questionar
regulação
Lei Geral de Proteção de Dados (LGPD, Lei 13.709/2018, art. 20): direito de pedir a revisão de decisões automatizadas, com "informações claras e adequadas" sobre os critérios; o regulamento europeu de proteção de dados (GDPR, do inglês General Data Protection Regulation, art. 22) vai na mesma direção
ciência
às vezes o modelo é uma ferramenta para aprender sobre o mundo; aí a explicação é o resultado
A caixa de ferramentas desta parte
| método | pergunta que responde | escopo |
|---|---|---|
| coeficientes, regras de árvore | o próprio modelo | global |
| importância por impureza (MDI, do inglês mean decrease in impurity) | quais atributos as divisões do treino mais usaram? | global, árvores |
| importância por permutação | quanto o escore depende de cada atributo? | global |
| dependência parcial (PDP, do inglês partial dependence plot) | como a previsão média muda com um atributo? | global |
| curvas ICE (expectativa condicional individual, do inglês individual conditional expectation) | ... e para cada linha? | local, muitas linhas |
| valores SHAP (SHapley Additive exPlanations) | quanto cada atributo afastou esta previsão da média? | local → global |
Métodos específicos leem o interior do modelo; os agnósticos só chamam predict. O LIME, um segundo método local, fica na abordagem avançada.
O caminho desta parte
- Legível primeirocoeficientes, regras de árvore, o preço da legibilidade
- O que importaimportância por permutação, em dados separados
- Com que formadependência parcial e curvas ICE
- Por que esta previsãovalores de Shapley, cascatas e beeswarms do SHAP
- Ler com cuidadonão é causalidade; certo pelos motivos errados
Antes: você precisa de uma caixa-preta?
Três candidatos nos mesmos cinco folds, do totalmente legível ao nada legível.
A legibilidade tem um preço, aqui
regressão linear
árvore, profundidade 3
gradient boosting
O que os modelos legíveis dizem
oito coeficientes
US$ 10.000 a mais de renda → +US$ 44.140 (com os outros fixos); um grau mais ao norte → −US$ 41.300.
rooms −11,65 e bedrooms +63,55 têm sinais opostos: são correlacionados (0,85), então "um quarto a mais com o número de cômodos fixo" significa converter um cômodo em quarto.
oito regras
Qualquer pessoa segue um distrito árvore abaixo:
renda acima de US$ 78.000 → US$ 457.900.
model é a caixa-preta: 200 árvores com até 16 folhas cada. O resto da aula a abre.Importância por permutação: embaralhe uma coluna
- Tome dados separados e o escore do modelo neles.
- Embaralhe uma coluna: os valores ficam, o vínculo com o alvo e com o resto de cada linha se quebra.
- Meça a queda do escore. Repita para cada coluna (Breiman, 2001).
for col in X_test.columns:
    X_perm = X_test.copy()
    X_perm[col] = rng.permutation(X_perm[col].to_numpy())
    drops[col] = base - r2_score(y_test, model.predict(X_perm))
Importância por permutação, à mão
4.087 distritos separados, R² = 0,825 sem nada embaralhado; cada coluna embaralhada 5 vezes. Preveja. Embaralhar uma coluna pode custar mais que 0,825?
Dois rankings do mesmo modelo
| permutação | MDI | |
|---|---|---|
| latitude | 1,346 | 0,103 |
| longitude | 1,187 | 0,117 |
| renda | 0,532 | 0,567 |
| ocupação | 0,134 | 0,130 |
| cômodos | 0,056 | 0,024 |
| população | 0,003 | 0,009 |
O permutation_importance roda o mesmo laço: os números à mão (latitude 1,330, renda 0,539, população 0,002) concordam até cerca de duas casas.
Embaralhar a latitude "custa" 1,330: o R² vai de 0,825 para cerca de −0,5, bem pior do que prever a média para todo mundo.
Por que a queda pode passar de 0,825 fica na abordagem avançada: linhas impossíveis.
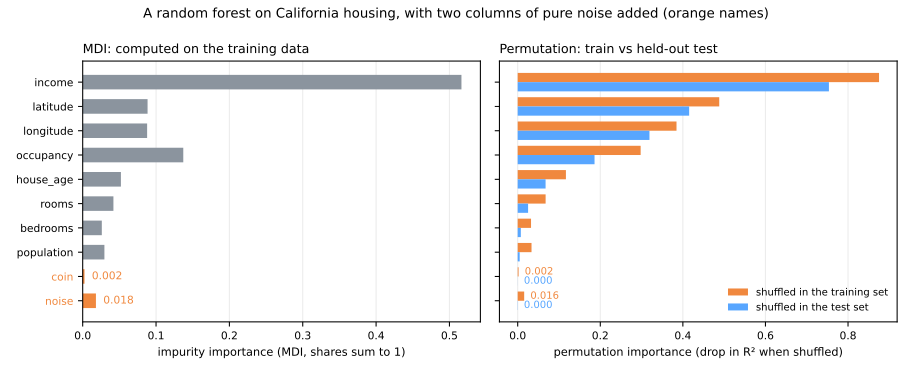
Dados separados, não dados de treino
Uma floresta com duas colunas de ruído: uma contínua e um cara ou coroa.
Dependência parcial: em que direção, com que forma?
Fixe o atributo \(j\) num valor \(v\) em todas as linhas, mantenha o resto e tire a média das previsões (Friedman, 2001):
\[ \mathrm{PD}_j(v) = \frac{1}{n}\sum_{i=1}^{n} \hat f\bigl(x_{i,1}, \dots,\, v,\, \dots, x_{i,d}\bigr) \]\(n\): número de linhas (4.087 distritos de teste); \(x_{i,k}\): atributo \(k\) da linha \(i\), sem mudança, exceto o atributo \(j\), trocado por \(v\); \(\hat f\): a previsão do modelo.
by_hand = [model.predict(X_test.assign(income=v)).mean() for v in grid]
O PDP da renda, à mão
Grade: renda de 1,5 a 10 (US$ 10.000). A cada passo, todas as 4.087 linhas recebem essa renda. Preveja. O valor previsto cresce com a renda de forma constante ou satura?
ICE: uma curva por linha
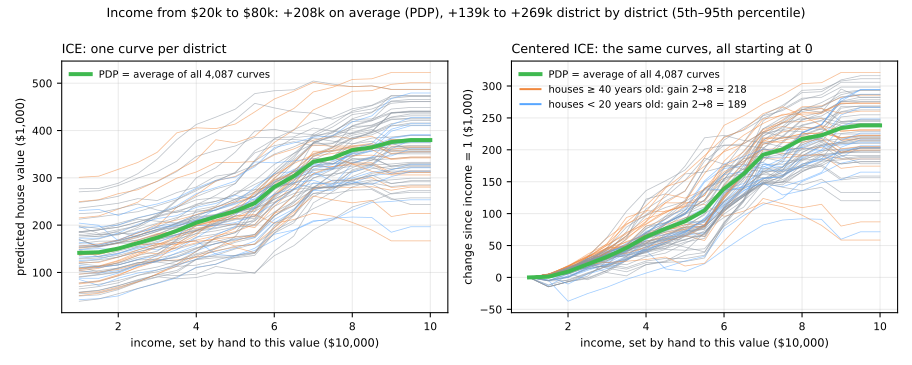
Renda de US$ 20.000 para US$ 80.000: +US$ 208.000 em média (o PDP), mas de +US$ 139.000 a +US$ 269.000 distrito a distrito (percentis 5 a 95).
SHAP: por que esta previsão, para mim?
Divida uma previsão em contribuições, uma por atributo, que somam exatamente:
\[ \hat f(x) = \underbrace{\phi_0}_{\text{valor base}} + \phi_1 + \phi_2 + \dots + \phi_d \]- \(\phi_0\): a previsão média sobre um conjunto de fundo; \(\phi_j\): a parte do atributo \(j\) na distância \(\hat f(x) - \phi_0\).
- Os atributos são jogadores; a previsão é o prêmio do time (Shapley, 1953; Lundberg & Lee, 2017).
- Valor de uma coalizão \(S\), escrito \(v(S)\): fixe os atributos de \(S\) nos valores da linha, tire os outros do fundo e faça a média.
- \(\phi_j\): a média de \(v(S \cup \{j\}) - v(S)\) sobre as coalizões em que \(j\) pode entrar, com toda ordem de chegada igualmente provável.
Um modelo de brinquedo, do tamanho de uma calculadora
\[ f = 100 + 80\,\text{rich} + 60\,\text{coastal} + 40\,\text{rich}\cdot\text{coastal} + 20\,\text{big} \quad (\mathrm{US}\$\ 1{.}000) \]- Fundo: quatro distritos, que valem 120, 180, 160 e 100. Então \(v(\varnothing) = 140\).
- Explicamos um distrito rico, litorâneo e não grande: \(f(x) = 280\).
Siga as setas em que "rich" entra
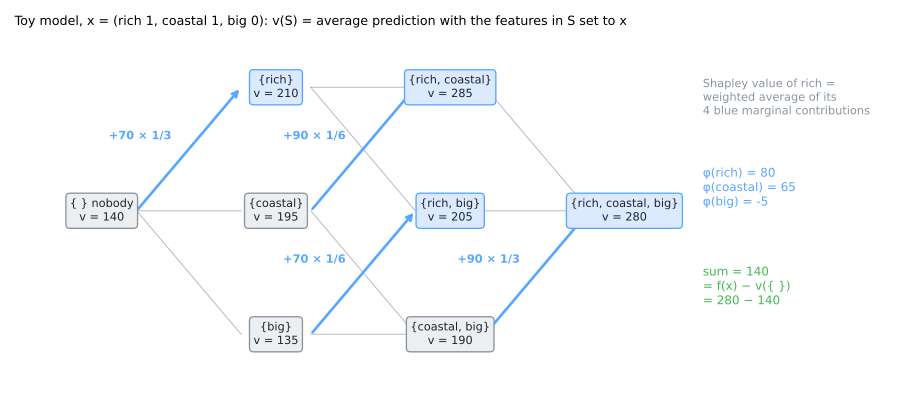
\(v(\{\text{rich}\})\): fixe rich = 1 nos quatro distritos: 200, 180, 280, 180, média 210.
\[ \phi_{\text{rich}} = \tfrac13(210-140) + \tfrac16(285-195) + \tfrac16(205-135) + \tfrac13(280-190) = 80 \]Todo número faz sentido
rich: 80
efeito principal 80 × (1 − ¼) = 60, mais metade da interação, 20
coastal: 65
45 + 20: a interação é dividida igualmente
big: −5
20 × (0 − ¼): não é grande, enquanto um quarto do fundo é
80 + 65 − 5 = 140 = 280 − 140. A única atribuição com estas quatro propriedades:
eficiência (somam) · simetria · nulidade (sem efeito → 0) · aditividade (soma de modelos → soma de valores)
O shap.TreeExplainer numa árvore que reproduz a fórmula devolve [80, 65, −5] e valor base 140.
Simulador: toda coalizão, toda ordem de chegada
Preveja. Desligue coastal. A interação continua dividida ao meio? A cascata continua terminando na previsão?
No modelo de verdade: um distrito de San Francisco
- 8 atributos: \(2^8 = 256\) coalizões × 100 distritos do fundo = 25.600 previsões.
- Força bruta e
TreeExplainerconcordam até a sexta casa decimal (maior diferença 2e-06).
TreeExplainer obtém os mesmos números exatos percorrendo cada árvore uma vez por linha (Lundberg et al., 2020).Lendo uma cascata (waterfall)
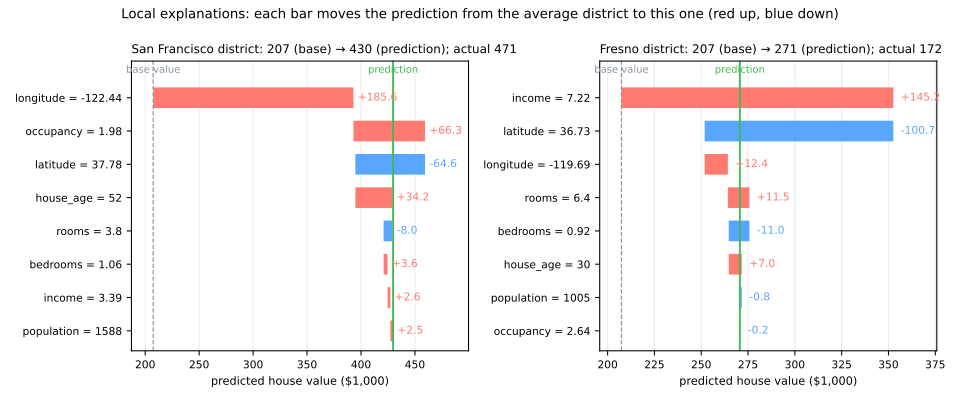
San Francisco (430 mil): longitude +185,6 e latitude −64,6, então localização +121,0; ocupação baixa +66,3; casas antigas +34,2; uma renda comum, +2,6.
Fresno (271 mil): uma renda alta (7,22) soma +145,2; localização −88,3.
Global: explicações locais empilhadas
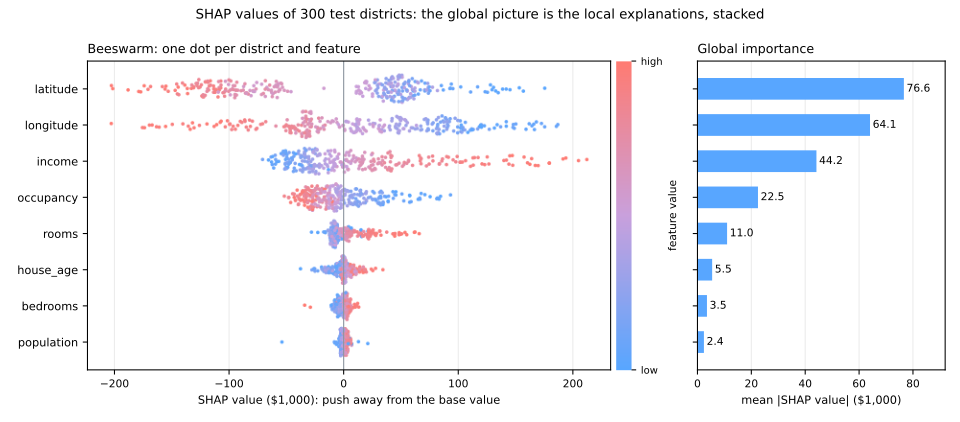
300 distritos × 8 valores SHAP. Média de |SHAP|, em US$ 1.000: latitude 76,6, longitude 64,1, renda 44,2, ocupação 22,5 ...
O beeswarm mostra também a direção: rendas altas à direita, ocupações altas e latitudes ao norte à esquerda.
Explicação ≠ causalidade
- "A ocupação baixa (1,98 pessoa por domicílio) soma US$ 66.300 ao preço previsto do distrito de San Francisco" (o valor SHAP dela) é uma afirmação verdadeira sobre o modelo.
- Não quer dizer que tirar gente de uma casa a deixa mais cara: domicílios lotados são um marcador de bairros mais pobres.
- Para auditoria: se um modelo de crédito se apoia no Código de Endereçamento Postal (CEP), ele pode estar usando o CEP como proxy de renda ou de raça.
Certo pelos motivos errados
Hospital A: pacientes graves demais para ficar de pé fazem o exame no aparelho portátil. Hospital B: aparelhos atribuídos ao acaso.
hospital B
importância por permutação
aparelho 0,393; marcadores médicos 0,012 no máximo
só os marcadores
73,0% no A, 74,7% no B
Nenhuma validação no A poderia ter avisado. A explicação avisou; só o conhecimento do domínio diz que essa dependência não vai sobreviver.
Resumo
- Legível primeiro: se um modelo interpretável é tão bom quanto nos mesmos folds, use-o.
- Importância por permutação, em dados separados: quanto o escore precisa de cada atributo.
- PDP para a forma média de um efeito, ICE para as linhas por trás dela; curvas em leque indicam interações.
- SHAP: contribuições que somam exatamente previsão − valor base; empilhadas, um ranking global com direções.
- Uma explicação descreve o modelo, não o mundo; quando um atributo domina, pergunte quando esse valor é registrado?
| pergunta | método |
|---|---|
| de quais atributos o escore precisa? | importância por permutação, em dados separados |
| como a previsão muda com um atributo? | PDP + ICE |
| por que esta previsão, para esta linha? | cascata SHAP |
Explicando decisões de crédito, passos 1 a 7
- German credit: 1.000 empréstimos, 20 atributos, 30% deram errado.
- Scorecard ou floresta, nos mesmos folds (ROC AUC, área sob a curva ROC, do inglês receiver operating characteristic); depois, abrir a floresta: MDI contra permutação, PDP e ICE, SHAP no geral e para o solicitante de maior risco.
- Baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook).
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: permutação nas linhas de treino (passo 4) e um fundo só de bons empréstimos (passo 7).
Ritmo: passos 1 a 3 em 10 min; passo 4 e a primeira simulação em 10 min; passos 5 e 6 em 10 min; passo 7 e a segunda simulação em 10 min.