Uma boa previsão que ninguém consegue ler
- Random forests, gradient boosting e redes neurais venceram as últimas aulas.
- Um ensemble de 200 árvores com boosting faz uma boa previsão, mas "por que este número?" não tem resposta que caiba numa página.
global
em quais atributos o modelo se apoia, no geral?
local
por que ele fez esta previsão para esta linha?
Por que explicar um modelo?
depuração
desconfie de um modelo bom demais: uma coluna vazada aparece no topo de qualquer ranking de importância
confiança
um médico, um analista de crédito ou um juiz não vai agir com base num número que não pode questionar
regulação
Lei Geral de Proteção de Dados (LGPD, Lei 13.709/2018, art. 20): direito de pedir a revisão de decisões automatizadas, com "informações claras e adequadas" sobre os critérios; o regulamento europeu de proteção de dados (GDPR, art. 22) vai na mesma direção
ciência
às vezes o modelo é uma ferramenta para aprender sobre o mundo; aí a explicação é o resultado
A caixa de ferramentas desta aula
| método | pergunta que responde | escopo |
|---|---|---|
| coeficientes, regras de árvore | o próprio modelo | global |
| importância por impureza (MDI) | quais atributos as divisões do treino mais usaram? | global, árvores |
| importância por permutação | quanto o escore depende de cada atributo? | global |
| dependência parcial (PDP) | como a previsão média muda com um atributo? | global |
| curvas ICE (expectativa condicional individual) | ... e para cada linha? | local, muitas linhas |
| valores SHAP (SHapley Additive exPlanations) | quanto cada atributo afastou esta previsão da média? | local → global |
| LIME (Local Interpretable Model-agnostic Explanations) | qual modelo linear imita a caixa-preta em volta desta linha? | local |
Métodos específicos leem o interior do modelo; os agnósticos só chamam predict.
O caminho desta aula
- Legível primeirocoeficientes, regras de árvore, o preço da legibilidade
- Global: o que importaimportância por permutação, dependência parcial, ICE
- Local: uma previsãovalores SHAP, LIME
- Ler com cuidadocausalidade, certo pelos motivos errados, um checklist
Antes: você precisa de uma caixa-preta?
Três candidatos nos mesmos cinco folds, do totalmente legível ao nada legível.
A legibilidade tem um preço, aqui
regressão linear
árvore, profundidade 3
gradient boosting
O que os modelos legíveis dizem
oito coeficientes
US$ 10.000 a mais de renda → +US$ 44.140 (com os outros fixos); um grau mais ao norte → −US$ 41.300.
rooms −11,65 e bedrooms +63,55 têm sinais opostos: são correlacionados (0,85), então "um quarto a mais com o número de cômodos fixo" significa converter um cômodo em quarto.
oito regras
Qualquer pessoa segue um distrito árvore abaixo:
renda acima de US$ 78.000 → US$ 457.900.
model é a caixa-preta: 200 árvores com até 16 folhas cada. O resto da aula a abre.Importância por permutação: embaralhe uma coluna
- Tome dados separados e o escore do modelo neles.
- Embaralhe uma coluna: os valores ficam, o vínculo com o alvo e com o resto de cada linha se quebra.
- Meça a queda do escore. Repita para cada coluna (Breiman, 2001).
for col in X_test.columns:
    X_perm = X_test.copy()
    X_perm[col] = rng.permutation(X_perm[col].to_numpy())
    drops[col] = base - r2_score(y_test, model.predict(X_perm))
Dois rankings do mesmo modelo
| permutação | MDI | |
|---|---|---|
| latitude | 1,346 | 0,103 |
| longitude | 1,187 | 0,117 |
| renda | 0,532 | 0,567 |
| ocupação | 0,134 | 0,130 |
| cômodos | 0,056 | 0,024 |
| população | 0,003 | 0,009 |
O laço à mão conta a mesma história: renda 0,539, população 0,002.
Embaralhar a latitude "custa" 1,330: o R² vai de 0,825 para cerca de −0,5, bem pior do que prever a média para todo mundo.
A explicação vem daqui a três slides.
Dados separados, não dados de treino
Uma floresta com duas colunas de ruído: uma contínua e um cara ou coroa.
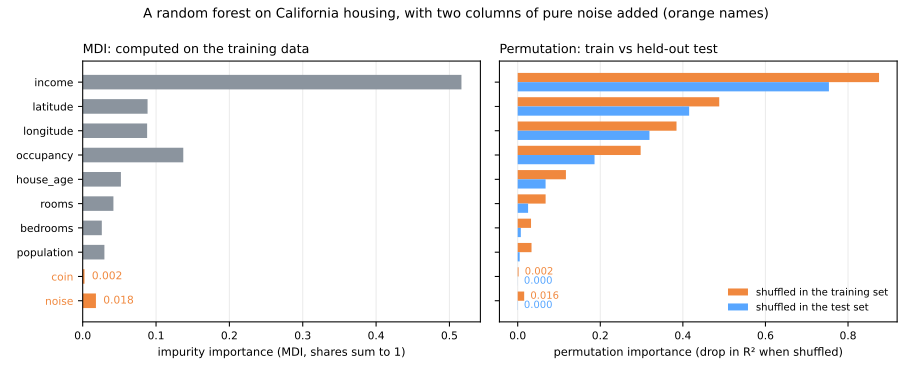
Atributos correlacionados (1): crédito dividido
Some uma cópia exata da renda e reajuste a floresta.
| MDI | perm. no teste | |
|---|---|---|
| renda sozinha | 0,516 | 0,754 |
| renda | 0,262 | 0,196 |
| cópia da renda | 0,259 | 0,196 |
| as duas embaralhadas juntas | 0,748 |
Embaralhe uma cópia e as árvores que dividem pela outra continuam funcionando.
Juntas, as duas cópias valem 0,392, metade do que a informação vale.
Atributos correlacionados (2): linhas impossíveis
- Latitude e longitude: correlação −0,92, porque a Califórnia é uma faixa diagonal.
- Embaralhe só a latitude: uma longitude de San Francisco recebe uma latitude de San Diego, um ponto no Pacífico.
O modelo nunca viu lugares assim. Parte do 1,330 mede a latitude; parte mede quão mal o modelo se comporta fora do mapa.
Dependência parcial: em que direção, com que forma?
Fixe o atributo \(j\) num valor \(v\) em todas as linhas, mantenha o resto e tire a média das previsões (Friedman, 2001):
\[ \mathrm{PD}_j(v) = \frac{1}{n}\sum_{i=1}^{n} \hat f\bigl(x_{i,1}, \dots,\, v,\, \dots, x_{i,d}\bigr) \]
by_hand = [model.predict(X_test.assign(income=v)).mean() for v in grid]
O PDP da renda, à mão
| renda (US$ 10 mil) | 1,5 | 2 | 3 | 4 | 5 | 6 | 8 | 10 |
|---|---|---|---|---|---|---|---|---|
| previsão média (US$ mil) | 142,6 | 150,6 | 173,7 | 205,1 | 229,5 | 280,6 | 358,6 | 379,8 |
plana embaixo
de 1,5 para 2 soma só 8,0
íngreme no meio
de 5 para 8 soma 129,1
achata de novo
de 8 para 10 soma 21,2, em parte pelo teto dos dados (US$ 500.001)
partial_dependence(..., method='brute') devolve os mesmos oito números.
ICE: uma curva por linha
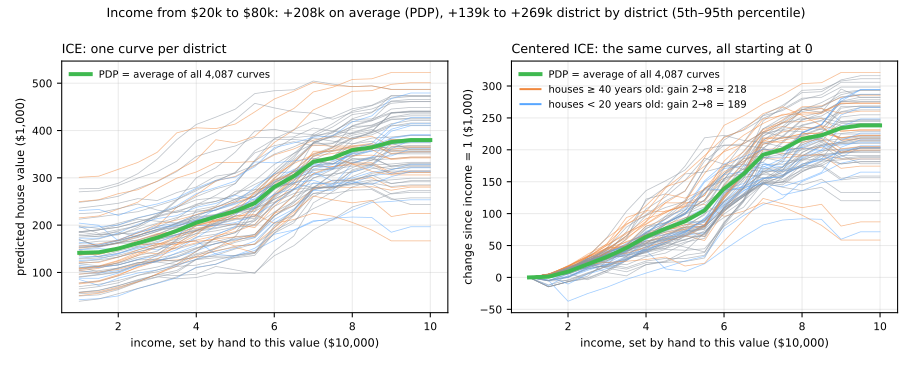
Renda de US$ 20.000 para US$ 80.000: +US$ 208.000 em média (o PDP), mas de +US$ 139.000 a +US$ 269.000 distrito a distrito (percentis 5 a 95).
A armadilha da extrapolação
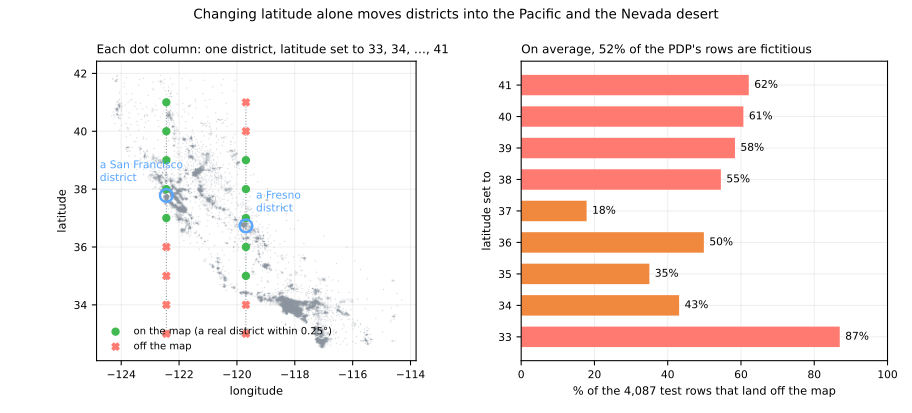
| latitude fixada em | 33° | 35° | 37° | 39° | 41° |
|---|---|---|---|---|---|
| linhas fora do mapa | 87% | 35% | 18% | 58% | 62% |
SHAP: por que esta previsão, para mim?
Divida uma previsão em contribuições, uma por atributo, que somam exatamente:
\[ \hat f(x) = \underbrace{\phi_0}_{\text{valor base}} + \phi_1 + \phi_2 + \dots + \phi_d \]- Os atributos são jogadores; a previsão é o prêmio do time (Shapley, 1953; Lundberg & Lee, 2017).
- Valor de uma coalizão \(S\): fixe os atributos de \(S\) nos valores da linha, tire os outros de um conjunto de fundo e faça a média.
- \(\phi_j\): a média de \(v(S \cup \{j\}) - v(S)\) sobre as coalizões em que \(j\) pode entrar, com toda ordem de chegada igualmente provável.
Um modelo de brinquedo, do tamanho de uma calculadora
\[ f = 100 + 80\,\text{rich} + 60\,\text{coastal} + 40\,\text{rich}\cdot\text{coastal} + 20\,\text{big} \quad (\mathrm{US}\$\ 1{.}000) \]- Fundo: quatro distritos, que valem 120, 180, 160 e 100. Então \(v(\varnothing) = 140\).
- Explicamos um distrito rico, litorâneo e não grande: \(f(x) = 280\).
Siga as setas em que "rich" entra
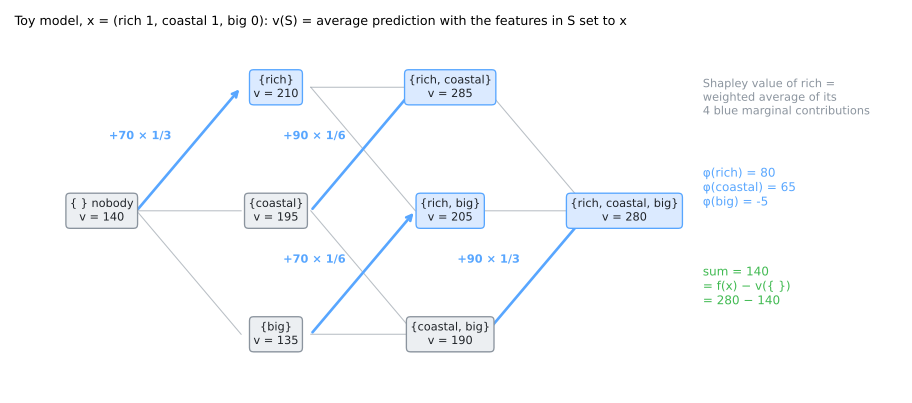
\(v(\{\text{rich}\})\): fixe rich = 1 nos quatro distritos: 200, 180, 280, 180, média 210.
\[ \phi_{\text{rich}} = \tfrac13(210-140) + \tfrac16(285-195) + \tfrac16(205-135) + \tfrac13(280-190) = 80 \]Todo número faz sentido
rich: 80
efeito principal 80 × (1 − ¼) = 60, mais metade da interação, 20
coastal: 65
45 + 20: a interação é dividida igualmente
big: −5
20 × (0 − ¼): não é grande, enquanto um quarto do fundo é
80 + 65 − 5 = 140 = 280 − 140. A única atribuição com estas quatro propriedades:
eficiência (somam) · simetria · nulidade (sem efeito → 0) · aditividade (soma de modelos → soma de valores)
O shap.TreeExplainer numa árvore que reproduz a fórmula devolve [80, 65, −5] e valor base 140.
Simulador: toda coalizão, toda ordem de chegada
Preveja. Desligue coastal. A interação continua dividida ao meio? A cascata continua terminando na previsão?
No modelo de verdade: um distrito de San Francisco
- 8 atributos: \(2^8 = 256\) coalizões × 100 distritos do fundo = 25.600 previsões.
- Força bruta e
TreeExplainerconcordam até a sexta casa decimal (maior diferença 2e-06).
TreeExplainer obtém os mesmos números exatos percorrendo cada árvore uma vez por linha (Lundberg et al., 2020).Lendo uma cascata (waterfall)
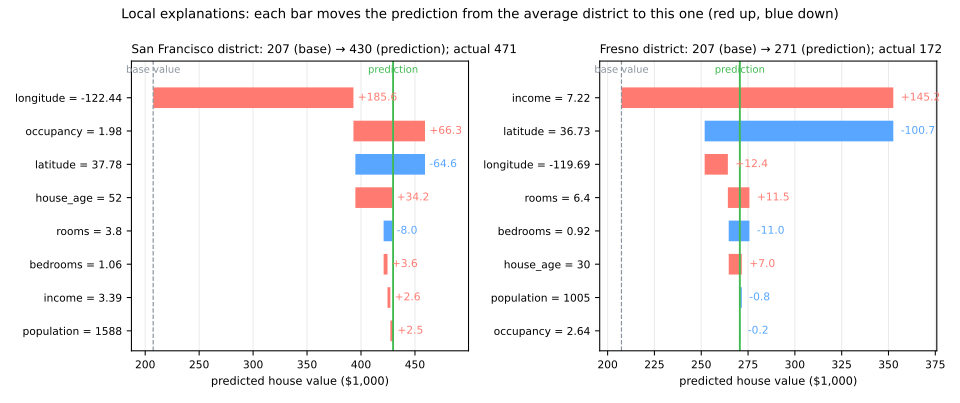
San Francisco (430 mil): longitude +185,6 e latitude −64,6, então localização +121,0; ocupação baixa +66,3; casas antigas +34,2; uma renda comum, +2,6.
Fresno (271 mil): uma renda alta (7,22) soma +145,2; localização −88,3.
Global: explicações locais empilhadas
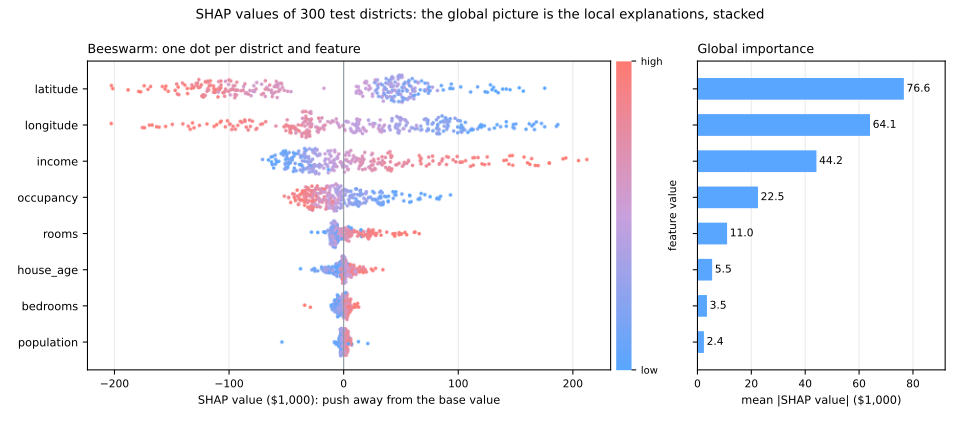
300 distritos × 8 valores SHAP. Média de |SHAP|, em US$ 1.000: latitude 76,6, longitude 64,1, renda 44,2, ocupação 22,5 ...
O beeswarm mostra também a direção: rendas altas à direita, ocupações altas e latitudes ao norte à esquerda.
Três rankings, três perguntas
MDI
renda em primeiro (0,567)
o que o treino usou?
permutação
latitude em primeiro, uma queda maior que 1, inflada por linhas impossíveis
de que o escore precisa?
média de |SHAP|
latitude em primeiro, 76,6 contra 44,2 da renda, em US$ 1.000
quanto cada atributo move as previsões?
LIME: um modelo linear em volta de uma linha
- perturbar: milhares de pontos em volta da linha
- prever: perguntar à caixa-preta sobre cada um
- ponderar: quanto mais perto, mais peso (kernel de largura \(w\))
- ajustar um modelo linear ponderado
| San Francisco | à mão | lime |
|---|---|---|
| renda | 42,1 | 42,0 |
| ocupação | −49,9 | −48,9 |
| latitude | −89,3 | −91,8 |
| longitude | −53,6 | −55,5 |
Em US$ 1.000 por desvio padrão (Ribeiro, Singh & Guestrin, 2016).
SHAP ou LIME? Respondem a perguntas diferentes
SHAP
quanto a renda real deste distrito afasta sua previsão da média? A renda é comum: afasta pouco.
"por que esta casa é cara?"
LIME
o que aconteceria se a renda mudasse? A inclinação local, que é íngreme.
"o que mudaria o preço?"
Quão local é "local"?
| largura | 0,5 | 1,0 | 2,12 | 5,0 | dp, 5 sementes |
|---|---|---|---|---|---|
| renda | 54,7 | 54,8 | 42,1 | 38,2 | 1,5 |
| house_age | −9,9 | 1,3 | 1,3 | 1,0 | 1,3 |
| ocupação | −71,0 | −67,4 | −49,9 | −45,0 | 0,9 |
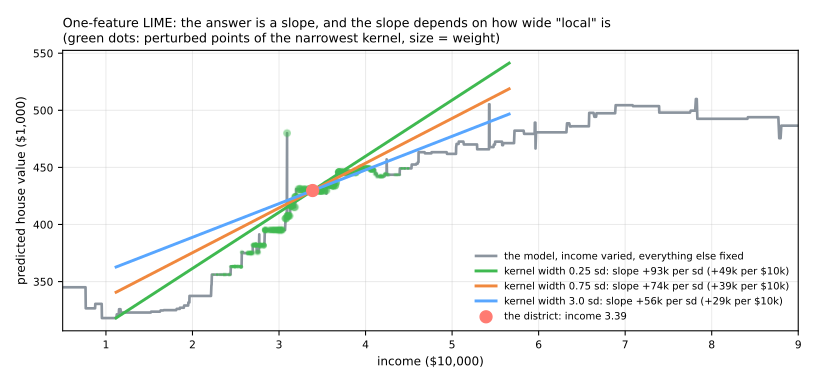
house_age chega a trocar de sinal. O padrão \(0{,}75\sqrt{d} = 2{,}12\) é uma convenção, não uma lei.Explicação ≠ causalidade
- "Em volta deste distrito, um desvio padrão a mais de ocupação reduz o preço previsto em cerca de US$ 50.000" é uma afirmação verdadeira sobre o modelo.
- Não quer dizer que pôr mais gente numa casa a deixa mais barata: domicílios lotados são um marcador de bairros mais pobres.
- Para auditoria: se um modelo de crédito se apoia no CEP, ele pode estar usando o CEP como proxy de renda ou de raça.
Certo pelos motivos errados
Hospital A: pacientes graves demais para ficar de pé fazem o exame no aparelho portátil. Hospital B: aparelhos atribuídos ao acaso.
hospital B
importância por permutação
aparelho 0,393; marcadores médicos 0,012 no máximo
só os marcadores
73,0% no A, 74,7% no B
Nenhuma validação no A poderia ter avisado. A explicação avisou; só o conhecimento do domínio diz que essa dependência não vai sobreviver.
Um checklist para explicar um modelo
- Tente primeiro um modelo interpretável; se ele for tão bom quanto nos mesmos folds, use-o.
- Calcule importâncias em dados separados.
- Procure grupos correlacionados e embaralhe ou explique esses grupos juntos.
- Olhe as curvas ICE, não só o PDP; confira se os valores do gráfico estão dentro dos dados.
- Use SHAP para explicações locais; informe o fundo que você usou.
- Quando um atributo domina, pergunte quando esse valor é registrado? (vazamento).
- Nunca leia uma explicação como uma afirmação causal.
Explicando decisões de crédito
- German credit: 1.000 empréstimos, 20 atributos, 30% deram errado.
- Scorecard ou floresta? Regressão logística com área sob a curva ROC (ROC AUC) de 0,771, random forest 0,785: uma diferença por fold de +0,014 ± 0,023, um empate.
- Abra a floresta: MDI contra permutação, PDP e ICE, SHAP global e para o solicitante de maior risco.
- O modelo precisa de
personal_status? Depois, plante um vazamento (cartas de cobrança, enviadas depois que um empréstimo dá errado): ROC AUC da CV de 0,785 para 0,927 e as explicações o encontram.
Baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook).
Resumo
- Antes de explicar uma caixa-preta, confira se um modelo legível é tão bom quanto.
- Importância por permutação em dados separados; atributos correlacionados dividem o crédito e criam linhas impossíveis.
- PDP para a forma média, ICE para as linhas por trás dela; cuidado com a extrapolação.
- SHAP: contribuições que somam exatamente previsão − valor base.
- LIME: a inclinação local, sensível à largura do kernel.
- Uma explicação descreve o modelo, não o mundo.