A Fronteira
A última parada do arco que começou com os mínimos quadrados em 1805. O centro dela é um mapa do campo: todas as técnicas das aulas anteriores, agrupadas pelo trabalho que fazem, ao lado das técnicas que ficam logo além desta disciplina, cada uma com a aula em que foi vista e onde ler mais. Em volta do mapa: como o transfer learning e os modelos de fundação mudaram a economia do machine learning, onde a caixa de ferramentas clássica que você construiu ainda vence e os problemas que o campo ainda não resolveu.
A aula não tem um conjunto de dados próprio. Os dois labs são exercícios guiados nesta página: você clica no mapa, encaminha pedidos para a ferramenta certa e confere, com algumas linhas de Python, três afirmações do texto — que a metade de busca de um sistema RAG é um k-NN, que o modelo de recompensa do RLHF é uma regressão logística e que a LoRA treina uma fração minúscula de um modelo. Todo número citado vem dos blocos de código desta página ou dos artigos citados.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Onde fica cada técnica da disciplina e quando recorrer a um modelo de fundação em vez da caixa de ferramentas clássica? | Como as ferramentas da fronteira funcionam por dentro, como testá-las e o que ainda está em aberto? |
| conteúdo | o mapa do campo e quatro caminhos por ele; transfer learning por extração de atributos e por fine-tuning; modelos de fundação, escala e os jeitos de adaptar um LLM (zero-shot, few-shot, fine-tuning, RAG); a caixa de ferramentas clássica dentro da pilha de LLMs; onde o ML clássico ainda vence; roteamento | a LoRA em detalhe, contada camada por camada, e por que uma atualização de baixo posto pode bastar; a memória do fine-tuning; por que as árvores ainda lideram nas tabelas; o TabPFN e como testar um desafiante; problemas em aberto |
| lab em aula | rotear o problema, passos 1 a 4 | contar, comprimir e testar, passos 5 a 7 |
| ao final, você sabe | situar uma técnica no mapa e dizer no que ela se apoia; distinguir extração de atributos, fine-tuning, prompting e RAG; reconhecer um k-NN, uma regressão logística e um problema de vazamento dentro de um sistema de LLM; encaminhar um pedido para um modelo de fundação, para a pilha clássica ou para os dois | contar o que a LoRA treina e o que ela economiza em memória; dizer quando uma atualização de baixo posto basta e quando não basta; explicar como o TabPFN prevê sem treinar; desenhar um teste justo de um desafiante contra o padrão clássico |
Esta aula não tem notebook. O código de cada passo roda em qualquer Python com scikit-learn: abra um notebook novo no Colab (não é preciso instalar nada) e copie os blocos desta página, em ordem. Os passos 1 e 4 não têm código.
Abordagem fundamental
Uma pergunta guia esta parte: onde fica tudo o que você aprendeu e quando um modelo de fundação é a ferramenta certa? A resposta parte do mapa, passa pelas duas ideias que mudaram a economia do campo (reusar um modelo pré-treinado; adaptá-lo com um prompt em vez de um treino), acha as peças desta disciplina dentro da pilha nova e termina numa regra de roteamento: que tipo de problema vai para que tipo de modelo.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. mapear o campo; 2. reusar, não recomeçar; 3. achar o clássico por dentro; 4. rotear o problema. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Mapear o campocada técnica pelo trabalho que faz; quatro caminhos
- Reusar, não recomeçartransfer learning, modelos de fundação, prompts
- Achar o clássico por dentrosoftmax, k-NN, regressão logística, vazamento
- Rotear o problemaonde o clássico vence; o que usar quando
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Um mapa do campo
Etapa 1. As técnicas estão agrupadas pela pergunta que respondem: preparar os dados, achar estrutura sem rótulos, transformar texto em números, prever com retas, vizinhos, árvores ou redes, medir com honestidade, explicar, automatizar, operar. Mais dois grupos guardam o que esta disciplina não alcançou: outros formatos de problema (sequências, recomendações, recompensas, grafos) e a própria fronteira. As fichas cheias foram vistas aqui (o código indica a aula); as fichas tracejadas ficam além. Clique em uma técnica para ver o que ela é, no que se apoia, o que se apoia nela e onde ler mais.
Como ler o mapa
As ligações entre as fichas são o que o mapa tem de mais útil. Quatro caminhos por ele:
- A geração aumentada por recuperação (RAG) apoia-se no k-NN e nos embeddings densos. Uma ideia de 1951 (votar entre os pontos mais próximos) e uma de 2013 (palavras como vetores) formam a metade de busca de um sistema de 2020. O passo 2 do lab constrói essa metade.
- O alinhamento (RLHF) treina um modelo de recompensa sobre pares de respostas: a probabilidade de a resposta A ser preferida à resposta B é modelada como \(\sigma(r_A - r_B)\), a sigmoide de uma diferença de escores. Isso é uma regressão logística, ajustada com a mesma entropia cruzada que você minimizou na aula de regressão logística. O passo 3 do lab ajusta uma.
- A avaliação de sistemas de LLM apoia-se nas métricas de classificação e em validação cruzada e vazamento. Um benchmark cujas perguntas vazaram para os dados de treino é o mesmo erro que um scaler ajustado antes da divisão, em escala de internet.
- Os modelos de fundação tabulares são o único ponto em que a fronteira ataca de frente o reduto do gradient boosting. Eles são discutidos na abordagem avançada.
O mesmo mapa, como lista
Todos os nós do mapa, agrupados do mesmo jeito. Esta lista é a fonte do mapa: funciona sem JavaScript e na impressão. marca a aula em que a técnica foi vista, marca o que fica além desta disciplina, marca onde ler (primeiro um artigo clássico, depois um recurso moderno).
Fundamentos — o que é aprender com dados
- Uma história das máquinas que aprendem — Dos mínimos quadrados (1805) ao perceptron, dois invernos da IA, o deep learning e os LLMs: cada onda recombina ideias antigas com mais dados e mais computação.
F1. Introdução & História · Turing (1950) · Sutton, "The Bitter Lesson" (2019) - Paradigmas de aprendizado — Supervisionado (aprende com rótulos), não supervisionado (acha estrutura), por reforço (aprende com recompensas): o paradigma decorre do retorno que os dados trazem.
F2. O panorama de ML · Hastie, Tibshirani & Friedman (2009) · James et al. (2023) - Generalização e no free lunch — O que importa é o erro em dados que o modelo não viu; nenhum algoritmo vence em todo problema: as suposições precisam combinar com os dados. Apoia-se em paradigmas de aprendizado.
F2. O panorama de ML · Wolpert (1996) · Domingos (2012)
Dados — dos registros brutos a uma matriz pronta para o modelo
- Análise exploratória de dados — Olhe antes de modelar: distribuições, valores faltantes, outliers, associações. Divida primeiro e explore só a parte de treino.
D1. Análise Exploratória de Dados · Anscombe (1973) · Matejka & Fitzmaurice (2017) - Pré-processamento — Escalonar atributos numéricos, codificar categorias, transformar colunas assimétricas e imputar valores faltantes, sempre ajustando só nos dados de treino. Apoia-se em EDA.
D2. Pré-processamento de Dados · Little & Rubin (2019) · scikit-learn: pré-processamento - Pipelines — Encadeiam o pré-processamento e o modelo em um único estimador, para que todo ajuste aconteça dentro da divisão certa. Apoia-se em pré-processamento.
D3. Pipelines · Buitinck et al. (2013) · scikit-learn: pipelines - IA centrada em dados e qualidade dos rótulos — Dados melhores muitas vezes valem mais que um modelo melhor: achar erros de rótulo, remover duplicatas, documentar como o conjunto foi coletado. Apoia-se em EDA.
além desta disciplina · Northcutt, Athalye & Mueller (2021) · Gebru et al. (2021)
Aprendizado não supervisionado — estrutura sem rótulos
- PCA — Gira os dados para as direções de maior variância e guarda as primeiras, para comprimir, tirar ruído ou plotar. Apoia-se em pré-processamento.
U1. Redução de Dimensionalidade · Pearson (1901) · Jolliffe & Cadima (2016) - t-SNE e UMAP — Mapas não lineares que mantêm perto os vizinhos de cada ponto, para enxergar dados de alta dimensão; as distâncias entre os grupos dizem pouco. Apoia-se em PCA, k-NN.
U1. Redução de Dimensionalidade · van der Maaten & Hinton (2008) · McInnes, Healy & Melville (2018) - k-means — Divide as linhas em k grupos compactos em torno de centroides; k se escolhe pela inércia e pela silhueta. Apoia-se em pré-processamento.
U2. Agrupamento · Lloyd (1982) · Arthur & Vassilvitskii (2007) - Agrupamento hierárquico — Funde os grupos mais próximos um passo de cada vez e lê o resultado num dendrograma; corta-se no nível desejado. Apoia-se em k-means.
E1. Agrupamento Hierárquico · Ward (1963) · Sokal & Rohlf (1962) - DBSCAN e HDBSCAN — Grupos como regiões densas de qualquer forma; os pontos das regiões esparsas ficam marcados como ruído. Apoia-se em k-NN.
U2. Agrupamento · Ester et al. (1996) · Campello, Moulavi & Sander (2013) - Detecção de anomalias — Sinaliza os pontos raros que não se encaixam no resto: isolation forests, escores de densidade, erros de reconstrução. Apoia-se em DBSCAN, random forest.
além desta disciplina · Liu, Ting & Zhou (2008) · scikit-learn: detecção de outliers - Aprendizado autossupervisionado e contrastivo — Inventa uma tarefa de previsão a partir dos próprios dados (esconder uma palavra, casar dois recortes da mesma imagem) e aprende representações sem nenhum rótulo humano. Apoia-se em embeddings densos, redes neurais.
além desta disciplina · Devlin et al. (2019) · Chen et al. (2020)
Texto — palavras viram vetores
- Bag-of-words e TF-IDF — Conta os tokens de cada documento e dá menos peso aos que todo documento usa: esparso, rápido, interpretável.
E2. Representação de Texto · Salton & Buckley (1988) · Manning, Raghavan & Schütze (2008) - Embeddings densos — Palavras e frases como vetores curtos e densos cuja geometria codifica o significado: textos de sentido parecido caem perto. Apoia-se em bag-of-words.
E2. Representação de Texto · Mikolov et al. (2013) · Reimers & Gurevych (2019) - Modelos de tópicos: LDA e BERTopic — Acham os temas de um corpus: o LDA como misturas de palavras; o BERTopic como grupos de embeddings, descritos por um TF-IDF por classe. Apoia-se em embeddings densos, UMAP, HDBSCAN, TF-IDF.
E3. Modelagem de Tópicos & BERTopic · Blei, Ng & Jordan (2003) · Grootendorst (2022) - Tokenização em subpalavras — Como os LLMs cortam o texto: o byte-pair encoding monta um vocabulário de fragmentos frequentes e nenhuma palavra fica fora do vocabulário. Apoia-se em bag-of-words.
além desta disciplina · Sennrich, Haddow & Birch (2016) · cursos da Hugging Face
Modelos lineares — retas, planos e margens
- Regressão linear — Mínimos quadrados: o ajuste em forma fechada, os resíduos, o R² e as suposições por trás das inferências.
R1. Regressão Linear · Galton (1886) · James et al. (2023) - Gradiente descendente — Desce a ladeira da perda, um lote ou mini-lote por vez: o otimizador por trás de quase todo modelo moderno. Apoia-se em regressão linear.
R2. Gradiente Descendente & Regularização · Ruder (2016) · Bottou, Curtis & Nocedal (2018) - Ridge e Lasso — Penaliza pesos grandes (L2) ou empurra alguns para exatamente zero (L1): um pouco de viés em troca de muito menos variância. Apoia-se em regressão linear.
R2. Gradiente Descendente & Regularização · Hoerl & Kennard (1970) · Tibshirani (1996) - Regressão logística e softmax — Probabilidades pela sigmoide ou pela softmax, treinadas com entropia cruzada; a camada de saída de toda rede classificadora. Apoia-se em regressão linear, gradiente descendente.
C1. Regressão Logística · Berkson (1944) · Cox (1958) - Máquinas de vetores de suporte e kernels — A fronteira de margem mais larga, curvada por um kernel que nunca constrói os novos atributos. Apoia-se em regressão logística, Ridge.
C5. Máquinas de Vetores de Suporte · Cortes & Vapnik (1995) · Hsu, Chang & Lin (2003) - Modelos probabilísticos e bayesianos — Distribuições sobre parâmetros e previsões (naive Bayes, regressão bayesiana, processos gaussianos): incerteza por construção. Apoia-se em regressão linear, Ridge.
além desta disciplina · Rasmussen & Williams (2006) · Murphy (2022)
Aprendizado baseado em instâncias — os vizinhos votam
- k-vizinhos mais próximos — Guarda o conjunto de treino e prevê a partir das k linhas mais próximas; o escalonamento e a escolha de k fazem todo o trabalho. Apoia-se em pré-processamento.
C2. k-Vizinhos Mais Próximos · Fix & Hodges (1951) · Cover & Hart (1967) - Busca aproximada de vizinhos mais próximos — Índices em grafo e por quantização (HNSW, FAISS) acham os vetores quase mais próximos entre bilhões em milissegundos: o motor dos bancos de dados vetoriais. Apoia-se em k-NN, embeddings densos.
além desta disciplina · Malkov & Yashunin (2020) · Johnson, Douze & Jégou (2019)
Árvores e ensembles — os burros de carga dos dados tabulares
- Árvores de decisão — Perguntas de sim/não recursivas, cada uma escolhida para reduzir a impureza; fáceis de ler, instáveis sozinhas.
M1. Árvores de Decisão · Breiman et al. (1984) · Quinlan (1986) - Random forest — A média de centenas de árvores descorrelacionadas, cada uma crescida em uma amostra bootstrap; o erro out-of-bag vem de graça. Apoia-se em árvores de decisão.
M2. Random Forest · Breiman (2001) · Louppe (2014) - Gradient boosting: XGBoost, LightGBM, CatBoost — Soma árvores pequenas uma de cada vez, cada uma ajustada ao gradiente da perda: o vencedor habitual em dados tabulares. Apoia-se em árvores de decisão, gradiente descendente.
M3. Gradient Boosting · Friedman (2001) · Chen & Guestrin (2016) · Ke et al. (2017) - Stacking — Treina um meta-modelo sobre as previsões fora do fold de vários modelos diferentes. Apoia-se em validação cruzada, gradient boosting.
além desta disciplina · Wolpert (1992) · scikit-learn: ensembles
Redes neurais — do perceptron ao deep learning
- Perceptron, MLP e retropropagação — Unidades logísticas empilhadas com ativações não lineares, treinadas pela regra da cadeia: as camadas ocultas aprendem os próprios atributos. Apoia-se em regressão logística, gradiente descendente.
E4. Redes Neurais · Rosenblatt (1958) · Rumelhart, Hinton & Williams (1986) - Redes convolucionais — Pequenos filtros compartilhados por toda a imagem, empilhados de bordas a texturas e a objetos. Apoia-se em MLP.
além desta disciplina · LeCun et al. (1998) · Krizhevsky, Sutskever & Hinton (2017) · ANN-DL do Insper - Redes recorrentes e LSTMs — Um estado carregado ao longo de uma sequência, passo a passo; portões deixam a LSTM lembrar por trechos longos. Apoia-se em MLP.
além desta disciplina · Hochreiter & Schmidhuber (1997) · ANN-DL do Insper - Transformers e atenção — Cada token olha para todos os outros e tira uma média ponderada, com pesos vindos de similaridades aprendidas (uma softmax). Apoia-se em MLP, embeddings densos, softmax.
além desta disciplina · Vaswani et al. (2017) · Alammar (2018) · ANN-DL do Insper - Modelos generativos: VAEs, GANs, difusão — Aprendem a distribuição dos próprios dados e amostram dela novas imagens, sons ou moléculas. Apoia-se em MLP, redes convolucionais.
além desta disciplina · Goodfellow et al. (2014) · Ho, Jain & Abbeel (2020) · ANN-DL do Insper
Avaliação e seleção de modelos — números honestos
- Métricas de classificação — Matriz de confusão, precisão, revocação, F1, MCC: escolha a métrica pelo custo de cada tipo de erro.
C3. Métricas de Classificação · van Rijsbergen (1979) · Chicco & Jurman (2020) - ROC, PR e dados desbalanceados — Curvas sobre todos os limiares; pesos de classe, mudança de limiar e reamostragem quando os positivos são raros. Apoia-se em métricas de classificação.
C4. ROC, PR e Dados Desbalanceados · Fawcett (2006) · Saito & Rehmsmeier (2015) - Validação cruzada e vazamento de dados — Revezar o fold de validação para uma estimativa mais estável, manter todo passo ajustado e todo fato do futuro longe das linhas avaliadas; comparar modelos nos mesmos folds (a validação cruzada aninhada avalia a própria escolha). Apoia-se em pipelines, generalização.
C6. Validação Cruzada e Vazamento de Dados · Stone (1974) · Kapoor & Narayanan (2023) - Seleção de modelos e viés–variância — A decomposição viés–variância, as curvas de validação e de aprendizado, a regressão à média: distinguir underfitting de overfitting e escolher a complexidade pelos escores de validação, não pela esperança. Apoia-se em validação cruzada, Ridge e Lasso.
M4. Seleção de Modelos · Geman, Bienenstock & Doursat (1992) · Belkin et al. (2019) - Calibração e predição conformal — Probabilidades que significam o que dizem e conjuntos de previsão que contêm a resposta certa a uma taxa garantida. Apoia-se em métricas de classificação, validação cruzada.
além desta disciplina · Guo et al. (2017) · Angelopoulos & Bates (2021)
Explicabilidade e responsabilidade — por que o modelo diz o que diz
- Interpretável por construção — Modelos lineares e árvores rasas, cujo raciocínio se lê diretamente; para decisões de alto risco, muitas vezes bastam. Apoia-se em regressão logística, árvores de decisão.
E5. Explicabilidade · Rudin (2019) · Molnar, Interpretable Machine Learning - Importância por permutação — Embaralha um atributo em dados separados e mede o quanto o escore cai. Apoia-se em random forest, validação cruzada.
E5. Explicabilidade · Fisher, Rudin & Dominici (2019) · scikit-learn: importância por permutação - SHAP e LIME — Explicam uma previsão: a contribuição de cada atributo, por valores de Shapley (SHAP) ou por um substituto linear local (LIME). Apoia-se em gradient boosting, importância por permutação.
E5. Explicabilidade · Ribeiro, Singh & Guestrin (2016) · Lundberg & Lee (2017) - Ética e responsabilidade — Os modelos aprendem o viés das decisões históricas; privacidade, consentimento e prestação de contas fazem parte do trabalho, não são um apêndice.
F2. O panorama de ML · Obermeyer et al. (2019) · Bender et al. (2021) - Justiça algorítmica (fairness) — Critérios formais (paridade demográfica, equalized odds), por que não valem todos ao mesmo tempo e como auditar um modelo grupo a grupo. Apoia-se em ética, métricas de classificação.
além desta disciplina · Hardt, Price & Srebro (2016) · Barocas, Hardt & Narayanan (2023) - Interpretabilidade mecanicista — Abre a própria rede e acha os atributos e circuitos que seus neurônios computam. Apoia-se em transformers, SHAP.
além desta disciplina · Olah et al. (2020) · Templeton et al. (2024)
AutoML — a busca pelo modelo
- Busca aleatória e otimização bayesiana — Sorteia hiperparâmetros ao acaso ou deixa um modelo substituto decidir onde tentar a seguir (Optuna). Apoia-se em seleção de modelos.
E6. AutoML · Bergstra & Bengio (2012) · Snoek, Larochelle & Adams (2012) - Successive halving e Hyperband — Dá a cada candidato um orçamento pequeno, guarda a melhor fração e dá mais orçamento aos sobreviventes. Apoia-se em busca aleatória.
E6. AutoML · Jamieson & Talwalkar (2016) · Li et al. (2018) - AutoML do pipeline inteiro — Busca junto o pré-processamento, a família de modelo e seus hiperparâmetros, muitas vezes terminando em um ensemble. Apoia-se em pipelines, otimização bayesiana, stacking.
E6. AutoML · Feurer et al. (2015) · Erickson et al. (2020) - Busca de arquitetura neural — Busca a própria arquitetura da rede: camadas, larguras, conexões. Apoia-se em otimização bayesiana, MLP.
além desta disciplina · Zoph & Le (2017) · Elsken, Metzen & Hutter (2019)
MLOps — modelos em produção
- Serving, versionamento e reprodutibilidade — Persistir o pipeline ajustado, fixar as versões dos dados e das bibliotecas, servir previsões atrás de uma API. Apoia-se em pipelines.
E7. MLOps · Sculley et al. (2015) · Breck et al. (2017) - Monitoramento e drift — Acompanhar as entradas, as previsões e os desfechos em produção; retreinar quando o mundo muda. Apoia-se em métricas de classificação, serving.
E7. MLOps · Gama et al. (2014) · Rabanser, Günnemann & Lipton (2019) - Model cards e documentação — Uma ficha curta e padronizada: para que serve o modelo, como foi avaliado, com quem ele erra. Apoia-se em ética, serving.
E7. MLOps · Mitchell et al. (2019) · Hugging Face: model cards
Outros formatos de problema — além de uma linha, um rótulo
- Previsão de séries temporais — Prevê os próximos valores de uma sequência a partir das defasagens e da sazonalidade, com uma validação que só olha para trás. Apoia-se em validação cruzada, gradient boosting.
além desta disciplina · Hyndman & Athanasopoulos (2021) · Makridakis, Spiliotis & Assimakopoulos (2022) - Sistemas de recomendação — Preveem quem quer o quê a partir de interações esparsas: fatoração de matrizes e, depois, embeddings de usuários e itens buscados por vizinhos mais próximos. Apoia-se em PCA, embeddings densos, vizinhos aproximados.
além desta disciplina · Koren, Bell & Volinsky (2009) · Covington, Adams & Sargin (2016) - Aprendizado por reforço — Um agente aprende agindo e colhendo recompensas: bandits, Q-learning, policy gradients. O paradigma foi apresentado na aula de panorama do ML. Apoia-se em paradigmas de aprendizado, MLP.
além desta disciplina · Sutton & Barto (2018) · Mnih et al. (2015) - Redes neurais em grafos — Aprendem sobre redes de entidades conectadas (moléculas, redes sociais, mapas viários) trocando mensagens entre vizinhos. Apoia-se em MLP, k-NN.
além desta disciplina · Kipf & Welling (2017) · Sanchez-Lengeling et al. (2021)
A fronteira — modelos de fundação e questões em aberto
- Transfer learning e fine-tuning — Parte de um modelo pré-treinado: usa seus embeddings como atributos ou continua treinando seus pesos (todos ou uma fatia LoRA de baixo posto) com os seus rótulos. Discutido mais abaixo. Apoia-se em embeddings densos, MLP.
além desta disciplina · Howard & Ruder (2018) · Hu et al. (2022) - Modelos de fundação e LLMs — Um modelo muito grande pré-treinado em tarefas autossupervisionadas e depois adaptado a muitas tarefas; escala em dados, parâmetros e computação continua comprando novas habilidades. Discutido mais abaixo. Apoia-se em transformers, aprendizado autossupervisionado, transfer learning.
além desta disciplina · Kaplan et al. (2020) · Brown et al. (2020) · Bommasani et al. (2021) - Prompting e aprendizado em contexto — Descreva a tarefa e mostre alguns exemplos no prompt; nenhum peso muda. Apoia-se em modelos de fundação.
além desta disciplina · Brown et al. (2020) · Wei et al. (2022) - Geração aumentada por recuperação (RAG) — Gera o embedding da pergunta, busca os trechos mais próximos em um acervo de documentos e os coloca no prompt: k-NN sobre embeddings alimentando um LLM. Apoia-se em k-NN, vizinhos aproximados, embeddings densos, modelos de fundação.
além desta disciplina · Lewis et al. (2020) · Karpukhin et al. (2020) - Alinhamento: RLHF e sucessores — Ajusta um modelo às preferências humanas, por meio de um modelo de recompensa treinado em pares de respostas comparadas (RLHF) ou diretamente nesses pares (DPO). Apoia-se em aprendizado por reforço, regressão logística, modelos de fundação.
além desta disciplina · Christiano et al. (2017) · Ouyang et al. (2022) · Rafailov et al. (2023) - Avaliação de sistemas de LLM — Os benchmarks saturam e vazam para os dados de treino; tarefas separadas, LLM-como-juiz e arenas de preferência humana são os novos conjuntos de validação. Apoia-se em métricas de classificação, validação cruzada e vazamento.
além desta disciplina · Liang et al. (2022) · Zheng et al. (2023) · Sainz et al. (2023) - Modelos multimodais — Um único espaço de embeddings para imagens e texto (CLIP) e, depois, modelos que leem, veem e ouvem ao mesmo tempo. Apoia-se em aprendizado autossupervisionado, transformers, redes convolucionais.
além desta disciplina · Radford et al. (2021) · Dosovitskiy et al. (2021) - Agentes e uso de ferramentas — LLMs que planejam, chamam ferramentas (busca, código, APIs) e agem em laço; como avaliá-los e mantê-los seguros está em grande parte em aberto. Apoia-se em prompting, RAG, aprendizado por reforço.
além desta disciplina · Yao et al. (2023) · Schick et al. (2023) - Modelos de fundação tabulares — Um transformer pré-treinado em milhões de tabelas sintéticas prevê uma nova tabela pequena em uma única passada (TabPFN), desafiando as árvores com boosting em dados pequenos. Discutido mais abaixo. Apoia-se em gradient boosting, transformers, seleção de modelos.
além desta disciplina · Grinsztajn, Oyallon & Varoquaux (2022) · Hollmann et al. (2023) · Hollmann et al. (2025) - Machine learning causal — De "o que prevê Y?" para "o que acontece com Y se agirmos?": efeitos de tratamento, uplift, double machine learning. Apoia-se em regressão linear, validação cruzada, gradient boosting.
além desta disciplina · Chernozhukov et al. (2018) · Hernán & Robins, Causal Inference: What If - Modelos eficientes: destilação e quantização — Modelos menores e mais baratos que mantêm quase toda a qualidade: um aluno treinado nos rótulos suaves de um professor, pesos guardados em 4 ou 8 bits. Apoia-se em modelos de fundação, transfer learning.
além desta disciplina · Hinton, Vinyals & Dean (2015) · Dettmers et al. (2023) - Regulação e governança de IA — Leis baseadas em risco e arcabouços de gestão de risco: o AI Act europeu, o AI RMF do NIST e, no Brasil, a LGPD (artigo 20: o direito de pedir revisão de decisões automatizadas) e o projeto de lei de IA, PL 2338/2023. Apoia-se em ética, justiça algorítmica, model cards, modelos interpretáveis.
além desta disciplina · AI Act da UE (2024) · NIST AI RMF 1.0 (2023) · PL 2338/2023 (Senado)
2. Transfer learning: pare de começar do zero
Etapa 2. O aprendizado supervisionado clássico treina cada modelo do zero com seus próprios dados rotulados. O transfer learning reutiliza conhecimento: pré-treine um modelo grande em um corpus genérico enorme e depois o adapte à sua tarefa. Há dois jeitos de adaptar:
- extração de atributos: congelar o modelo pré-treinado e usar suas representações como atributos para uma cabeça clássica. Você fez isso: sentence embeddings alimentando uma regressão logística ou uma etapa de agrupamento;
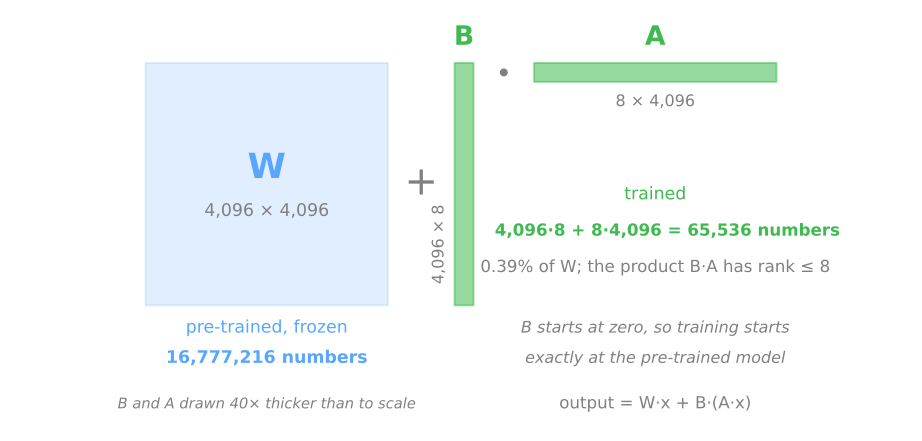
- fine-tuning: continuar treinando alguns ou todos os pesos com seus dados rotulados, tipicamente 10²–10⁴ exemplos em vez de 10⁶. A LoRA (Hu et al., 2022) treina só uma correção de baixo posto \(W + BA\) de cada matriz de pesos, com \(B\) e \(A\) finas; para uma matriz \(4096 \times 4096\) e posto 8, são \(2 \times 4096 \times 8 = 65.536\) números treináveis em vez de \(16.777.216\), 0,39% deles.
A figura desenha essa conta: a matriz congelada e as duas matrizes finas que a LoRA treina (script da figura). A abordagem avançada refaz a conta para um modelo inteiro de 7 bilhões de parâmetros.
Isso inverteu a economia de dados do campo. O ULMFiT (Howard & Ruder, 2018) e o BERT (Devlin et al., 2019) mostraram que um modelo de linguagem pré-treinado em texto sem rótulo, depois ajustado com fine-tuning, supera modelos treinados do zero em classificação de texto com uma fração dos rótulos. Tarefas que antes exigiam conjuntos rotulados enormes tornaram-se viáveis com centenas de exemplos.
3. Modelos de fundação
Escale a receita: arquiteturas transformer, pré-treino autossupervisionado (prever tokens mascarados ou o próximo token: os rótulos são grátis, então qualquer texto vira dado de treino), bilhões de parâmetros. Algo qualitativamente novo aparece. Um modelo de fundação (Bommasani et al., 2021) é um único modelo pré-treinado muito grande, adaptado a muitas tarefas: a família GPT, o Claude, o Gemini e o Llama para texto; o CLIP e seus sucessores para visão e linguagem; o Whisper para fala.
Por que escalar? Kaplan et al. (2020) mediram que a perda de teste dos modelos de linguagem cai como uma lei de potência suave no número de parâmetros, no tamanho dos dados e na computação, ao longo de várias ordens de grandeza. Essa regularidade tornou racional gastar em treinos cada vez maiores. A "Bitter Lesson" de Sutton (2019) lê a mesma história: em 70 anos, métodos gerais que aproveitam mais computação venceram o conhecimento construído à mão.
Com os grandes modelos de linguagem (LLMs), a adaptação fica ainda mais leve:
| Adaptação | Dados rotulados necessários | O que acontece |
|---|---|---|
| zero-shot | nenhum | descreva a tarefa no prompt |
| few-shot / em contexto | um punhado | mostre exemplos no prompt; nenhum peso muda |
| fine-tuning (completo / LoRA) | centenas+ | atualiza os pesos ou uma fatia de baixo posto deles |
| RAG | nenhum (precisa de documentos) | recupera trechos relevantes por busca de vizinhos mais próximos sobre embeddings e os coloca no contexto |
"Classifique este tíquete de suporte como cobrança, técnico ou outro": em 2018, um projeto de rotulagem e um classificador treinado; hoje, muitas vezes um único prompt (Brown et al., 2020, mostraram o GPT-3 fazendo tarefas novas a partir de poucos exemplos no prompt). O prompting virou o novo fit() para uma ampla classe de tarefas de linguagem. O que não mudou: você continua precisando de um conjunto de teste rotulado para saber se o prompt funciona.
4. A caixa de ferramentas clássica em um mundo de LLMs
Etapa 3. Olhe dentro da pilha moderna e esta disciplina está em toda parte:
- a camada de saída de um LLM é uma regressão softmax sobre o vocabulário; o treino é gradiente descendente em mini-batch com weight decay (uma penalidade L2, como na Ridge) sobre a entropia cruzada;
- os sistemas RAG são k-NN sobre embeddings; um banco de dados vetorial é um motor de vizinhos mais próximos aproximados;
- o modelo de recompensa do RLHF é uma regressão logística sobre pares de respostas;
- avaliar um sistema de LLM é pensar em precisão e revocação mais um desenho honesto com dados separados; perguntas de teste que vazam para os dados de treino são o problema de vazamento atual do campo;
- o BERTopic já compunha embeddings de modelos de fundação com UMAP, HDBSCAN e TF-IDF.
Onde o ML clássico ainda vence
Etapa 4. Recorra à pilha clássica (e não a um modelo de fundação) quando:
| Situação | Por que o clássico vence |
|---|---|
| Dados tabulares (churn, crédito, precificação, demanda) | o gradient boosting ainda lidera os benchmarks em tabelas de tamanho médio (Grinsztajn et al., 2022); LLMs são ruins com tabelas de números |
| Latência / custo / escala (decisões em milissegundos, bilhões de linhas) | uma regressão logística pontua uma linha em microssegundos, quase de graça |
| Decisões reguladas | razões de chances e valores SHAP podem ser mostrados a um auditor; um prompt não |
| Problemas pequenos e bem estruturados | um conjunto de 2.000 linhas precisa de controle de viés–variância, não de um trilhão de parâmetros |
| Determinismo e estabilidade | modelo fixo + entrada fixa = saída fixa; LLMs amostram |
A primeira linha tem um desafiante: o TabPFN (Hollmann et al., 2023, 2025), um transformer pré-treinado em milhões de tabelas sintéticas, que prevê uma tabela nova e pequena em uma única passada, sem treino e sem ajuste de hiperparâmetros. Em tabelas de classificação de até 10.000 linhas, vale testá-lo contra as árvores com boosting, do jeito que você testou todo modelo nesta disciplina; a abordagem avançada mostra como ele funciona e como testá-lo.
Roteamento: o que usar quando
A habilidade do profissional de fronteira é o roteamento: percepção e linguagem vão para os modelos de fundação, predição estruturada vai para a pilha clássica; sistemas reais usam as duas. Um LLM lê a reclamação em texto livre, um modelo de gradient boosting calcula o risco de churn e o MLOps monitora os dois. Na prática:
- texto livre, imagens ou som, poucos rótulos: um modelo de fundação. Comece por um prompt (zero-shot ou few-shot); com algumas centenas de rótulos, embeddings mais uma cabeça clássica (extração de atributos); faça fine-tuning (LoRA) quando nenhum dos dois for bom o bastante;
- a resposta tem de sair dos seus próprios documentos: RAG, um k-NN sobre os embeddings desses documentos alimentando o prompt;
- uma tabela de números e categorias: a pilha clássica. Gradient boosting como padrão; uma regressão logística quando a decisão precisa ser auditada ou pontuada em microssegundos;
- os dois tipos de entrada: os dois modelos. O modelo de fundação transforma o texto em atributos ou rótulos; o modelo clássico recebe esses atributos como colunas e decide;
- qualquer que seja a rota: um conjunto de teste rotulado que o sistema nunca viu e a mesma validação honesta da aula de validação cruzada.
5. Resumo: a fronteira em cinco linhas
- Toda técnica tem um lugar no mapa e a maior parte da fronteira se apoia em fichas que esta disciplina ensinou: k-NN, embeddings, regressão logística, gradiente descendente, validação cruzada.
- O transfer learning reusa um modelo pré-treinado: congelado, como extrator de atributos para uma cabeça clássica, ou ajustado com fine-tuning nos seus rótulos (a LoRA treina uma fatia fina de cada matriz).
- Os modelos de fundação são pré-treinados em tarefas autossupervisionadas, em escala; um LLM pode ser adaptado com um prompt, alguns exemplos no prompt, trechos recuperados (RAG) ou fine-tuning.
- Dentro da pilha de LLMs está esta disciplina: uma camada de saída softmax, gradiente descendente em mini-batch, busca por k-NN, um modelo de recompensa logístico e o vazamento como o problema da avaliação.
- Roteie o problema: linguagem e percepção para modelos de fundação, tabelas para a pilha clássica, sistemas reais para os dois e sempre um conjunto de teste rotulado.
| pedido | primeira ferramenta | por quê |
|---|---|---|
| texto livre, poucos rótulos | um prompt, depois embeddings + uma cabeça clássica | o conhecimento pré-treinado substitui rótulos |
| respostas a partir dos seus documentos | RAG | o k-NN sobre embeddings alimenta o prompt |
| uma tabela, custo ou auditoria importam | gradient boosting ou regressão logística | preciso, barato, explicável |
| uma tabela pequena (≤ 10.000 linhas) | boosting, com o TabPFN como desafiante | teste os dois nos mesmos folds |
Lab fundamental — rotear o problema
O problema. Uma empresa contratou você para decidir, a cada pedido novo que chega ao time de dados, que parte da caixa de ferramentas fica com ele. Antes de rotear qualquer coisa, você confere com o seu próprio código duas afirmações desta aula das quais o roteamento depende: que a metade de busca do RAG é um k-NN e que o modelo de recompensa do RLHF é uma regressão logística. As conferências usam dados artificiais minúsculos, construídos para que cada uma mostre um único mecanismo; não são benchmarks.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Esta aula não tem notebook. Abra um notebook novo no Colab (ou qualquer Python com scikit-learn) e copie o código de cada passo desta página, em ordem, numa única sessão. Os passos 1 e 4 não têm código.
- Este lab é formado pelos passos 1 a 4. O lab avançado continua a partir do passo 5.
- Todo passo começa com um Preveja: responda com a sua dupla antes de rodar a célula ou abrir a solução. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que você escreva um pequeno experimento em Python: mude uma entrada e veja o que acontece com a saída. Nada de contas à mão. A solução está recolhida logo abaixo: tente antes de abri-la.
- Ritmo sugerido: passo 1 em 5 min; passo 2 e sua simulação em 10 min; passo 3 e sua simulação em 10 min; passo 4 em 5 min.
Passo 1 — ache a sua disciplina no mapa
Preveja. De todas as fichas do mapa, em qual delas se apoiam mais fichas: num modelo, numa representação ou num jeito de validar? Dê um palpite antes de clicar.
Use o mapa: o anel verde mostra o que se apoia na ficha clicada, e o painel lista essas fichas em leva a. Clique em k-vizinhos mais próximos, depois em Regressão logística e softmax, depois em Perceptron, MLP e retropropagação, Embeddings densos e Validação cruzada e vazamento de dados e conte os anéis verdes de cada uma.
Solução
O mapa tem 69 técnicas em 14 grupos: 38 vistas nesta disciplina, 31 além dela. A ficha em que mais fichas se apoiam é Perceptron, MLP e retropropagação (9 se apoiam nela: redes convolucionais e recorrentes, transformers, aprendizado autossupervisionado, modelos generativos, redes em grafos, aprendizado por reforço, busca de arquitetura neural, transfer learning), seguida de Embeddings densos e de Validação cruzada e vazamento de dados, com 7 cada. O k-NN e a regressão logística têm 5 cada: o k-NN leva ao t-SNE e ao UMAP, ao DBSCAN, à busca aproximada de vizinhos mais próximos, às redes em grafos e ao RAG; a regressão logística leva aos SVMs, ao MLP, aos transformers, aos modelos interpretáveis e ao alinhamento (RLHF). As duas ideias mais reusadas depois da rede são uma representação e um jeito de validar, não um modelo: o que você aprendeu sobre medir com honestidade é tão central para a fronteira quanto qualquer algoritmo.
Passo 2 — a metade de busca do RAG é um k-NN
Preveja. A pergunta abaixo tem em comum com um dos seis trechos as palavras choose (escolher) e k-NN e não tem nenhuma palavra em comum com a maioria dos outros. Que trecho volta em primeiro lugar? Quão parecido você espera que seja o segundo?
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.neighbors import NearestNeighbors

passages = [
    "k-NN predicts from the k closest training rows; choose k by cross-validation.",
    "Gradient boosting adds small trees one at a time, each fitted to the errors of the previous ones.",
    "Fit the scaler on the training split only, or information leaks from the test set.",
    "Logistic regression turns a score into a probability with the sigmoid.",
    "A random forest averages many deep trees, each grown on a bootstrap sample.",
    "PCA rotates the data onto the directions of largest variance.",
]
vec = TfidfVectorizer()
P = vec.fit_transform(passages)                      # um vetor esparso por trecho
index = NearestNeighbors(n_neighbors=2, metric='cosine').fit(P)

def retrieve(question):
    dist, idx = index.kneighbors(vec.transform([question]))
    for d, i in zip(dist[0], idx[0]):
        print(f"{1 - d:.2f}  {passages[i]}")

retrieve("How do I choose k in k-NN?")
0.46  k-NN predicts from the k closest training rows; choose k by cross-validation.
0.00  Gradient boosting adds small trees one at a time, each fitted to the errors of the previous ones.
A pergunta vira um vetor e o kneighbors devolve os trechos cujos vetores estão mais próximos pelo cosseno: é o NearestNeighbors da aula de k-NN, sobre os vetores TF-IDF da aula de representação de texto. O trecho do k-NN volta com similaridade de cosseno 0,46; o segundo colocado tem 0,00, porque não divide nenhuma palavra com a pergunta e, no TF-IDF, dois textos sem palavra em comum são ortogonais. Um sistema RAG faz exatamente isso e depois cola os trechos recuperados no prompt do LLM, para que a resposta possa citar os seus documentos. Sistemas reais usam embeddings densos e um índice aproximado em vez de TF-IDF e força bruta; a simulação mostra por quê.
Simulação: a mesma pergunta, com outras palavras. Pergunte a mesma coisa sem as palavras do trecho: "How many neighbors should vote?" (quantos vizinhos devem votar?). Que trecho volta agora e por quê?
Solução
0.32  A random forest averages many deep trees, each grown on a bootstrap sample.
0.00  Gradient boosting adds small trees one at a time, each fitted to the errors of the previous ones.
O buscador agora devolve o trecho da random forest, com 0,32, só porque ele contém a palavra many (muitos). O trecho do k-NN, que responde à pergunta, não divide nenhuma palavra com ela (neighbors e vote não aparecem nele), então sua similaridade é 0. O TF-IDF casa palavras, não significados. É por isso que os sistemas RAG buscam com sentence embeddings densos, nos quais "vizinhos que votam" cai perto de "as k linhas de treino mais próximas": o buscador continua sendo um k-NN; só os vetores mudam. Uma resposta de RAG não pode ser melhor que os trechos que o seu k-NN recupera.
Passo 3 — o modelo de recompensa é uma regressão logística
Preveja. Nos dados abaixo, os votos das pessoas dependem de a resposta estar correta e, um pouco, de ser educada, mas não do seu tamanho. Uma regressão logística sem intercepto é ajustada sobre as diferenças entre os atributos das duas respostas de cada par. Que pesos você espera que ela encontre? Por que ela pode dispensar o intercepto?
from sklearn.linear_model import LogisticRegression

rng = np.random.default_rng(0)
n_pairs = 2000


def answers(n):
    # cada resposta descrita por três atributos
    return np.column_stack([rng.integers(0, 2, n),      # correta: 0 ou 1
                            rng.random(n),              # educada: de 0 a 1
                            rng.random(n) * 5])         # tamanho: de 0 a 5 centenas de palavras


A, B = answers(n_pairs), answers(n_pairs)
w_people = np.array([3.0, 1.0, 0.0])                    # o que as pessoas valorizam: correção, um pouco de educação, não tamanho
p_A = 1 / (1 + np.exp(-(A - B) @ w_people))             # P(A preferida a B) = sigmoide(r_A - r_B)
prefers_A = (rng.random(n_pairs) < p_A).astype(int)     # um voto humano por par
print(f"{n_pairs} compared pairs, A preferred in {prefers_A.mean():.0%} of them")

reward = LogisticRegression(fit_intercept=False, C=np.inf).fit(A - B, prefers_A)
print("weights of the reward model:", reward.coef_[0].round(2))

best, worst = np.array([[1, 1.0, 1.0]]), np.array([[0, 0.0, 1.0]])
print(f"P(correct and polite beats wrong and rude) = {reward.predict_proba(best - worst)[0, 1]:.2f}")
2000 compared pairs, A preferred in 50% of them
weights of the reward model: [2.98 1.12 0.03]
P(correct and polite beats wrong and rude) = 0.98
A recompensa de uma resposta é uma soma ponderada dos seus atributos, \(r = w \cdot x\), e a probabilidade de as pessoas preferirem A a B é \(\sigma(r_A - r_B) = \sigma(w \cdot (x_A - x_B))\): uma regressão logística sobre a diferença entre as duas respostas, ajustada com entropia cruzada (C=np.inf desliga a penalidade, como na aula de regressão logística). A partir de 2.000 votos, ela recupera os pesos que as pessoas usaram, 2,98, 1,12 e 0,03 contra 3, 1 e 0. Nenhum intercepto é necessário e nenhum deveria estar lá: trocar A por B tem de transformar \(p\) em \(1 - p\), o que \(\sigma(-z) = 1 - \sigma(z)\) só garante quando não há termo constante (um intercepto favoreceria a resposta mostrada primeiro). No RLHF, os atributos não são três colunas, mas a representação interna de um LLM, e o modelo de recompensa é uma rede com essa mesma saída logística; o LLM é então ajustado para produzir respostas que o modelo de recompensa pontua alto.
Simulação: eleitores que gostam de respostas longas. Refaça os votos com os mesmos pares, mas agora com pessoas que também gostam de respostas longas: pesos [3.0, 1.0, 0.8]. Reajuste o modelo de recompensa. Qual a chance de uma resposta curta e correta (50 palavras) vencer uma longa e errada (500 palavras, igualmente educada), segundo o modelo de recompensa justo e segundo o novo?
Solução
rng = np.random.default_rng(0)                          # mesma semente: os mesmos pares e os mesmos sorteios
A, B = answers(n_pairs), answers(n_pairs)
w_biased = np.array([3.0, 1.0, 0.8])
p_A = 1 / (1 + np.exp(-(A - B) @ w_biased))
prefers_A = (rng.random(n_pairs) < p_A).astype(int)
biased = LogisticRegression(fit_intercept=False, C=np.inf).fit(A - B, prefers_A)
print("weights, length-biased votes:", biased.coef_[0].round(2))
short_right, long_wrong = np.array([[1, 1.0, 0.5]]), np.array([[0, 1.0, 5.0]])
print(f"P(short and correct beats long and wrong): fair {reward.predict_proba(short_right - long_wrong)[0, 1]:.2f}"
      f" · biased {biased.predict_proba(short_right - long_wrong)[0, 1]:.2f}")
weights, length-biased votes: [3.02 1.03 0.76]
P(short and correct beats long and wrong): fair 0.95 · biased 0.40
O modelo de recompensa aprende o viés com fidelidade: um peso de 0,76 no tamanho. Com votos justos, a resposta curta e correta vence com probabilidade 0,95; com os votos enviesados, 0,40: o modelo de recompensa agora prefere a resposta longa e errada, porque 450 palavras a mais valem mais que estar certo. Um LLM ajustado para maximizar essa recompensa aprende a escrever longo. A regressão logística não errou em nada: ela mediu os votos que recebeu. É por isso que a qualidade das comparações humanas (a ficha de IA centrada em dados do mapa) e o próprio alinhamento estão na lista de problemas em aberto.
Passo 4 — rotear seis pedidos
Preveja. Para cada pedido abaixo, decida com a sua dupla: um modelo de fundação, a pilha clássica ou os dois? Escreva uma frase dizendo por quê e como você testaria a escolha antes de abrir a solução.
| # | pedido |
|---|---|
| 1 | Separar 300 e-mails rotulados de clientes, em português, em 5 intenções; o sistema precisa estar no ar na semana que vem |
| 2 | Pontuar 50 milhões de transações de cartão toda noite, em busca de fraude, com orçamento apertado |
| 3 | Aprovar ou negar crédito a partir de uma tabela de 60.000 linhas; o regulador precisa ver por que cada pessoa foi negada |
| 4 | Responder às perguntas dos funcionários sobre o manual de RH de 400 páginas da empresa |
| 5 | Prever o rendimento de um processo químico a partir de uma tabela de 600 linhas de medidas de laboratório |
| 6 | Marcar pedidos de indenização de seguro fraudulentos a partir de 30 colunas numéricas mais o relato em texto livre do acidente |
Solução
| # | rota | por quê | como testar |
|---|---|---|---|
| 1 | modelo de fundação | linguagem, poucos rótulos, pouco tempo: um prompt few-shot ou embeddings dos e-mails mais uma regressão logística treinada nos 300 rótulos | separar parte dos 300 como conjunto de teste rotulado; precisão e revocação por intenção |
| 2 | clássico | uma tabela, bilhões de pontuações por ano, milissegundos cada: gradient boosting ou regressão logística | validação em ordem temporal; precisão e revocação no limiar escolhido, já que fraude é rara |
| 3 | clássico | tabular e regulado: regressão logística ou boosting com SHAP, cujas razões podem ser mostradas | validação cruzada e depois um teste; explicações conferidas por uma pessoa |
| 4 | modelo de fundação, com RAG | as respostas estão nos seus documentos: gerar embeddings dos trechos do manual, recuperar os mais próximos (um k-NN) e colocá-los no prompt | um conjunto rotulado de perguntas com o trecho que responde cada uma: ele é recuperado (revocação em k)? a resposta está certa? |
| 5 | clássico, com o TabPFN como desafiante | uma tabela pequena: um modelo regularizado ou boosting com validação cruzada; com 600 linhas, um modelo de fundação tabular também vale o teste | os mesmos folds para todo candidato, comparados fold a fold |
| 6 | os dois | o texto passa por um modelo de fundação (embeddings ou um rótulo extraído) e vira colunas; o boosting decide a partir de todas elas | os atributos de texto têm de ser calculados dentro da validação cruzada, como qualquer pré-processamento, para evitar vazamento |
Só um pedido em seis é puramente trabalho de modelo de fundação e mais um precisa dos dois: a maioria dos problemas que chegam a um time de dados ainda são tabelas. Toda linha da última coluna precisa de um conjunto de teste rotulado, qualquer que seja a rota.
Para fechar a parte fundamental. Em uma frase cada: (1) cite duas peças desta disciplina que estão dentro de um sistema de LLM e diga onde; (2) o que separa extração de atributos, fine-tuning e prompting? (3) Por que um prompt continua precisando de um conjunto de teste rotulado?
Sua vez (fundamental)
Para casa:
- Três fichas tracejadas. Escolha três fichas tracejadas no mapa. Para cada uma, escreva no que ela se apoia e em que aula desta disciplina você aprendeu isso.
- Busca densa. Refaça o passo 2 com os sentence embeddings da aula de sentence embeddings em vez do TF-IDF (o
NearestNeighbors(metric='cosine')funciona igual sobre vetores densos). A pergunta "How many neighbors should vote?" agora acha o trecho do k-NN? - Um intercepto para a primeira resposta. No passo 3, faça as pessoas preferirem um pouco a resposta mostrada primeiro (some 0,5 à diferença de escores em
p_A) e ajuste o modelo de recompensa comfit_intercept=True. O que o intercepto aprende?
Abordagem avançada
A parte fundamental situou a fronteira no mapa e encaminhou problemas para a ferramenta certa. Esta parte abre três caixas da fronteira: a LoRA, contada para um modelo inteiro, e por que uma fatia fina de cada matriz pode bastar; o TabPFN, o desafiante das árvores com boosting em tabelas pequenas, e como testá-lo; e os problemas em aberto. Os blocos de código são independentes dos da parte fundamental.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. ajustar uma fatia fina; 2. desafiar as árvores; 3. encarar os problemas em aberto. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Ajustar uma fatia finaa LoRA contada camada por camada; por que baixo posto basta
- Desafiar as árvorespor que as árvores lideram nas tabelas; TabPFN; um teste justo
- Encarar os problemas em abertoconfiabilidade, avaliação, alinhamento, eficiência, governança
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
6. LoRA: fine-tuning de uma fatia fina
Etapa 1. Uma camada de uma rede calcula \(h = Wx\), com \(W\) uma matriz de \(d_{saída} \times d_{entrada}\) pesos pré-treinados. O fine-tuning completo aprende uma matriz nova \(W + \Delta W\), com \(\Delta W\) livre: \(d_{saída} \cdot d_{entrada}\) números para treinar, para cada matriz do modelo. A LoRA (low-rank adaptation, adaptação de baixo posto; Hu et al., 2022) mantém \(W\) congelada e obriga a atualização a ser o produto de duas matrizes finas:
Só \(B\) e \(A\) são treinadas: \(r\,(d_{entrada} + d_{saída})\) números em vez de \(d_{entrada}\, d_{saída}\). \(A\) começa aleatória e \(B\) começa em zero, então \(BA = 0\) e o treino parte exatamente do modelo pré-treinado; Hu et al. também multiplicam \(BA\) por uma constante \(\alpha / r\), para que mudar \(r\) não mude o tamanho da atualização. Depois do treino, \(BA\) pode ser somada a \(W\) uma única vez e o modelo adaptado não custa nada a mais para rodar.
Contando um modelo inteiro
A seção 2 contou uma matriz \(4096 \times 4096\). Um modelo inteiro tem centenas de matrizes de dois formatos. O código as conta para um modelo com o formato publicado do Llama 2 7B (Touvron et al., 2023): 32 camadas, cada uma com quatro matrizes de atenção \(4096 \times 4096\) (\(q\), \(k\), \(v\), \(o\)) e três matrizes de MLP entre 4.096 e 11.008 unidades, mais os embeddings de um vocabulário de 32.000 tokens:
d, d_ff, n_layers, vocab = 4096, 11008, 32, 32000      # o formato publicado do Llama 2 7B

# cada matriz de pesos de uma camada transformer, como (linhas, colunas)
layer = {'q': (d, d), 'k': (d, d), 'v': (d, d), 'o': (d, d),               # atenção
         'gate': (d, d_ff), 'up': (d, d_ff), 'down': (d_ff, d)}             # MLP
per_layer = sum(r * c for r, c in layer.values()) + 2 * d                  # + dois vetores de normalização
total = n_layers * per_layer + 2 * vocab * d + d                           # + embeddings, cabeça de saída, norma final
print(f"one layer {per_layer:,} · whole model {total:,}")


def lora(adapted, r):
    # a LoRA treina B (linhas x r) e A (r x colunas) para cada matriz adaptada de cada camada
    return n_layers * sum(r * (layer[m][0] + layer[m][1]) for m in adapted)


for adapted in (['q', 'v'], ['q', 'k', 'v', 'o'], list(layer)):
    n = lora(adapted, r=8)
    print(f"LoRA r=8 on {'+'.join(adapted):22s} {n:>11,} trained · {n / total:.3%} of the model")
one layer 202,383,360 · whole model 6,738,415,616
LoRA r=8 on q+v                      4,194,304 trained · 0.062% of the model
LoRA r=8 on q+k+v+o                  8,388,608 trained · 0.124% of the model
LoRA r=8 on q+k+v+o+gate+up+down    19,988,480 trained · 0.297% of the model
O modelo tem 6.738.415.616 pesos, o "7B" do nome; uma camada guarda 202.383.360 deles, dois terços no MLP. Hu et al. adaptaram só \(q\) e \(v\) e viram que isso bastava nas tarefas deles: no posto 8, são 4.194.304 números treinados, 0,062% do modelo. Adaptar todas as matrizes de todas as camadas ainda treina menos de 0,3%.
O simulador percorre a mesma conta, uma peça do modelo por passo: uma matriz, a atenção de uma camada, a camada inteira, 32 camadas, os embeddings e, por fim, a memória de que o treino precisa (o assunto do passo 5 do lab). Antes de avançar, preveja: conforme as peças se somam, a fração que a LoRA treina cresce, diminui ou fica igual? Mude o posto e as matrizes adaptadas e veja todas as contas acompanharem.
Por que uma fatia fina pode bastar
O produto \(BA\) tem posto no máximo \(r\): faça o treino o que fizer, a LoRA só consegue atualizações de posto \(\le r\). Ela funciona quando a atualização de que o fine-tuning precisa é próxima de baixo posto. Aghajanyan et al. (2021) acharam que o fine-tuning de um modelo de linguagem pré-treinado tem dimensão intrínseca baixa: em algumas tarefas, treinar algumas centenas de números, projetados no espaço inteiro de pesos, chega a 90% do desempenho do fine-tuning completo. Hu et al. (2022) construíram a LoRA sobre a hipótese de que as atualizações dos pesos têm posto intrínseco baixo, que os experimentos deles sustentaram: postos de 1 a 8 foram competitivos com o fine-tuning completo nos benchmarks deles. É um fato empírico sobre modelos pré-treinados, não uma lei: o passo 6 do lab mostra o que acontece quando a atualização não é de baixo posto.
7. Modelos de fundação tabulares: TabPFN
Etapa 2. A regra de roteamento manda tabelas para a pilha clássica. Este é o único ponto em que um modelo de fundação desafia essa regra de frente.
Por que as árvores ainda lideram nas tabelas
Grinsztajn, Oyallon & Varoquaux (2022) compararam modelos em 45 conjuntos tabulares de cerca de 10.000 linhas e acharam os ensembles de árvores à frente das redes profundas. Eles atribuíram a diferença a três propriedades das tabelas: as funções-alvo são irregulares e as redes tendem a funções suaves; as tabelas têm muitas colunas pouco informativas, que atrapalham mais as redes que as árvores; e as colunas têm significado próprio (idade, renda), então misturá-las, como faz a primeira camada de uma rede, joga fora uma estrutura que as perguntas de uma coluna só de uma árvore preservam.
Uma passada em vez de um ajuste
O TabPFN (Hollmann et al., 2023, 2025) segue outro caminho. Ele é uma prior-data fitted network (rede ajustada a dados de uma priori; Müller et al., 2022): um transformer pré-treinado, uma única vez e offline, em milhões de conjuntos de dados sintéticos, sorteados de uma família ampla de processos aleatórios de geração de dados. Cada exemplo de pré-treino é uma tabela pequena inteira: as linhas de treino com seus rótulos e algumas linhas de teste sem eles; o alvo são os rótulos das linhas de teste. Para usá-lo na sua tabela, você dá como entrada as suas linhas de treino e as suas linhas novas e ele devolve as previsões em uma única passada: nenhum passo de gradiente nos seus dados, nenhuma busca de hiperparâmetros. É aprendizado em contexto, como no few-shot, com uma tabela no lugar do prompt; Müller et al. mostraram que uma rede assim aproxima a previsão bayesiana sob a priori com que foi treinada.
Em conjuntos de classificação de até 10.000 linhas, a versão de 2025 superou, em 2,8 segundos, um ensemble dos modelos de referência mais fortes (árvores com boosting entre eles) ajustado por 4 horas. O preço é pago na hora de prever: a tabela de treino inteira faz parte da entrada de cada previsão, então o modelo é grande e lento para rodar perto de uma árvore já ajustada, e ele foi feito para tabelas pequenas (a versão de 2025 mira até 10.000 linhas e 500 atributos). Acima desse tamanho (e sempre que a latência importa), as árvores com boosting continuam sendo o padrão.
Testando o desafiante
Teste o desafiante como você testou todo modelo nesta disciplina: mesmos folds, mesma métrica, comparação pareada e no tamanho da sua tabela. Quem vence depende do tamanho: o passo 7 do lab mostra um modelo linear regularizado vencendo o gradient boosting numa amostra de 300 linhas do California housing e perdendo em todos os folds a partir de 1.000 linhas. Um resultado de benchmark ("o melhor até 10.000 linhas") é uma afirmação sobre uma faixa de tamanhos, medida nas tabelas dos outros; a sua validação é o único teste que conta.
8. Problemas em aberto — para onde este campo vai
Etapa 3. O mapa tem fichas tracejadas porque o campo não está pronto. Estes problemas estão em aberto:
- Alucinação e confiabilidade: falsidades fluentes. Calibração em escala de fronteira: um modelo deveria saber quando não sabe.
- Avaliação: os benchmarks saturam em um ou dois anos e vazam para os dados de treino; medir com honestidade é uma corrida armamentista (Validação, em escala maior).
- Alinhamento e segurança: fazer os sistemas perseguirem os objetivos que pretendemos; o RLHF e seus sucessores são respostas parciais. A simulação do passo 3 do lab mostrou um modelo de recompensa aprendendo com fidelidade um viés dos seus eleitores.
- Eficiência: destilação, quantização, modelos pequenos especializados contra generalistas gigantes.
- Proveniência dos dados, viés e governança: as questões de ética da aula de panorama do ML, agora industrializadas e reguladas (AI Act europeu; no Brasil, a LGPD e o projeto de lei de IA PL 2338/2023, aprovado pelo Senado em dezembro de 2024 e enviado à Câmara dos Deputados).
- Causalidade: a predição responde "o que vai acontecer"; decisões precisam de "o que acontece se agirmos". O ML causal une as duas coisas.
- Agentes: modelos que planejam, chamam ferramentas e agem. Como avaliá-los e mantê-los seguros está em grande parte sem solução.
9. Resumo: por dentro das ferramentas da fronteira
- A LoRA treina \(B\) e \(A\), \(r\,(d_{entrada} + d_{saída})\) números por matriz adaptada, com \(W\) congelada: 0,062% de um modelo de 7 bilhões de parâmetros no posto 8 em \(q\) e \(v\).
- Ela economiza mais memória e armazenamento que computação: a cópia congelada ainda precisa ficar na memória, mas cada tarefa é um adaptador pequeno.
- Ela funciona porque as atualizações do fine-tuning são próximas de baixo posto em modelos pré-treinados; uma atualização que não é de baixo posto não cabe numa fatia fina.
- O TabPFN prevê uma tabela pequena em uma única passada de um transformer pré-treinado em tabelas sintéticas; as árvores com boosting continuam o padrão em tabelas maiores e com latência apertada.
- Um desafiante é testado como qualquer modelo: a sua tabela, o seu tamanho, os mesmos folds, fold a fold.
| ferramenta | o que ela muda | o que não muda |
|---|---|---|
| LoRA | treina menos de 0,3% dos pesos; um adaptador pequeno por tarefa | você continua precisando de rótulos e de um conjunto de teste |
| TabPFN | nenhum treino nem ajuste em tabelas pequenas | a comparação nos seus folds decide |
| modelos de fundação em geral | linguagem e percepção com poucos rótulos | vazamento, calibração e viés, agora em escala |
Lab avançado — contar, comprimir, testar
O problema. O seu time quer fazer fine-tuning de um modelo de 7 bilhões de parâmetros para uma tarefa de atendimento ao cliente e alguém propõe trocar as árvores com boosting de um modelo tabular pequeno por um modelo de fundação tabular. Antes da reunião, você confere três coisas com código: quanto o fine-tuning custa em memória, quando uma atualização de baixo posto basta e quanto o vencedor de uma comparação depende do tamanho da tabela.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- O mesmo notebook (ou um novo): o passo 5 usa
totalelorado bloco de código da seção 6; rode esse bloco primeiro. Os passos 6 e 7 são independentes. - Todo passo começa com um Preveja: responda antes de rodar.
- O passo 7 ajusta 50 modelos; leva uns dois minutos.
- Ritmo sugerido: passo 5 e sua simulação em 10 min; passo 6 e sua simulação em 10 min; passo 7 em 10 min.
Passo 5 — quanto o fine-tuning custa em memória
Preveja. A LoRA treina 0,062% dos números do modelo. Ela precisa de 0,062% da memória do fine-tuning completo? De muito mais? Por quê?
GB = 1e9
trained_bytes = 16          # Adam em precisão mista: peso e gradiente em 16 bits, cópia mestra e dois momentos em 32 bits
frozen_bytes = 2            # um peso congelado só é lido: uma cópia em 16 bits

full = total * trained_bytes
n_lora = lora(['q', 'v'], r=8)
with_lora = total * frozen_bytes + n_lora * trained_bytes
print(f"full fine-tuning: {full / GB:6.1f} GB · LoRA r=8 on q+v: {with_lora / GB:5.1f} GB")
print(f"saved per task:   {total * 2 / GB:6.1f} GB (a full copy) · {n_lora * 2 / 1e6:.1f} MB (an adapter)")
full fine-tuning:  107.8 GB · LoRA r=8 on q+v:  13.5 GB
saved per task:     13.5 GB (a full copy) · 8.4 MB (an adapter)
Treinar com o otimizador Adam em precisão mista guarda 16 bytes por número treinado (a conta de Rajbhandari et al., 2020; as ativações vêm por cima e dependem do lote). O fine-tuning completo precisa de 107,8 GB, mais do que cabe num único acelerador de 80 GB. Com a LoRA, 13,5 GB: 8 vezes menos, não 1.600 vezes, porque a cópia congelada do modelo em 16 bits ainda precisa estar na memória e agora ela é quase tudo. A outra economia é de armazenamento: cada tarefa nova é um adaptador de 8,4 MB em vez de uma cópia de 13,5 GB do modelo, então um único modelo base pode servir centenas de tarefas.
Simulação: encolher a parte congelada. A QLoRA (Dettmers et al., 2023) guarda os pesos congelados em 4 bits (meio byte) e treina a LoRA por cima. Quanta memória isso exige? E quanto o posto \(r\) muda a memória, de 1 a 64?
Solução
four_bit = total * 0.5 + n_lora * trained_bytes
print(f"QLoRA (frozen weights in 4 bits): {four_bit / GB:.1f} GB")
for r in (1, 4, 8, 16, 64):
    print(f"r={r:<3d} {lora(['q', 'v'], r):>11,} trained · {(total * frozen_bytes + lora(['q', 'v'], r) * trained_bytes) / GB:.2f} GB")
QLoRA (frozen weights in 4 bits): 3.4 GB
r=1       524,288 trained · 13.49 GB
r=4     2,097,152 trained · 13.51 GB
r=8     4,194,304 trained · 13.54 GB
r=16    8,388,608 trained · 13.61 GB
r=64   33,554,432 trained · 14.01 GB
Em 4 bits, o modelo congelado ocupa 3,4 GB: um modelo de 7 bilhões de parâmetros pode passar por fine-tuning numa única placa de vídeo de consumo. O posto quase não importa para a memória: de \(r = 1\) a \(r = 64\), os números treinados crescem 64 vezes e a memória vai de 13,49 para 14,01 GB. Quando a atualização é uma fatia fina, o que custa memória é o modelo congelado; por isso a economia seguinte veio de comprimi-lo.
Passo 6 — quando uma fatia fina basta?
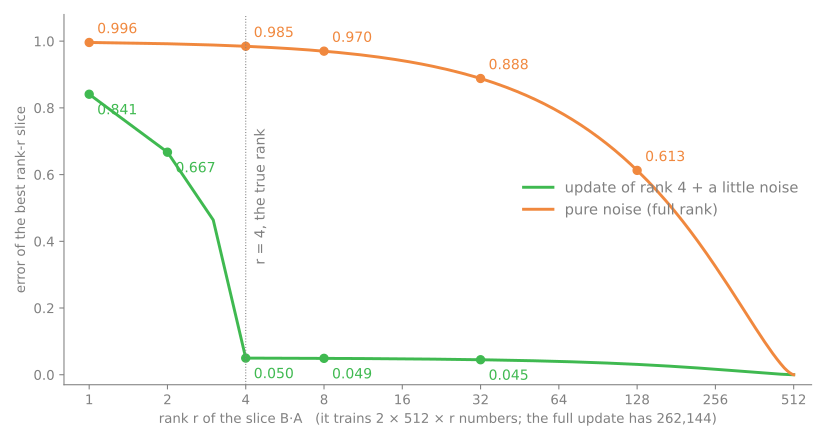
Preveja. A atualização delta abaixo tem posto 4, mais um pouco de ruído. A função mede o melhor que qualquer \(B \cdot A\) de posto \(r\) consegue (a SVD truncada, pelo teorema de Eckart–Young), como o tamanho do que sobra em relação ao tamanho da atualização. Como esse erro muda de \(r = 1\) a \(r = 32\)?
import numpy as np

rng = np.random.default_rng(0)
d = 512
# uma atualização que tem posto 4 de verdade, mais um pouco de ruído
delta = rng.normal(size=(d, 4)) @ rng.normal(size=(4, d)) + 0.1 * rng.normal(size=(d, d))


def best_rank_r_error(M, r):
    # o melhor que qualquer B (d x r) vezes A (r x d) consegue: manter os r maiores valores singulares (Eckart-Young)
    U, s, Vt = np.linalg.svd(M)
    approx = (U[:, :r] * s[:r]) @ Vt[:r]
    return np.linalg.norm(M - approx) / np.linalg.norm(M)


print(f"full update: {d * d:,} numbers")
for r in (1, 2, 4, 8, 32):
    print(f"r={r:<3d} {2 * d * r:>7,} numbers · error {best_rank_r_error(delta, r):.3f}")
full update: 262,144 numbers
r=1     1,024 numbers · error 0.841
r=2     2,048 numbers · error 0.667
r=4     4,096 numbers · error 0.050
r=8     8,192 numbers · error 0.049
r=32   32,768 numbers · error 0.045
O erro cai devagar em \(r = 1\) e 2, depois despenca para 0,050 em \(r = 4\), o posto verdadeiro, e para aí: o que sobra (0,049, 0,045) é o ruído, que nenhuma fatia de baixo posto captura e nenhuma precisa capturar. Com 4.096 números em vez de 262.144 (1,6%), a fatia reproduz a atualização a menos do ruído. Um \(r\) maior só compra mais números. É nessa situação que a LoRA aposta.
Simulação: uma atualização sem estrutura. Troque delta por uma matriz de ruído puro, rng.normal(size=(d, d)), que tem posto cheio. Qual o erro agora em \(r = 1, 4, 8, 32\) e \(128\)?
Solução
noise = rng.normal(size=(d, d))
for r in (1, 4, 8, 32, 128):
    print(f"r={r:<3d} {2 * d * r:>7,} numbers · error {best_rank_r_error(noise, r):.3f}")
r=1     1,024 numbers · error 0.996
r=4     4,096 numbers · error 0.985
r=8     8,192 numbers · error 0.970
r=32   32,768 numbers · error 0.888
r=128 131,072 numbers · error 0.613
Agora não há estrutura para aproveitar: o posto 8 deixa 97% da atualização de fora e mesmo o posto 128, com metade dos números da matriz inteira (131.072 contra 262.144), deixa 61%. Uma fatia fina só aprende uma atualização próxima de baixo posto. A LoRA funciona em grandes modelos de linguagem porque as atualizações de que o fine-tuning precisa ali são, empiricamente, próximas de baixo posto; numa tarefa muito distante do que o modelo viu no pré-treino, um \(r\) pequeno pode não bastar.
A figura desenha os dois erros para todo posto de 1 a 512, com os valores deste passo marcados (script da figura):
Passo 7 — quem vence depende do tamanho da tabela
Preveja. Em amostras de 100 a 10.000 linhas do California housing, um modelo linear regularizado (RidgeCV, com imputação e escalonamento) é comparado com o gradient boosting nos mesmos cinco folds. Com 100 linhas, qual você espera que vença? E com 10.000?
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.impute import SimpleImputer
from sklearn.linear_model import RidgeCV
from sklearn.model_selection import KFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

housing = pd.read_csv('https://raw.githubusercontent.com/hsandmann/biblio/refs/heads/main/ml/aula02/housing.csv')
X_all = housing.drop(columns=['median_house_value', 'ocean_proximity'])
y_all = housing['median_house_value']
print(X_all.shape)

linear = make_pipeline(SimpleImputer(strategy='median'), StandardScaler(), RidgeCV())
boosting = HistGradientBoostingRegressor(random_state=0)
cv = KFold(n_splits=5, shuffle=True, random_state=0)

for n in (100, 300, 1000, 3000, 10000):
    sample = X_all.sample(n, random_state=0)
    X_n, y_n = sample, y_all.loc[sample.index]
    rmse = {}
    for name, model in (('linear', linear), ('boosting', boosting)):
        rmse[name] = -cross_val_score(model, X_n, y_n, cv=cv, scoring='neg_root_mean_squared_error')
    wins = (rmse['boosting'] < rmse['linear']).sum()
    print(f"n={n:>6,}  linear {rmse['linear'].mean():>7,.0f}  boosting {rmse['boosting'].mean():>7,.0f}"
          f"  boosting wins {wins} of 5 folds")
(20640, 8)
n=   100  linear  60,842  boosting  71,432  boosting wins 1 of 5 folds
n=   300  linear  64,830  boosting  71,952  boosting wins 0 of 5 folds
n= 1,000  linear  69,439  boosting  58,184  boosting wins 5 of 5 folds
n= 3,000  linear  69,139  boosting  53,752  boosting wins 5 of 5 folds
n=10,000  linear  70,025  boosting  49,547  boosting wins 5 of 5 folds
O vencedor troca entre 300 e 1.000 linhas. Com 100 e 300 linhas, o modelo linear tem o menor RMSE (em dólares de valor mediano das casas) e o boosting vence no máximo um fold: com tão poucas linhas, um modelo flexível tem mais variância que sinal para ajustar. A partir de 1.000 linhas, o boosting vence todos os folds e o seu erro continua caindo (58.184 → 49.547), enquanto o do modelo linear fica perto de 70.000, o limite de uma reta. Quem decide é o equilíbrio entre viés e variância e o tamanho da tabela o desloca. É por isso que a afirmação de um modelo de fundação tabular é uma afirmação sobre uma faixa de tamanhos e por isso o único teste que resolve a questão é o feito na sua tabela, no seu tamanho, nos mesmos folds, fold a fold.
Para fechar a aula. Em uma frase cada: (1) por que a LoRA corta a memória do fine-tuning 8 vezes e não 1.600 vezes? (2) Quando uma atualização de posto 8 deixaria de adaptar um modelo? (3) Como você decidiria entre o TabPFN e as árvores com boosting para uma tabela de 5.000 linhas?
Sua vez (avançado)
Para casa, com mais tempo:
- LoRA em tudo. Com o código da seção 6 e a conta de memória do passo 5, quantos números a LoRA treina com \(r = 16\) nas sete matrizes de cada camada e quanta memória ela exige, com os pesos congelados em 16 bits e em 4 bits?
- Um terceiro concorrente. No passo 7, acrescente a tabela inteira (
n = 20640) e umRandomForestRegressor(n_estimators=200, random_state=0, n_jobs=-1). Em que tamanhos cada modelo vence, fold a fold? - Leia o desafiante. Leia Hollmann et al. (2025), nas referências, e liste os tipos de tabela para os quais o TabPFN não foi feito. Para cada um, diga que modelo desta disciplina você usaria no lugar.
Para onde ir a partir daqui
- Deep learning, em profundidade: a disciplina do Insper Artificial Neural Networks and Deep Learning (CNNs, transformers, modelos generativos); Prince, Understanding Deep Learning (2023, grátis on-line).
- A visão probabilística: Murphy, Probabilistic Machine Learning (2022, grátis on-line), para os modelos bayesianos, os processos gaussianos e a incerteza que esta disciplina só tocou.
- LLMs, na prática: os cursos da Hugging Face (tokenizadores, fine-tuning, RAG); a série Neural Networks: Zero to Hero de Karpathy, que constrói um GPT do zero.
- Ler artigos: escolha uma ficha tracejada no mapa, leia o artigo clássico dela e depois procure um artigo recente que o cite. Os links do mapa são os pontos de partida.
A tese da disciplina, uma última vez
Toda ideia "nova" que você encontrar é uma composição de coisas que agora entende: perdas, gradientes, regularização, embeddings, vizinhos, ensembles, validação honesta. A fronteira se move; os fundamentos se acumulam. Aprenda as partes e nenhum todo será uma caixa-preta.
Referências
O mapa traz de uma a três referências por técnica. Estas são as que o texto desta aula usa.
- Sutton, R. "The Bitter Lesson." Ensaio (2019). Link
- Vaswani, A. et al. "Attention Is All You Need." NeurIPS (2017). arXiv:1706.03762
- Howard, J.; Ruder, S. "Universal Language Model Fine-tuning for Text Classification." ACL (2018). arXiv:1801.06146
- Devlin, J.; Chang, M.-W.; Lee, K.; Toutanova, K. "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding." NAACL-HLT (2019). arXiv:1810.04805
- Kaplan, J. et al. "Scaling Laws for Neural Language Models." arXiv (2020). arXiv:2001.08361
- Brown, T. B. et al. "Language Models are Few-Shot Learners." NeurIPS (2020) — GPT-3. arXiv:2005.14165
- Lewis, P. et al. "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks." NeurIPS (2020). arXiv:2005.11401
- Rajbhandari, S.; Rasley, J.; Ruwase, O.; He, Y. "ZeRO: Memory Optimizations Toward Training Trillion Parameter Models." SC20 (2020) — os 16 bytes por parâmetro treinado do Adam em precisão mista. arXiv:1910.02054
- Aghajanyan, A.; Gupta, S.; Zettlemoyer, L. "Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning." ACL (2021). arXiv:2012.13255
- Bommasani, R. et al. "On the Opportunities and Risks of Foundation Models." arXiv (2021). arXiv:2108.07258
- Hu, E. J. et al. "LoRA: Low-Rank Adaptation of Large Language Models." ICLR (2022). arXiv:2106.09685
- Müller, S.; Hollmann, N.; Pineda Arango, S.; Grabocka, J.; Hutter, F. "Transformers Can Do Bayesian Inference." ICLR (2022) — as prior-data fitted networks. arXiv:2112.10510
- Ouyang, L. et al. "Training Language Models to Follow Instructions with Human Feedback." NeurIPS (2022) — RLHF. arXiv:2203.02155
- Grinsztajn, L.; Oyallon, E.; Varoquaux, G. "Why Do Tree-Based Models Still Outperform Deep Learning on Typical Tabular Data?" NeurIPS Datasets and Benchmarks (2022). arXiv:2207.08815
- Hollmann, N.; Müller, S.; Eggensperger, K.; Hutter, F. "TabPFN: A Transformer That Solves Small Tabular Classification Problems in a Second." ICLR (2023). arXiv:2207.01848
- Touvron, H. et al. "Llama 2: Open Foundation and Fine-Tuned Chat Models." arXiv (2023) — o formato contado na seção 6. arXiv:2307.09288
- Dettmers, T.; Pagnoni, A.; Holtzman, A.; Zettlemoyer, L. "QLoRA: Efficient Finetuning of Quantized LLMs." NeurIPS (2023). arXiv:2305.14314
- Sainz, O. et al. "NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for each Benchmark." Findings of EMNLP (2023). arXiv:2310.18018
- Hollmann, N. et al. "Accurate Predictions on Small Data with a Tabular Foundation Model." Nature 637 (2025): 319–326. DOI
- Regulamento (UE) 2024/1689 (Regulamento da Inteligência Artificial, o AI Act). Jornal Oficial da União Europeia (2024). EUR-Lex
Quiz
O quiz cobre a abordagem fundamental.