O caminho desta parte
- Ajustar uma fatia finaa LoRA contada camada por camada; por que baixo posto basta
- Desafiar as árvorespor que as árvores lideram nas tabelas; TabPFN; um teste justo
- Encarar os problemas em abertoconfiabilidade, avaliação, alinhamento, eficiência, governança
LoRA: congele \(W\), treine \(B\) e \(A\)
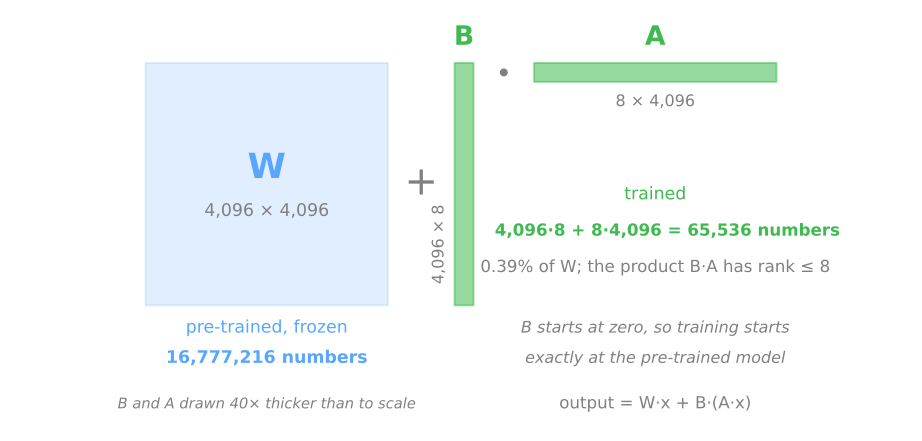
Uma camada calcula \(h = Wx\): entrada \(x\), saída \(h\), pesos pré-treinados \(W\) de \(d_{saída} \times d_{entrada}\).
\[ h = Wx + B\,(Ax) \]\(B\): \(d_{saída} \times r\) · \(A\): \(r \times d_{entrada}\) · posto \(r \ll d\)
treinados: \(r\,(d_{entrada} + d_{saída})\) em vez de \(d_{entrada}\, d_{saída}\)
LoRA, contada camada por camada
Preveja. Um modelo com o formato do Llama 2 7B. Conforme as peças se somam (uma matriz, uma camada, 32 camadas, os embeddings), a fração que a LoRA treina cresce, diminui ou fica igual? E a memória?
Por que uma fatia fina pode bastar
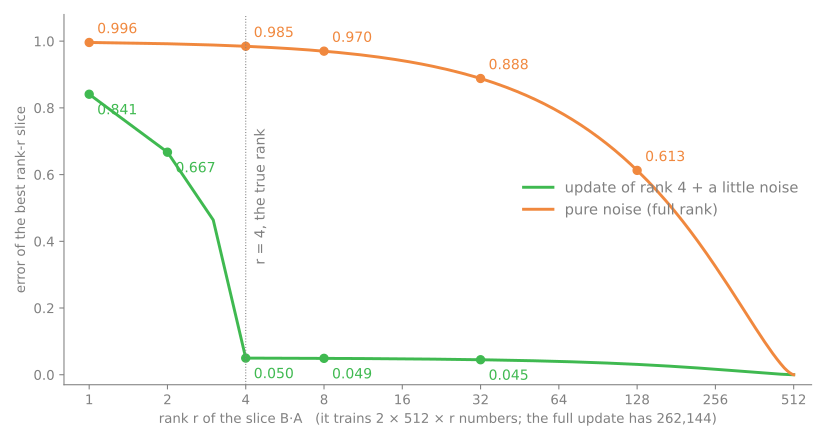
\(BA\) tem posto no máximo \(r\): a LoRA só aprende atualizações de posto \(\le r\). Preveja: para uma atualização de posto verdadeiro 4, o que acontece com o erro depois de \(r = 4\)? E para ruído puro?
Por que as árvores ainda lideram nas tabelas
Grinsztajn, Oyallon & Varoquaux (2022): 45 conjuntos tabulares de cerca de 10.000 linhas, ensembles de árvores à frente das redes profundas. Três razões:
alvos irregulares
tabelas têm saltos e limiares; as redes tendem a funções suaves
colunas inúteis
muitas colunas pouco informativas atrapalham mais as redes que as árvores
colunas com significado
a primeira camada de uma rede mistura idade com renda; uma árvore pergunta sobre uma coluna de cada vez
TabPFN: uma passada em vez de um ajuste
árvores com boosting
na sua tabela: crescer centenas de árvores, ajustar os hiperparâmetros com validação cruzada e depois prever
TabPFN (Hollmann et al., 2023, 2025)
um transformer pré-treinado uma vez em milhões de tabelas sintéticas. Entrada: as suas linhas de treino e as suas linhas novas. Saída: as previsões, em uma única passada
- PFN = prior-data fitted network, rede ajustada a dados de uma priori (Müller et al., 2022): aprendizado em contexto, como no few-shot, com uma tabela no lugar do prompt.
- Classificação até 10.000 linhas: a versão de 2025 superou, em 2,8 segundos, um ensemble dos modelos de referência mais fortes ajustado por 4 horas.
- Tabelas maiores ou latência apertada: as árvores com boosting continuam sendo o padrão.
Testando o desafiante: quem vence depende do tamanho
Preveja. Amostras do California housing: um modelo linear regularizado contra o gradient boosting, nos mesmos cinco folds. Quem vence com 100 linhas? E com 10.000?
| linhas | RMSE linear | RMSE boosting | o boosting vence |
|---|---|---|---|
| 100 | 60.842 | 71.432 | 1 de 5 folds |
| 300 | 64.830 | 71.952 | 0 de 5 |
| 1.000 | 69.439 | 58.184 | 5 de 5 |
| 3.000 | 69.139 | 53.752 | 5 de 5 |
| 10.000 | 70.025 | 49.547 | 5 de 5 |
Problemas em aberto: para onde o campo vai
- Alucinação e confiabilidade: calibração em escala de fronteira; um modelo deveria saber quando não sabe.
- Avaliação: os benchmarks saturam e vazam para os dados de treino.
- Alinhamento e segurança: o RLHF (aprendizado por reforço com feedback humano) e seus sucessores são respostas parciais; um modelo de recompensa aprende os vieses dos seus eleitores.
- Eficiência: destilação, quantização, modelos pequenos especializados.
- Proveniência dos dados, viés e governança: as questões de ética, agora reguladas (AI Act europeu; no Brasil, a LGPD, Lei Geral de Proteção de Dados, e o projeto de lei de IA PL 2338/2023).
- Causalidade: decisões precisam de "o que acontece se agirmos".
- Agentes: modelos que planejam, chamam ferramentas e agem; avaliá-los e mantê-los seguros está em grande parte sem solução.
Resumo
- A LoRA treina \(r\,(d_{entrada} + d_{saída})\) números por matriz adaptada: 0,062% de um modelo 7B com \(r = 8\) em \(q\) e \(v\).
- Ela economiza memória e armazenamento: de 107,8 GB para 13,5 GB no treino; um adaptador de 8,4 MB por tarefa. Agora a cópia congelada domina.
- Ela funciona porque as atualizações do fine-tuning são próximas de baixo posto; uma atualização de posto cheio não cabe numa fatia fina.
- O TabPFN prevê uma tabela pequena em uma única passada; as árvores com boosting continuam o padrão em tabelas grandes e com latência apertada.
- Um desafiante é testado como qualquer modelo: a sua tabela, o seu tamanho, os mesmos folds.
Para onde ir a partir daqui
- Deep learning, em profundidade: a disciplina do Insper Artificial Neural Networks and Deep Learning; Prince, Understanding Deep Learning (2023, grátis on-line).
- A visão probabilística: Murphy, Probabilistic Machine Learning (2022, grátis on-line).
- LLMs, na prática: os cursos da Hugging Face; a série Neural Networks: Zero to Hero de Karpathy.
- Ler artigos: escolha uma ficha tracejada no mapa, leia o artigo clássico dela e depois um artigo recente que o cite.
Contar, comprimir e testar, passos 5 a 7
- O mesmo notebook do Colab (ou um novo): o passo 5 usa
totalelorado bloco de contagem da seção 6; rode-o primeiro. - Passo 5: quanto o fine-tuning custa em memória · passo 6: quando uma fatia fina basta? · passo 7: quem vence depende do tamanho da tabela.
- Simulações: encolher a parte congelada (passo 5, QLoRA em 4 bits) e uma atualização sem estrutura (passo 6).
- O passo 7 ajusta 50 modelos: uns dois minutos.
Ritmo: passo 5 e sua simulação em 10 min; passo 6 e sua simulação em 10 min; passo 7 em 10 min.