Gradient Boosting
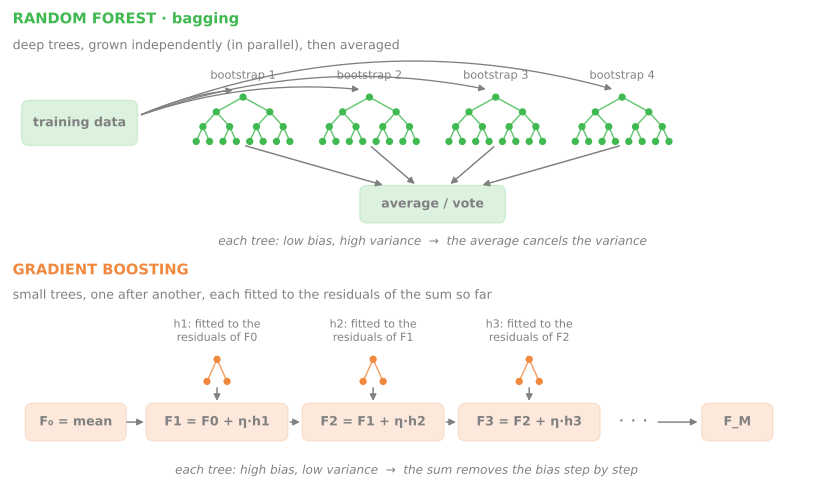
Uma random forest cresce centenas de árvores profundas de forma independente e tira a média delas: cada árvore sobreajusta do seu jeito e a média cancela o ruído. O boosting faz o contrário. Ele cresce árvores pequenas, uma depois da outra; cada árvore nova é ajustada aos erros que o ensemble ainda comete. A floresta combate a variância; o boosting combate o viés. A ideia nasceu como uma pergunta teórica (vários aprendizes "fracos", cada um pouco melhor que o acaso, podem ser combinados num forte?), virou um algoritmo prático com o AdaBoost (Freund & Schapire, 1997) e foi transformada numa receita geral por Friedman (2001): o gradient boosting, um gradiente descendente em que cada passo é uma árvore. Seus descendentes de engenharia, XGBoost (2016), LightGBM (2017) e CatBoost (2018), continuam sendo a escolha padrão para dados tabulares na indústria e em competições.
Esta aula constrói o gradient boosting a partir de um exemplo de seis pontos que dá para fazer com uma calculadora, mostra por que os resíduos são um gradiente, mede cada botão de regularização e termina com um lab em dados reais de marketing bancário, em que as bibliotecas modernas enfrentam a random forest nos mesmos folds. Todo número citado vem dos blocos de código ou dos scripts de figura ao lado desta página.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula no Colab; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Como somar árvores fracas, uma depois da outra, produz um modelo forte — e como impedir que ele exagere? | Que perda o boosting otimiza, o que as bibliotecas modernas mudam e quando ele vence a floresta |
| conteúdo | média contra soma, boosting à mão em seis pontos, resíduos como gradiente, taxa de aprendizado × número de árvores, parada antecipada | outras perdas, classificação pelo log-odds, AdaBoost, os outros botões, histogramas, XGBoost, LightGBM e CatBoost, floresta ou boosting |
| lab em aula | telemarketing: vazamento, booster padrão e taxa de aprendizado, passos 1 a 5 | floresta, bibliotecas, busca, limiar e teste, passos 6 a 11 |
| ao final, você sabe | fazer três rodadas de boosting à mão; explicar por que mais árvores podem piorar; usar a parada antecipada; reconhecer uma coluna que conhece o futuro | escolher a perda; ler o passo de Newton das folhas; comparar bibliotecas e a floresta nos mesmos folds; escolher o limiar fora do fold; desconfiar de uma divisão aleatória em dados ordenados no tempo |
Os dois labs usam o mesmo notebook no Colab: a parte fundamental vai do passo 1 ao 5; a avançada, do 6 ao 11. Tudo roda no navegador, inclusive o XGBoost e o LightGBM, que já vêm instalados no Colab; não é preciso baixar nada.
Abordagem fundamental
Uma pergunta guia esta parte: o que acontece quando, em vez de tirar a média de árvores independentes, você soma árvores pequenas, cada uma ajustada ao que as anteriores erraram? Primeiro com uma calculadora, em seis pontos; depois com a biblioteca. O algoritmo é um gradiente descendente em que cada passo é uma árvore e, como todo otimizador, ele não sabe parar sozinho: a taxa de aprendizado e a parada antecipada são os freios.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. somar, não tirar a média; 2. boosting à mão; 3. resíduo é gradiente; 4. frear e parar. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Somar, não tirar a médiaárvores pequenas em sequência removem o viés
- Boosting à mãoajustar os resíduos, somá-los encolhidos
- Resíduo é gradientedescida do gradiente nas previsões
- Frear e parartaxa de aprendizado e parada antecipada
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Uma árvore pequena depois da outra
Etapa 1. O contraste com a floresta fica mais fácil de ver num problema em que a resposta certa é conhecida: uma senoide com ruído, 200 pontos de treino e 5.000 pontos novos para medir o erro. Só o ruído já tem variância 0,25, então nenhum modelo pode ter um MSE de teste abaixo de cerca de 0,25.
import numpy as np
from sklearn.ensemble import GradientBoostingRegressor, RandomForestRegressor
from sklearn.tree import DecisionTreeRegressor


def sample(n, seed):                          # uma senoide com ruído; o ruído tem variância 0,25
    r = np.random.default_rng(seed)
    X = r.uniform(0, 6, (n, 1))
    return X, 2 * np.sin(X[:, 0]) + r.normal(0, 0.5, n)


X, y = sample(200, seed=0)                    # dados de treino
X_new, y_new = sample(5000, seed=1)           # dados novos, para medir o erro

models = {
    'one stump':                DecisionTreeRegressor(max_depth=1),
    'forest of 200 stumps':     RandomForestRegressor(n_estimators=200, max_depth=1, random_state=0),
    'boosting of 200 stumps':   GradientBoostingRegressor(n_estimators=200, max_depth=1,
                                                          learning_rate=0.1, random_state=0),
    'one deep tree':            DecisionTreeRegressor(random_state=0),
    'forest of 200 deep trees': RandomForestRegressor(n_estimators=200, random_state=0),
}
for name, model in models.items():
    model.fit(X, y)
    train_mse = np.mean((model.predict(X) - y) ** 2)
    test_mse = np.mean((model.predict(X_new) - y_new) ** 2)
    print(f"{name:25s} training MSE {train_mse:.3f} · test MSE {test_mse:.3f}")
one stump                 training MSE 0.552 · test MSE 0.608
forest of 200 stumps      training MSE 0.511 · test MSE 0.572
boosting of 200 stumps    training MSE 0.215 · test MSE 0.280
one deep tree             training MSE 0.000 · test MSE 0.509
forest of 200 deep trees  training MSE 0.054 · test MSE 0.369
Um toco (stump) é uma árvore com um único corte: uma pergunta, duas folhas. É o aprendiz fraco clássico: ele só sabe dizer "à esquerda do corte, este valor; à direita, aquele".
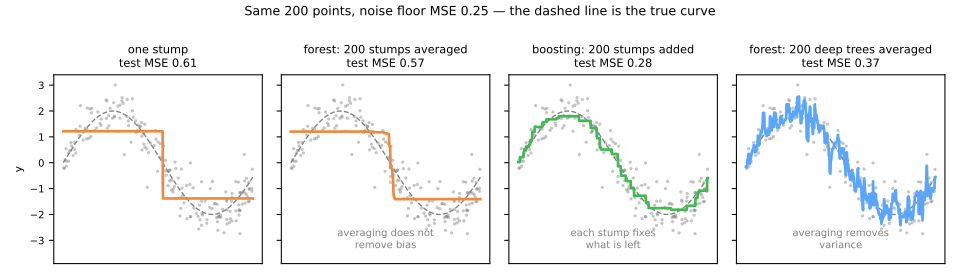
Leia a tabela duas linhas de cada vez:
- Tirar a média não remove viés. Uma floresta de 200 tocos é pouco melhor que um toco (MSE de teste 0,572 contra 0,608). Cada toco, qualquer que seja a amostra bootstrap que ele vê, faz mais ou menos o mesmo corte perto do meio, então a média deles ainda é mais ou menos um degrau. O erro de um toco é viés: ele é simples demais para seguir uma senoide — e 200 cópias de "simples demais" continuam simples demais.
- Tirar a média remove variância. Uma única árvore profunda decora o treino (MSE de treino 0,000) e paga por isso nos dados novos (0,509). A média de 200 delas derruba o MSE de teste para 0,369. Esse é o trabalho da floresta, da aula de random forest.
- Somar remove viés. O boosting usa os mesmos tocos fracos da primeira floresta, mas os soma: cada toco novo é ajustado ao que os anteriores erraram. O resultado segue a curva e chega a um MSE de teste de 0,280, perto do piso do ruído, 0,25.
Então os dois ensembles não são rivais fazendo a mesma coisa. A floresta precisa de árvores fortes e instáveis e tira a média delas; o boosting precisa de árvores fracas e estáveis e as empilha.
O diagrama põe as duas estratégias lado a lado (script da figura):
2. Boosting à mão
Seis pontos, três tocos
Etapa 2. Seis pontos, um atributo:
| \(x\) | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| \(y\) | 2 | 3 | 4 | 9 | 10 | 14 |
A perda é o erro quadrático; cada rodada soma um toco multiplicado por uma taxa de aprendizado \(\eta = 0{,}5\) (o mesmo \(\eta\) do gradiente descendente; por que meio passo é uma boa ideia fica para depois). A receita:
- Comece com uma constante. A constante que minimiza o erro quadrático é a média: \(F_0 = 42/6 = 7\).
- Calcule os resíduos \(r_i = y_i - F_0(x_i)\): \(-5, -4, -3, 2, 3, 7\).
- Ajuste um toco aos resíduos, não a \(y\). Um toco num atributo testa todo corte entre pontos vizinhos e fica com o de menor erro quadrático; cada folha prevê o resíduo médio dos seus pontos.
- Some-o, encolhido: \(F_1 = F_0 + \eta \cdot \text{toco}_1\). Repita a partir do passo 2.
O passo 3, a busca do toco, é a árvore de regressão da aula de árvores de decisão com profundidade 1:
x = np.arange(1, 7).reshape(-1, 1)
y = np.array([2, 3, 4, 9, 10, 14])

r = y - y.mean()                                   # resíduos de F0 = 7
for t in [1.5, 2.5, 3.5, 4.5, 5.5]:                # os cinco cortes possíveis
    left, right = r[x.ravel() < t], r[x.ravel() > t]
    sse = ((left - left.mean()) ** 2).sum() + ((right - right.mean()) ** 2).sum()
    print(f"x < {t}: left mean {left.mean():+.2f} · right mean {right.mean():+.2f} · SSE {sse:.2f}")
x < 1.5: left mean -5.00 · right mean +1.00 · SSE 82.00
x < 2.5: left mean -4.50 · right mean +2.25 · SSE 51.25
x < 3.5: left mean -4.00 · right mean +4.00 · SSE 16.00
x < 4.5: left mean -2.50 · right mean +5.00 · SSE 37.00
x < 5.5: left mean -1.40 · right mean +7.00 · SSE 53.20
O corte em 3,5 vence com folga (SSE 16; o segundo melhor tem 37): a folha da esquerda prevê \(-4\) e a da direita \(+4\). Com \(\eta = 0{,}5\), o ensemble anda metade do caminho: \(F_1 = 7 - 2 = 5\) para \(x \le 3\) e \(7 + 2 = 9\) para \(x \ge 4\). Agora repita com os novos resíduos:
| rodada | corte escolhido | valores das folhas (esq. / dir.) | previsões \(F_m\) em \(x = 1 \dots 6\) | resíduos | MSE de treino |
|---|---|---|---|---|---|
| 0 | — | — | 7, 7, 7, 7, 7, 7 | −5, −4, −3, 2, 3, 7 | 18,67 |
| 1 | \(x < 3{,}5\) | −4 / +4 | 5, 5, 5, 9, 9, 9 | −3, −2, −1, 0, 1, 5 | 6,67 |
| 2 | \(x < 5{,}5\) | −1 / +5 | 4,5; 4,5; 4,5; 8,5; 8,5; 11,5 | −2,5; −1,5; −0,5; 0,5; 1,5; 2,5 | 2,92 |
| 3 | \(x < 3{,}5\) | −1,5 / +1,5 | 3,75; 3,75; 3,75; 9,25; 9,25; 12,25 | −1,75; −0,75; 0,25; −0,25; 0,75; 1,75 | 1,23 |
Confira a rodada 2 com uma calculadora. Os resíduos depois da rodada 1 são \(-3, -2, -1, 0, 1, 5\); o grande que sobrou é o último ponto, então o melhor corte o isola: \(x < 5{,}5\), média da esquerda \((-3-2-1+0+1)/5 = -1\), folha da direita \(5\). Metade disso é somada: \(5 - 0{,}5 = 4{,}5\), \(9 - 0{,}5 = 8{,}5\) e \(9 + 2{,}5 = 11{,}5\). Note que a rodada 3 usa o mesmo corte da rodada 1: nada o proíbe; os resíduos simplesmente pediram mais da mesma correção.
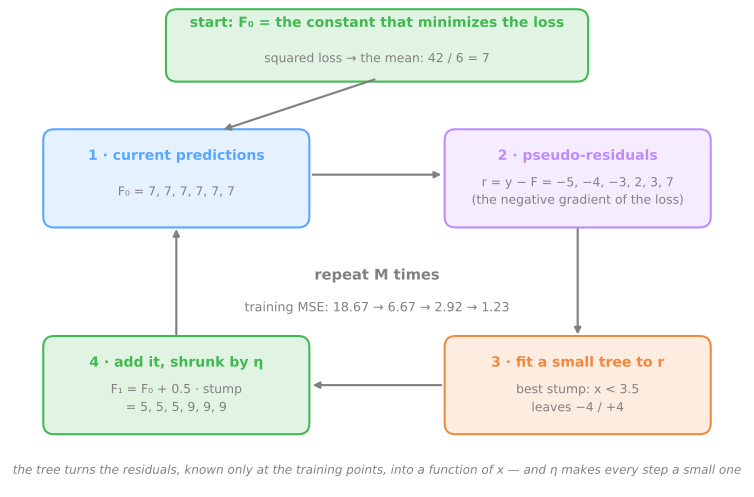
O laço inteiro cabe num diagrama, com os números da primeira rodada (script da figura):
A biblioteca confirma
O GradientBoostingRegressor com max_depth=1 constrói tocos; staged_predict devolve as previsões depois de cada rodada:
gb = GradientBoostingRegressor(n_estimators=3, max_depth=1, learning_rate=0.5).fit(x, y)
for m, F in enumerate(gb.staged_predict(x), start=1):
    stump = gb.estimators_[m - 1, 0].tree_          # o nó 0 é o corte, os nós 1 e 2 são as folhas
    print(f"round {m}: x < {stump.threshold[0]} · leaves {stump.value[1, 0, 0]:+.1f} / "
          f"{stump.value[2, 0, 0]:+.1f} · F = {F} · MSE {np.mean((y - F) ** 2):.2f}")
round 1: x < 3.5 · leaves -4.0 / +4.0 · F = [5. 5. 5. 9. 9. 9.] · MSE 6.67
round 2: x < 5.5 · leaves -1.0 / +5.0 · F = [ 4.5  4.5  4.5  8.5  8.5 11.5] · MSE 2.92
round 3: x < 3.5 · leaves -1.5 / +1.5 · F = [ 3.75  3.75  3.75  9.25  9.25 12.25] · MSE 1.23
Mesmos cortes, mesmos valores de folha, mesmas previsões. Note que a árvore guarda os valores de folha sem o encolhimento (\(-4\), \(+4\)); a taxa de aprendizado é aplicada quando as árvores são somadas.
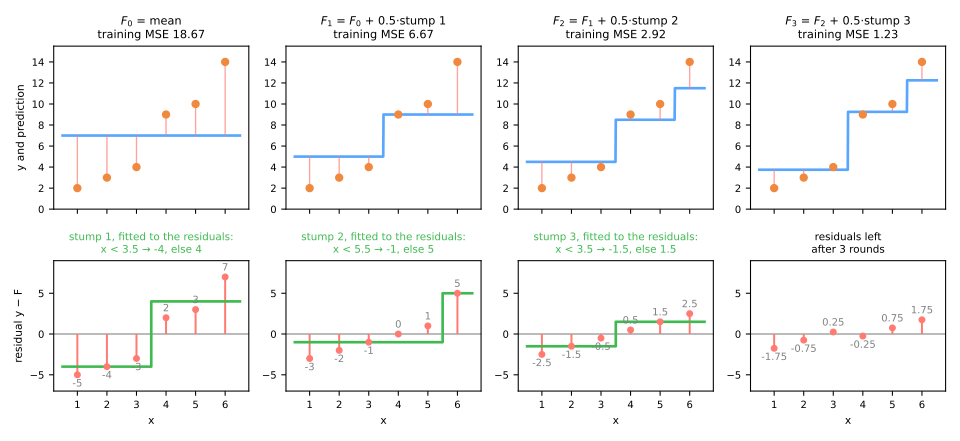
A linha de cima é o ensemble depois de cada rodada, uma escada que ganha um degrau a mais (ou um degrau mais alto) a cada vez. A linha de baixo é o que o próximo toco enxerga: não os dados, mas os resíduos, que encolhem rodada após rodada. O modelo final é uma soma: \(F_3(x) = 7 + 0{,}5\,\text{toco}_1(x) + 0{,}5\,\text{toco}_2(x) + 0{,}5\,\text{toco}_3(x)\).
Veja o resíduo encolher
O simulador roda o mesmo laço em 60 pontos. O painel de baixo é o resíduo; a função degrau verde é o toco que está prestes a ser ajustado a ele. O controle \(\nu\) é a taxa de aprendizado (\(\nu\) é a letra que Friedman usou; o scikit-learn a chama de learning_rate e esta página, de \(\eta\)).
Três experimentos:
- Ponha ν = 1 com 6 tocos, depois ν = 0,15 com 40. Os dois chegam a um ajuste parecido, mas o segundo chegou lá em passos pequenos e cautelosos. Com \(\nu = 1\) cada toco corrige inteiramente a sua região, inclusive o ruído que há nela; com \(\nu\) pequeno, uma correção precisa ser confirmada por vários tocos seguidos antes de ser aplicada por inteiro.
- Divida \(\nu\) por dois e você precisa de cerca do dobro de tocos para o mesmo ajuste.
learning_rateen_estimatorssão um mesmo botão visto de dois lados e precisam ser ajustados juntos. - Ponha ν = 1 e leve os tocos até 60. A curva azul começa a se curvar em direção a pontos individuais, enquanto o MSE de treino continua caindo. O erro de treino não sabe dizer quando parar; uma curva de validação sabe e, mais abaixo, ela volta a subir.
3. Por que "gradient" boosting: resíduos são um gradiente
Etapa 3. Olhe a perda quadrática de um ponto, como função da previsão \(F\):
O resíduo é o gradiente negativo da perda em relação à previsão. Então o exemplo à mão fez gradiente descendente, mas não sobre pesos: sobre as seis previsões em si. A rodada \(m\) calculou a direção em que cada previsão deveria andar para baixar a perda (os resíduos) e moveu cada previsão um passo \(\eta\) nessa direção.
Por que não mover as seis previsões diretamente, então? Porque o gradiente só é conhecido nos pontos de treino, enquanto o modelo precisa prever em qualquer lugar. Ajustar uma árvore ao gradiente transforma seis números numa função de \(x\): ela agrupa os pontos que querem andar para o mesmo lado e dá a todo \(x\) novo o passo do seu grupo. O algoritmo geral de Friedman, para qualquer perda diferenciável \(L\):
F0(x) = a constante c que minimiza Σ L(yᵢ, c)                # a média, a mediana, o log-odds...
para m = 1 .. M:
    rᵢ = −∂L(yᵢ, F)/∂F  em F = F_{m−1}(xᵢ)                   # pseudo-resíduos: o gradiente negativo
    ajuste uma pequena árvore de regressão h_m aos pares (xᵢ, rᵢ)  # a árvore decide as regiões
    em cada folha, ponha o valor que mais baixa a perda        # no erro quadrático: o resíduo médio
    F_m(x) = F_{m−1}(x) + η · h_m(x)                            # um passo pequeno
Os \(r_i\) se chamam pseudo-resíduos: na perda quadrática eles são os resíduos comuns; em outras perdas, são outra coisa. A árvore é sempre uma árvore de regressão ajustada a eles, mesmo quando o problema é de classificação.
4. O kit de regularização: taxa de aprendizado e parada antecipada
Etapa 4. O boosting é um otimizador: toda rodada baixa a perda de treino e nada no algoritmo o faz parar. Em dados reais isso significa que ele acaba ajustando ruído, então mais árvores podem piorar o modelo, o que nunca acontece com uma floresta. Os freios, usados todos juntos:
- Taxa de aprendizado \(\eta\): encolhe a contribuição de cada árvore;
- Número de árvores, escolhido por parada antecipada (early stopping) num conjunto de validação;
- Tamanho da árvore:
max_depthoumax_leaf_nodes; - Tamanho da folha e penalidades:
min_samples_leaf,l2_regularization; - Subamostragem: cada árvore vê uma fração aleatória das linhas (gradient boosting estocástico, Friedman 2002) e/ou das colunas (
max_features,colsample_bytree), o truque de descorrelação da floresta.
Esta parte mede os dois primeiros freios, os que mais importam; os outros ficam para a seção 9.
Taxa de aprendizado e número de árvores
Os dados desta seção: California housing, 20.640 distritos, prever o valor mediano das casas (em milhares de dólares) a partir de localização, idade, cômodos, renda e proximidade do oceano. Cada modelo abaixo soma 1.000 árvores sem parada antecipada; o erro de validação é registrado depois de cada árvore (script da figura):
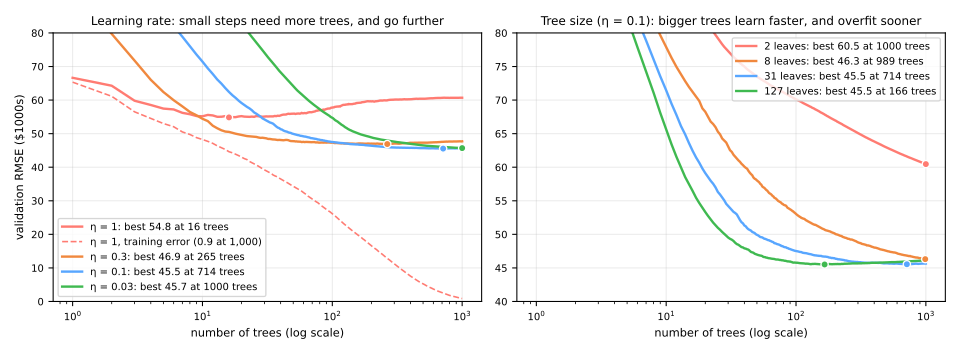
O painel da esquerda é a imagem central do boosting:
- Com \(\eta = 1\), o erro de validação chega ao fundo depois de 16 árvores (54,8 mil dólares) e então sobe até 60,7, enquanto o erro de treino (tracejado) continua caindo, até 0,9 depois de 1.000 árvores. Essa distância é sobreajuste, produzido por somar árvores.
- Um \(\eta\) menor precisa de mais árvores para chegar a algum lugar, mas chega mais longe: 46,9 com 265 árvores para \(\eta = 0{,}3\), 45,5 com 714 para \(\eta = 0{,}1\). A curva depois do mínimo também é mais plana, então passar do número certo de árvores custa menos.
- Abaixo de certo \(\eta\) os ganhos acabam e só resta o custo: depois de 1.000 árvores, \(\eta = 0{,}03\) está em 45,7 e ainda caindo, enquanto \(\eta = 0{,}1\) chegou a 45,5 com 714 árvores.
O painel da direita muda o tamanho da árvore com \(\eta = 0{,}1\). Tocos (2 folhas) não conseguem representar interações entre atributos (como "perto do oceano e com renda alta") e ainda estão em 60,5 depois de 1.000 árvores. Árvores maiores aprendem mais depressa e chegam antes ao mínimo: com 8 folhas, 46,3 só com 989 árvores; com 31 folhas, 45,5 com 714; com 127 folhas, 45,5 com 166 — e depois disso o erro começa a subir devagar. Uma árvore com \(d\) níveis combina no máximo \(d\) atributos ao longo de um caminho, então o tamanho da árvore limita a ordem de interação que o modelo consegue expressar.
A parada antecipada escolhe o número de árvores
Na prática ninguém desenha essa curva à mão. A parada antecipada separa uma fatia dos dados de treino, observa a perda nela depois de cada árvore e para quando ela não melhora há n_iter_no_change rodadas. O número de árvores vira uma saída, não um hiperparâmetro:
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.model_selection import train_test_split

url = 'https://raw.githubusercontent.com/hsandmann/biblio/refs/heads/main/ml/aula02/housing.csv'
housing = pd.read_csv(url)
y_h = housing.pop('median_house_value') / 1000                   # em milhares de dólares
X_h = housing.astype({'ocean_proximity': 'category'})           # lida nativamente, sem codificação
X_tr, X_va, y_tr, y_va = train_test_split(X_h, y_h, test_size=0.25, random_state=0)

for eta in [1.0, 0.3, 0.1]:
    model = HistGradientBoostingRegressor(learning_rate=eta, max_iter=5000, early_stopping=True,
                                          validation_fraction=0.1, n_iter_no_change=20,
                                          random_state=0).fit(X_tr, y_tr)
    rmse = np.sqrt(np.mean((model.predict(X_va) - y_va) ** 2))
    print(f"η = {eta:<3}: stopped after {model.n_iter_:4d} trees · validation RMSE {rmse:.1f}")
η = 1.0: stopped after   41 trees · validation RMSE 56.4
η = 0.3: stopped after   87 trees · validation RMSE 47.4
η = 0.1: stopped after  337 trees · validation RMSE 46.0
A parada antecipada chega perto do fundo de cada curva da figura sem nunca olhar para X_va: 56,4 para \(\eta = 1\) (o mínimo da figura era 54,8), 47,4 para \(\eta = 0{,}3\) e 46,0 para \(\eta = 0{,}1\). Com \(\eta = 0{,}1\) ela parou em 337 árvores, bem antes do mínimo da figura em 714, porque essa curva é quase plana depois de 300 árvores: 20 rodadas sem melhora numa pequena fatia de observação bastam para encerrar, ao custo de meio ponto de RMSE. Dois detalhes para lembrar:
- a fatia de observação sai dos dados de treino (
validation_fraction=0.1), então as árvores são ajustadas em 90% deX_tre os seus próprios dados de validação ou de teste ficam intocados; - o modelo ajustado mantém as
n_iter_no_changeárvores somadas depois da melhor; o scikit-learn não volta atrás. Com \(\eta\) grande, essas árvores extras já sobreajustam (o lab mede quanto isso custa); com \(\eta\) pequeno, são inofensivas. Dê mais paciência a taxas de aprendizado pequenas.
5. Resumo: o boosting em cinco linhas
- A média corta variância; a soma corta viés. Uma floresta de tocos continua sendo mais ou menos um toco; um boosting de tocos segue a curva.
- Cada árvore é ajustada aos resíduos do ensemble atual e entra multiplicada pela taxa de aprendizado \(\eta\): \(F_m = F_{m-1} + \eta\, h_m\).
- Os resíduos são o gradiente negativo da perda: boosting é gradiente descendente sobre as previsões, com uma árvore transformando o gradiente numa função de \(x\).
- Mais árvores podem piorar o modelo. Um \(\eta\) menor precisa de mais árvores, chega mais longe e sobe mais devagar depois do mínimo.
- A parada antecipada observa uma fatia do treino e escolhe o número de árvores sozinha: ele vira uma saída, não um hiperparâmetro.
| sintoma | o que está acontecendo | o que fazer |
|---|---|---|
| erro de validação mínimo cedo e depois subindo | \(\eta\) grande: as árvores seguintes ajustam ruído | baixar \(\eta\) e ligar a parada antecipada |
| erro ainda caindo no fim | árvores de menos para o \(\eta\) escolhido | mais árvores (a parada antecipada decide) |
| treino perfeito, validação ruim | sobreajuste somando árvores | parada antecipada, árvores menores, folhas maiores |
| métricas boas demais para ser verdade | uma coluna que conhece o futuro | perguntar, coluna a coluna, se o valor existe na hora da previsão |
Lab fundamental — quem vai assinar?
O problema. Um banco português fez campanhas por telefone entre 2008 e 2010 para vender um depósito a prazo (Moro, Cortez & Rita, 2014). Cada uma das 45.211 linhas é um cliente contatado numa campanha: idade, profissão, estado civil, escolaridade, saldo em conta, empréstimos, como e quando foi contatado, além do que aconteceu em campanhas anteriores. O alvo: o cliente assinou? Só 11,7% assinaram. Um modelo que ordena os clientes pela chance de assinar deixa o banco ligar primeiro para os promissores.
O fluxo é o da aula de validação: trancar um conjunto de teste, um único objeto cv para todos os modelos, comparar nos mesmos folds, tocar no teste uma vez, no passo 10. A classe positiva é rara, então a métrica principal é a precisão média (AP, a área sob a curva precisão–recall da aula de ROC e dados desbalanceados), com o ROC AUC ao lado. Esta parte encontra um vazamento, mede o booster padrão contra um modelo linear e ajusta a taxa de aprendizado com parada antecipada; a floresta, as outras bibliotecas, a busca, o limiar e o teste ficam para o lab avançado.
Como fazer este lab em aula (cerca de 35 min, em duplas)
- Abra o notebook do lab no Colab. Não é preciso baixar nem instalar nada: o Colab roda no navegador e já traz o XGBoost e o LightGBM. Para guardar as suas respostas, salve uma cópia no seu Drive (Arquivo → Salvar uma cópia no Drive) antes de editar. Rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 5 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 6.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 a 3 em 10 min; passo 4 e a primeira simulação em 12 min; passo 5 e a segunda simulação em 13 min. Os passos 4 e 5 levam de alguns segundos a um minuto para rodar.
Passo 1 — carregar, nomear as colunas, olhar
Preveja. Só uma parte dos clientes contatados assina o depósito. Você espera algo perto de 50%, de 25% ou de 10%? E a duração da ligação: maior para quem assinou ou para quem não assinou?
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_openml

bank = fetch_openml(data_id=1461, as_frame=True)            # Bank Marketing (UCI), uma linha por cliente
X = bank.data.copy()
X.columns = ['age', 'job', 'marital', 'education', 'default', 'balance', 'housing', 'loan',
             'contact', 'day', 'month', 'duration', 'campaign', 'pdays', 'previous', 'poutcome']
y = (bank.target == '2').astype(int).rename('subscribed')   # 1 = assinou um depósito a prazo
print(X.shape, f"· subscribed: {y.sum()} ({y.mean():.1%})")
print(X.dtypes.astype(str).value_counts().to_dict())
print(X['duration'].describe().round(0).to_dict())
print(X.groupby(y)['duration'].median())
(45211, 16) · subscribed: 5289 (11.7%)
{'category': 9, 'int64': 7}
{'count': 45211.0, 'mean': 258.0, 'std': 258.0, 'min': 0.0, '25%': 103.0, '50%': 180.0, '75%': 319.0, 'max': 4918.0}
subscribed
0    164.0
1    426.0
Name: duration, dtype: float64
45.211 clientes, dos quais 5.289 (11,7%) assinaram. Nove colunas são categóricas (category do pandas, que o boosting usa diretamente) e sete são inteiras. O OpenML entrega as colunas anonimizadas como V1…V16; os nomes acima seguem a ordem da documentação original da UCI; vale conferir pelo menos um contra os dados antes de confiar na lista. A coluna 12, duration, é documentada como a duração da última ligação, em segundos: seus valores vão de 0 a 4.918 (82 minutos), com mediana 180 (três minutos), que é a cara de ligações telefônicas. E ela separa fortemente as classes: quem assinou falou por uma mediana de 426 segundos; os demais, por 164.
Passo 2 — trancar o teste, fixar os folds, definir um baseline
Preveja. Com 11,7% de positivos, que AP uma ordenação aleatória dos clientes consegue? E que ROC AUC?
from sklearn.dummy import DummyClassifier
from sklearn.model_selection import StratifiedKFold, cross_validate, train_test_split

X_dev, X_test, y_dev, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=42)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)     # os MESMOS folds para todo modelo


def cv_eval(model, X_=None):
    """CV de 5 folds no conjunto de desenvolvimento: escores, tempos e os modelos de cada fold."""
    return cross_validate(model, X_dev if X_ is None else X_, y_dev, cv=cv, return_estimator=True,
                          scoring=['roc_auc', 'average_precision'])


def summary(r):
    return (f"ROC AUC {r['test_roc_auc'].mean():.3f} ± {r['test_roc_auc'].std():.3f} · "
            f"AP {r['test_average_precision'].mean():.3f} ± {r['test_average_precision'].std():.3f}")


print(X_dev.shape, X_test.shape)
print('dummy', summary(cv_eval(DummyClassifier(strategy='prior'))))
36.168 linhas para desenvolvimento e 9.043 trancadas até o passo 10, ambas com 11,7% de positivos graças ao stratify=y. O objeto cv é criado uma vez e todo modelo abaixo é avaliado nos mesmos cinco folds, então as diferenças podem ser comparadas fold a fold. A AP do dummy é 0,117, a prevalência: é quanto uma ordenação aleatória marca; toda AP abaixo deve ser lida contra ela, não contra 0 ou 0,5. O seu ROC AUC é 0,5, o baseline da ROC.
Passo 3 — um vazamento à vista: a duração da ligação
Preveja. A duração da ligação separa muito bem quem assina de quem não assina. Ela pode ser usada para decidir para quem ligar? O que você espera das métricas sem ela?
from sklearn.ensemble import HistGradientBoostingClassifier

hgb = HistGradientBoostingClassifier(random_state=42)
with_duration = cv_eval(hgb)
without = cv_eval(hgb, X_dev.drop(columns='duration'))
print('with duration   ', summary(with_duration))
print('without duration', summary(without))

X_dev, X_test = X_dev.drop(columns='duration'), X_test.drop(columns='duration')   # fora de vez
with duration    ROC AUC 0.934 ± 0.002 · AP 0.624 ± 0.017
without duration ROC AUC 0.797 ± 0.004 · AP 0.447 ± 0.012
Com duration, o booster chega a ROC AUC 0,934 e AP 0,624. Sem ela, 0,797 e 0,447. A coluna mais útil da tabela também é inutilizável: a duração de uma ligação só é conhecida quando a ligação termina, mas o trabalho do modelo é decidir para quem ligar. A própria documentação da UCI diz isso (a coluna "deve ser descartada se a intenção é ter um modelo preditivo realista"). É o vazamento dos atributos que conhecem o futuro: nenhum esquema de validação cruzada o detecta, porque ele mora nas colunas, não na divisão. A pergunta tem de ser feita a cada coluna: este valor está disponível no momento em que a previsão é feita? Daqui em diante, duration sai de X_dev e de X_test; 0,797 é o ponto de partida honesto.
Passo 4 — HistGradientBoosting sem ajuste, contra um modelo linear
Preveja. O booster usa as colunas como estão, sem one-hot nem escalonamento; a regressão logística recebe tudo preparado. Quem ordena melhor os clientes?
from sklearn.compose import make_column_selector, make_column_transformer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import OneHotEncoder, OrdinalEncoder, StandardScaler

categorical = make_column_selector(dtype_include='category')
logistic = make_pipeline(
    make_column_transformer((OneHotEncoder(handle_unknown='ignore'), categorical),
                            remainder=StandardScaler()),
    LogisticRegression(max_iter=2000))
as_codes = make_pipeline(
    make_column_transformer((OrdinalEncoder(), categorical), remainder='passthrough'),
    HistGradientBoostingClassifier(categorical_features=None, random_state=42))

results = {'logistic regression': cv_eval(logistic),
           'HGB, native categories': without,
           'HGB, categories as codes': cv_eval(as_codes)}
for name, r in results.items():
    print(f"{name:25s}", summary(r))
print('trees kept by early stopping in each fold:', [m.n_iter_ for m in without['estimator']])
logistic regression       ROC AUC 0.763 ± 0.003 · AP 0.402 ± 0.008
HGB, native categories    ROC AUC 0.797 ± 0.004 · AP 0.447 ± 0.012
HGB, categories as codes  ROC AUC 0.795 ± 0.002 · AP 0.441 ± 0.010
trees kept by early stopping in each fold: [52, 45, 46, 59, 71]
Como ler:
- Boosting contra um modelo linear. A regressão logística, com categorias em one-hot e números escalonados, chega a ROC AUC 0,763 e AP 0,402. O booster, sem pré-processamento nenhum, chega a 0,797 e 0,447: 4,5 pontos de AP, cerca de quatro desvios padrão entre folds. As árvores encontram limiares e interações entre colunas que um modelo linear não representa sem atributos feitos à mão.
- Categorias nativas contra códigos inteiros. Passar as categorias de forma nativa (0,447) ou como códigos inteiros arbitrários (0,441) faz uma diferença menor que o desvio padrão entre folds aqui. Com códigos, as árvores precisam recortar uma ordem arbitrária (
admin.= 0,blue-collar= 1, …), o que custa mais cortes; com 12 profissões e 12 meses elas dão conta mesmo assim. O caminho nativo importa mais com muitas categorias e é mais simples: nenhum codificador para ajustar. - A parada antecipada já estava ligada. O
HistGradientBoostingClassifiera liga sozinho quando há mais de 10.000 linhas (early_stopping='auto'), com no máximomax_iter=100árvores. Cada fold manteve entre 45 e 71.
Simulação: uma floresta de tocos contra um boosting de tocos. A seção 1 comparou, numa senoide, a média de 200 tocos com a soma de 200 tocos. Repita nos dados do banco, nos mesmos folds: um toco sozinho, uma floresta de 200 tocos e um boosting de 200 tocos (max_leaf_nodes=2, sem parada antecipada). Quanto da distância até o booster completo cada um fecha?
Solução
from sklearn.ensemble import RandomForestClassifier

codes = lambda: make_column_transformer((OrdinalEncoder(), categorical), remainder='passthrough')
stumps = {'one stump': make_pipeline(codes(), RandomForestClassifier(
              n_estimators=1, max_depth=1, bootstrap=False, max_features=None, random_state=42)),
          'forest of 200 stumps': make_pipeline(codes(), RandomForestClassifier(
              n_estimators=200, max_depth=1, n_jobs=-1, random_state=42)),
          'boosting of 200 stumps': HistGradientBoostingClassifier(
              max_leaf_nodes=2, max_iter=200, early_stopping=False, random_state=42)}    # toco = 2 folhas
for name, model in stumps.items():
    print(f"{name:23s}", summary(cv_eval(model)))
one stump               ROC AUC 0.546 ± 0.003 · AP 0.153 ± 0.003
forest of 200 stumps    ROC AUC 0.720 ± 0.004 · AP 0.283 ± 0.010
boosting of 200 stumps  ROC AUC 0.775 ± 0.003 · AP 0.412 ± 0.007
Um toco sozinho quase não ordena nada (AP 0,153, perto da prevalência de 0,117). A floresta de tocos melhora bastante (0,283), ao contrário da senoide da seção 1: aqui há 15 colunas e o sorteio de atributos da floresta faz cada toco cortar uma coluna diferente, então a média vira uma soma grosseira de efeitos de várias colunas. Mas cada toco foi ajustado sem saber dos outros. O boosting ajusta cada toco ao que os anteriores ainda erram e chega a 0,412, perto dos 0,447 do booster padrão, usando só árvores de uma pergunta. O que falta para chegar lá são as interações entre colunas, que um toco não representa.
Passo 5 — taxa de aprendizado × número de árvores, com parada antecipada
Preveja. Com \(\eta = 0{,}5\), o booster vai precisar de mais ou de menos árvores que com \(\eta = 0{,}03\)? E vai chegar mais longe ou menos longe?
import matplotlib.pyplot as plt

for eta in [0.5, 0.1, 0.03]:
    model = HistGradientBoostingClassifier(learning_rate=eta, max_iter=2000, early_stopping=True,
                                           n_iter_no_change=30, random_state=42)
    results[f'HGB, η = {eta}'] = r = cv_eval(model)
    trees = [m.n_iter_ for m in r['estimator']]
    print(f"η = {eta:<4} trees per fold {trees} · {summary(r)}")
    curve = -r['estimator'][0].validation_score_          # fold 0: log loss nos 10% internos
    plt.plot(curve, label=f'η = {eta}')
plt.xscale('log'); plt.xlabel('trees'); plt.ylabel('inner validation log loss'); plt.legend()
plt.show()
η = 0.5  trees per fold [38, 36, 34, 36, 35] · ROC AUC 0.768 ± 0.008 · AP 0.385 ± 0.008
η = 0.1  trees per fold [99, 108, 80, 79, 105] · ROC AUC 0.795 ± 0.002 · AP 0.446 ± 0.014
η = 0.03 trees per fold [349, 296, 206, 304, 270] · ROC AUC 0.798 ± 0.004 · AP 0.449 ± 0.015
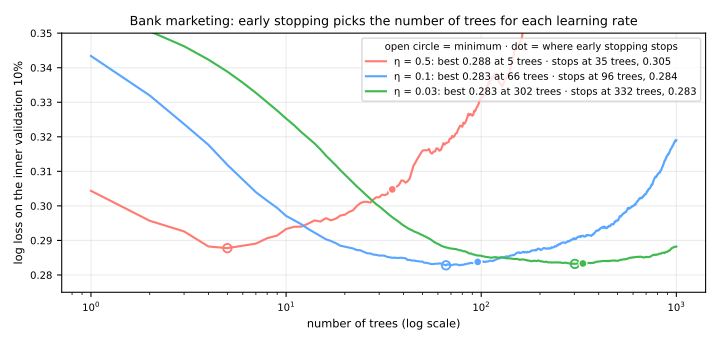
(script da figura, ajustado no conjunto de desenvolvimento inteiro em vez de num fold)
Como ler:
- η = 0,5 é claramente pior: ROC AUC 0,768 e AP 0,385, contra 0,795 e 0,446 para η = 0,1. A figura mostra por quê. A perda da validação interna é mínima depois de só 5 árvores e depois sobe; a parada antecipada precisa de 30 rodadas sem melhora para parar; o modelo mantém essas 30 árvores que sobreajustam (perda 0,305 na parada, contra 0,288 no mínimo).
- η = 0,1 e η = 0,03 empatam: AP 0,446 e 0,449, uma diferença muito menor que os desvios padrão entre folds (0,014–0,015). Com passos pequenos o vale é largo e plano, então as 30 árvores extras quase não custam nada (0,284 contra 0,283). A taxa menor precisa de cerca de três vezes mais árvores (206–349 contra 79–108) sem ganho mensurável.
- O número de árvores é uma saída. Ninguém escolheu 99, 108, 80, 79 ou 105: os folds escolheram.
Simulação: mais árvores, sem freio. Desligue a parada antecipada e fixe o número de árvores em 5, 35, 200 e 1.000, com \(\eta = 0{,}5\) e \(\eta = 0{,}05\). Para ser rápido, use só o primeiro fold do cv e meça a AP na sua parte de validação. Mais árvores sempre ajudam?
Solução
from sklearn.metrics import average_precision_score

tr, va = next(cv.split(X_dev, y_dev))                  # um único fold, para ser rápido
print('trees   η = 0.5   η = 0.05')
for n in [5, 35, 200, 1000]:
    aps = []
    for eta in [0.5, 0.05]:
        m = HistGradientBoostingClassifier(learning_rate=eta, max_iter=n, early_stopping=False, random_state=42)
        m.fit(X_dev.iloc[tr], y_dev.iloc[tr])
        aps.append(average_precision_score(y_dev.iloc[va], m.predict_proba(X_dev.iloc[va])[:, 1]))
    print(f"{n:5d}   {aps[0]:7.3f}   {aps[1]:8.3f}")
Com \(\eta = 0{,}5\), a AP é máxima já com 5 árvores (0,418) e cai a cada lote de árvores, até 0,336 com 1.000: as árvores seguintes ajustam ruído. Com \(\eta = 0{,}05\) a subida é mais lenta e o pico, mais alto (0,435 com 200 árvores), mas a queda vem do mesmo jeito: 0,408 com 1.000. Numa floresta, mais árvores nunca pioram; no boosting, pioram. O ponto certo depende de \(\eta\). É exatamente o trabalho que a parada antecipada do passo 5 fez sozinha, fold a fold.
Para fechar a parte fundamental. Em uma frase cada: (1) por que somar tocos ajustados aos resíduos chega mais longe que tirar a média de tocos? (2) Por que a duração da ligação não pode entrar no modelo, por mais que melhore as métricas? (3) O que a parada antecipada decide e com que dados?
Sua vez (fundamental)
Para casa:
- Mais uma rodada à mão. Continue o exemplo dos seis pontos da seção 2: calcule os resíduos depois da rodada 3, encontre o melhor corte e as folhas do quarto toco e as previsões \(F_4\). Confira com
GradientBoostingRegressor(n_estimators=4, max_depth=1, learning_rate=0.5). - Devolva o vazamento. Rode de novo os passos 4 e 5 mantendo
durationemX_dev. Quanto a AP sobe? Escreva um parágrafo para o gerente do banco explicando por que esse modelo não pode ir para produção e outro sugerindo comodurationpoderia ser usada (dica: depois que a ligação começou, para decidir se vale continuar falando). - Tocos com parada antecipada. Ajuste
HistGradientBoostingClassifier(max_leaf_nodes=2, max_iter=5000, early_stopping=True, n_iter_no_change=30)nos mesmos folds. Quantas árvores a parada antecipada mantém? A AP chega aos 0,447 do booster padrão?
Abordagem avançada
A parte fundamental construiu o boosting com a perda quadrática e o freou com a taxa de aprendizado. Esta parte mostra o que muda quando a perda muda e o que as bibliotecas fazem por você: perdas robustas, classificação pelo log-odds com passos de Newton, o AdaBoost como caso particular, os outros botões, os truques de engenharia do XGBoost, do LightGBM e do CatBoost e uma comparação justa com a floresta. Os blocos de código continuam os das seções 1 a 4.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. qualquer perda, o mesmo laço; 2. ajustar os outros botões; 3. as bibliotecas modernas; 4. floresta ou boosting? Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Qualquer perda, o mesmo laçoperdas robustas, log-odds, AdaBoost
- Ajustar os outros botõestamanho da árvore, folhas, L2, com η fixo
- As bibliotecas modernashistogramas, XGBoost, LightGBM, CatBoost
- Floresta ou boosting?uma comparação justa, lado a lado
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
6. Outras perdas, a mesma maquinaria
| perda | \(L(y, F)\) | pseudo-resíduo \(-\partial L / \partial F\) | \(F_0\) |
|---|---|---|---|
| erro quadrático | \(\tfrac12 (y - F)^2\) | \(y - F\) | média |
| erro absoluto | \(\lvert y - F \rvert\) | \(\operatorname{sinal}(y - F)\) | mediana |
| Huber | quadrática perto de 0, absoluta além de \(\delta\) | \(y - F\), cortado em \(\pm\delta\) | — |
| log loss (classificação) | \(-[y \ln p + (1-y)\ln(1-p)]\), \(p = \sigma(F)\) | \(y - p\) | log-odds da taxa base |
Etapa 1. A perda decide o que a próxima árvore escuta. Transforme o último ponto do exemplo num outlier, \(y_6 = 40\) em vez de 14:
y_out = np.array([2, 3, 4, 9, 10, 40])
F0_sq, F0_abs = y_out.mean(), np.median(y_out)
print(f"squared loss : F0 = {F0_sq:.2f} (mean)   pseudo-residuals {np.round(y_out - F0_sq, 2)}")
print(f"absolute loss: F0 = {F0_abs:.2f} (median) pseudo-residuals {np.sign(y_out - F0_abs)}")
squared loss : F0 = 11.33 (mean)   pseudo-residuals [-9.33 -8.33 -7.33 -2.33 -1.33 28.67]
absolute loss: F0 = 6.50 (median) pseudo-residuals [-1. -1. -1.  1.  1.  1.]
Na perda quadrática, o pseudo-resíduo do outlier (28,67) é três vezes maior que qualquer outro, então o primeiro toco vai gastar seu corte nesse único ponto. Na perda absoluta, todo ponto empurra com a mesma força, \(\pm 1\): o outlier pede "mais alto" com a mesma força que o 9 e o 10. É por isso que loss='absolute_error' ou loss='huber' são a escolha quando o alvo tem caudas pesadas; loss='quantile' ajusta um quantil em vez da média, o que dá intervalos de previsão. Mudar a perda muda uma linha do algoritmo.
7. Classificação: boosting do log-odds
Para um alvo 0/1, o ensemble não soma probabilidades (uma soma de árvores poderia sair de \([0, 1]\)). Ele soma log-odds — exatamente a quantidade \(F\) da regressão logística — e transforma a soma em probabilidade com a sigmoide, \(p = 1/(1 + e^{-F})\). O pseudo-resíduo da log loss é \(y - p\): quão longe a probabilidade atual está do rótulo.
Seis pontos de novo, agora com rótulo 0 ou 1:
| \(x\) | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| \(y\) | 0 | 1 | 0 | 1 | 1 | 1 |
À mão, uma rodada com \(\eta = 0{,}5\).
- \(F_0\) é o log-odds da taxa base: 4 positivos em 6, \(p = 2/3\), \(F_0 = \ln\frac{2/3}{1/3} = \ln 2 = 0{,}693\).
- Pseudo-resíduos \(y - p\): \(-0{,}667;\ 0{,}333;\ -0{,}667;\ 0{,}333;\ 0{,}333;\ 0{,}333\).
- A busca do toco nesses números escolhe o corte \(x < 3{,}5\) (SSE 0,667, contra 0,8 do segundo melhor).
- Aqui os valores das folhas não são o pseudo-resíduo médio. O scikit-learn dá um passo de Newton em cada folha: a soma dos gradientes dividida pela soma das derivadas segundas, \(\sum (y_i - p_i) / \sum p_i (1 - p_i)\). Folha da esquerda: \((-0{,}667 + 0{,}333 - 0{,}667) / (3 \times \tfrac{2}{9}) = -1/\tfrac{2}{3} = -1{,}5\). Folha da direita: \(+1/\tfrac{2}{3} = +1{,}5\).
- \(F_1 = 0{,}693 - 0{,}5 \times 1{,}5 = -0{,}057\) à esquerda e \(0{,}693 + 0{,}75 = 1{,}443\) à direita. Pela sigmoide: \(p = 0{,}486\) e \(p = 0{,}809\).
from sklearn.ensemble import GradientBoostingClassifier

yc = np.array([0, 1, 0, 1, 1, 1])
p0 = yc.mean()
F0 = np.log(p0 / (1 - p0))                               # log-odds da taxa base
g = yc - p0                                              # pseudo-resíduos y - p
left = x.ravel() < 3.5
newton = lambda m: g[m].sum() / (p0 * (1 - p0) * m.sum())  # um passo de Newton por folha
F1 = F0 + 0.5 * np.where(left, newton(left), newton(~left))
p1 = 1 / (1 + np.exp(-F1))
log_loss = lambda p: -np.mean(yc * np.log(p) + (1 - yc) * np.log(1 - p))
print(f"F0 = {F0:.3f} · leaves {newton(left):+.2f} / {newton(~left):+.2f}")
print(f"by hand     : F1 = {F1.round(3)} · p1 = {p1.round(3)}")

clf = GradientBoostingClassifier(n_estimators=1, max_depth=1, learning_rate=0.5).fit(x, yc)
print(f"scikit-learn: F1 = {clf.decision_function(x).round(3)} · p1 = {clf.predict_proba(x)[:, 1].round(3)}")
print(f"log loss: {log_loss(np.full(6, p0)):.3f} before, {log_loss(p1):.3f} after one round")
F0 = 0.693 · leaves -1.50 / +1.50
by hand     : F1 = [-0.057 -0.057 -0.057  1.443  1.443  1.443] · p1 = [0.486 0.486 0.486 0.809 0.809 0.809]
scikit-learn: F1 = [-0.057 -0.057 -0.057  1.443  1.443  1.443] · p1 = [0.486 0.486 0.486 0.809 0.809 0.809]
log loss: 0.637 before, 0.448 after one round
A biblioteca concorda até a terceira casa decimal; um toco baixa a log loss de 0,637 para 0,448. O passo de Newton divide por \(p(1-p)\), a curvatura da log loss: onde o modelo ainda está em dúvida (\(p\) perto de 0,5) a curvatura é maior e o passo é cauteloso; onde ele já está confiante, o passo pode ser maior. Guarde essa fórmula: o XGBoost a usa para qualquer perda e acrescenta uma penalidade a ela, mais abaixo.
8. AdaBoost, o ancestral
O gradient boosting não foi o primeiro algoritmo de boosting. O AdaBoost (Freund & Schapire, 1997) respondeu à pergunta dos aprendizes fracos com outro mecanismo: em vez de ajustar resíduos, ele repondera os pontos de treino. Cada rodada treina um toco nos dados ponderados, depois aumenta o peso dos pontos que ele errou e diminui o dos outros, de modo que o próximo toco é forçado a olhar para os casos difíceis. Com rótulos \(\pm 1\) e um toco de erro ponderado \(\varepsilon\):
O classificador final é o sinal do voto ponderado \(\sum_m \alpha_m h_m(x)\): um toco de erro pequeno ganha um \(\alpha\) grande. Dez pontos, pesos iguais, um toco que erra três deles:
w = np.full(10, 0.1)
wrong = np.array([0, 0, 1, 0, 0, 1, 0, 0, 1, 0], dtype=bool)   # 3 pontos errados
eps = w[wrong].sum()
alpha = 0.5 * np.log((1 - eps) / eps)
w = w * np.exp(np.where(wrong, alpha, -alpha))
w = w / w.sum()
print(f"error {eps:.1f} · vote alpha {alpha:.3f}")
print(f"new weight of a misclassified point {w[wrong][0]:.4f}, of a correct one {w[~wrong][0]:.4f}")
print(f"total weight on the misclassified points: {w[wrong].sum():.2f}")
error 0.3 · vote alpha 0.424
new weight of a misclassified point 0.1667, of a correct one 0.0714
total weight on the misclassified points: 0.50
Cada um dos três pontos difíceis passou de 10% para 16,7% do peso; juntos, eles agora têm exatamente metade dele. Não é coincidência destes números: depois da atualização, o toco anterior sempre tem erro ponderado de exatamente 50%, o nível de uma moeda, então o próximo toco não pode simplesmente repeti-lo e precisa achar algo novo. Friedman, Hastie & Tibshirani (2000) mostraram depois que o AdaBoost é gradient boosting disfarçado, com a perda exponencial \(e^{-yF}\); o gradient boosting o generalizou para qualquer perda e, por isso, o substituiu na prática.
Empilhar aprendizes fracos realmente produz um forte? O teste clássico (Hastie, Tibshirani & Friedman, The Elements of Statistical Learning, §10.1): 10 atributos gaussianos, o rótulo é \(+1\) quando a soma dos seus quadrados passa de 9,34, 2.000 pontos de treino e 10.000 de teste.
from sklearn.datasets import make_hastie_10_2
from sklearn.ensemble import AdaBoostClassifier
from sklearn.tree import DecisionTreeClassifier

Xh, yh = make_hastie_10_2(n_samples=12000, random_state=1)
Xh_tr, yh_tr, Xh_te, yh_te = Xh[:2000], yh[:2000], Xh[2000:], yh[2000:]
contenders = {
    'one stump':                    DecisionTreeClassifier(max_depth=1),
    'one deep tree':                DecisionTreeClassifier(random_state=0),
    'AdaBoost, 400 stumps':         AdaBoostClassifier(DecisionTreeClassifier(max_depth=1),
                                                       n_estimators=400, random_state=0),
    'gradient boosting, 400 stumps': GradientBoostingClassifier(n_estimators=400, max_depth=1,
                                                                random_state=0),
}
for name, model in contenders.items():
    err = 1 - model.fit(Xh_tr, yh_tr).score(Xh_te, yh_te)
    print(f"{name:30s} test error {err:.1%}")
one stump                      test error 45.9%
one deep tree                  test error 24.5%
AdaBoost, 400 stumps           test error 11.6%
gradient boosting, 400 stumps  test error 11.1%
Aqui um toco é quase uma moeda (45,9% de erro): nenhum corte num único atributo diz muito sobre uma soma de dez quadrados. Uma árvore crescida até o fim chega a 24,5%. Quatrocentos tocos, cada um tão fraco quanto o primeiro, chegam a 11,6% (AdaBoost) e 11,1% (gradient boosting): os aprendizes fracos, combinados, têm menos da metade do erro da árvore forte.
9. Os outros botões, um de cada vez
Etapa 2. Com \(\eta = 0{,}1\) e a parada antecipada fixos, mude um botão de cada vez e meça-o com validação cruzada de 5 folds (aula de validação cruzada), sempre nos mesmos folds:
from sklearn.model_selection import KFold, cross_validate

cv_h = KFold(n_splits=5, shuffle=True, random_state=0)
base = dict(learning_rate=0.1, max_iter=5000, early_stopping=True, n_iter_no_change=20, random_state=0)
variants = {'defaults (31 leaves)': {},
            'max_leaf_nodes=8': {'max_leaf_nodes': 8},
            'max_leaf_nodes=127': {'max_leaf_nodes': 127},
            'min_samples_leaf=200': {'min_samples_leaf': 200},
            'l2_regularization=10': {'l2_regularization': 10},
            'max_features=0.5': {'max_features': 0.5}}
for name, extra in variants.items():
    r = cross_validate(HistGradientBoostingRegressor(**base, **extra), X_h, y_h, cv=cv_h,
                       scoring='neg_root_mean_squared_error', return_estimator=True)
    trees = np.mean([m.n_iter_ for m in r['estimator']])
    print(f"{name:21s} RMSE {-r['test_score'].mean():.1f} ± {r['test_score'].std():.1f} · {trees:4.0f} trees")
defaults (31 leaves)  RMSE 45.8 ± 0.6 ·  350 trees
max_leaf_nodes=8      RMSE 46.3 ± 0.8 ·  736 trees
max_leaf_nodes=127    RMSE 45.9 ± 0.6 ·  179 trees
min_samples_leaf=200  RMSE 46.4 ± 0.3 ·  452 trees
l2_regularization=10  RMSE 45.5 ± 0.4 ·  419 trees
max_features=0.5      RMSE 45.8 ± 0.7 ·  343 trees
Uma vez que a taxa de aprendizado e o número de árvores estão certos, os outros botões quase não importam nestes dados: toda variante fica entre 45,5 e 46,4, no máximo 0,6 longe dos padrões, que é o tamanho do próprio desvio padrão entre folds dos padrões (0,6). Seria preciso a comparação pareada da aula de validação cruzada antes de declarar qualquer uma delas melhor. O que os botões mudam é quantas árvores são necessárias: árvores de 8 folhas precisam de 736 em média, árvores de 127 folhas de 179. Tamanho da árvore e número de árvores se compensam, como a taxa de aprendizado e o número de árvores. Em dados menores ou mais ruidosos, em que o sobreajuste chega antes, min_samples_leaf, a penalidade L2 e a subamostragem fazem diferença; é por isso que eles entram na busca, não numa receita fixa.
O HistGradientBoosting* não tem subamostragem de linhas; o XGBoost e o LightGBM têm (subsample, que o LightGBM só aplica quando subsample_freq > 0); uma simulação do lab avançado (passo 7) a mede.
Uma ordem de ajuste que funciona
- Fixe uma taxa de aprendizado moderada (0,05–0,1) e ligue a parada antecipada, para que o número de árvores se resolva sozinho. 2. Ajuste o tamanho da árvore (
max_leaf_nodes/max_depth/num_leaves) e o tamanho da folha, com validação cruzada. 3. Experimente subamostragem de linhas e colunas e a penalidade L2. 4. Para o modelo final, baixe a taxa de aprendizado (e deixe a parada antecipada somar árvores) se o tempo extra de treino couber. As buscas aleatória e bayesiana da aula de AutoML fazem os passos 2–3 com mais eficiência que uma grade.
10. As bibliotecas modernas
Etapa 3. O algoritmo de Friedman, como no GradientBoostingRegressor, ordena cada atributo a cada corte. As bibliotecas que tornaram o boosting o padrão para dados tabulares mantêm o algoritmo e mudam a engenharia.
Histogramas (LightGBM, XGBoost com tree_method='hist', os HistGradientBoosting* do scikit-learn). Antes do treino, cada atributo é cortado em no máximo 255 faixas pelos seus quantis; toda busca de corte percorre as fronteiras das faixas em vez dos valores ordenados. O custo de um corte passa a depender só do número de faixas, não do número de valores distintos; a perda de precisão é desprezível. As faixas trazem duas coisas de graça: valores faltantes ganham uma faixa própria, com a árvore aprendendo em cada corte se eles vão para a esquerda ou para a direita; e atributos categóricos podem ser divididos diretamente em grupos de categorias, sem one-hot (categorical_features='from_dtype' lê o dtype category do pandas, como no código acima).
O XGBoost (Chen & Guestrin, 2016) acrescenta uma penalidade a cada árvore e usa a derivada segunda da perda em todo passo. Para uma árvore com \(T\) folhas e valores de folha \(w_j\), o objetivo de uma rodada é
e uma expansão de segunda ordem da perda dá o melhor valor de cada folha em forma fechada, com \(G_j\) e \(H_j\) as somas das derivadas primeiras e segundas na folha:
Com \(\lambda = 0\), isso é exatamente o passo de Newton calculado à mão no exemplo de classificação: folha da esquerda \(G = \sum (p - y) = 1\), \(H = \sum p(1-p) = 0{,}667\), \(w^* = -1{,}5\). Com reg_lambda=1 (o padrão do XGBoost), \(w^* = -1/1{,}667 = -0{,}6\): a penalidade puxa para zero as folhas pequenas e mal sustentadas, a ideia do Ridge aplicada dentro da árvore. \(\gamma\) cobra por cada folha extra, então um corte só é mantido se baixar a perda mais que \(\gamma\).
O LightGBM (Ke et al., 2017) cresce as árvores folha a folha (leaf-wise): em vez de dividir todos os nós de um nível antes de passar ao próximo, ele sempre divide a folha cujo corte mais baixa a perda, em qualquer lugar da árvore. Para o mesmo número de folhas isso ajusta mais, então o seu principal botão de tamanho é num_leaves, não max_depth (os HistGradientBoosting* do scikit-learn também crescem folha a folha, com max_leaf_nodes). Dois truques a mais o deixam rápido em dados grandes: o GOSS mantém todas as linhas de gradiente grande e amostra as demais; o EFB junta num só os atributos esparsos que nunca são não nulos ao mesmo tempo.
O CatBoost (Prokhorenkova et al., 2018) é especializado em atributos categóricos: ele codifica cada categoria pela média do alvo das linhas vistas antes dela numa ordem aleatória (assim uma linha nunca vê o próprio rótulo, uma proteção embutida contra vazamento do alvo) e cresce árvores simétricas, em que todos os nós de um nível usam o mesmo corte.
Os mesmos botões, com quatro nomes:
| ideia | scikit-learn HistGradientBoosting* | XGBoost | LightGBM | CatBoost |
|---|---|---|---|---|
| taxa de aprendizado | learning_rate | learning_rate (eta) | learning_rate | learning_rate |
| número de árvores | max_iter | n_estimators | n_estimators | iterations |
| tamanho da árvore | max_leaf_nodes, max_depth | max_depth, max_leaves | num_leaves, max_depth | depth |
| tamanho da folha | min_samples_leaf | min_child_weight (em unidades de derivada segunda) | min_child_samples | min_data_in_leaf |
| penalidade L2 nas folhas | l2_regularization | reg_lambda | reg_lambda | l2_leaf_reg |
| subamostragem de linhas | — | subsample | subsample (bagging_fraction) | subsample |
| subamostragem de colunas | max_features (por corte) | colsample_bytree | colsample_bytree | rsm |
| parada antecipada | early_stopping=True | early_stopping_rounds + eval_set | callbacks=[lgb.early_stopping(...)] | early_stopping_rounds |
O lab compara as implementações do scikit-learn, do XGBoost e do LightGBM nos mesmos folds, em qualidade e em tempo.
11. Floresta ou boosting?
Etapa 4. Os dois são ensembles de árvores, nenhum precisa de escalonamento, os dois lidam com interações e não linearidade. Qual escolher? Três medições no California housing, todas nos mesmos 5 folds.
Sem ajuste. Configurações padrão, fold a fold:
from sklearn.ensemble import RandomForestRegressor

X_codes = X_h.assign(ocean_proximity=X_h['ocean_proximity'].cat.codes)   # a floresta precisa de números
contenders = {'random forest, defaults': (RandomForestRegressor(n_jobs=-1, random_state=0), X_codes),
              'boosting, defaults': (HistGradientBoostingRegressor(random_state=0), X_h),
              'boosting, tuned': (HistGradientBoostingRegressor(
                  learning_rate=0.05, max_iter=5000, max_leaf_nodes=63, early_stopping=True,
                  n_iter_no_change=30, random_state=0), X_h)}
rmse, fit_time = {}, {}
for name, (model, data) in contenders.items():
    r = cross_validate(model, data, y_h, cv=cv_h, scoring='neg_root_mean_squared_error')
    rmse[name], fit_time[name] = -r['test_score'], r['fit_time'].mean()
    print(f"{name:24s} RMSE per fold {rmse[name].round(1)} → {rmse[name].mean():.1f}")
for other in ['boosting, defaults', 'boosting, tuned']:
    d = rmse['random forest, defaults'] - rmse[other]
    print(f"forest − {other:18s}: {d.round(1)} → {d.mean():+.1f} ± {d.std():.1f}")
random forest, defaults  RMSE per fold [49.7 48.6 48.7 49.2 49.3] → 49.1
boosting, defaults       RMSE per fold [47.4 47.3 47.4 47.8 47.9] → 47.5
boosting, tuned          RMSE per fold [45.6 45.  44.4 45.9 45.8] → 45.3
forest − boosting, defaults: [2.3 1.4 1.4 1.4 1.4] → +1.6 ± 0.4
forest − boosting, tuned   : [4.2 3.6 4.3 3.3 3.5] → +3.8 ± 0.4
Com os padrões, o boosting vence a floresta em todos os folds, por 1,4 a 2,3 mil dólares de RMSE (média +1,6 ± 0,4). O booster "ajustado" não é o resultado de uma busca, mas a leitura direta do experimento dos botões acima: uma taxa de aprendizado menor (0,05) com parada antecipada e árvores maiores (63 folhas). Ele chega a 45,3 e vence a floresta em todos os folds, por 3,3 a 4,3 (média +3,8 ± 0,4). Pela regra da aula de validação cruzada, as duas diferenças são muito maiores que o espalhamento das diferenças pareadas: são reais. A ressalva de sempre: essa configuração foi escolhida depois de olhar experimentos nos mesmos folds, então o seu 45,3 é um pouco otimista.
Sensibilidade ao ajuste. Sorteie 16 configurações aleatórias de cada família e avalie todas nos mesmos folds, com o R² como escore (script da figura). Floresta: max_features de 0,2 a 1,0 e min_samples_leaf de 1 a 20, 100 árvores. Boosting: taxa de aprendizado de 0,01 a 1, de 50 a 1.000 árvores sem parada antecipada, de 4 a 127 folhas, de 5 a 100 linhas por folha.
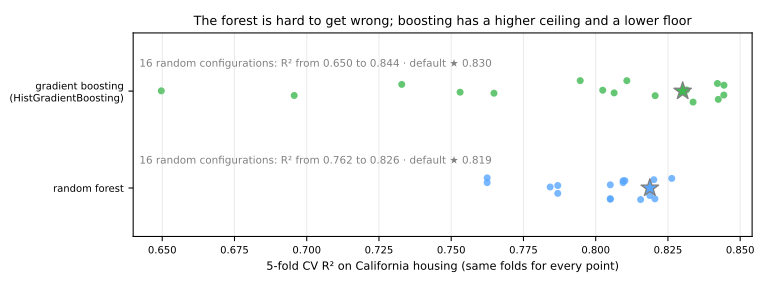
As 16 configurações da floresta ficam todas entre R² 0,762 e 0,826; os seus padrões (0,819) estão perto do topo: quase qualquer escolha dá uma floresta decente. As do boosting se espalham três vezes mais, de 0,650 a 0,844. As melhores vencem todas as florestas; até os seus padrões (0,830) vencem as 16. As piores não são exóticas, só descasadas: os três pontos mais baixos combinam uma taxa de aprendizado pequena (0,02 a 0,05) com só 50 ou 100 árvores e param muito antes de as curvas da figura da taxa de aprendizado chegarem ao fundo; no outro extremo, uma taxa perto de 0,7 ou 1 rodada por 100 a 1.000 árvores também termina abaixo dos padrões da floresta. A melhor, 0,047 com 1.000 árvores de 16 folhas, fica no meio. É por isso que o boosting é ajustado com parada antecipada: ela tira da busca o botão mais perigoso, o número de árvores.
Tempo. Os tempos de ajuste do primeiro bloco:
Os segundos dependem da máquina, então a sua saída vai ser diferente. A máquina que gerou esta página estava ocupada com outros trabalhos, então estes números foram medidos com cada modelo restrito a um núcleo de CPU (n_jobs=1 para a floresta, OMP_NUM_THREADS=1 para o booster), o que mantém a comparação justa:
random forest, defaults  11.5 s per fit
boosting, defaults       0.5 s per fit
boosting, tuned          2.7 s per fit
Num núcleo, a floresta leva 11,5 s por ajuste e o booster padrão 0,5 s, mais de vinte vezes menos: a floresta cresce 100 árvores completas em amostras bootstrap das 16.512 linhas de treino; o booster, no máximo 100 árvores pequenas sobre histogramas de 255 faixas. Até o booster ajustado, com árvores maiores, taxa de aprendizado menor e algumas centenas de árvores, leva 2,7 s. Os dois se paralelizam em mais núcleos: a floresta entre as árvores, o booster com histogramas dentro de cada árvore.
| Random forest | Gradient boosting | |
|---|---|---|
| as árvores são construídas | de forma independente, em paralelo | uma depois da outra, cada uma corrigindo as demais |
| cada árvore é | profunda, instável (viés baixo, variância alta) | rasa, estável (viés alto, variância baixa) |
| o ensemble reduz | a variância, tirando a média | o viés, somando |
| mais árvores | nunca atrapalham, só custam tempo | acabam sobreajustando: use parada antecipada |
| sem ajuste | muito boa, difícil de estragar | boa; configurações ruins podem ser muito piores |
| ajustada | um pouco melhor | em geral a melhor em dados tabulares |
| botões principais | max_features, min_samples_leaf | learning_rate + número de árvores, tamanho da árvore |
| extras de graça | erro out-of-bag, treino em paralelo | parada antecipada, faltantes e categorias nativos, perdas personalizadas |
Quando cada uma vence. Use uma floresta quando quiser um baseline forte quase sem ajuste, quando os dados forem pequenos e ruidosos ou quando precisar de uma estimativa honesta de erro de graça (out-of-bag). Use boosting quando os últimos pontos de qualidade importam e você pode pagar por um ajuste com validação cruzada, quando os dados são grandes (as implementações com histogramas são rápidas) ou quando a perda é incomum (quantis, ranqueamento, contagens de Poisson). Em dados tabulares, o gradient boosting ajustado ainda costuma vencer o deep learning (Grinsztajn et al., 2022); para imagens, áudio e texto, as redes neurais levam a melhor.
12. Perfil prático
| Gradient boosting (bibliotecas com histogramas) | |
|---|---|
| Dados | tabulares: colunas numéricas e categóricas, faltantes permitidos |
| Pré-processamento | nenhum obrigatório: sem escalonamento, sem imputação, sem one-hot (categorias com dtype category) |
| Tarefas | regressão (quadrática, absoluta, Huber, quantil, Poisson…), classificação binária e multiclasse, ranqueamento |
| Hiperparâmetros principais | taxa de aprendizado e número de árvores (via parada antecipada), tamanho da árvore, tamanho da folha, subamostragem, L2 |
| Custo de treino | sequencial nas árvores, paralelo dentro de cada árvore; as versões com histogramas lidam com milhões de linhas |
| Custo de previsão | uma descida por árvore: rápido |
| Modos de falha | sobreajusta com árvores demais e taxa de aprendizado alta; extrapola como constante fora da faixa do treino (como todo modelo de árvores); as probabilidades podem precisar de calibração |
| Interpretabilidade | não dá para ler árvore por árvore; use importância por permutação (no lab) ou valores SHAP, que têm um algoritmo exato e rápido para ensembles de árvores (Explicabilidade) |
Lab avançado — comparar, ajustar e testar
O lab fundamental terminou com um booster honesto (sem duration), em que a taxa de aprendizado de 0,1 com parada antecipada empatou com a de 0,03 por um terço do custo. Esta parte o compara com a floresta e com o XGBoost e o LightGBM nos mesmos folds, ajusta alguns botões, escolhe um limiar em previsões fora do fold, abre o teste uma vez e pergunta em que colunas o modelo se apoia. Continue no mesmo notebook, na mesma sessão: os passos abaixo usam X_dev, y_dev, cv, cv_eval, summary, categorical e results dos passos 1 a 5.
Como fazer este lab em aula (cerca de 40 min, em duplas)
- Continue no notebook do Colab, a partir do passo 6. Se a sessão caiu, rode antes as células dos passos 1 a 5 (Ambiente de execução → Executar anteriores).
- Como no lab fundamental: Preveja antes de rodar, compare com esta página e tente as Simulações antes de abrir a solução.
- Ritmo sugerido: passos 6 e 7 e a primeira simulação em 15 min (a floresta leva meio minuto); passo 8 em 10 min (a busca leva um ou dois minutos); passos 9 e 10 em 8 min; passo 11 e a segunda simulação em 7 min.
Passo 6 — a random forest, nos mesmos folds
Preveja. A floresta tira a média de árvores profundas; o boosting soma árvores pequenas. Nestes dados, a diferença entre os dois vai ser grande ou pequena?
from sklearn.ensemble import RandomForestClassifier

forest = make_pipeline(
    make_column_transformer((OrdinalEncoder(), categorical), remainder='passthrough'),
    RandomForestClassifier(n_estimators=300, min_samples_leaf=5, n_jobs=-1, random_state=42))
results['random forest'] = cv_eval(forest)
print('random forest', summary(results['random forest']))

a, b = results['HGB, η = 0.1'], results['random forest']
for metric in ['roc_auc', 'average_precision']:
    d = a['test_' + metric] - b['test_' + metric]
    print(f"HGB − forest, {metric:17s}: {d.round(3)} → {d.mean():+.3f} ± {d.std():.3f}")
random forest ROC AUC 0.790 ± 0.004 · AP 0.439 ± 0.015
HGB − forest, roc_auc          : [-0.001  0.006  0.005  0.005  0.011] → +0.005 ± 0.004
HGB − forest, average_precision: [0.006 0.01  0.005 0.011 0.004] → +0.007 ± 0.003
A floresta precisa de números, então as suas categorias passam por um OrdinalEncoder (árvores só precisam de uma ordem para cortar, não de colunas one-hot). min_samples_leaf=5 é uma escolha comum para um alvo ruidoso; ajustá-lo faz parte do Sua vez. A floresta chega a ROC AUC 0,790 e AP 0,439, logo atrás do booster. As diferenças pareadas decidem: o boosting está à frente em todos os cinco folds na AP (+0,007 ± 0,003) e em quatro de cinco no ROC AUC (+0,005 ± 0,004). Pela regra da aula de validação cruzada a diferença de AP é real, porque é mais que o dobro do espalhamento das diferenças. Ela também é pequena: menos de um ponto de AP. Nestes dados a floresta, quase sem ajuste, consegue quase tudo o que o booster consegue.
Passo 7 — XGBoost e LightGBM, mesmos folds
Preveja. O XGBoost, o LightGBM e o boosting do scikit-learn implementam o mesmo algoritmo. Algum deles vai se destacar na AP? E no tempo?
import lightgbm as lgb
import xgboost as xgb

results['XGBoost'] = cv_eval(xgb.XGBClassifier(
    n_estimators=300, learning_rate=0.05, max_depth=5, tree_method='hist',
    enable_categorical=True, n_jobs=-1, random_state=42, verbosity=0))
results['LightGBM'] = cv_eval(lgb.LGBMClassifier(
    n_estimators=300, learning_rate=0.05, num_leaves=31, n_jobs=-1, random_state=42, verbose=-1))
for name in ['HGB, η = 0.1', 'random forest', 'XGBoost', 'LightGBM']:
    print(f"{name:14s}", summary(results[name]))
HGB, η = 0.1   ROC AUC 0.795 ± 0.002 · AP 0.446 ± 0.014
random forest  ROC AUC 0.790 ± 0.004 · AP 0.439 ± 0.015
XGBoost        ROC AUC 0.798 ± 0.002 · AP 0.452 ± 0.013
LightGBM       ROC AUC 0.798 ± 0.004 · AP 0.447 ± 0.011
As três bibliotecas de boosting empatam: AP 0,446 (scikit-learn), 0,452 (XGBoost) e 0,447 (LightGBM), diferenças de no máximo 0,006 contra desvios padrão entre folds de 0,011–0,015; ROC AUC de 0,795–0,798. Elas implementam o mesmo algoritmo; o que muda é a engenharia em volta. As configurações também não são idênticas (300 árvores fixas com η = 0,05 para o XGBoost e o LightGBM, parada antecipada para o scikit-learn); uma diferença desse tamanho poderia se inverter com outra semente. As três estão à frente da floresta (AP 0,439).
times = pd.DataFrame({name: {'fit (s)': r['fit_time'].mean(), 'predict (s)': r['score_time'].mean()}
                      for name, r in results.items()}).T
print(times.round(2))
Os tempos dependem da máquina, então esta saída vai ser diferente na sua. A máquina que gerou esta página estava ocupada com outros trabalhos, então estes números foram medidos com cada biblioteca restrita a um núcleo de CPU (n_jobs=1 para a floresta, o XGBoost e o LightGBM, OMP_NUM_THREADS=1 para o boosting do scikit-learn), o que mantém a comparação justa:
                          fit (s)  predict (s)
logistic regression          0.06         0.01
HGB, native categories       0.30         0.03
HGB, categories as codes     0.35         0.03
HGB, η = 0.5                 0.33         0.05
HGB, η = 0.1                 0.60         0.04
HGB, η = 0.03                1.52         0.12
random forest                9.67         0.45
XGBoost                      0.88         0.07
LightGBM                     0.77         0.18
Num núcleo, os três boosters ajustam um fold em menos de um segundo (0,60 s para o scikit-learn com η = 0,1, 0,88 s para o XGBoost, 0,77 s para o LightGBM); a floresta de 300 árvores profundas leva 9,67 s, mais de dez vezes mais. A taxa de aprendizado menor custa o que o passo anterior prometeu: η = 0,03 leva 1,52 s pelas suas cerca de três vezes mais árvores. A floresta também é a mais lenta para prever (0,45 s, contra 0,04–0,18 s dos boosters), porque cada previsão desce por 300 árvores profundas. Com vários núcleos (o código usa n_jobs=-1) tudo isso encolhe. Em 29.000 linhas qualquer booster é rápido; os truques de velocidade do LightGBM e do XGBoost importam em milhões de linhas, que este lab não tem.
Simulação: boosting estocástico. O gradient boosting estocástico (Friedman, 2002) sorteia uma fração das linhas para cada árvore e o XGBoost também sorteia as colunas, o truque de descorrelação da floresta. Acrescente subsample=0.8 e colsample_bytree=0.8 ao XGBoost do passo 7 e compare com ele fold a fold. A diferença é maior que o espalhamento das diferenças pareadas?
Solução
sub = cv_eval(xgb.XGBClassifier(
    n_estimators=300, learning_rate=0.05, max_depth=5, tree_method='hist', subsample=0.8,
    colsample_bytree=0.8, enable_categorical=True, n_jobs=-1, random_state=42, verbosity=0))
print('XGBoost            ', summary(results['XGBoost']))
print('XGBoost, subsample ', summary(sub))
d = sub['test_average_precision'] - results['XGBoost']['test_average_precision']
print(f"difference in AP per fold: {d.round(3)} → {d.mean():+.3f} ± {d.std():.3f}")
XGBoost             ROC AUC 0.798 ± 0.002 · AP 0.452 ± 0.013
XGBoost, subsample  ROC AUC 0.801 ± 0.002 · AP 0.454 ± 0.012
difference in AP per fold: [ 0.005  0.003 -0.002  0.     0.001] → +0.001 ± 0.002
A subamostragem sobe a AP em 0,001 em média, com um fold indo para o outro lado e outro empatado: +0,001 ± 0,002 é um empate pela regra da aula de validação cruzada. A ROC AUC sobe de 0,798 para 0,801, também dentro do ruído. Com cerca de 29.000 linhas de treino por fold e árvores pequenas, o booster tem pouca variância para cortar; a subamostragem costuma pesar mais em dados menores ou mais ruidosos — e, de quebra, deixa cada árvore mais barata.
Passo 8 — ajustar alguns botões com uma busca aleatória
Preveja. Dez configurações aleatórias, cada uma com parada antecipada: o ganho sobre o modelo do passo 5 vai ser maior ou menor que o ganho de tirar o vazamento ou de trocar a regressão logística pelo boosting?
from scipy.stats import loguniform, randint
from sklearn.model_selection import RandomizedSearchCV

space = {'learning_rate': loguniform(0.02, 0.3),
         'max_leaf_nodes': randint(8, 64),
         'min_samples_leaf': randint(10, 200),
         'l2_regularization': loguniform(1e-3, 10),
         'max_features': [0.5, 0.8, 1.0]}
search = RandomizedSearchCV(
    HistGradientBoostingClassifier(max_iter=2000, early_stopping=True, n_iter_no_change=30,
                                   random_state=42),
    space, n_iter=10, cv=cv, scoring='average_precision', random_state=42)
search.fit(X_dev, y_dev)
res = pd.DataFrame(search.cv_results_).sort_values('rank_test_score')
print(res[['param_learning_rate', 'param_max_leaf_nodes', 'param_min_samples_leaf',
           'mean_test_score', 'std_test_score']].head(4).round(3).to_string(index=False))
print(f"best AP {search.best_score_:.3f} (HGB, η = 0.1: "
      f"{results['HGB, η = 0.1']['test_average_precision'].mean():.3f})")
 param_learning_rate  param_max_leaf_nodes  param_min_samples_leaf  mean_test_score  std_test_score
               0.046                    51                      98            0.453           0.016
               0.029                    29                      62            0.451           0.014
               0.068                    11                      98            0.451           0.013
               0.067                    18                      97            0.451           0.015
best AP 0.453 (HGB, η = 0.1: 0.446)
Dez configurações aleatórias, cada uma com parada antecipada, todas avaliadas nos mesmos folds. A melhor (taxa de aprendizado 0,046, 51 folhas, pelo menos 98 linhas por folha) chega a AP 0,453, contra 0,446 do modelo com η = 0,1 do passo 5. As quatro melhores configurações estão a 0,002 umas das outras e cada uma tem desvio padrão entre folds de 0,013–0,016, então a busca achou um platô, não um pico; o seu vencedor é o melhor de dez estimativas ruidosas (a maldição do vencedor da aula de validação cruzada). Compare os ganhos: tirar o vazamento mudou a AP em 0,18, passar de um modelo linear para boosting em 0,045, ajustar em 0,007. Vale a pena ajustar, mas depois das perguntas sobre os dados, não no lugar delas. Para buscas maiores, a busca aleatória é a ferramenta certa e a otimização bayesiana (Optuna) é melhor; as duas estão na aula de AutoML.
Passo 9 — escolher o limiar em previsões fora do fold
Preveja. Com 11,7% de positivos, o limiar que maximiza o F1 vai ficar acima ou abaixo de 0,5? Que fração dos clientes o banco acabaria ligando?
from sklearn.metrics import precision_recall_curve
from sklearn.model_selection import cross_val_predict

best = search.best_estimator_                   # reajustado em todo o X_dev pela busca
oof = cross_val_predict(best, X_dev, y_dev, cv=cv, method='predict_proba')[:, 1]
precision, recall, thresholds = precision_recall_curve(y_dev, oof)
f1 = 2 * precision * recall / (precision + recall + 1e-12)
k = f1[:-1].argmax()
threshold = thresholds[k]
print(f"threshold {threshold:.3f} · out-of-fold precision {precision[k]:.3f} · "
      f"recall {recall[k]:.3f} · F1 {f1[k]:.3f}")
print(f"share of clients flagged: {(oof >= threshold).mean():.1%}")
threshold 0.218 · out-of-fold precision 0.457 · recall 0.526 · F1 0.489
share of clients flagged: 13.5%
O cross_val_predict dá a cada linha de desenvolvimento uma probabilidade vinda de um modelo que não treinou nela, então o limiar pode ser escolhido em previsões honestas sem tocar no teste (a aula de ROC e dados desbalanceados o escolheu num split de validação; aqui são 36.168 previsões). Maximizar o F1 dá um limiar de 0,218, bem abaixo de 0,5, como esperado com 11,7% de positivos. Nesse limiar o banco ligaria para 13,5% dos clientes; 45,7% dessas ligações seriam de assinantes (contra 11,7% ligando ao acaso, cerca de quatro vezes melhor); essas ligações alcançariam 52,6% de todos os assinantes. O F1 pesa precisão e recall igualmente; com o custo real de uma ligação e o valor de um depósito, o banco escolheria o limiar que maximiza o lucro, na mesma curva.
Passo 10 — o único teste
Preveja. A AP de teste vai ficar perto dos 0,453 da validação cruzada? E a precisão e o recall, perto das estimativas fora do fold do passo 9?
from sklearn.metrics import average_precision_score, confusion_matrix, roc_auc_score

proba = best.predict_proba(X_test)[:, 1]
pred = (proba >= threshold).astype(int)
print(f"test ROC AUC {roc_auc_score(y_test, proba):.3f} · AP {average_precision_score(y_test, proba):.3f}")
print(confusion_matrix(y_test, pred, labels=[1, 0]))
tp, fn, fp, tn = confusion_matrix(y_test, pred, labels=[1, 0]).ravel()
print(f"precision {tp / (tp + fp):.3f} · recall {tp / (tp + fn):.3f}")
Uma vez, no fim, o booster ajustado encontra os 9.043 clientes de teste: ROC AUC 0,804, AP 0,465, um pouco acima dos 0,453 da validação cruzada e dentro de um desvio padrão entre folds. No limiar escolhido no passo 9, o modelo marca 1.209 clientes (641 + 568, 13,4%): 568 deles assinam (precisão de 0,470), o que corresponde a 53,7% dos 1.058 assinantes do conjunto de teste. Os dois números batem com as estimativas fora do fold do passo 9 (0,457 e 0,526), que é a cara de um pipeline sem vazamento. Os 490 assinantes que o modelo perde são o preço de ligar só para 13% da lista.
Passo 11 — quais colunas o modelo usa?
Preveja. Que colunas você espera que o modelo mais use para prever quem assina? Alguma delas pode descrever o momento da campanha e não o cliente?
from sklearn.inspection import permutation_importance

imp = permutation_importance(best, X_test, y_test, scoring='average_precision',
                             n_repeats=5, random_state=42)
print(pd.Series(imp.importances_mean, index=X_test.columns).sort_values(ascending=False).head(6).round(3))
A importância por permutação embaralha uma coluna de cada vez no conjunto de teste e mede quanto a AP cai: uma coluna em que o modelo se apoia faz falta quando embaralhada. O mês do contato (0,139) e o resultado da campanha anterior (0,132) dominam, seguidos do canal de contato e do dia do mês. Leia o primeiro com espírito crítico. Segundo a documentação da UCI, as linhas estão em ordem temporal (de maio de 2008 a novembro de 2010) e uma divisão aleatória mistura esses períodos. Um modelo que se apoia no mês pode estar aprendendo quando o banco teve sucesso nas ligações, um padrão que não precisa valer no ano seguinte; só uma divisão cronológica (TimeSeriesSplit, aula de validação cruzada) pode dizer. Ensembles de árvores não se leem árvore por árvore; a importância por permutação dá uma visão global; os valores SHAP, que têm um algoritmo exato e rápido para ensembles de árvores, explicam previsões individuais (Explicabilidade).
Simulação: e no ano seguinte? As linhas estão em ordem de tempo (de maio de 2008 a novembro de 2010), mas o lab dividiu os dados ao acaso. Simule o uso real: treine a configuração vencedora do passo 8 nos primeiros 80% das linhas e teste nos últimos 20%; compare com o teste aleatório do passo 10. Leia a AP junto com a fração de positivos de cada teste.
Solução
from sklearn.metrics import average_precision_score, roc_auc_score

Xt = X.drop(columns='duration')
cut = int(0.8 * len(Xt))                               # as linhas estão em ordem de tempo
splits = {'random 80/20 (as in the lab)': (X_dev.index, X_test.index),
          'chronological: first 80% → last 20%': (Xt.index[:cut], Xt.index[cut:])}
for name, (a, b) in splits.items():
    m = HistGradientBoostingClassifier(max_iter=2000, early_stopping=True, n_iter_no_change=30,
                                       random_state=42, **search.best_params_)
    m.fit(Xt.loc[a], y.loc[a])
    p = m.predict_proba(Xt.loc[b])[:, 1]
    print(f"{name:37s} test positives {y.loc[b].mean():.1%} · ROC AUC {roc_auc_score(y.loc[b], p):.3f}"
          f" · AP {average_precision_score(y.loc[b], p):.3f}")
random 80/20 (as in the lab)          test positives 11.7% · ROC AUC 0.804 · AP 0.465
chronological: first 80% → last 20%   test positives 31.6% · ROC AUC 0.685 · AP 0.494
No teste cronológico a ROC AUC cai de 0,804 para 0,685: o modelo ordena os clientes do período seguinte muito pior que os do mesmo período, misturados. A AP sobe (0,494), mas só porque o último período tem 31,6% de assinantes, quase o triplo; comparada à prevalência, ela cai de 4,0 vezes a de uma lista aleatória (0,465 / 0,117) para 1,6 vez (0,494 / 0,316). O mês e o resultado da campanha anterior, as duas colunas mais importantes do passo 11, descrevem um banco que mudou com o tempo. A divisão aleatória respondeu "quão bem o modelo interpola dentro desse período?"; a pergunta do banco é "quão bem ele prevê o próximo?" e só a divisão cronológica a responde.
Para fechar a aula. Em uma frase cada: (1) por que as três bibliotecas de boosting empatam na AP, mas não no tempo? (2) Por que o limiar pode ser escolhido nas previsões fora do fold, sem gastar o teste? (3) O que a divisão cronológica revelou que a divisão aleatória escondia?
Sua vez (avançado)
Para casa, com mais tempo:
- Parada antecipada dentro do XGBoost e do LightGBM. Separe 10% de
X_dev(estratificado) como conjunto de avaliação e ajustexgb.XGBClassifier(n_estimators=3000, learning_rate=0.03, early_stopping_rounds=50, ...)comeval_set=[(X_eval, y_eval)]; faça o mesmo com o LightGBM, usandocallbacks=[lgb.early_stopping(50)]. Quantas árvores cada um mantém? Compare com on_iter_do passo 5. - Uma floresta ajustada. Ajuste
max_featuresemin_samples_leafda floresta com umRandomizedSearchCVdo mesmo tamanho do passo 8, no mesmocv. Ela fecha a distância para o booster ajustado? Depois leia a aula de AutoML e refaça o passo 8 com o Optuna e 50 tentativas: quanto do ganho as 10 tentativas aleatórias já tinham capturado? - Validação no tempo. Refaça a comparação do passo 4 (regressão logística contra o booster) com
TimeSeriesSplit(n_splits=5)sobre as linhas em ordem original, semduration. O booster ainda vence? Por quanto e com que espalhamento entre folds?
Referências
- Schapire, R. E. "The Strength of Weak Learnability." Machine Learning 5 (1990): 197–227 — a primeira prova de que aprendizes fracos podem ser "boostados". DOI
- Freund, Y.; Schapire, R. E. "A Decision-Theoretic Generalization of On-Line Learning and an Application to Boosting." Journal of Computer and System Sciences 55, n. 1 (1997): 119–139 — o AdaBoost. DOI
- Friedman, J. H.; Hastie, T.; Tibshirani, R. "Additive Logistic Regression: A Statistical View of Boosting." Annals of Statistics 28, n. 2 (2000): 337–407 — o AdaBoost como ajuste por etapas da perda exponencial. DOI
- Friedman, J. H. "Greedy Function Approximation: A Gradient Boosting Machine." Annals of Statistics 29, n. 5 (2001): 1189–1232 — gradient boosting, encolhimento, pseudo-resíduos. DOI
- Friedman, J. H. "Stochastic Gradient Boosting." Computational Statistics & Data Analysis 38, n. 4 (2002): 367–378 — subamostragem de linhas. DOI
- Chen, T.; Guestrin, C. "XGBoost: A Scalable Tree Boosting System." KDD (2016): 785–794. DOI
- Ke, G.; Meng, Q.; Finley, T.; Wang, T.; Chen, W.; Ma, W.; Ye, Q.; Liu, T.-Y. "LightGBM: A Highly Efficient Gradient Boosting Decision Tree." Advances in Neural Information Processing Systems 30 (2017). Link
- Prokhorenkova, L.; Gusev, G.; Vorobev, A.; Dorogush, A. V.; Gulin, A. "CatBoost: Unbiased Boosting with Categorical Features." Advances in Neural Information Processing Systems 31 (2018). arXiv
- Hastie, T.; Tibshirani, R.; Friedman, J. The Elements of Statistical Learning, 2ª ed. Springer (2009), capítulo 10 — boosting e árvores aditivas; o problema de teste com 10 atributos. DOI
- Grinsztajn, L.; Oyallon, E.; Varoquaux, G. "Why Do Tree-Based Models Still Outperform Deep Learning on Typical Tabular Data?" NeurIPS Datasets and Benchmarks (2022). arXiv
- Pace, R. K.; Barry, R. "Sparse Spatial Autoregressions." Statistics & Probability Letters 33, n. 3 (1997): 291–297 — os dados do California housing. DOI
- Moro, S.; Cortez, P.; Rita, P. "A Data-Driven Approach to Predict the Success of Bank Telemarketing." Decision Support Systems 62 (2014): 22–31 — o conjunto de dados do lab (OpenML 1461). DOI
- XGBoost / LightGBM — gradient boosting.
Quiz
O quiz cobre a abordagem fundamental.