O caminho desta parte
- Qualquer perda, o mesmo laçoperdas robustas, log-odds, AdaBoost
- Ajustar os outros botõestamanho da árvore, folhas, L2, com η fixo
- As bibliotecas modernashistogramas, XGBoost, LightGBM, CatBoost
- Floresta ou boosting?uma comparação justa, lado a lado
A perda decide o que a próxima árvore escuta
| perda | pseudo-resíduo \(-\partial L/\partial F\) | \(F_0\) |
|---|---|---|
| quadrática | \(y - F\) | média |
| absoluta | \(\operatorname{sinal}(y - F)\) | mediana |
| Huber | \(y - F\), cortado em \(\pm\delta\) | — |
| log loss | \(y - p\) | log-odds da taxa base |
Um outlier, \(y_6 = 40\): pseudo-resíduos quadráticos −9,33 … 28,67; absolutos, todos \(\pm 1\).
Classificação: somar log-odds
- O ensemble soma \(F\) (log-odds) e usa a sigmoide: \(p = 1/(1 + e^{-F})\). Pseudo-resíduo: \(y - p\).
- Seis pontos, 4 positivos: \(F_0 = \ln 2 = 0{,}693\). O toco corta em \(x < 3{,}5\).
- Cada folha recebe um passo de Newton: \(\sum (y_i - p_i) / \sum p_i (1 - p_i) = \pm 1{,}5\).
Os 12 clientes de churn: média ou soma de tocos
O mesmo toco, sete vezes. Bagging: cada toco vê um bootstrap de \((x, y)\) e o modelo é a média das probabilidades. Boosting: cada toco vê os resíduos \(y - p\) e a folha é somada aos log-odds, × 0,5, com \(p = \sigma(F)\) — somar probabilidades poderia sair de \([0, 1]\). Preveja. No boosting, o segundo toco repete a pergunta do primeiro?
AdaBoost, o ancestral
- Em vez de resíduos, repondera os pontos: os errados ganham peso, o próximo toco é forçado a olhar para eles.
- Toco que erra 3 de 10: \(\alpha = \tfrac12 \ln\frac{0{,}7}{0{,}3} = 0{,}424\); cada ponto errado vai de 10% para 16,7%; juntos, metade do peso.
| 10 atributos, soma de quadrados (ESL §10.1) | erro de teste |
|---|---|
| um toco | 45,9% |
| uma árvore completa | 24,5% |
| AdaBoost, 400 tocos | 11,6% |
| gradient boosting, 400 tocos | 11,1% |
Simulador: AdaBoost nos 12 clientes de churn
O tamanho de cada cliente é o seu peso. Preveja. A rodada 1 (bill ≤ 82,5) erra H e K: quem cresce depois da rodada 2?
Os outros botões, com \(\eta\) e parada antecipada fixos
| California housing, CV 5-fold | RMSE | árvores |
|---|---|---|
| padrões (31 folhas) | 45,8 ± 0,6 | 350 |
max_leaf_nodes=8 | 46,3 ± 0,8 | 736 |
max_leaf_nodes=127 | 45,9 ± 0,6 | 179 |
min_samples_leaf=200 | 46,4 ± 0,3 | 452 |
l2_regularization=10 | 45,5 ± 0,4 | 419 |
Simulador: o erro mal se mexe, o número de árvores sim
Preveja. Qual variante sai da faixa de ruído dos padrões? E qual muda mais o número de árvores?
As bibliotecas modernas
- Histogramas (LightGBM, XGBoost
hist,HistGradientBoosting*): até 255 faixas por atributo; faltantes e categorias nativos. - XGBoost: penalidade por árvore e derivada segunda; o valor ótimo de cada folha é
- LightGBM: cresce folha a folha (
num_leaves), GOSS e EFB para dados grandes. - CatBoost: codifica categorias pela média do alvo das linhas anteriores, sem ver o próprio rótulo.
Simulador: a folha do XGBoost
\(w^* = -G/(H+\lambda)\); o corte fica se o ganho passar de \(\gamma\). Preveja. Nos 12 clientes, quando \(\lambda\) cresce, qual folha encolhe mais depressa: a de menos clientes ou a de mais?
Floresta ou boosting?
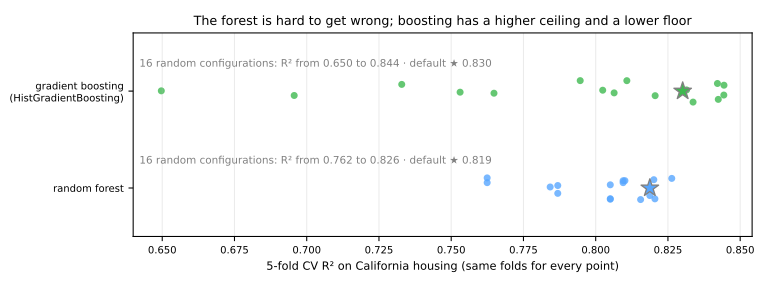
- Padrões, fold a fold: o boosting vence a floresta em todos os folds, +1,6 ± 0,4 mil de RMSE; ajustado, +3,8 ± 0,4.
- 16 configurações aleatórias: floresta de R² 0,762 a 0,826; boosting de 0,650 a 0,844.
Simulador: floresta ou boosting, ponto a ponto
Preveja. O que as piores configurações de boosting têm em comum? Clique nelas e depois troque para a vista do orçamento η × árvores.
Lado a lado
| Random forest | Gradient boosting | |
|---|---|---|
| árvores | independentes, profundas | em sequência, rasas |
| reduz | a variância (média) | o viés (soma) |
| mais árvores | nunca atrapalham | acabam sobreajustando |
| sem ajuste | muito boa | boa; ruins podem ser muito piores |
| ajustada | um pouco melhor | em geral a melhor em dados tabulares |
| de graça | OOB, treino paralelo | parada antecipada, faltantes, perdas |
Comparar, ajustar e testar, passos 6 a 11
- Mesmo notebook, mesma sessão: os passos usam
X_dev,cv,cv_eval,summaryeresults. - A floresta e o XGBoost e o LightGBM nos mesmos folds; uma busca aleatória; o limiar fora do fold; o teste, uma vez; as colunas que o modelo usa.
- Notebook no Colab, a partir do passo 6.
- Simulações: boosting estocástico (passo 7) e e no ano seguinte? (passo 11).
Ritmo: passos 6 e 7 e a primeira simulação em 15 min; passo 8 em 10 min; passos 9 e 10 em 8 min; passo 11 e a segunda em 7 min.