O caminho desta parte
- Somar, não tirar a médiaárvores pequenas em sequência removem o viés
- Boosting à mãoajustar os resíduos, somá-los encolhidos
- Resíduo é gradientedescida do gradiente nas previsões
- Frear e parartaxa de aprendizado e parada antecipada
Cada etapa responde a uma pergunta: por que somar árvores em vez de tirar a média? → o que cada nova árvore aprende? → por que o nome gradient boosting? → quantas árvores e que tamanho de passo?
Etapa 1 · por que somar árvores em vez de tirar a média?
Tirar a média ou somar?
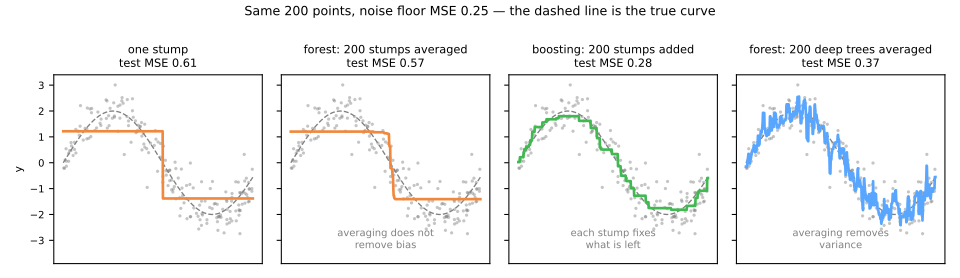
| 200 pontos, senoide | MSE de teste |
|---|---|
| um toco | 0,608 |
| floresta de 200 tocos | 0,572 |
| boosting de 200 tocos | 0,280 |
| uma árvore profunda | 0,509 |
| floresta de 200 árvores profundas | 0,369 |
Piso do ruído: 0,25.
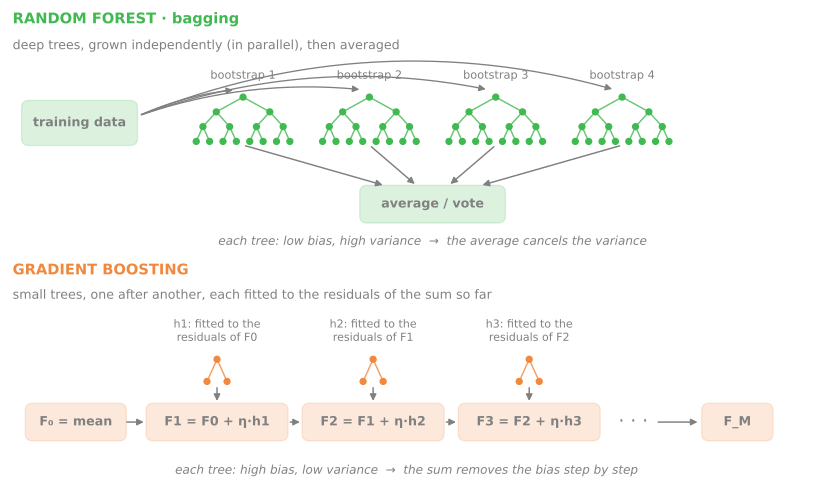
A média remove variância, não viés: 200 tocos em média ainda são um degrau. A soma remove viés: tocos ajustados aos erros seguem a curva.
Duas estratégias com o mesmo bloco
Etapa 2 · o que cada nova árvore aprende?
Boosting à mão: seis pontos
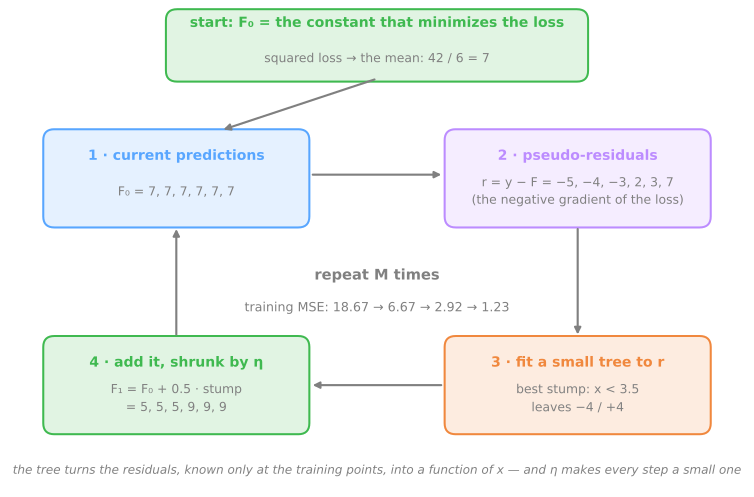
\(x = 1, \dots, 6\); \(y = 2, 3, 4, 9, 10, 14\); tocos; \(\eta = 0{,}5\). Preveja. Os primeiros resíduos vão de −5 a +7: onde o primeiro toco vai cortar?
O laço do boosting
Simulador: veja o resíduo encolher
Preveja. O mesmo laço em 60 pontos. Ponha ν = 1 com 6 tocos, depois ν = 0,15 com 40: qual ajusta melhor e como cada um chega lá?
Etapa 3 · por que o nome gradient boosting?
Por que "gradient": resíduos são um gradiente
\[ L(y, F) = \tfrac{1}{2}(y - F)^2, \qquad -\frac{\partial L}{\partial F} = y - F \]- O resíduo é o gradiente negativo da perda em relação à previsão.
- Boosting é gradiente descendente sobre as previsões; a árvore transforma o gradiente, conhecido só nos pontos de treino, numa função de \(x\).
F0(x) = a constante que minimiza Σ L(yᵢ, c)
para m = 1 .. M:
    rᵢ = −∂L(yᵢ, F)/∂F em F = F_{m−1}(xᵢ)     # pseudo-resíduos
    ajuste uma pequena árvore h_m a (xᵢ, rᵢ)
    F_m(x) = F_{m−1}(x) + η · h_m(x)
Cinco nomes que se confundem
| o que cada árvore nova recebe | como entra | |
|---|---|---|
| bagging | uma amostra bootstrap de \((x, y)\); árvores independentes | média |
| boosting | os mesmos \(x\), em sequência, com foco no que ainda erra | soma |
| AdaBoost | os mesmos \((x, y)\), com pesos maiores nos errados | voto ponderado por \(\alpha\) |
| gradient boosting | os mesmos \(x\), com o pseudo-resíduo como alvo | \(F \mathrel{+}= \eta\, h\) |
| XGBoost, LightGBM… | o mesmo gradient boosting + histogramas, Newton, penalidades | \(F \mathrel{+}= \eta\, h\) |
O boosting não sorteia linhas: de uma árvore para a outra muda o alvo, não a amostra. E o "gradient" é uma descida nas previsões, não nos pesos de um modelo.
Etapa 4 · quantas árvores e que tamanho de passo?
Taxa de aprendizado e número de árvores
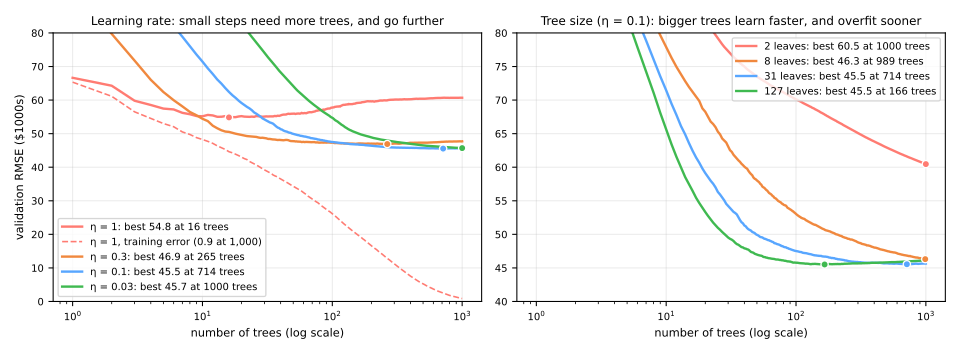
- \(\eta = 1\): mínimo depois de 16 árvores (54,8 mil) e sobe até 60,7, enquanto o treino cai a 0,9: sobreajuste somando árvores.
- \(\eta\) menor chega mais longe: 46,9 com \(\eta = 0{,}3\), 45,5 com \(\eta = 0{,}1\) (714 árvores).
A parada antecipada escolhe o número de árvores
- Separa uma fatia do treino (
validation_fraction), mede a perda depois de cada árvore e para depois den_iter_no_changerodadas sem melhora.
| California housing | árvores mantidas | RMSE de validação |
|---|---|---|
| \(\eta = 1{,}0\) | 41 | 56,4 |
| \(\eta = 0{,}3\) | 87 | 47,4 |
| \(\eta = 0{,}1\) | 337 | 46,0 |
O número de árvores vira uma saída. Com \(\eta\) grande, as árvores extras depois do mínimo já sobreajustam; dê mais paciência a taxas pequenas.
Resumo
- A média corta variância; a soma corta viés.
- Cada árvore é ajustada aos resíduos e entra encolhida: \(F_m = F_{m-1} + \eta\, h_m\).
- Os resíduos são o gradiente negativo da perda.
- Mais árvores podem piorar; \(\eta\) menor precisa de mais árvores e chega mais longe.
- A parada antecipada escolhe o número de árvores.
| sintoma | o que fazer |
|---|---|
| validação mínima cedo e depois subindo | baixar \(\eta\), ligar a parada antecipada |
| métricas boas demais para ser verdade | procurar uma coluna que conhece o futuro |
Lab fundamental · cerca de 35 min, em duplas
Quem vai assinar? Passos 1 a 5
- Telemarketing de um banco português: 45.211 clientes, 11,7% assinaram um depósito a prazo. Métrica: precisão média (AP).
- Um vazamento à vista; o booster padrão contra a regressão logística; taxa de aprendizado com parada antecipada.
- Notebook no Colab: nada para baixar; XGBoost e LightGBM já instalados.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: uma floresta de tocos contra um boosting de tocos (passo 4) e mais árvores, sem freio (passo 5).
Ritmo: passos 1 a 3 em 10 min; passo 4 e a primeira simulação em 12 min; passo 5 e a segunda em 13 min.