Por que a forma fechada não basta
A forma fechada dos mínimos quadrados ordinários (OLS, de ordinary least squares), \(\hat w = (X^\top X)^{-1}X^\top y\), resolve a regressão linear de uma vez. Mas:
não escala
inverter \(X^\top X\) custa \(O(d^3)\) para \(d\) atributos: inviável com muitíssimos atributos
não existe
para a maioria dos outros modelos, a começar pelas redes neurais
não freia
não diz nada sobre controlar o sobreajuste
O caminho desta parte
- Descer a ladeirao gradiente, deduzido e calculado à mão
- Ajustar o passoa taxa de aprendizado; batch, estocástico, mini-batch
- Retas → curvasatributos polinomiais; subajuste e sobreajuste
- Regularizarridge (L2), lasso (L1) e o botão α
Gradiente descendente: desça a ladeira
Em vez de resolver \(\nabla J = 0\) no papel: meça a inclinação onde você está, dê um passo contra ela, repita.
\[ w^{(t+1)} = w^{(t)} - \eta \, \nabla_w J\big(w^{(t)}\big) \]- \(J(w)\): a perda, o erro que o modelo comete com os pesos \(w\); \(t\): a iteração.
- \(\eta\): a taxa de aprendizado, o tamanho do passo.
- \(\nabla_w J\), o gradiente, aponta para onde a perda cresce mais rápido; o sinal de menos faz o método descer.
De onde vem o gradiente
\[ J(w_0, w_1) = \frac{1}{n}\sum_{i=1}^{n}\big(\underbrace{y_i - w_0 - w_1 x_i}_{e_i}\big)^2 \]\(n\) pontos \((x_i, y_i)\); \(e_i\) é o resíduo do ponto \(i\). Regra da cadeia: a derivada de \(e_i^2\) é \(2e_i\) vezes como o resíduo reage ao peso.
\(\partial e_i / \partial w_0 = -1\)
subir o intercepto em uma unidade baixa todo resíduo em uma unidade
\(\partial e_i / \partial w_1 = -x_i\)
subir a inclinação baixa o resíduo em \(x_i\): pontos longe da origem sentem mais
Gradiente descendente, à mão
Pontos \((1,2), (2,4), (3,7)\); partida em \(w_0 = w_1 = 0\); \(\eta = 0{,}1\). Preveja. Para que lado o primeiro passo move cada peso e quanto da perda de 23 ele tira?
A taxa de aprendizado
- \(\eta\) pequeno demais → passos minúsculos, convergência lenta
- \(\eta\) grande demais → os passos ultrapassam; a perda oscila ou diverge
- receita: experimente \(\eta \in \{10^{-3}, 10^{-2}, 10^{-1}\}\) e veja a perda de treino cair suavemente
Em \(J(w) = (w-3)^2\), inclinação \(2(w-3)\), subtraia 3 dos dois lados da atualização:
\[ w_{t+1} - 3 = (1 - 2\eta)\,(w_t - 3) \]a distância até o mínimo é multiplicada por \(1 - 2\eta\) a cada passo.
então, nesta perda
| \(\eta < 0{,}5\) | aproxima-se aos poucos |
| \(\eta = 0{,}5\) | o mínimo de uma vez |
| \(0{,}5 < \eta < 1\) | pula, mas fecha |
| \(\eta = 1\) | bate entre dois pontos para sempre |
| \(\eta > 1\) | explode |
Simulador: a taxa de aprendizado
Preveja. Defina \(\eta = 1{,}05\) e avance passo a passo. Converge, fica batendo para sempre ou explode?
Batch, estocástico e mini-batch
O gradiente soma sobre os \(n\) pontos: com milhões de linhas, um passo custa uma passada inteira pelos dados.
| variante | gradiente calculado sobre | custo por passo | comportamento |
|---|---|---|---|
| gradiente descendente (GD) em lote | o conjunto completo | \(O(nd)\) | descida exata e suave |
| GD estocástico (SGD) | uma amostra aleatória | \(O(d)\) | ruidoso mas barato; escapa de armadilhas rasas |
| mini-batch GD | um lote de ~32–512 | intermediário | o padrão moderno |
from sklearn.linear_model import SGDRegressor
model = SGDRegressor(loss='squared_error', penalty='l2', alpha=1e-4,
                     learning_rate='invscaling', max_iter=1000)
De retas a curvas: atributos polinomiais
A regressão linear é linear nos parâmetros, não nas entradas: \(x \mapsto (x, x^2, \dots, x^p)\) e o mesmo OLS ajusta os pesos.
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures

model = make_pipeline(PolynomialFeatures(degree=3), LinearRegression())
A flexibilidade corta dos dois lados
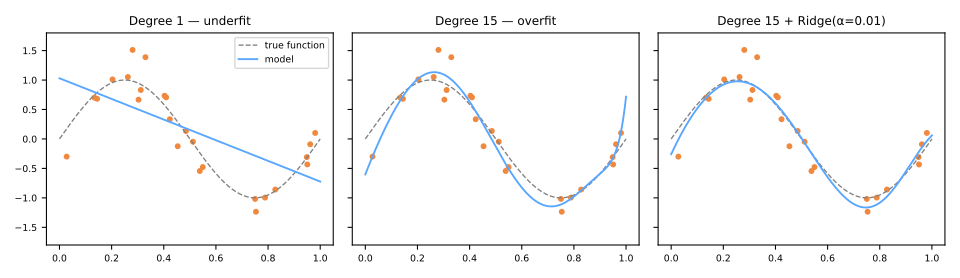
O grau 1 subajusta: rígido demais. O grau 15 sobreajusta: 16 parâmetros perseguem 25 pontos ruidosos. À direita: os mesmos 16 parâmetros mais uma penalidade Ridge e a curva relaxa de volta ao sinal.
Subajuste e sobreajuste, medidos
100 pontos de \(y = 0{,}5x^2 + x + 2\), ruído com desvio 3; validação cruzada de cinco dobras. RMSE: raiz do erro quadrático médio (root mean squared error), na unidade de \(y\).
| grau | RMSE de treino | RMSE de validação (média) | desvio entre as dobras |
|---|---|---|---|
| 1 | 3,22 | 3,26 | 0,19 |
| 2 | 2,64 | 2,75 | 0,33 |
| 30 | 2,46 | 10,43 | 13,46 |
Grau 30, dobra por dobra: \(3{,}14 \quad 3{,}02 \quad 5{,}51 \quad \mathbf{37{,}29} \quad 3{,}20\)
Um diagnóstico de bolso
| simples demais (subajuste) | complexo demais (sobreajuste) | |
|---|---|---|
| erro de treino | alto | baixo |
| erro de validação | alto, de forma consistente | alto na média, às vezes baixo |
| variação entre dobras | pequena | grande |
| o que fazer | mais capacidade, atributos melhores | regularizar, mais dados, menos capacidade |
Regularização: penalizar o tamanho
Ridge (L2) · Tikhonov 1943; Hoerl & Kennard 1970
\[ \lVert y - Xw \rVert^2 + \alpha \sum_j w_j^2 \]- encolhe suavemente, nunca exatamente a zero
- espalha o peso entre atributos correlacionados
- forma fechada: \((X^\top X + \alpha I)^{-1} X^\top y\)
Lasso (L1) · Tibshirani 1996
\[ \lVert y - Xw \rVert^2 + \alpha \sum_j \lvert w_j \rvert \]- cai exatamente em zero para atributos fracos
- seleção automática de atributos
- entre atributos correlacionados, fica com um ao acaso
\(\lVert y - Xw\rVert^2\): a soma dos erros quadráticos; \(\alpha \ge 0\): a força da penalidade. O L2 penaliza a soma dos quadrados dos pesos; o L1, a soma dos valores absolutos. A Elastic Net mistura as duas (l1_ratio).
Ridge e lasso num coeficiente, à mão
Um atributo, \(\sum x_i^2 = 1\), \(\alpha = 1\); \(\hat w\) é o coeficiente do OLS. Preveja. Qual penalidade consegue transformar \(\hat w = 0{,}2\) em exatamente zero e por quê?
O botão α
- \(\alpha \to 0\): OLS puro, sem freio.
- \(\alpha \to \infty\): todos os coeficientes esmagados para ~0, o modelo prevê a média.
- O \(\alpha\) certo não é conhecido de antemão: escolha-o por validação cruzada (
RidgeCV,LassoCV, uma busca em grade).
Resumo
- O gradiente descendente desce a ladeira: \(w \leftarrow w - \eta\nabla J\).
- No erro quadrático o gradiente é uma soma ponderada pelos resíduos: \(-\frac{2}{n}\sum e_i\), \(-\frac{2}{n}\sum e_i x_i\).
- \(\eta\) grande demais diverge, pequeno demais rasteja; mini-batches deixam cada passo barato.
- Sobreajuste = erro de treino baixo, erro de validação alto e imprevisível.
- O ridge divide os coeficientes, o lasso os subtrai e corta em zero; escalone antes e escolha \(\alpha\) por validação cruzada.
| sintoma | o que fazer |
|---|---|
| a perda cresce a cada passo | dividir \(\eta\) por 10 |
| erro de treino muito abaixo do de validação, dobras que discordam | regularizar, mais dados, menos capacidade |
Ladeira abaixo, um passo de cada vez, passos 1 a 3
- Passo 1: descer \(J(w) = (w-3)^2\) com \(\eta\) fixo. Passo 2: forçar \(\eta\) até quebrar. Passo 3: treinar uma reta nos três pontos da tabela feita à mão e conferir cada número contra a forma fechada.
- Notebook no Colab, seções 1 a 3: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: o caso da fronteira (passo 2) e outro ponto de partida (passo 3).
Ritmo: passos 1 e 2 e a primeira simulação em 12 min; passo 3 e a segunda em 13 min.