Por que a forma fechada não basta
não escala
\((X^\top X)^{-1}\) custa \(O(d^3)\): inviável com muitíssimos atributos
não existe
para a maioria dos outros modelos, a começar pelas redes neurais
não freia
não diz nada sobre controlar o sobreajuste
O caminho desta aula
- Descer a ladeirao gradiente, deduzido e calculado à mão
- Ajustar a descidasuperfície de perda, escala, taxa de aprendizado, mini-batch
- Retas → curvasatributos polinomiais; subajuste e sobreajuste
- Regularizarridge (L2), lasso (L1) e o botão α
Gradiente descendente: desça a ladeira
Em vez de resolver \(\nabla J = 0\) no papel: meça a inclinação onde você está, dê um passo contra ela, repita.
\[ w^{(t+1)} = w^{(t)} - \eta \, \nabla_w J\big(w^{(t)}\big) \]- \(\eta\): a taxa de aprendizado, o tamanho do passo.
- \(\nabla_w J\) aponta para onde a perda cresce mais rápido; o sinal de menos faz o método descer.
De onde vem o gradiente
\[ J(w_0, w_1) = \frac{1}{n}\sum_{i=1}^{n}\big(\underbrace{y_i - w_0 - w_1 x_i}_{e_i}\big)^2 \]Regra da cadeia: a derivada de \(e_i^2\) é \(2e_i\) vezes como o resíduo reage ao peso.
\(\partial e_i / \partial w_0 = -1\)
subir o intercepto em uma unidade baixa todo resíduo em uma unidade
\(\partial e_i / \partial w_1 = -x_i\)
subir a inclinação baixa o resíduo em \(x_i\): pontos longe da origem sentem mais
Uma fórmula para todo parâmetro
Com a coluna de uns \(x_{i0} = 1\), o intercepto é só mais um peso:
\[ \frac{\partial J}{\partial w_j} = -\frac{2}{n}\sum_{i=1}^{n} e_i\,x_{ij} \qquad\Longrightarrow\qquad \nabla_w J = -\frac{2}{n}X^\top e = -\frac{2}{n}X^\top(y - Xw) \]primeira leitura
iguale a zero: \(X^\top(y - Xw) = 0\), as equações normais. A mesma afirmação por dois caminhos: resolver de uma vez ou caminhar até lá.
segunda leitura
uma soma ponderada pelos resíduos: pontos bem previstos quase não votam, pontos muito errados dominam o passo.
Um passo, à mão
Pontos \((1,2), (2,4), (3,7)\); começa em \(w_0 = w_1 = 0\); \(\eta = 0{,}1\).
A reta prevê 0 em todo lugar, então \(e = y = (2, 4, 7)\): \(\sum e_i = 13\), \(\sum e_i x_i = 2 + 8 + 21 = 31\).
\[ \frac{\partial J}{\partial w_0} = -\tfrac{2}{3}(13) = -8{,}667, \qquad \frac{\partial J}{\partial w_1} = -\tfrac{2}{3}(31) = -20{,}667 \] \[ w_0 \leftarrow 0 - 0{,}1(-8{,}667) = 0{,}867, \qquad w_1 \leftarrow 0 - 0{,}1(-20{,}667) = 2{,}067 \]Os próximos passos
| iteração | \(w_0\) | \(w_1\) | \(J\) | \(\partial J/\partial w_0\) | \(\partial J/\partial w_1\) |
|---|---|---|---|---|---|
| 0 | 0,000 | 0,000 | 23,000 | −8,667 | −20,667 |
| 1 | 0,867 | 2,067 | 0,625 | 1,333 | 2,089 |
| 2 | 0,733 | 1,858 | 0,344 | 0,231 | −0,394 |
| 3 | 0,710 | 1,897 | 0,327 | 0,343 | −0,119 |
primeiro passo enorme
23 → 0,63, depois se arrasta: uma queda rápida no início diz pouco sobre convergência
os sinais trocam
um passo ultrapassa o mínimo, o seguinte volta
ritmos diferentes
\(\partial J/\partial w_1\) é 2,4× \(\partial J/\partial w_0\): os resíduos entram multiplicados por \(x_i\)
Depois de 2000 iterações: \(w_0 = -0{,}667\), \(w_1 = 2{,}5\), exatamente as equações normais.
A paisagem que você está descendo
- Cada ponto do plano \((w_0, w_1)\) é uma reta candidata; a altura é o erro dela.
- Minimizar = achar o fundo do vale; \(-\nabla J\) é a direção de descida mais íngreme.
Simulador: a superfície de perda
Clique à esquerda para soltar um início e aperte Passo. Depois ligue centrar x e comece de novo a partir de um ponto parecido.
Por que escalonar vem antes de ajustar
sem centrar
um vale longo e estreito: inclinar uma reta cujos \(x\) estão longe de zero também a sobe ou desce, então \(w_0\) e \(w_1\) ficam acoplados. O gradiente aponta atravessado ao vale; o caminho ziguezagueia e se arrasta.
centrado
uma tigela redonda: os mesmos passos vão quase direto à resposta.
A taxa de aprendizado
- \(\eta\) pequeno demais → passos minúsculos, convergência lenta
- \(\eta\) grande demais → os passos ultrapassam; a perda oscila ou diverge
- receita: experimente \(\eta \in \{10^{-3}, 10^{-2}, 10^{-1}\}\) e veja a perda de treino cair suavemente
na perda do próximo slide
| \(\eta < 0{,}5\) | aproxima-se aos poucos |
| \(\eta = 0{,}5\) | o mínimo de uma vez |
| \(0{,}5 < \eta < 1\) | pula, mas fecha |
| \(\eta = 1\) | bate entre dois pontos para sempre |
| \(\eta > 1\) | explode |
Simulador: a taxa de aprendizado
Preveja. Defina \(\eta = 1{,}05\) e avance passo a passo. Converge, fica batendo para sempre ou explode?
Batch, estocástico e mini-batch
| variante | gradiente calculado sobre | custo por passo | comportamento |
|---|---|---|---|
| batch GD | o conjunto completo | \(O(nd)\) | descida exata e suave |
| GD estocástico (SGD) | uma amostra aleatória | \(O(d)\) | ruidoso mas barato; escapa de armadilhas rasas |
| mini-batch GD | um lote de ~32–512 | intermediário | o padrão moderno |
from sklearn.linear_model import SGDRegressor
model = SGDRegressor(loss='squared_error', penalty='l2', alpha=1e-4,
                     learning_rate='invscaling', max_iter=1000)
De retas a curvas: atributos polinomiais
A regressão linear é linear nos parâmetros, não nas entradas: \(x \mapsto (x, x^2, \dots, x^p)\).
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures

model = make_pipeline(PolynomialFeatures(degree=3), LinearRegression())
A flexibilidade corta dos dois lados
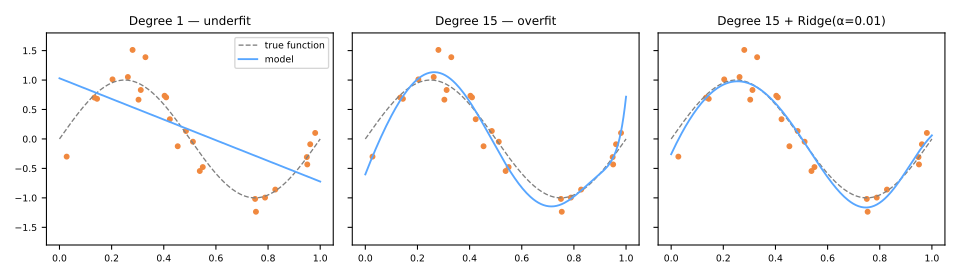
O grau 1 subajusta: rígido demais. O grau 15 sobreajusta: 16 parâmetros perseguem 25 pontos ruidosos. À direita: os mesmos 16 parâmetros mais uma penalidade Ridge e a curva relaxa de volta ao sinal.
Subajuste e sobreajuste, medidos
100 pontos de \(y = 0{,}5x^2 + x + 2\), ruído com desvio 3; validação cruzada de cinco dobras.
| grau | RMSE de treino | RMSE de validação (média) | desvio entre as dobras |
|---|---|---|---|
| 1 | 3,22 | 3,26 | 0,19 |
| 2 | 2,64 | 2,75 | 0,33 |
| 30 | 2,46 | 10,43 | 13,46 |
Grau 30, dobra por dobra: \(3{,}14 \quad 3{,}02 \quad 5{,}51 \quad \mathbf{37{,}29} \quad 3{,}20\)
Um diagnóstico de bolso
| simples demais (subajuste) | complexo demais (sobreajuste) | |
|---|---|---|
| erro de treino | alto | baixo |
| erro de validação | alto, de forma consistente | alto na média, às vezes baixo |
| variação entre dobras | pequena | grande |
| o que fazer | mais capacidade, atributos melhores | regularizar, mais dados, menos capacidade |
"Complexo demais" depende de quantos dados você tem
Um polinômio de grau 10 tem 11 parâmetros livres.
| pontos de treino | 5 | 8 | 10 | 11 | 15 | 30 |
|---|---|---|---|---|---|---|
| RMSE de treino | 3·10⁻¹⁵ | 1·10⁻¹¹ | 1·10⁻¹¹ | 0,40 | 0,77 | 1,53 |
- Até 11 pontos a curva atravessa todos: erro de treino zero é sinal de que não sobrou informação.
- A partir do décimo primeiro ponto ele precisa escolher e o erro sai do chão.
Regularização: penalizar o tamanho
Ridge (L2) · Tikhonov 1943; Hoerl & Kennard 1970
\[ \lVert y - Xw \rVert^2 + \alpha \sum_j w_j^2 \]- encolhe suavemente, nunca exatamente a zero
- espalha o peso entre atributos correlacionados
- forma fechada: \((X^\top X + \alpha I)^{-1} X^\top y\)
Lasso (L1) · Tibshirani 1996
\[ \lVert y - Xw \rVert^2 + \alpha \sum_j \lvert w_j \rvert \]- cai exatamente em zero para atributos fracos
- seleção automática de atributos
- entre atributos correlacionados, fica com um ao acaso
A Elastic Net mistura as duas (l1_ratio): um padrão robusto com muitos atributos correlacionados.
Por que o L1 zera e o L2 não
Escreva a penalidade como um orçamento: minimizar o erro sujeito a \(\sum |w_j| \le t\) (lasso) ou \(\sum w_j^2 \le t^2\) (ridge).
- As curvas de nível do erro são elipses centradas na solução de OLS (ordinary least squares, mínimos quadrados ordinários).
- A solução é onde a elipse que cresce toca primeiro a região.
Simulador: círculo contra losango
Arraste o ótimo do OLS e conte quantas vezes cada região é tocada sobre um eixo.
O caso unidimensional, em forma fechada
um atributo, \(\sum_i x_i^2 = 1\), \(\alpha = 1\)
| \(\hat{w}\) (OLS) | ridge | lasso |
|---|---|---|
| 2,00 | 1,000 | 1,500 |
| 1,00 | 0,500 | 0,500 |
| 0,60 | 0,300 | 0,100 |
| 0,50 | 0,250 | 0 |
| 0,20 | 0,100 | 0 |
Acompanhando o caminho
Oito atributos: três com sinal real, três puro ruído, dois quase cópias (\(c_1, c_2\), ambos de verdade 2). Preveja. Quando \(\alpha\) cresce, quais coeficientes o lasso derruba primeiro?
O que o caminho mostra
| α | lasso: não nulos | ridge: não nulos |
|---|---|---|
| 0,05 | 8 / 8 | 8 / 8 |
| 0,2 | 7 / 8 | 8 / 8 |
| 0,6 | 6 / 8 | 8 / 8 |
| 2,0 | 5 / 8 | 8 / 8 |
O lasso remove primeiro os atributos de ruído; o ridge mantém os oito, pequenos.
O par correlacionado em \(\alpha = 2\):
lasso (1,89; 0,98): começa a escolher um, quase ao acaso.
ridge (1,02; 0,97): divide o peso por igual.
O ridge também conserta a parte numérica
duas colunas quase idênticas
número de condição de \(X^\top X\): \(7{,}2\times10^{7}\)
OLS: \((1{,}000; -0{,}000)\), uma divisão arbitrária
\(\alpha = 0{,}01\) na diagonal
número de condição: \(6\times10^{3}\)
resposta: \((0{,}500; 0{,}500)\), com a soma preservada
O botão α
- \(\alpha \to 0\): OLS puro, sem freio.
- \(\alpha \to \infty\): todos os coeficientes esmagados para ~0, o modelo prevê a média.
- O \(\alpha\) certo não é conhecido de antemão: escolha-o por validação cruzada (
RidgeCV,LassoCV, uma busca em grade).
Resumo
- \(w \leftarrow w - \eta\nabla J\); no erro quadrático, \(\nabla J = -\frac{2}{n}X^\top e\), uma soma ponderada pelos resíduos.
- Escalone os atributos: uma tigela redonda em vez de um vale estreito.
- \(\eta\) grande demais diverge; mini-batch é o padrão.
- Sobreajuste = erro de treino baixo, erro de validação imprevisível.
- O ridge divide, o lasso subtrai e corta; escolha \(\alpha\) por validação cruzada.
Gradiente descendente, na prática
- Abra o notebook do handout no Colab.
- Uma ladeira de uma variável; a taxa de aprendizado forçada até quebrar.
- Os três pontos de um passo, à mão, conferidos número a número.
- A paisagem da perda com e sem centrar; 20 mil casas da Califórnia com e sem padronização; mini-batch.