Agrupamento Hierárquico
Em Agrupamento, o k-means precisava do número de grupos antes de começar e devolvia uma única partição, plana. O agrupamento hierárquico responde a outra pergunta: em vez de "divida estes pontos em k grupos", ele constrói a família inteira de agrupamentos de uma vez, uns dentro dos outros, na forma de uma árvore. Dois animais se juntam, depois esse par se junta a um terceiro, grupos pequenos viram grupos maiores e, no topo, tudo é um grupo só. A árvore se chama dendrograma; o número de grupos é escolhido depois, decidindo em que altura cortá-la.
É a maneira mais antiga de organizar os seres vivos (reinos, classes, ordens, famílias, espécies) e continua sendo o que biólogos, bibliotecários e equipes de marketing querem quando um único nível de detalhe não basta. Esta aula constrói a árvore à mão com cinco pontos, lê a árvore, corta a árvore, mede como a escolha da ligação (linkage) muda o que ela encontra, verifica quão fielmente ela preserva as distâncias originais e termina com um laboratório que reconstrói uma taxonomia zoológica a partir de 16 perguntas de sim/não sobre 101 animais.
Toda afirmação abaixo é medida, não apenas enunciada: cada figura é produzida por um script Python curto que fica ao lado desta página; os blocos de código reproduzem os números citados no texto.
A aula segue um pipeline em quatro etapas, desenhado abaixo: 1. construir a árvore, fundindo o par mais próximo de novo e de novo, à mão, com quatro ligações; 2. ler e cortar, o que o dendrograma diz e como um corte o transforma em grupos; 3. escolher e conferir, qual ligação, onde cortar e quão fielmente a árvore guarda as distâncias; 4. na prática, outras distâncias, o custo e quando uma árvore ganha do k-means ou do agrupamento por densidade. Cada etapa leva à sua seção; nos slides, uma faixa embaixo mostra em que etapa você está.
- Construir a árvorefundir o par mais próximo; quatro ligações à mão
- Ler e cortaro dendrograma, a matriz Z, o corte
- Escolher e conferircomportamento das ligações, onde cortar, correlação cofenética
- Na práticaoutras distâncias, custo, contra k-means e agrupamento por densidade
Slides
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
A ideia: fundir os dois grupos mais próximos e repetir
Etapa 1. O agrupamento hierárquico aglomerativo cabe em quatro linhas:
- comece com \(n\) grupos, um por ponto;
- encontre os dois grupos mais próximos entre si;
- funda os dois num só e registre a distância em que se fundiram (a altura da fusão);
- volte ao passo 2 até sobrar um único grupo.
Depois de \(n-1\) fusões, o histórico das fusões é a árvore. Nada é sorteado e nada é iterado até convergir: os mesmos dados sempre dão a mesma árvore (a menos de empates). A alternativa divisiva faz o caminho contrário — começa com um grupo só e o divide recursivamente, por exemplo com 2-means a cada passo —, mas é bem menos comum; tudo o que segue é aglomerativo.
O passo 2 esconde a única decisão de verdade. As distâncias entre pontos são dadas; a distância entre dois grupos precisa ser definida. Essa definição é a ligação:
| ligação | distância entre os grupos \(P\) e \(Q\) | tende a produzir |
|---|---|---|
| simples (single) | o par mais próximo: \(\min_{p \in P,\, q \in Q} d(p, q)\) | cadeias; segue formas finas; uma ponte de pontos funde dois grupos |
| completa (complete) | o par mais distante: \(\max_{p,q} d(p, q)\) | grupos compactos, de diâmetro parecido |
| média (average, UPGMA) | a média de todas as \(\lvert P \rvert \cdot \lvert Q \rvert\) distâncias entre pares | um meio-termo entre as duas |
| Ward | quanto a fusão aumenta a soma de quadrados dentro dos grupos | grupos redondos, de tamanho parecido, como o k-means |
Ward (1963) é a que se liga à aula anterior. A soma de quadrados dentro dos grupos é a inércia do k-means; Ward funde o par de grupos cuja união a aumenta menos:
em que \(\mu_P\) e \(\mu_Q\) são os dois centroides. O k-means minimiza a inércia para um \(k\) fixo, iterando; Ward a faz crescer o mais devagar possível, uma fusão gulosa de cada vez.
Construa uma árvore você mesmo antes do ensaio numérico. Aperte fundir o próximo algumas vezes nas três bolhas e veja cada fusão acrescentar uma barra ao dendrograma; depois aperte fundir todos e arraste para cima e para baixo a linha vermelha de corte. Troque a ligação na cadeia e nas duas luas e procure o maior salto na altura das fusões antes de cortar.
A ligação simples segue cada lua, mas deixa a ponte colar os dois grupos e a sua árvore não tem nenhum salto claro; a completa, a média e Ward mantêm os grupos compactos, então separam as duas bolhas da cadeia e cortam as luas de través. Onde as alturas das fusões dão um salto, um corte dentro dele dá uma partição que os dados sustentam.
Ensaio numérico: cinco pontos, quatro árvores
Cinco pontos sobre uma reta. Os espaços entre vizinhos crescem de um em um — 3, 4, 5, 6 —, que é exatamente o tipo de dado em que as ligações discordam.
| ponto | A | B | C | D | E |
|---|---|---|---|---|---|
| posição | 0 | 3 | 7 | 12 | 18 |
A matriz de distâncias (em 1-D, a distância é só a diferença):
| A | B | C | D | E | |
|---|---|---|---|---|---|
| A | 0 | 3 | 7 | 12 | 18 |
| B | 3 | 0 | 4 | 9 | 15 |
| C | 7 | 4 | 0 | 5 | 11 |
| D | 12 | 9 | 5 | 0 | 6 |
| E | 18 | 15 | 11 | 6 | 0 |
A fusão 1 é a mesma para todas as ligações. Entre pontos isolados, toda definição dá a distância comum, então as quatro fundem o par mais próximo, A e B, na altura 3. A matriz encolhe para 4 × 4 e as ligações começam a diferir no modo de preencher a linha nova — a distância de \(\{A,B\}\) a todo o resto:
| distância de {A, B} até | simples = mín | completa = máx | média |
|---|---|---|---|
| C | mín(7, 4) = 4 | máx(7, 4) = 7 | (7 + 4) / 2 = 5,5 |
| D | mín(12, 9) = 9 | máx(12, 9) = 12 | (12 + 9) / 2 = 10,5 |
| E | mín(18, 15) = 15 | máx(18, 15) = 18 | (18 + 15) / 2 = 16,5 |
O resto da matriz não muda: C–D = 5, C–E = 11, D–E = 6. A fusão 2 já separa as ligações. Para a ligação simples, a menor entrada agora é 4 e C se junta a {A, B}. Para a completa e a média, a linha nova é maior (7 e 5,5); a menor entrada passa a ser C–D = 5 e C forma par com D. Continuando do mesmo jeito até o fim:
Ligação simples — sempre o menor espaço entre os grupos, então a cadeia só cresce:
| fusão | grupos antes | menor distância entre grupos | funde | altura |
|---|---|---|---|---|
| 1 | A · B · C · D · E | A–B = 3 | A + B | 3 |
| 2 | AB · C · D · E | AB–C = mín(7, 4) = 4 | AB + C | 4 |
| 3 | ABC · D · E | ABC–D = mín(12, 9, 5) = 5 | ABC + D | 5 |
| 4 | ABCD · E | ABCD–E = mín(18, 15, 11, 6) = 6 | ABCD + E | 6 |
Ligação completa — decide a maior distância entre os grupos:
| fusão | grupos antes | candidatos | funde | altura |
|---|---|---|---|---|
| 2 | AB · C · D · E | AB–C 7, AB–D 12, AB–E 18, C–D 5, C–E 11, D–E 6 | C + D | 5 |
| 3 | AB · CD · E | AB–CD = máx(7, 12, 4, 9) = 12; CD–E = máx(11, 6) = 11; AB–E 18 | CD + E | 11 |
| 4 | AB · CDE | máx das seis distâncias de A/B até C/D/E = 18 | AB + CDE | 18 |
Ligação média — a média de todas as distâncias cruzadas:
| fusão | grupos antes | candidatos | funde | altura |
|---|---|---|---|---|
| 2 | AB · C · D · E | AB–C 5,5, AB–D 10,5, AB–E 16,5, C–D 5, C–E 11, D–E 6 | C + D | 5 |
| 3 | AB · CD · E | AB–CD = (7 + 12 + 4 + 9) / 4 = 8; CD–E = (11 + 6) / 2 = 8,5; AB–E 16,5 | AB + CD | 8 |
| 4 | ABCD · E | (18 + 15 + 11 + 6) / 4 = 12,5 | ABCD + E | 12,5 |
A fusão 3 é onde a média e a completa se separam: 8 contra 8,5 é apertado; a média prefere juntar os dois pares, enquanto a completa enxerga o 12 entre A e D e prefere trazer E para {C, D}.
Ward trabalha com o custo \(\Delta\), o aumento da soma de quadrados. Para dois pontos isolados, ele é metade da distância ao quadrado (A + B: \(\tfrac{1 \cdot 1}{2}\, 3^2 = 4{,}5\)); em geral, precisa dos tamanhos e dos centroides:
| fusão | grupos antes (centroide) | candidatos mais baratos, \(\Delta\) | funde | \(\Delta\) | altura \(\sqrt{2\Delta}\) |
|---|---|---|---|---|---|
| 1 | cinco pontos isolados | A+B 4,5 · B+C 8 · C+D 12,5 | A + B | 4,5 | 3 |
| 2 | AB (1,5) · C · D · E | C+D 12,5 · D+E 18 · AB+C \(\tfrac{2}{3}(7-1{,}5)^2 = 20{,}17\) | C + D | 12,5 | 5 |
| 3 | AB (1,5) · CD (9,5) · E | CD+E \(\tfrac{2}{3}(18-9{,}5)^2 = 48{,}17\) · AB+CD \(1 \cdot 8^2 = 64\) · AB+E 181,5 | CD + E | 48,17 | 9,81 |
| 4 | AB (1,5) · CDE (12,33) | AB+CDE \(\tfrac{6}{5}(12{,}33-1{,}5)^2 = 140{,}83\) | AB + CDE | 140,83 | 16,78 |
Duas conferências que dá para fazer na calculadora. Os quatro custos somam 4,5 + 12,5 + 48,17 + 140,83 = 206, que é a soma de quadrados dos cinco pontos em torno da média 8 — a inércia de "um grupo só", como tem de ser, já que cada fusão acrescenta exatamente o seu \(\Delta\). E a última coluna: as bibliotecas reportam \(\sqrt{2\Delta}\) como altura de Ward, para que a fusão de dois pontos isolados fique na distância comum entre eles (\(\sqrt{2 \cdot 4{,}5} = 3\)).
As quatro regras de atualização acima são casos particulares de uma única fórmula, de Lance & Williams (1967): a distância de um grupo \(K\) ao grupo fundido \(I \cup J\) é \(\alpha_I d(K, I) + \alpha_J d(K, J) + \beta\, d(I, J) + \gamma\, |d(K, I) - d(K, J)|\), com uma escolha diferente dos quatro coeficientes para cada ligação (simples: \(\alpha = \tfrac12, \beta = 0, \gamma = -\tfrac12\), que dá o mínimo). É por isso que o algoritmo só precisa da matriz de distâncias, nunca dos pontos em si — exceto Ward, cuja fórmula só é exata para distâncias euclidianas ao quadrado.
O SciPy confirma as quatro contas feitas à mão:
import numpy as np
from scipy.cluster.hierarchy import linkage
from scipy.spatial.distance import pdist, squareform

X = np.array([[0], [3], [7], [12], [18]])        # A, B, C, D, E sobre uma reta
names = list('ABCDE')
print(squareform(pdist(X)).astype(int))          # a matriz de distâncias

def merges(Z):
    """Traduz uma matriz de ligação na sequência de grupos fundidos."""
    groups = list(names)
    steps = []
    for a, b, height, size in Z:
        groups.append(''.join(sorted(groups[int(a)] + groups[int(b)])))
        steps.append(f"{groups[-1]} at {height:.2f}")
    return ' -> '.join(steps)

for method in ['single', 'complete', 'average', 'ward']:
    print(f"{method:8s}", merges(linkage(X, method)))
[[ 0  3  7 12 18]
 [ 3  0  4  9 15]
 [ 7  4  0  5 11]
 [12  9  5  0  6]
 [18 15 11  6  0]]
single   AB at 3.00 -> ABC at 4.00 -> ABCD at 5.00 -> ABCDE at 6.00
complete AB at 3.00 -> CD at 5.00 -> CDE at 11.00 -> ABCDE at 18.00
average  AB at 3.00 -> CD at 5.00 -> ABCD at 8.00 -> ABCDE at 12.50
ward     AB at 3.00 -> CD at 5.00 -> CDE at 9.81 -> ABCDE at 16.78
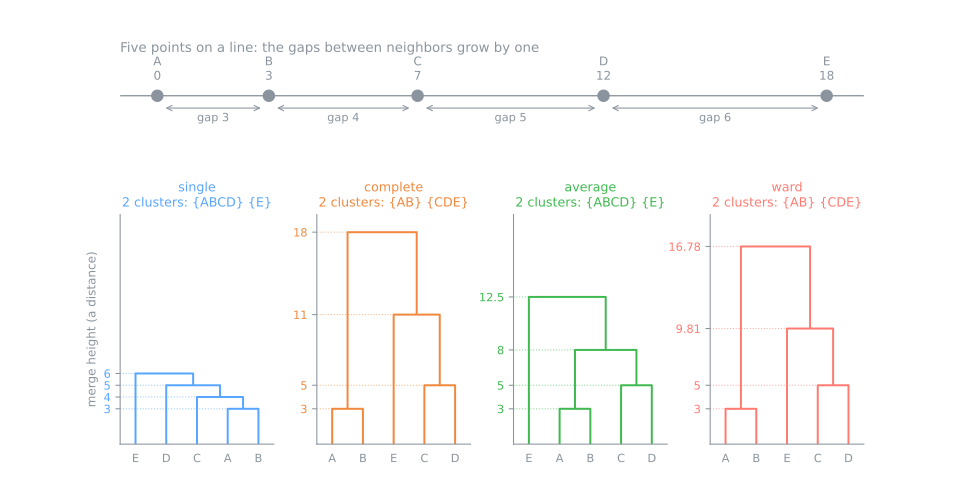
Uma matriz de distâncias, três árvores diferentes (a completa e Ward têm a mesma forma, com alturas diferentes). A divergência não é detalhe: pedindo dois grupos, a simples e a média isolam o E, enquanto a completa e Ward cortam entre B e C. A ligação simples vê uma cadeia em que cada espaço é só uma unidade maior que o anterior e não encontra motivo para quebrá-la em lugar nenhum a não ser no último espaço. A completa e Ward comparam grupos inteiros e veem dois grupos, {A, B} perto de 1,5 e {C, D, E} perto de 12,3. Nenhuma está errada; são respostas a definições diferentes de "grupo".
Como ler um dendrograma
Etapa 2. Um dendrograma tem uma folha por ponto (na base) e uma barra horizontal por fusão. As regras de leitura:
- O eixo y é uma distância. A altura de uma barra é a distância de ligação em que seus dois ramos se fundiram. Dois pontos são tão parecidos quanto a altura da barra mais baixa que os liga: na árvore completa, A e B se juntam em 3, mas A e E só em 18. Essa altura se chama distância cofenética entre os dois pontos.
- As linhas verticais longas são a parte interessante. Um ramo que sobe muito antes de se fundir é um grupo que continua longe de todo o resto. Na árvore completa, {C, D, E} se forma em 11 e espera até 18 para se juntar a {A, B}.
- A ordem da esquerda para a direita quase não traz informação. Cada barra pode ser girada sem mudar a árvore, então 5 folhas têm \(2^4 = 16\) desenhos equivalentes. Na árvore completa, o E aparece desenhado ao lado do B, embora os dois terminem sendo o par mais distante (18). Nunca leia semelhança em folhas vizinhas; leia na altura em que elas se encontram.
A árvore fica guardada numa matriz de ligação Z com \(n - 1\) linhas, uma por fusão, na ordem em que as fusões aconteceram:
Coluna por coluna:
| coluna | significado | árvore completa |
|---|---|---|
| 0 e 1 | os dois grupos fundidos. Os ids de 0 a \(n-1\) são os pontos originais; o grupo criado pela linha \(i\) recebe o id \(n + i\) | a linha 0 funde os pontos 0 e 1 (A, B) no grupo 5; a linha 1 funde 2 e 3 (C, D) no grupo 6; a linha 2 funde o ponto 4 (E) com o grupo 6; a linha 3 funde os grupos 5 e 7 |
| 2 | a altura da fusão | 3, 5, 11, 18 — as alturas da tabela feita à mão |
| 3 | quantos pontos originais o grupo novo contém | 2, 2, 3, 5 |
dendrogram desenha a árvore (a figura acima são quatro chamadas dele) e, com no_plot=True, devolve a ordem das folhas da esquerda para a direita sem desenhar:
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import dendrogram

dendrogram(Z, labels=names)
plt.ylabel('merge height')
plt.show()
print(dendrogram(Z, labels=names, no_plot=True)['ivl'])
Cortando a árvore
Uma linha horizontal traçada no dendrograma na altura \(t\) corta algumas linhas verticais; cada pedaço pendurado abaixo da linha é um grupo. O fcluster do SciPy faz isso de dois jeitos: numa altura dada (criterion='distance') ou para um número pedido de grupos (criterion='maxclust'):
from scipy.cluster.hierarchy import fcluster

for t in [4, 8, 12, 20]:
    print(f"cut at height {t:2d}:", fcluster(Z, t, criterion='distance'))
for k in [2, 3]:
    print(f"ask for {k} clusters: ", fcluster(Z, k, criterion='maxclust'))
cut at height  4: [1 1 2 3 4]
cut at height  8: [1 1 2 2 3]
cut at height 12: [1 1 2 2 2]
cut at height 20: [1 1 1 1 1]
ask for 2 clusters:  [1 1 2 2 2]
ask for 3 clusters:  [1 1 2 2 3]
Comparando com a árvore completa: uma linha em 4 fica acima só da fusão A–B (3), então A e B dividem um rótulo e os outros três ficam sozinhos, 4 grupos. Em 8 ela passa também acima de C–D (5): {A, B}, {C, D}, {E}. Em 12 passa também acima de 11: {A, B} e {C, D, E}. Qualquer corte entre 11 e 18 dá os mesmos dois grupos. Essa faixa de alturas, com 7 unidades de largura, é o que torna estável a resposta de dois grupos aqui; a próxima seção transforma isso num jeito de escolher \(k\).
O scikit-learn encapsula o mesmo algoritmo em AgglomerativeClustering, com a interface fit_predict de sempre. Passe n_clusters ou ponha n_clusters=None e passe uma altura em distance_threshold:
from sklearn.cluster import AgglomerativeClustering

for method in ['single', 'complete', 'average', 'ward']:
    agg = AgglomerativeClustering(n_clusters=2, linkage=method, compute_distances=True).fit(X)
    print(f"{method:8s} labels {agg.labels_}  merge heights {agg.distances_.round(2)}")

agg = AgglomerativeClustering(n_clusters=None, distance_threshold=8, linkage='complete').fit(X)
print(f"complete, cut at 8: {agg.n_clusters_} clusters, labels {agg.labels_}")
single   labels [0 0 0 0 1]  merge heights [3. 4. 5. 6.]
complete labels [1 1 0 0 0]  merge heights [ 3.  5. 11. 18.]
average  labels [0 0 0 0 1]  merge heights [ 3.   5.   8.  12.5]
ward     labels [1 1 0 0 0]  merge heights [ 3.    5.    9.81 16.78]
complete, cut at 8: 3 clusters, labels [1 1 0 0 2]
As alturas das fusões são as das tabelas feitas à mão, Ward incluída (o scikit-learn usa a mesma escala \(\sqrt{2\Delta}\)). Os números dos rótulos diferem dos do SciPy (0/1 em vez de 1/2, em outra ordem), o que não importa: uma partição é o agrupamento, não o nome dos grupos.
O AgglomerativeClustering não tem método predict. Uma árvore é construída a partir dos pontos que recebeu; um ponto novo não tem lugar nela até você reconstruir a árvore ou até atribuí-lo com alguma outra regra (por exemplo, ao grupo do vizinho ou do centroide mais próximo, como na seção sobre custo).
Uma propriedade decorre da construção e merece ser dita: cortes da mesma árvore são aninhados. O corte em 3 grupos é o corte em 2 grupos com um dos grupos partido em dois; nada passa de um ramo para outro. Duas execuções do k-means com \(k = 3\) e \(k = 4\) não têm essa obrigação; o laboratório mede o quanto elas discordam.
O comportamento de cada ligação, medido
Etapa 3. Os cinco pontos mostraram que as ligações podem discordar. Em formas reais, a discordância segue um padrão. Quatro conjuntos 2-D com grupos conhecidos, 300 pontos cada; todo método recebe o número verdadeiro de grupos, de modo que a única diferença é a ligação. A nota é o índice de Rand ajustado (ARI) de Agrupamento: 1 para uma partição idêntica aos grupos verdadeiros, perto de 0 para uma que não é melhor que o acaso.
from sklearn.datasets import make_blobs, make_moons
from sklearn.metrics import adjusted_rand_score
import pandas as pd

rng = np.random.default_rng(0)
blobs = make_blobs(n_samples=300, centers=3, cluster_std=1.0, random_state=1)
a, b = rng.normal([0, 0], 0.7, (140, 2)), rng.normal([6, 0], 0.7, (140, 2))
t = np.linspace(1.0, 5.0, 20)                                     # uma linha fina de 20 pontos
bridge = (np.vstack([a, b, np.c_[t, rng.normal(0, 0.05, 20)]]),
          np.r_[np.zeros(140), np.ones(140), (t > 3).astype(int)])
moons = make_moons(n_samples=300, noise=0.06, random_state=0)
rng = np.random.default_rng(0)
strips = (np.vstack([np.c_[rng.uniform(0, 8, 100), rng.normal(1.5 * j, 0.12, 100)] for j in range(3)]),
          np.repeat([0, 1, 2], 100))

table = {}
for name, (Xd, yd) in {'blobs': blobs, 'blobs + bridge': bridge,
                       'moons': moons, 'parallel strips': strips}.items():
    k = len(np.unique(yd))
    table[name] = {m: adjusted_rand_score(yd, AgglomerativeClustering(n_clusters=k, linkage=m).fit_predict(Xd))
                   for m in ['single', 'complete', 'average', 'ward']}
print(pd.DataFrame(table).T.round(2))
                 single  complete  average  ward
blobs              0.57      0.98     0.98  0.98
blobs + bridge     0.00      0.91     0.99  0.96
moons              1.00      0.20     0.43  0.30
parallel strips    1.00      0.12     0.19  0.22
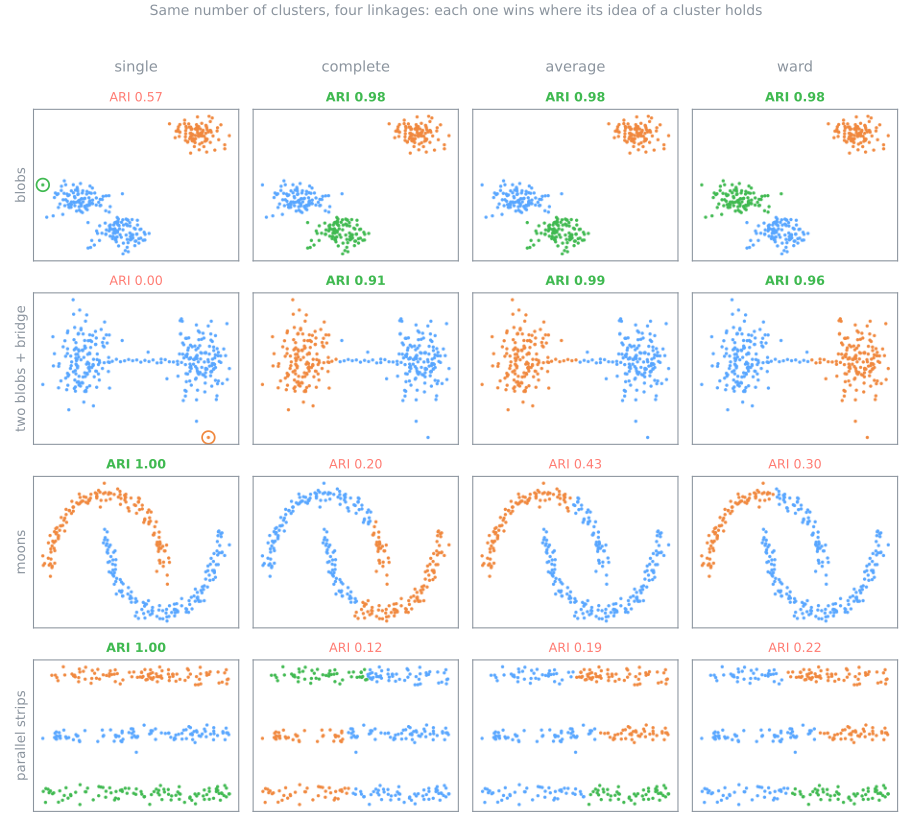
A tabela se divide em dois campos bem definidos:
- A ligação simples ganha exatamente onde as outras perdem. Nas luas e nas faixas paralelas ela tira 1,00: cada forma é uma cadeia de vizinhos próximos e a ligação simples só pergunta "existe algum salto curto entre estes grupos?". A mesma pergunta é o seu ponto fraco. Nas bolhas ela tira 0,57: guarda um ponto distante como grupo próprio (circulado) e junta duas bolhas. Com duas bolhas ligadas por uma ponte fina de 20 pontos, ela tira 0,00: a ponte oferece uma cadeia de saltos curtos, as duas bolhas se fundem cedo e a última fusão que sobra é a de algum ponto perdido. Isso é o encadeamento (chaining). A ligação simples é também a árvore geradora mínima disfarçada (Gower & Ross, 1969): cortar a árvore na altura \(t\) é o mesmo que apagar da árvore geradora mínima toda aresta mais longa que \(t\).
- A completa, a média e Ward perguntam quão longe estão os grupos como um todo, então uma ponte de poucos pontos não consegue puxar duas bolhas uma para a outra (0,91 a 0,99). Mas todas preferem grupos compactos e por isso cortam as luas e as faixas de través (0,12 a 0,43), exatamente como o k-means. Ward é a mais parecida com o k-means; a completa é a mais sensível a um único ponto distante, já que um outlier define o máximo; a média fica entre as duas.
A regra prática: Ward (o padrão do scikit-learn) ou a média para grupos compactos; a simples quando você espera formas finas e conectadas e os grupos estão bem separados; e sempre olhe a árvore antes de confiar em qualquer uma delas.
Onde cortar
Uma árvore tem \(n - 1\) cortes possíveis, então alguma coisa precisa escolher. Tome 400 pontos em quatro bolhas que vêm em dois pares: duas escalas de estrutura num mesmo conjunto.
from sklearn.metrics import silhouette_score

X4, y4 = make_blobs(n_samples=400, centers=[[0, 0], [0, 3.5], [9, 6], [12, 6]],
                    cluster_std=0.8, random_state=0)
Z4 = linkage(X4, 'ward')
h = Z4[::-1, 2]                  # alturas a partir do topo: h[0] funde 2 -> 1 grupos, h[1] 3 -> 2, ...
print('top merge heights:', h[:6].round(1))
for k in range(2, 8):
    labels = fcluster(Z4, k, criterion='maxclust')
    print(f"k={k}: any cut between {h[k-1]:5.1f} and {h[k-2]:5.1f} (gap {h[k-2] - h[k-1]:5.1f})"
          f"  silhouette {silhouette_score(X4, labels):.3f}")
top merge heights: [159.2  32.3  30.3   9.7   9.2   8.9]
k=2: any cut between  32.3 and 159.2 (gap 126.9)  silhouette 0.787
k=3: any cut between  30.3 and  32.3 (gap   2.1)  silhouette 0.664
k=4: any cut between   9.7 and  30.3 (gap  20.6)  silhouette 0.545
k=5: any cut between   9.2 and   9.7 (gap   0.5)  silhouette 0.473
k=6: any cut between   8.9 and   9.2 (gap   0.3)  silhouette 0.393
k=7: any cut between   8.7 and   8.9 (gap   0.2)  silhouette 0.349
O maior salto nas alturas das fusões. A partição em \(k\) grupos é a que se obtém para toda altura de corte entre a fusão que a criou e a fusão que a desfaz. Quanto mais larga essa faixa, mais os dados insistem naquele \(k\): um salto pequeno significa que uma altura um pouco diferente ou dados um pouco diferentes dariam outra resposta. Aqui, \(k = 2\) sobrevive a uma faixa de 126,9 (de 32,3 a 159,2) e \(k = 4\), a uma faixa de 20,6; nenhum outro \(k\) sobrevive a mais de 2,1. Dois saltos se destacam porque há duas escalas: os pares estão longe um do outro e, dentro de cada par, há duas bolhas.
A silhueta de cada corte, de Agrupamento, medida nos mesmos pontos. Ela é máxima em \(k = 2\) (0,787) e cai sem parar: 0,545 em \(k = 4\). Concorda com o maior salto e, como todo índice de compacidade, prefere a divisão bem separada mais grossa. Não enxerga a segunda escala.
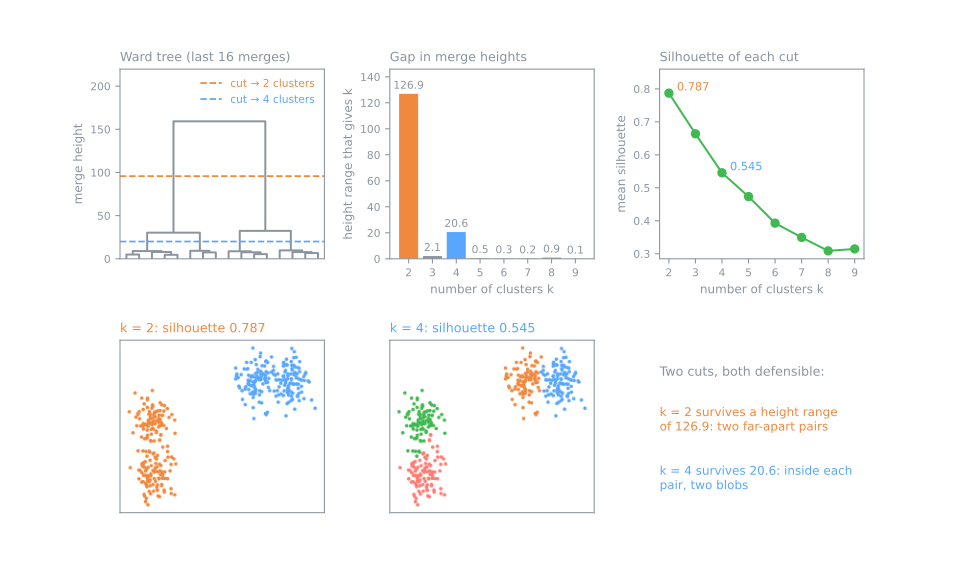
Então qual está certo? Os dois — e essa é a vantagem real de uma árvore: você não precisa escolher um só. Os dois cortes são aninhados, então dá para relatar dois segmentos no nível grosso e quatro no nível fino, que concordam entre si. Quando um único número é exigido, escolha pensando na pergunta (com quantos grupos alguém consegue agir?) e use os saltos e a silhueta para descartar cortes que os dados não sustentam, como k = 3 aqui (salto de 2,1).
O SciPy também oferece o coeficiente de inconsistência, que compara a altura de cada fusão com as alturas das fusões logo abaixo dela: \((h - \text{média}) / \text{desvio}\), calculado sobre a ligação e suas sub-ligações até a profundidade d. Uma fusão muito mais alta que as fusões que ela junta é "inconsistente" (um lugar natural para cortar); fcluster(Z, t, criterion='inconsistent') corta onde o coeficiente passa de t:
from scipy.cluster.hierarchy import inconsistent

print(inconsistent(Z4, d=2)[-4:].round(2))     # últimas 4 fusões: média, desvio, contagem, coeficiente
Cada linha é uma fusão: a média e o desvio padrão das alturas usadas (a própria ligação e as ligações logo abaixo), quantas alturas foram e o coeficiente. É uma medida local e aqui mostra o seu limite: com profundidade 2, as estatísticas usam no máximo três alturas, então o coeficiente não passa de \(2/\sqrt{3} = 1{,}15\); as três fusões do topo recebem todas esse máximo. Ele não distingue a fronteira de \(k = 2\) da de \(k = 4\); já os saltos, sim. Use-o, se for usar, como mais uma pista.
Correlação cofenética: quão fiel é a árvore?
Uma árvore troca as \(n(n-1)/2\) distâncias entre pares por \(n - 1\) alturas de fusão. Cada par de pontos ganha uma distância nova, a distância cofenética (a altura em que se juntam pela primeira vez). A pergunta é quanto da geometria original sobrevive. Sokal & Rohlf (1962) propuseram a medida óbvia: a correlação entre as distâncias originais e as cofenéticas, a correlação cofenética.
À mão, para a árvore de ligação simples dos cinco pontos. Liste os 10 pares na ordem AB, AC, AD, AE, BC, BD, BE, CD, CE, DE:
| AB | AC | AD | AE | BC | BD | BE | CD | CE | DE | média | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| original \(d\) | 3 | 7 | 12 | 18 | 4 | 9 | 15 | 5 | 11 | 6 | 9 |
| cofenética \(c\) | 3 | 4 | 5 | 6 | 4 | 5 | 6 | 5 | 6 | 6 | 5 |
Centrando, os produtos \((d - 9)(c - 5)\) somam 33, os quadrados \((d - 9)^2\) somam 220 e \((c - 5)^2\) somam 10, então a correlação é \(33 / \sqrt{220 \times 10} = 0{,}704\). O cophenet do SciPy devolve o mesmo número e também o das outras três árvores:
from scipy.cluster.hierarchy import cophenet

dist = pdist(X)
for method in ['single', 'complete', 'average', 'ward']:
    c, coph = cophenet(linkage(X, method), dist)
    print(f"{method:8s} cophenetic correlation {c:.3f}   cophenetic distances {coph.round(1)}")
single   cophenetic correlation 0.704   cophenetic distances [3. 4. 5. 6. 4. 5. 6. 5. 6. 6.]
complete cophenetic correlation 0.565   cophenetic distances [ 3. 18. 18. 18. 18. 18. 18.  5. 11. 11.]
average  cophenetic correlation 0.691   cophenetic distances [ 3.   8.   8.  12.5  8.   8.  12.5  5.  12.5 12.5]
ward     cophenetic correlation 0.561   cophenetic distances [ 3.  16.8 16.8 16.8 16.8 16.8 16.8  5.   9.8  9.8]
A ligação simples é a que melhor preserva as distâncias aqui (0,704), mesmo sendo uma cadeia. A completa e Ward, cujo corte em dois grupos parecia o mais natural, são as que pior preservam (0,565 e 0,561): elas empurram todo par de A/B com C/D/E para uma mesma altura grande, 18 ou 16,78, apagando a diferença entre B–C (4) e A–E (18). A mesma comparação nas quatro bolhas da seção anterior:
d4 = pdist(X4)
for method in ['single', 'complete', 'average', 'ward']:
    Zm = linkage(X4, method)
    print(f"{method:8s} cophenetic correlation {cophenet(Zm, d4)[0]:.3f}"
          f"   ARI at k=4 {adjusted_rand_score(y4, fcluster(Zm, 4, criterion='maxclust')):.3f}")
single   cophenetic correlation 0.944   ARI at k=4 0.496
complete cophenetic correlation 0.947   ARI at k=4 0.954
average  cophenetic correlation 0.953   ARI at k=4 0.856
ward     cophenetic correlation 0.952   ARI at k=4 0.892
As quatro árvores preservam as distâncias quase igualmente bem (de 0,944 a 0,953); mesmo assim, seus cortes em quatro grupos vão de ARI 0,496 (a simples, que encadeia duas bolhas) a 0,954 (a completa). Este é o ponto a guardar. A correlação cofenética mede quão fielmente a árvore representa as distâncias, não quão bons são os grupos. A ligação média costuma tirar a nota mais alta, porque a média das distâncias cruzadas é um resumo natural delas. Use a correlação cofenética para comparar ligações quando o produto é a própria árvore — uma taxonomia, a ordem de um mapa de calor — e as verificações de grupos (saltos, silhueta e uma olhada nos dados) para os grupos.
Além da distância euclidiana
Etapa 4. Nada no algoritmo exige a distância euclidiana: as ligações simples, completa e média funcionam com qualquer dissimilaridade. Isso abre dois casos importantes.
Perfis: distância de correlação. Quatro clientes, seis meses de gastos. Dois crescem de forma constante, dois gastam quase tudo num único mês; em cada par, um gasta cinco vezes mais que o outro:
P = np.array([[10, 12, 14, 16, 18, 20],           # pequeno, crescimento constante
              [50, 60, 70, 80, 90, 100],          # grande, crescimento constante
              [12, 10, 11, 25, 11, 10],           # pequeno, um mês de pico
              [55, 50, 52, 110, 50, 52]], float)  # grande, um mês de pico
for metric in ['euclidean', 'correlation']:
    Zp = linkage(P, 'average', metric=metric)
    print(f"{metric:11s} clusters {fcluster(Zp, 2, criterion='maxclust')}   distances {pdist(P, metric).round(2)}")
euclidean   clusters [1 2 1 2]   distances [150.73  15.72 125.69 157.45  72.48 125.06]
correlation clusters [1 1 2 2]   distances [0.   0.94 0.9  0.94 0.9  0.  ]
A distância euclidiana agrupa os clientes por quanto gastam (pequeno com pequeno, grande com grande); a distância de correlação, \(1 - r\), agrupa pelo formato do gasto (os que crescem com os que crescem, os de pico com os de pico), porque um perfil e o mesmo perfil multiplicado por cinco têm correlação 1 e distância 0. Qual está certa depende da pergunta; nenhum índice calculado nos dados pode decidir isso. A análise de expressão gênica usa distância de correlação por esse motivo: dois genes que sobem e descem juntos ao longo das amostras estão relacionados, seja qual for o nível de base de cada um.
Documentos: distância do cosseno. Em Representação de Texto, um documento vira um vetor de contagens de palavras. Um documento e o mesmo documento escrito dez vezes mais longo apontam na mesma direção, mas ficam longe na distância euclidiana:
docs = np.array([[2, 1, 0, 0],       # um texto curto sobre o tema 1
                 [20, 10, 0, 0],     # um texto longo, mesmas palavras, mesmas proporções
                 [0, 0, 3, 1]])      # um texto curto sobre o tema 2
for metric in ['euclidean', 'cosine']:
    print(f"{metric:9s}", squareform(pdist(docs, metric)).round(2)[0])
Medindo a partir do primeiro documento, a distância euclidiana diz que o texto sobre o outro tema está mais perto (3,87) que o mesmo texto escrito mais longo (20,12); a distância do cosseno diz o contrário (1,0 contra 0,0). Para texto, o cosseno é o padrão. No scikit-learn, AgglomerativeClustering(metric='cosine', linkage='average') ou metric='precomputed' com qualquer matriz que você mesmo calculou. Ward é a exceção: seu custo é definido por centroides e distâncias euclidianas ao quadrado; por isso o scikit-learn recusa qualquer outra métrica com linkage='ward'.
Restrições de conectividade. O AgglomerativeClustering também aceita uma matriz connectivity (por exemplo, kneighbors_graph(X, n_neighbors=10)) e então só funde grupos que são vizinhos nesse grafo. Dois grupos que por acaso estão perto no espaço, mas não estão ligados através dos dados, não podem se fundir, o que faz até Ward seguir estruturas finas e curvas; é o jeito padrão de segmentar uma imagem em regiões de pixels adjacentes ou um mapa em áreas contíguas. Como só pares vizinhos são comparados, também fica bem mais rápido em dados grandes.
Custo: por que não escala e o que fazer
Todo algoritmo aglomerativo padrão parte da matriz completa de distâncias entre pares. São \(n(n-1)/2\) números:
for n in [1_000, 10_000, 100_000, 1_000_000]:
    print(f"{n:>9,} rows: {n * (n - 1) // 2:>15,} distances = {n * (n - 1) / 2 * 8 / 1e9:9,.3f} GB")
    1,000 rows:         499,500 distances =     0.004 GB
   10,000 rows:      49,995,000 distances =     0.400 GB
  100,000 rows:   4,999,950,000 distances =    40.000 GB
1,000,000 rows: 499,999,500,000 distances = 3,999.996 GB
O tempo é pior que a memória. O algoritmo ingênuo (procurar o mínimo na matriz inteira, fundir, repetir) é \(O(n^3)\); os algoritmos que o SciPy e o scikit-learn usam de fato, descritos por Müllner (2011), trazem as quatro ligações desta aula para \(O(n^2)\) — uma árvore geradora mínima para a ligação simples e a cadeia de vizinhos mais próximos (nearest-neighbor chain) para a completa, a média e Ward. \(O(n^2)\) continua sendo quadrático. Medido em bolhas 5-D:
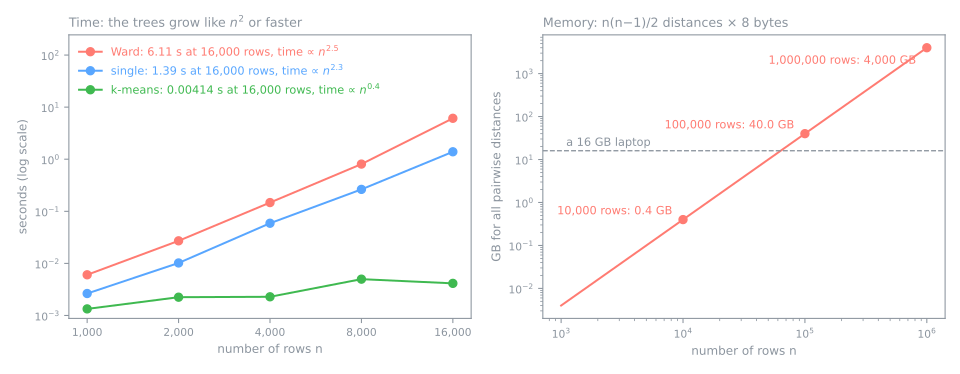
Na máquina em que a figura foi gerada, cada vez que \(n\) dobrou, o tempo foi multiplicado por cerca de 5,7; 16.000 linhas levaram 6,11 s com Ward; o k-means nas mesmas linhas levou 0,004 s. (Os tempos mudam de máquina para máquina; o que importa são os expoentes.) Extrapole mais um fator de seis (até 100.000 linhas) e só as distâncias precisam de 40 GB, mais do que a maioria dos notebooks tem. O agrupamento hierárquico é um método para centenas a dezenas de milhares de linhas. Para mais do que isso:
- Amostrar e depois atribuir. Construa a árvore numa amostra aleatória, corte-a e dê a cada um dos demais pontos o grupo do centroide mais próximo (ou do vizinho amostrado mais próximo). Se os grupos forem grandes o bastante para aparecer na amostra, perde-se pouco:
Xbig, ybig = make_blobs(n_samples=100_000, centers=5, n_features=5, cluster_std=1.5, random_state=0)
rng = np.random.default_rng(0)
idx = rng.choice(len(Xbig), 2_000, replace=False)                 # uma amostra de 2%
lab_sample = fcluster(linkage(Xbig[idx], 'ward'), 5, criterion='maxclust')
centroids = np.array([Xbig[idx][lab_sample == c].mean(axis=0) for c in range(1, 6)])
lab_all = ((Xbig[:, None, :] - centroids[None]) ** 2).sum(axis=2).argmin(axis=1)
print(f"tree on {len(idx):,} rows, all {len(Xbig):,} assigned: ARI {adjusted_rand_score(ybig, lab_all):.3f}")
A árvore com 2.000 linhas leva uma fração de segundo; seus cinco grupos, estendidos às 100.000 linhas, batem com os grupos verdadeiros com ARI 0,993. O que se perde é a estrutura fina: um grupo de 30 pontos em 100.000 teria cerca de 0,6 representante na amostra.
- Restrições de conectividade (acima) trocam a matriz completa por um grafo esparso de vizinhos.
- HDBSCAN, de Agrupamento, é ele próprio um método hierárquico: constrói uma árvore de ligação simples sobre uma distância ajustada pela densidade e fica com os ramos que persistem por mais tempo. Com um índice espacial, ele não precisa da matriz de distâncias completa, então alcança tamanhos de dados muito além do que uma ligação aguenta. Além disso, marca ruído, coisa que nenhuma ligação faz.
Hierárquico vs k-means vs DBSCAN
| hierárquico (aglomerativo) | k-means | DBSCAN / HDBSCAN | |
|---|---|---|---|
| um grupo é | um ramo da árvore de fusões | os pontos mais perto de um centroide | uma região densa |
| decidido antes do ajuste | ligação e distância | \(k\) | eps, min_samples (HDBSCAN: min_cluster_size) |
| decidido depois do ajuste | \(k\) ou a altura do corte, olhando a árvore | — | — |
| saída | uma família aninhada de partições | uma partição | uma partição mais ruído (−1) |
| formas encontradas | depende da ligação: a simples segue cadeias, Ward acha grupos redondos | convexas, de tamanhos parecidos | qualquer forma |
| outliers | mantidos, como grupos minúsculos ou encadeados | forçados para dentro de um grupo | marcados como ruído |
| qualquer distância? | sim, exceto Ward | só euclidiana | sim |
| pontos novos | sem predict: reconstruir ou atribuir ao mais próximo | predict | sem predict no scikit-learn |
| custo | memória \(O(n^2)\), tempo \(O(n^2)\) ou pior | quase linear em \(n\) | cerca de \(n \log n\) com um índice |
| mesmo resultado a cada execução | sim | depende da inicialização | sim |
Aplicações
Taxonomias. Sempre que o produto é uma árvore e não uma partição: espécies a partir de características ou de DNA (a origem do método, a taxonomia numérica de Sokal & Rohlf), catálogos de produtos, os assuntos de uma coleção de documentos organizados em temas e subtemas. O laboratório reconstrói assim as classes zoológicas de 101 animais.
Mapas de calor de expressão gênica. Uma tabela genes × amostras é ilegível na ordem original. Agrupe separadamente os genes (linhas) e as amostras (colunas), usando distância de correlação; depois redesenhe a tabela com as duas na ordem das folhas do dendrograma. Genes que sobem e descem juntos ficam lado a lado; o mesmo vale para amostras com o mesmo perfil. É o "mapa de calor agrupado" de quase todo artigo de genômica (o clustermap do seaborn faz isso numa chamada; aqui, só com SciPy e matplotlib):
from scipy.cluster.hierarchy import leaves_list

rng = np.random.default_rng(3)
E = rng.normal(size=(40, 12))                                         # qualquer tabela genes x amostras
Ez = (E - E.mean(axis=1, keepdims=True)) / E.std(axis=1, keepdims=True)   # padroniza (z-score) cada gene
rows = leaves_list(linkage(Ez, 'average', metric='correlation'))      # ordem dos genes
cols = leaves_list(linkage(Ez.T, 'average', metric='correlation'))    # ordem das amostras
plt.imshow(Ez[rows][:, cols], aspect='auto', cmap='RdBu_r')
plt.show()
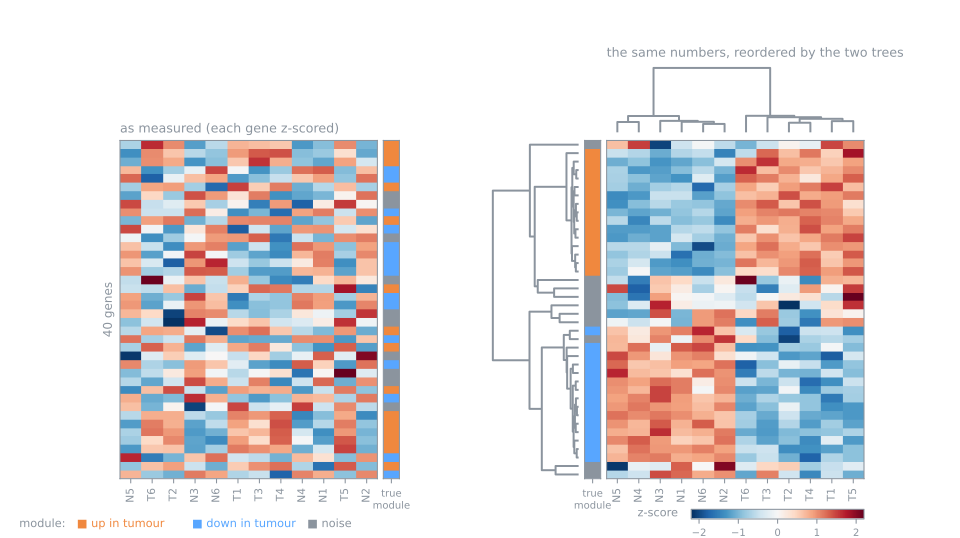
A figura usa uma tabela sintética com resposta conhecida: 15 genes que sobem nos tumores, 15 que descem e 10 de ruído, cada gene com seu próprio nível de base; linhas e colunas foram embaralhadas. Nada é visível à esquerda. À direita, sem nenhuma informação além dos números, a árvore das colunas separa as seis amostras de tumor das seis normais na sua fusão do topo; a faixa do módulo verdadeiro ao lado das linhas vira blocos sólidos: a árvore recuperou os dois fatores do experimento.
Segmentação em várias granularidades. Uma equipe de marketing raramente sabe se quer 3 segmentos ou 12. Uma única árvore sobre a tabela de clientes responde às duas perguntas, de forma coerente: os 12 segmentos finos são subdivisões dos 3 grossos, então uma campanha desenhada para um segmento grosso continua valendo para os seus subsegmentos. Execuções separadas do k-means com \(k = 3\) e \(k = 12\) não dão essa garantia.
Lab: uma árvore de 101 animais
Os dados. A tabela Zoo da UCI (Forsyth, 1990): 101 animais, cada um descrito por 15 perguntas de sim/não (tem pelos? penas? põe ovos? produz leite? voa? vive na água? …) e pelo número de pernas. Ela também traz a classe que um zoólogo daria — mamífero, ave, peixe, réptil, anfíbio, inseto, invertebrado —, que mantemos lacrada até o passo 8, como no laboratório dos vinhos da aula de agrupamento: toda decisão (escala, ligação, corte) é tomada como seria tomada sem gabarito; o gabarito é usado depois só para auditar essas decisões.
A pergunta. Uma árvore construída com 16 atributos simples consegue redescobrir a taxonomia dos zoólogos? E o que ela mostra que o k-means não mostra?
Usamos a cópia 42667 da tabela no OpenML porque ela mantém os nomes dos animais (a cópia mais antiga, OpenML 62, os descarta). Toda saída abaixo é o que o código imprime; o laboratório inteiro roda em poucos segundos. Para trabalhar direto nele, baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook).
Passo 1 — carregar e olhar
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_openml

zoo = fetch_openml(data_id=42667, as_frame=True).frame     # UCI Zoo, com os nomes dos animais
animals = zoo['animal'].to_numpy()
kind = zoo['type']                                          # a classe dos zoólogos: lacrada até o passo 8
X = zoo.drop(columns=['animal', 'type'])
for col in X.columns.drop('legs'):
    X[col] = (X[col].astype(str) == 'True').astype(int)    # sim/não -> 1/0
print(X.shape)
pick = [list(animals).index(a) for a in ['bear', 'chicken', 'crab']]
print(X.iloc[pick].set_axis(animals[pick]).T.to_string())
print('legs:', X['legs'].value_counts().sort_index().to_dict())
print('rows identical to an earlier row:', X.duplicated().sum())
(101, 16)
          bear  chicken  crab
hair         1        0     0
feathers     0        1     0
eggs         0        1     1
milk         1        0     0
airborne     0        1     0
aquatic      0        0     1
predator     1        0     1
toothed      1        0     0
backbone     1        1     0
breathes     1        1     0
venomous     0        0     0
fins         0        0     0
legs         4        2     4
tail         0        1     0
domestic     0        1     0
catsize      1        0     0
legs: {0: 23, 2: 27, 4: 38, 5: 1, 6: 10, 8: 2}
rows identical to an earlier row: 42
Dezesseis colunas: quinze são respostas 0/1 e legs (pernas) é uma contagem de 0 a 8. Duas coisas a notar antes de agrupar. Primeiro, 42 das 101 linhas são cópias exatas de uma linha anterior: muitos animais são indistinguíveis por essas 16 perguntas (a maioria dos peixes, por exemplo, responde tudo igual). A árvore vai fundi-los na altura 0. Segundo, "frog" (rã) aparece duas vezes na tabela, como dois animais diferentes, um deles venenoso.
Passo 2 — pôr as colunas na mesma escala
raw = X.to_numpy(dtype=float)
sq = (raw[:, None, :] - raw[None, :, :]) ** 2               # todo par, toda coluna
share = pd.Series(sq.sum(axis=(0, 1)) / sq.sum(), index=X.columns)
print(share.sort_values(ascending=False).head(3).round(3))

from sklearn.preprocessing import MinMaxScaler

Xs = MinMaxScaler().fit_transform(X)                        # legs / 8; as colunas 0/1 continuam 0/1
sq = (Xs[:, None, :] - Xs[None, :, :]) ** 2
print('share of legs after scaling:', round(sq[:, :, X.columns.get_loc('legs')].sum() / sq.sum(), 3))
yes_no = X.columns != 'legs'
i, j = pick[1], pick[2]
print(f"chicken vs crab: {(raw[i] != raw[j])[yes_no].sum()} yes/no answers differ, "
      f"legs {raw[i, ~yes_no][0]:.0f} vs {raw[j, ~yes_no][0]:.0f}, "
      f"squared distance {((Xs[i] - Xs[j]) ** 2).sum():.4f}")
legs        0.589
predator    0.036
catsize     0.035
dtype: float64
share of legs after scaling: 0.022
chicken vs crab: 8 yes/no answers differ, legs 2 vs 4, squared distance 8.0625
Como ler:
- Sem escala,
legsé o agrupamento. Somando sobre todos os pares de animais, 58,9% da distância euclidiana ao quadrado vem dessa única coluna; cada uma das outras quinze contribui com menos de 4%. Uma diferença de duas pernas pesa tanto quanto quatro respostas de sim/não. É o problema de escala de Pré-processamento de novo, na sua forma mais pura. - Qual escalonador? O
MinMaxScalerlevalegspara [0, 1] (divide por 8) e deixa as colunas 0/1 exatamente como estão. Depois dele,legscontribui com 2,2%; a distância ao quadrado ganha um significado simples: o número de perguntas de sim/não em que dois animais discordam, mais um termo pequeno para as pernas. A galinha e o caranguejo discordam em 8 perguntas e diferem em duas pernas, \((2/8)^2 = 0{,}0625\), total 8,0625. OStandardScalerdividiria cada coluna pelo seu próprio desvio padrão, o que dá a uma resposta rara (venomous, 8 animais) cerca de três vezes o peso de uma comum (hair); não há razão zoológica para isso, então não fazemos.
Como o laboratório dos vinhos mostrou, nenhum índice de agrupamento pode tomar essa decisão por você: um índice calculado depois de escalar mede a geometria que a escala criou. Ela se decide pelo que uma distância deve significar para esses dados.
Passo 3 — quatro ligações e a fidelidade de cada árvore
from scipy.cluster.hierarchy import cophenet, linkage
from scipy.spatial.distance import pdist

d = pdist(Xs)                                               # as 5.050 distâncias entre pares
trees = {m: linkage(Xs, m) for m in ['single', 'complete', 'average', 'ward']}
for m, Z in trees.items():
    print(f"{m:8s} cophenetic correlation {cophenet(Z, d)[0]:.3f}   top merge at {Z[-1, 2]:.2f}")
single   cophenetic correlation 0.867   top merge at 2.00
complete cophenetic correlation 0.885   top merge at 3.68
average  cophenetic correlation 0.905   top merge at 2.75
ward     cophenetic correlation 0.802   top merge at 14.03
A ligação média é a que melhor preserva as distâncias originais, com correlação cofenética de 0,905; a completa (0,885) e a simples (0,867) vêm em seguida; Ward fica por último (0,802). As alturas de Ward estão em outra escala (sua fusão do topo está em 14,03, contra 2,00 a 3,68 das outras, porque ela mede o crescimento da soma de quadrados, não uma distância entre animais); além disso, sua árvore comprime muitos pares diferentes em poucas alturas grandes. Como o produto que queremos é uma taxonomia, uma árvore cujas alturas possam ser lidas como "quão diferentes são estes animais", seguimos com a ligação média. É para isso que a correlação cofenética serve: escolher entre árvores quando a própria árvore é o resultado.
Passo 4 — desenhar a árvore
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import dendrogram

Z = trees['average']
print('merges at height 0 (identical animals):', (Z[:, 2] == 0).sum())
print('last 8 merge heights:', Z[-8:, 2].round(3))
fig, ax = plt.subplots(figsize=(7, 15))
dendrogram(Z, labels=animals, orientation='left', leaf_font_size=7, ax=ax)
ax.set_xlabel('merge height (average distance between the two groups)')
plt.show()
merges at height 0 (identical animals): 42
last 8 merge heights: [1.894 1.917 2.009 2.097 2.258 2.445 2.519 2.752]
As primeiras 42 fusões acontecem na altura 0: são as 42 linhas duplicadas do passo 1, absorvidas pelas suas gêmeas antes de qualquer outra coisa. As últimas oito fusões, as que dão forma ao topo da árvore, sobem de 1,894 a 2,752. O gráfico é alto de propósito (101 nomes); a versão anotada está no passo 9. Antes de continuar lendo, olhe o gráfico e anote quantos grupos você diria que existem.
Passo 5 — escolher o corte: saltos e silhueta
from scipy.cluster.hierarchy import fcluster
from sklearn.metrics import silhouette_score

h = Z[::-1, 2]                          # h[0] funde 2 -> 1 grupos, h[1] funde 3 -> 2, ...
rows = []
for k in range(2, 11):
    labels = fcluster(Z, k, criterion='maxclust')
    rows.append({'k': k, 'gap': h[k - 2] - h[k - 1], 'silhouette': silhouette_score(Xs, labels),
                 'sizes': sorted(np.bincount(labels)[1:], reverse=True)})
print(pd.DataFrame(rows).round(3).to_string(index=False))
 k   gap  silhouette                              sizes
 2 0.233       0.325                           [60, 41]
 3 0.074       0.346                       [41, 39, 21]
 4 0.187       0.398                   [41, 21, 21, 18]
 5 0.161       0.389                [41, 21, 21, 17, 1]
 6 0.087       0.403             [41, 21, 21, 10, 7, 1]
 7 0.092       0.405          [41, 21, 14, 10, 7, 7, 1]
 8 0.022       0.383       [35, 21, 14, 10, 7, 7, 6, 1]
 9 0.025       0.380    [35, 21, 13, 10, 7, 7, 6, 1, 1]
10 0.169       0.377 [35, 21, 13, 10, 7, 7, 5, 1, 1, 1]
Como ler:
- Saltos. A faixa de alturas mais larga é a de \(k = 2\) (0,233): um ramo de 41 animais contra os outros 60. As seguintes são \(k = 4\) (0,187) e \(k = 5\) (0,161). \(k = 3\), \(k = 8\) e \(k = 9\) têm faixas estreitas e pouco apoio. (\(k = 10\) também tem uma faixa larga, 0,169, mas só destaca animais isolados: tamanhos 1, 1, 1.)
- Silhueta. É máxima em \(k = 7\) (0,405), mas \(k = 4\), 6 e 7 ficam a menos de 0,007 um do outro; a curva é um platô de 4 a 7, não um pico.
- Tamanhos. A partir de \(k = 5\), um dos "grupos" é um único animal. Isso não é necessariamente errado — alguns animais são de fato diferentes do resto —, mas vale saber qual é.
Os instrumentos não apontam um único \(k\) — e uma árvore não obriga você a escolher um só. Ficamos com dois níveis aninhados: \(k = 4\) como nível grosso (o segundo maior salto e uma silhueta dentro do platô) e \(k = 7\) como nível fino (a melhor silhueta). Note que escolhemos sem olhar as classes dos zoólogos.
Passo 6 — o que são os grupos? Traçar o perfil
hc4 = fcluster(Z, 4, criterion='maxclust')
hc7 = fcluster(Z, 7, criterion='maxclust')
profile = pd.DataFrame(Xs, columns=X.columns).groupby(hc4).mean()
profile.insert(0, 'size', np.bincount(hc4)[1:])
print(profile[['size', 'hair', 'milk', 'feathers', 'backbone', 'fins', 'toothed', 'legs', 'airborne']].round(2).to_string())
for c in range(1, 8):
    members = animals[hc7 == c]
    print(f"k=7 cluster {c} ({len(members):2d}):", ', '.join(members[:6]) + (' ...' if len(members) > 6 else ''))
   size  hair  milk  feathers  backbone  fins  toothed  legs  airborne
1    41  0.95   1.0      0.00       1.0  0.10     0.98  0.42      0.05
2    21  0.00   0.0      0.00       1.0  0.62     1.00  0.12      0.00
3    21  0.00   0.0      0.95       1.0  0.00     0.00  0.26      0.76
4    18  0.22   0.0      0.00       0.0  0.00     0.00  0.59      0.33
k=7 cluster 1 (41): aardvark, antelope, bear, boar, buffalo, calf ...
k=7 cluster 2 ( 7): frog, frog, newt, pitviper, slowworm, toad ...
k=7 cluster 3 (14): bass, carp, catfish, chub, dogfish, haddock ...
k=7 cluster 4 (21): chicken, crow, dove, duck, flamingo, gull ...
k=7 cluster 5 ( 7): clam, crab, crayfish, lobster, octopus, seawasp ...
k=7 cluster 6 (10): flea, gnat, honeybee, housefly, ladybird, moth ...
k=7 cluster 7 ( 1): scorpion
Cada número do perfil é a fração do grupo que responde "sim" (para legs, o número médio de pernas dividido por 8). Lendo como um zoólogo leria:
- grupo 1 (41): pelos (
hair) 0,95, leite (milk) 1,00 — mamíferos; - grupo 2 (21): coluna vertebral (
backbone) e dentes (toothed) em todos, 62% com nadadeiras (fins), sem pelos, leite ou penas — os vertebrados de sangue frio, peixes junto com anfíbios e répteis; - grupo 3 (21): penas (
feathers) 0,95, voa (airborne) 0,76, coluna 1,00 — aves; - grupo 4 (18): nenhuma coluna vertebral, o maior número de pernas (0,59, cerca de 4,7 em média) — os invertebrados.
O nível \(k = 7\) divide os grupos 2 e 4: os peixes (14) separados de rãs, tritões e cobras (7); os invertebrados marinhos (mariscos, caranguejos, polvo, 7) separados dos insetos e de outros invertebrados terrestres (10); e o escorpião, sozinho. Ele tem oito pernas, cauda, veneno e pulmões, uma combinação que nenhum outro animal da tabela tem.
Passo 7 — os mesmos dados com k-means
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score

km4 = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(Xs)
km7 = KMeans(n_clusters=7, n_init=10, random_state=0).fit_predict(Xs)
print(f"agreement tree vs k-means (ARI): k=4 {adjusted_rand_score(hc4, km4):.3f}  k=7 {adjusted_rand_score(hc7, km7):.3f}")
print(pd.crosstab(pd.Series(hc4, name='tree k=4'), pd.Series(hc7, name='tree k=7')))
print(pd.crosstab(pd.Series(km4, name='k-means k=4'), pd.Series(km7, name='k-means k=7')))
agreement tree vs k-means (ARI): k=4 0.940  k=7 0.683
tree k=7   1  2   3   4  5   6  7
tree k=4
1         41  0   0   0  0   0  0
2          0  7  14   0  0   0  0
3          0  0   0  21  0   0  0
4          0  0   0   0  7  10  1
k-means k=7   0   1   2   3  4   5  6
k-means k=4
0             0  19   0   0  0  20  0
1            15   0   0   0  8   0  0
2             0   0  10   0  1   0  7
3             0   0   0  21  0   0  0
Como ler:
- Em \(k = 4\), os dois métodos quase concordam (ARI de 0,940 entre as duas partições): com quatro grupos grandes e claramente diferentes, "pontos perto de um centroide" e "ramos da árvore" descrevem quase a mesma coisa.
- Em \(k = 7\), eles divergem (ARI 0,683). A primeira tabela cruzada mostra por que a resposta da árvore é fácil de usar: todo grupo de \(k = 7\) está dentro de exatamente um grupo de \(k = 4\) (um único valor não nulo por coluna). A segunda mostra que duas execuções do k-means não têm essa estrutura. A execução com \(k = 7\) corta o maior grupo de \(k = 4\) (39 animais) em duas metades de 19 e 20; um dos grupos novos (coluna 4) pega 8 animais de um grupo de \(k = 4\) e 1 de outro. O k-means prefere grupos de tamanho parecido, então, com sete para preencher, ele parte o grupo maior ao meio em vez de isolar um pequeno.
Passo 8 — abrir o gabarito
for name, labels in [('tree k=4', hc4), ('tree k=7', hc7), ('k-means k=4', km4), ('k-means k=7', km7)]:
    print(f"{name:12s} ARI vs zoologists' class {adjusted_rand_score(kind, labels):.3f}")
print(pd.crosstab(pd.Series(hc7, name='tree k=7'), kind))
print(pd.crosstab(pd.Series(km7, name='k-means k=7'), kind))
tree k=4     ARI vs zoologists' class 0.883
tree k=7     ARI vs zoologists' class 0.950
k-means k=4  ARI vs zoologists' class 0.819
k-means k=7  ARI vs zoologists' class 0.641
type      amphibian  bird  fish  insect  invertebrate  mammal  reptile
tree k=7
1                 0     0     0       0             0      41        0
2                 4     0     0       0             0       0        3
3                 0     0    13       0             0       0        1
4                 0    20     0       0             0       0        1
5                 0     0     0       0             7       0        0
6                 0     0     0       8             2       0        0
7                 0     0     0       0             1       0        0
type         amphibian  bird  fish  insect  invertebrate  mammal  reptile
k-means k=7
0                    0     0    13       0             0       2        0
1                    0     0     0       0             0      19        0
2                    0     0     0       8             2       0        0
3                    0    20     0       0             0       0        1
4                    4     0     0       0             1       0        4
5                    0     0     0       0             0      20        0
6                    0     0     0       0             7       0        0
A árvore cortada em sete chega a ARI 0,950 contra as sete classes. Só cinco dos 101 animais caem fora do grupo principal da sua classe. Cada erro ensina alguma coisa:
- a tartaruga (tortoise) está entre as aves: sem dentes, põe ovos, tem cauda, coluna vertebral e pulmões. Tirando "penas" e "voa", esse é o perfil de uma ave;
- a cobra-do-mar (seasnake) está entre os peixes: aquática, com dentes e (nesta tabela) não respira ar;
- dois dos "invertebrados" (a lesma e a minhoca) ficam com os insetos e o escorpião fica sozinho;
- e anfíbios e répteis dividem um grupo (4 + 3): por essas 16 perguntas, um sapo e um licranço têm quase a mesma folha de respostas.
O k-means com \(k = 7\) tira só 0,641. A tabela dele mostra por quê: ele gasta dois dos seus sete grupos com mamíferos (19 e 20; os 2 mamíferos restantes vão parar com os peixes) e, para pagar por isso, junta anfíbios, répteis e um invertebrado num único grupo. Em \(k = 4\), os dois métodos vão bem (0,883 e 0,819). A árvore se saiu melhor aqui não por ser um algoritmo melhor em geral, mas porque a taxonomia é uma árvore: grupos grandes e desiguais (41 mamíferos, 4 anfíbios) aninhados dentro de grupos maiores, que é exatamente a estrutura que o agrupamento aglomerativo produz e o k-means não.
Passo 9 — o mapa de calor, reordenado pela árvore
from scipy.cluster.hierarchy import leaves_list

rows = leaves_list(Z)                                     # animais na ordem do dendrograma
cols = leaves_list(linkage(Xs.T, 'average'))              # atributos agrupados do mesmo jeito
print(', '.join(animals[rows][:12]), '...')
print(list(X.columns[cols]))
fig, ax = plt.subplots(figsize=(6, 15))
ax.imshow(Xs[rows][:, cols], aspect='auto', cmap='Blues', interpolation='nearest')
ax.set_yticks(range(len(rows)), animals[rows], fontsize=6)
ax.set_xticks(range(len(cols)), X.columns[cols], rotation=90)
plt.show()
aardvark, bear, wolf, raccoon, puma, polecat, mongoose, lynx, lion, leopard, boar, cheetah ...
['eggs', 'aquatic', 'fins', 'feathers', 'airborne', 'legs', 'venomous', 'domestic', 'predator', 'catsize', 'hair', 'milk', 'breathes', 'toothed', 'backbone', 'tail']
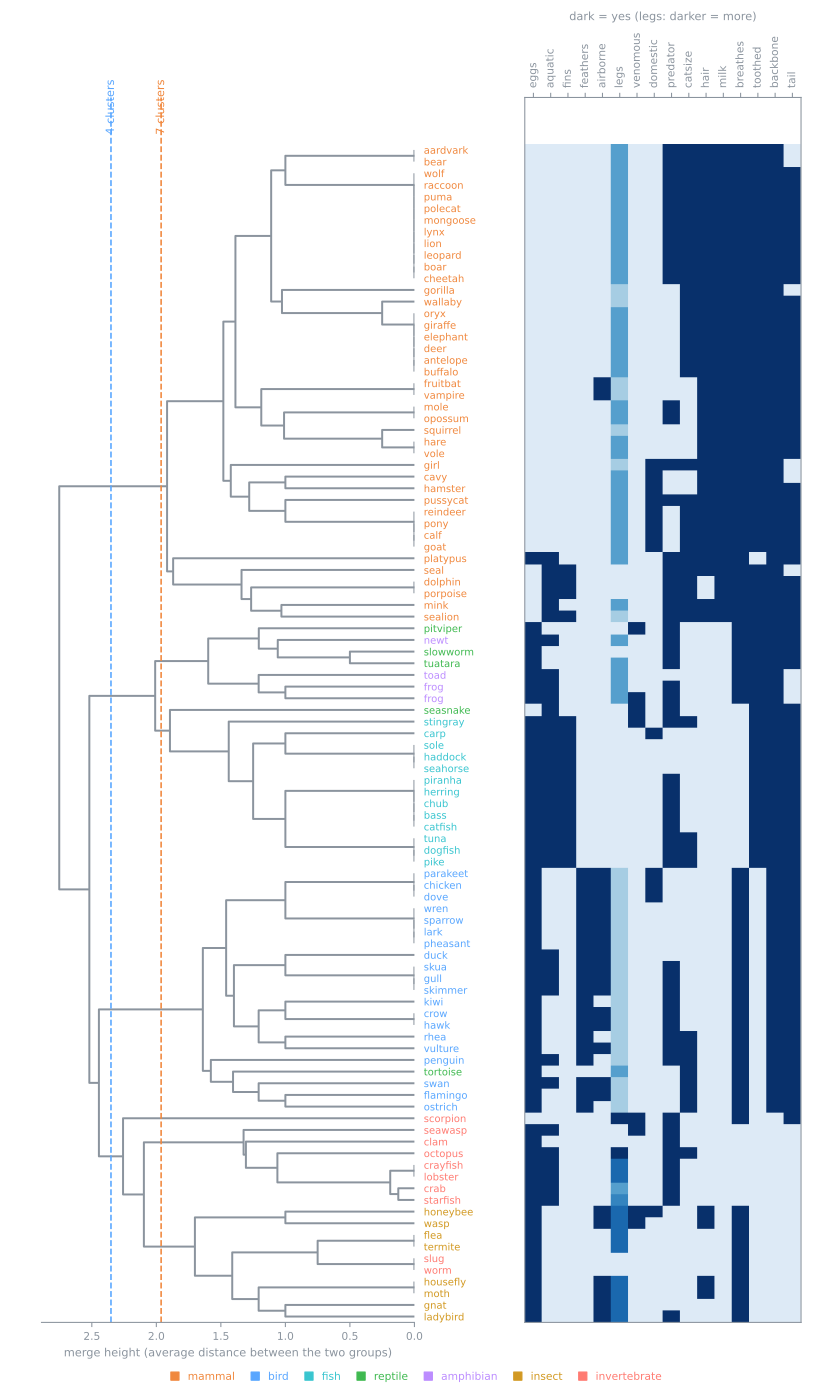
leaves_list devolve a ordem das folhas do dendrograma; o mesmo truque agrupa as colunas: atributos que costumam ter a mesma resposta (ovos, aquático, nadadeiras; pelos, leite, respira, dentes) ficam lado a lado. O resultado é a própria tabela, sem nada acrescentado nem removido, mas lida numa ordem em que a sua estrutura fica visível: blocos sólidos de pelos e leite descendo pelos mamíferos, penas pelas aves, nadadeiras pelos peixes e a coluna vertebral vazia pelos invertebrados. As cores dos nomes mostram a auditoria do passo 8 num relance.
Sua vez
- Uma distância para dados de sim/não. As 15 colunas de sim/não podem ser comparadas pela distância de Jaccard (a fração de discordâncias entre as perguntas em que pelo menos um dos dois animais responde sim). Construa
linkage(Xs[:, yes_no].astype(bool), 'average', metric='jaccard'), corte em 7 e compare o ARI contrakindcom o do passo 8. Por que não dá para usar'ward'com essa métrica? - Ligação simples no zoológico. Corte
trees['single']em \(k = 4\) e \(k = 7\) e imprima os tamanhos dos grupos. Onde aparece o encadeamento? Relacione o que você vê com a correlação cofenética dela no passo 3, que não foi a mais baixa. - StandardScaler no lugar. Refaça os passos 3 a 8 com
StandardScaler. O ARI em \(k = 7\) sobe ou desce? Que atributos ganharam peso? Isso faz sentido zoológico? - Tire as duplicatas. Remova as 42 linhas duplicadas (
X.duplicated()), reconstrua a árvore média e compare a tabela de saltos e silhueta com a do passo 5. Que números mudam? Por que as duplicatas importam para a silhueta, mas não para a forma da árvore?
Material de aula
Notebook do lab e handouts
- Notebook do lab desta aula: lab-hierarchical-clustering.ipynb — baixe e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook).
- Handout — Agrupamento e k-means: o panorama final situa o agrupamento hierárquico entre as outras famílias de métodos e compara Ward com k-means, GMM, agrupamento espectral e HDBSCAN em cinco formas: handout
- Laboratório — Agrupar 178 vinhos: a etapa 7 audita Ward contra k-means e GMM nos dados de vinhos; o segundo desafio agrupa uma matriz de coassociação com ligação média: abrir o desafio
Referências
- Ward, J. H., Jr. "Hierarchical Grouping to Optimize an Objective Function." Journal of the American Statistical Association 58, no. 301 (1963): 236–244 — a fusão que menos aumenta a soma de quadrados. DOI
- Sokal, R. R.; Rohlf, F. J. "The Comparison of Dendrograms by Objective Methods." Taxon 11, no. 2 (1962): 33–40 — a correlação cofenética. DOI
- Lance, G. N.; Williams, W. T. "A General Theory of Classificatory Sorting Strategies: 1. Hierarchical Systems." The Computer Journal 9, no. 4 (1967): 373–380 — uma única fórmula de atualização para todas as ligações. DOI
- Gower, J. C.; Ross, G. J. S. "Minimum Spanning Trees and Single Linkage Cluster Analysis." Journal of the Royal Statistical Society, Series C (Applied Statistics) 18, no. 1 (1969): 54–64 — a ligação simples é a árvore geradora mínima. DOI
- Müllner, D. "Modern Hierarchical, Agglomerative Clustering Algorithms." (2011) — os algoritmos por trás do
linkagedo SciPy e sua complexidade. arXiv:1109.2378 - Forsyth, R. "Zoo." UCI Machine Learning Repository (1990) — o conjunto de dados do laboratório (OpenML 42667). DOI