O caminho desta parte
- Casar a ligação com a formaencadeamento contra grupos compactos; uma regra local de corte
- Escolher a distânciauma fórmula de atualização; correlação e cosseno
- Encarar o customemória e tempo quadráticos; amostrar e depois atribuir
- Escolher a ferramentacontra o k-means e o agrupamento por densidade; aplicações
O comportamento de cada ligação, medido
Quatro conjuntos com grupos conhecidos, 300 pontos cada; todo método recebe o número verdadeiro de grupos. A nota é o ARI (índice de Rand ajustado, Adjusted Rand Index): 1 para os grupos verdadeiros, perto de 0 para o acaso.
| simples | completa | média | Ward | |
|---|---|---|---|---|
| bolhas | 0,57 | 0,98 | 0,98 | 0,98 |
| bolhas + ponte | 0,00 | 0,91 | 0,99 | 0,96 |
| luas | 1,00 | 0,20 | 0,43 | 0,30 |
| faixas paralelas | 1,00 | 0,12 | 0,19 | 0,22 |
Dois campos
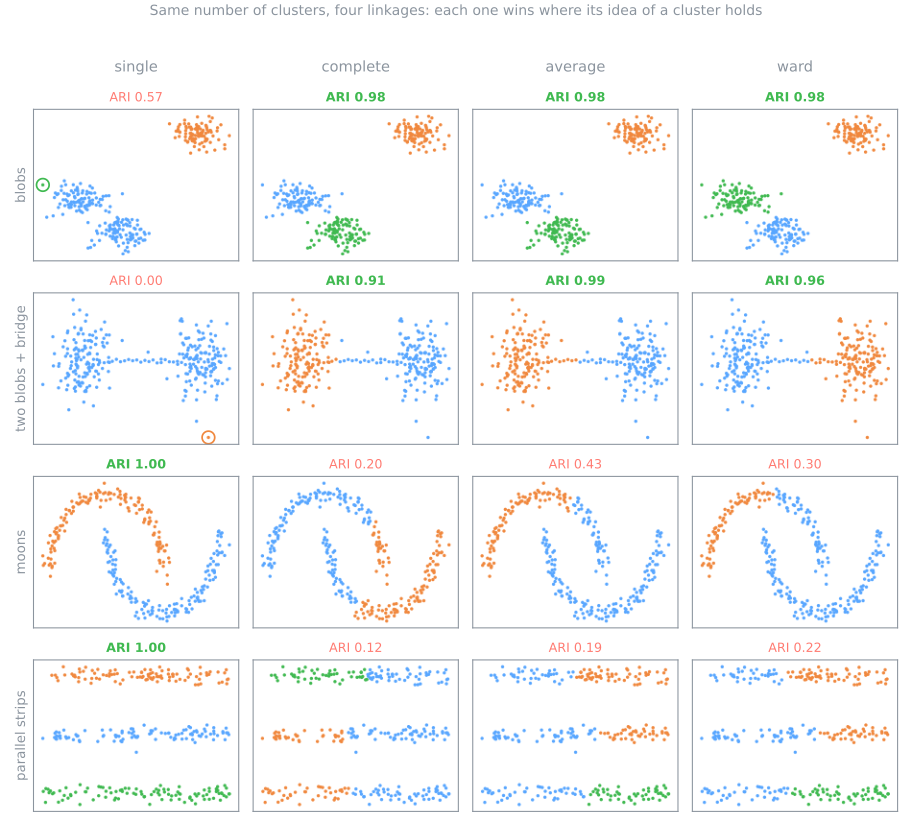
A simples pergunta "existe algum salto curto?": segue cadeias (1,00 nas luas e nas faixas) e uma ponte de 20 pontos funde duas bolhas (0,00). Isso é o encadeamento (chaining).
A completa, a média e Ward comparam os grupos como um todo: uma ponte não consegue puxar duas bolhas uma para a outra, mas elas cortam as luas e as faixas de través, como o k-means.
Uma regra local para o corte: o coeficiente de inconsistência
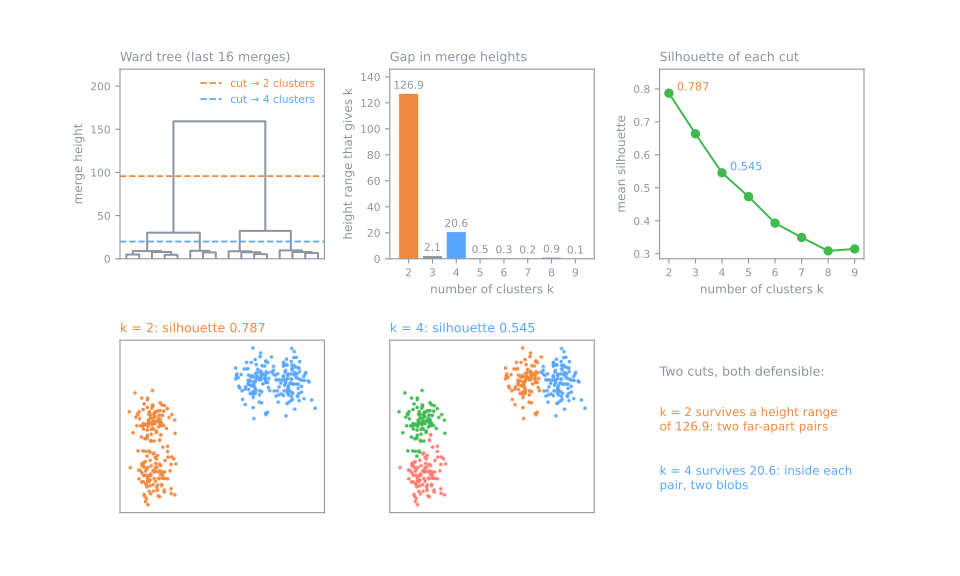
\(h\) = altura de uma fusão; \(\bar h\), \(s\) = média e desvio padrão de \(h\) e das alturas das fusões logo abaixo dela (profundidade 2: no máximo três alturas). Árvore de Ward dos 400 pontos.
| fusão | \(\bar h\) | \(s\) | coef. |
|---|---|---|---|
| 4ª do topo | 7,05 | 3,05 | 0,86 |
| 3ª | 16,14 | 12,22 | 1,15 |
| 2ª | 16,90 | 13,36 | 1,15 |
| topo | 73,93 | 73,87 | 1,15 |
Uma fórmula de atualização para todas as ligações
Depois que \(I\) e \(J\) se fundem, a distância de qualquer outro grupo \(K\) até \(I \cup J\) (Lance & Williams, 1967), com coeficientes \(\alpha_I, \alpha_J, \beta, \gamma\) escolhidos pela ligação:
\[ d(K, I \cup J) = \alpha_I\, d(K, I) + \alpha_J\, d(K, J) + \beta\, d(I, J) + \gamma\, \lvert d(K, I) - d(K, J) \rvert \]| ligação | coeficientes | \(d(C, \{A, B\})\) |
|---|---|---|
| simples | \(\alpha = \tfrac12,\ \beta = 0,\ \gamma = -\tfrac12\) | \(3{,}5 + 2 - 1{,}5 = 4\) |
| completa | \(\alpha = \tfrac12,\ \beta = 0,\ \gamma = +\tfrac12\) | \(3{,}5 + 2 + 1{,}5 = 7\) |
| média | \(\alpha_I = \tfrac{|I|}{|I| + |J|},\ \beta = \gamma = 0\) | \(3{,}5 + 2 = 5{,}5\) |
Além da distância euclidiana
perfis: distância de correlação
Quatro clientes: dois crescem de forma constante, dois gastam quase tudo num único mês; em cada par, um gasta cinco vezes mais.
A euclidiana agrupa por quanto gastam; \(1 - r\) agrupa pelo formato do gasto.
documentos: distância do cosseno
Um texto, o mesmo texto dez vezes mais longo, um texto sobre outro tema. A partir do primeiro, euclidiana: 20,12 até a cópia longa, 3,87 até o outro tema. Cosseno: 0,0 e 1,0.
Custo: por que não escala
| linhas | distâncias entre pares |
|---|---|
| 1.000 | 0,004 GB |
| 10.000 | 0,400 GB |
| 100.000 | 40 GB |
| 1.000.000 | cerca de 4.000 GB |
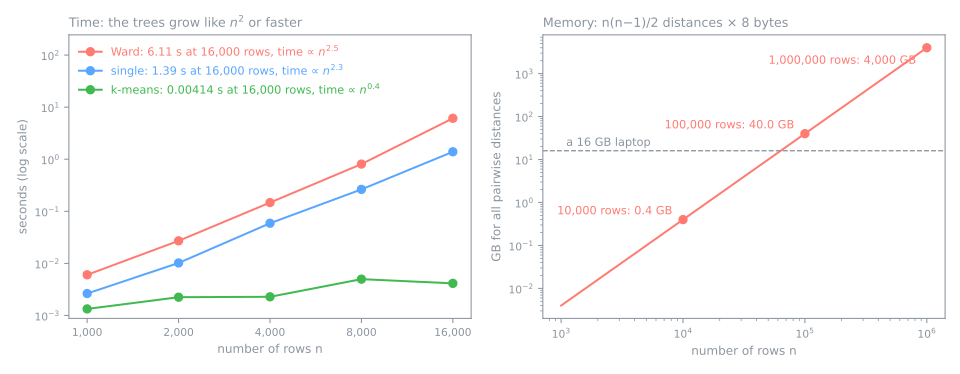
Os melhores algoritmos são \(O(n^2)\), ainda quadráticos. Na máquina em que a figura foi gerada, 16.000 linhas levaram 6,11 s com Ward; o k-means, 0,004 s. Um método para centenas a dezenas de milhares de linhas.
O que fazer com mais linhas
- Amostrar e depois atribuir. Árvore numa amostra de 2% (2.000 de 100.000 linhas), cortada em 5, cada um dos demais pontos ao centroide mais próximo: ARI 0,993. O que se perde é a estrutura fina: um grupo de 30 pontos teria cerca de 0,6 representante.
- Restrições de conectividade: só fundir vizinhos num grafo esparso.
- O HDBSCAN (o DBSCAN hierárquico; DBSCAN: density-based spatial clustering of applications with noise) é ele próprio hierárquico: uma árvore de ligação simples sobre uma distância ajustada pela densidade, sem a matriz completa. Além disso, marca ruído.
Hierárquico vs k-means vs DBSCAN
| hierárquico | k-means | DBSCAN / HDBSCAN | |
|---|---|---|---|
| um grupo é | um ramo da árvore de fusões | os pontos mais perto de um centroide | uma região densa |
| decidido depois do ajuste | \(k\) ou a altura do corte | — | — |
| saída | uma família aninhada de partições | uma partição | uma partição mais ruído |
| qualquer distância? | sim, exceto Ward | só euclidiana | sim |
| pontos novos | sem predict | predict | sem predict |
| mesmo resultado a cada execução | sim | depende da inicialização | sim |
Aplicações
Taxonomias: sempre que o produto é uma árvore e não uma partição.
Segmentação em várias granularidades: 12 segmentos finos que são subdivisões de 3 grossos.
Mapas de calor de expressão gênica: agrupe linhas e colunas com distância de correlação e redesenhe na ordem das folhas.
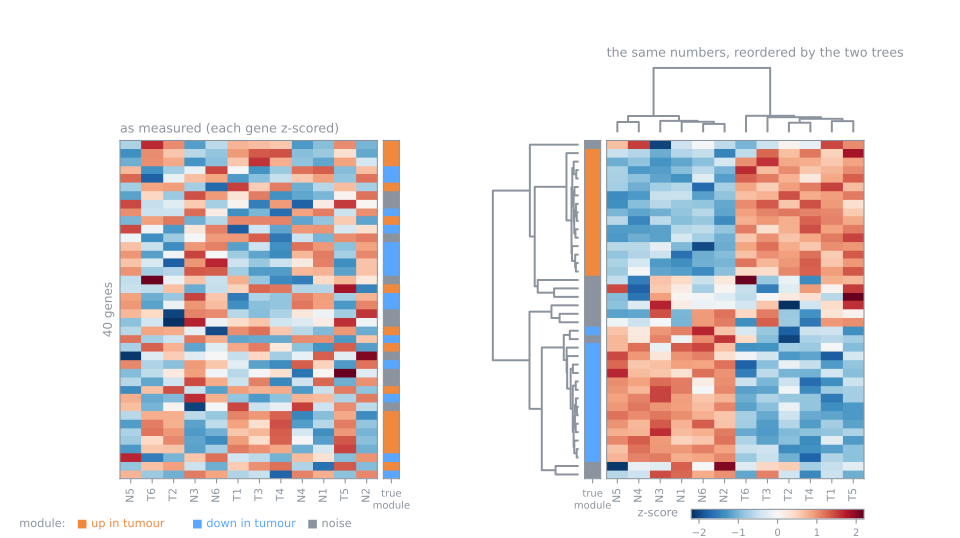
Os mesmos números, reordenados pela árvore: aparecem blocos de genes que sobem e que descem nos tumores e a árvore das colunas separa as amostras de tumor das normais na sua fusão do topo.
Resumo
- A simples segue cadeias e se engana com pontes; a completa, a média e Ward acham grupos compactos e cortam formas finas de través.
- Uma regra local de corte (o coeficiente de inconsistência) deixa escapar o que os saltos, lidos do topo, enxergam.
- Uma fórmula de atualização: qualquer dissimilaridade serve, exceto para Ward. Distância de correlação para perfis, cosseno para documentos.
- Memória e tempo quadráticos: centenas a dezenas de milhares de linhas. Além disso: amostrar e atribuir, restrições de conectividade, HDBSCAN.
- Escolha uma árvore quando o produto é uma hierarquia, os grupos são desiguais ou vários níveis de detalhe são necessários.
A árvore contra o k-means e o gabarito, passos 7 a 9
- Mesmo notebook, mesma sessão, a partir do passo 7.
- Passo 7: o k-means com \(k = 4\) e \(k = 7\); as partições dele são aninhadas como os cortes da árvore?
- Passo 8: abrir as classes dos zoólogos e auditar cada decisão do lab fundamental.
- Passo 9: o mapa de calor, com linhas e colunas reordenadas pela árvore.
- Simulações: o k-means com outra semente (passo 7) e a ligação, auditada (passo 8).
Ritmo: passo 7 e a sua simulação em 10 min; passo 8 e a sua simulação em 10 min; passo 9 em 5 min.