O caminho desta parte
- Escolher a distânciaMinkowski, cosseno, Hamming: pelo tipo de dado
- Como o voto contaempates, pesos 1/d, um
predict_probagrosseiro - Onde quebraa maldição da dimensionalidade; o custo de prever
- Quando usarcontra a regressão logística; regressão; perfil prático
A família de Minkowski
\[ d_p(a, b) = \Big( \sum_{j=1}^{d} \lvert a_j - b_j \rvert^p \Big)^{1/p} \]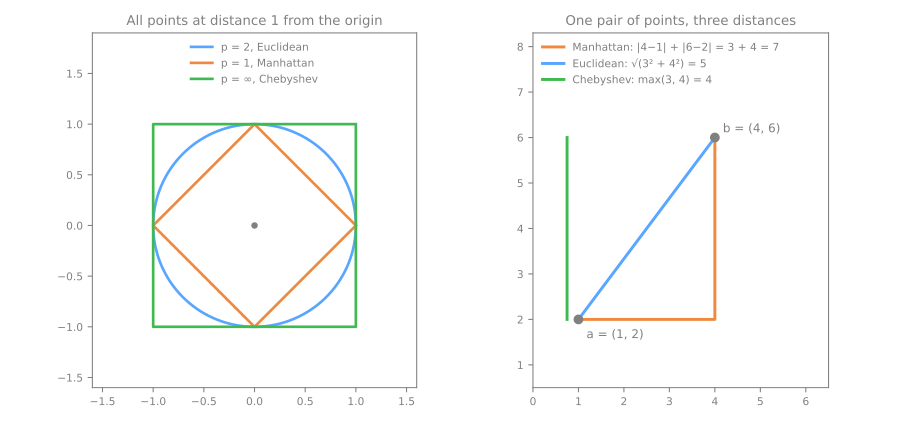
\(a = (1, 2)\), \(b = (4, 6)\): diferenças 3 e 4.
| \(p = 1\) Manhattan | \(3 + 4 = 7\) |
| \(p = 2\) euclidiana | \(\sqrt{9 + 16} = 5\) |
| \(p = \infty\) Chebyshev | \(\max(3, 4) = 4\) |
Elevar ao quadrado deixa a euclidiana sensível a uma diferença grande num só atributo.
Escolha a distância pelo tipo de dado
| tipo de dado | distância | por quê |
|---|---|---|
| numéricos, escalonados | euclidiana | a linha reta; o padrão |
| diferenças grandes e isoladas | Manhattan | um atributo sozinho domina menos |
| texto, TF-IDF, embeddings | cosseno | compara direção, ignora comprimento |
| binários, one-hot | Hamming | conta posições diferentes |
Empates
- Com duas classes, \(k\) ímpar nunca empata; \(k\) par pode.
- O scikit-learn não desempata pela distância: devolve a classe que vem primeiro em
classes_. - Assinantes com \(k = 2\): Ana (sim, \(d = 1\)) × Bruno (não, \(d = 2{,}24\)) → prevê "não gostou", embora a mais próxima tenha gostado.
- Com 3 ou mais classes, \(k\) ímpar não garante nada: 5 votos podem dar 2–2–1.
Votos ponderados: peso \(1/d\)
\(k = 3\) para o assinante novo:
- Ana: \(1/1 = 1{,}000\) → gostou
- Bruno: \(1/2{,}236 = 0{,}447\) → não
- Carla: \(1/2{,}828 = 0{,}354\) → não
| \(k\) | weights | prevê | P(gostou) |
|---|---|---|---|
| 2 | uniform | 0 | 0,500 |
| 2 | distance | 1 | 0,691 |
| 3 | uniform | 0 | 0,333 |
| 3 | distance | 1 | 0,555 |
A ponderação inverte as duas respostas e desfaz o empate. weights é um segundo hiperparâmetro: escolha na validação.
O predict_proba é grosseiro
Com pesos uniformes, é uma fração de \(k\) vizinhos: só \(k + 1\) valores possíveis, \(0, 1/k, \ldots, 1\).
| \(k\) | probabilidades distintas nos 200 pontos de validação |
|---|---|
| 5 | 6 |
| 15 | 16 |
| 73 | 62 |
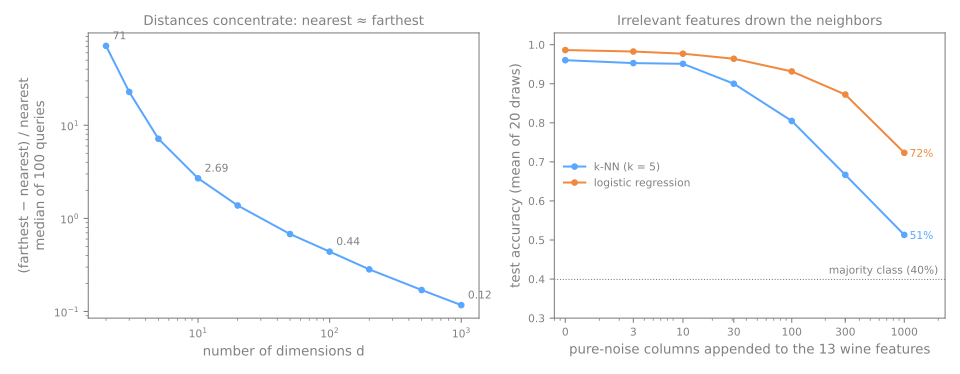
Maldição 1: as distâncias se concentram
1.000 pontos aleatórios no cubo unitário, 100 consultas; mediana por consulta:
| dimensões | mais próximo | mais distante | (longe − perto)/perto |
|---|---|---|---|
| 2 | 0,014 | 1,044 | 71,21 |
| 10 | 0,505 | 1,894 | 2,69 |
| 100 | 3,311 | 4,755 | 0,44 |
| 1.000 | 12,188 | 13,611 | 0,12 |
Maldição 2: colunas irrelevantes afogam as úteis
Vinhos (13 atributos) + colunas de ruído puro:
| ruído | k-NN | logística |
|---|---|---|
| 0 | 0,963 | 1,000 |
| 10 | 0,963 | 0,944 |
| 100 | 0,796 | 0,907 |
| 1.000 | 0,556 | 0,685 |
Custo: o aprendiz preguiçoso, medido
fit em 2.000 linhas
predict de 20 consultas
custo por consulta
Árvores de busca (ball_tree) descartam regiões longe demais:
| dimensões | força bruta | ball tree |
|---|---|---|
| 2 | 2.000 | 118 |
| 10 | 2.000 | 2.124 |
| 50 | 2.000 | 2.127 |
Em escala: vizinhos aproximados
- Milhões de linhas em centenas de dimensões (embeddings de imagem, de texto): a busca exata é lenta demais.
- Vizinhos mais próximos aproximados (índices em grafo como o HNSW, bibliotecas como a FAISS) devolvem quase os \(k\) mais próximos, ordens de grandeza mais rápido.
- É o coração dos bancos de dados vetoriais por trás dos sistemas de LLM com recuperação aumentada (RAG).
k-NN vs regressão logística
| dados | logística | k-NN (\(k = 15\)) |
|---|---|---|
| luas | 0,833 | 0,897 |
| círculos | 0,493 | 0,993 |
Nenhuma reta separa um disco do anel em volta dele.
| situação | favorece |
|---|---|
| fronteira curva, poucos atributos, muitas linhas | k-NN |
| muitos atributos, alguns irrelevantes | logística |
| previsão rápida, treino enorme | logística |
| explicar o efeito de cada atributo | logística |
| explicar uma decisão específica | k-NN |
k-NN para regressão e uma garantia teórica
KNeighborsRegressor
- prevê a média dos alvos dos \(k\) vizinhos (ponderada por \(1/d\) com
weights='distance'); - mesmos cuidados: escalonar, escolher \(k\) na validação, evitar dimensão alta;
- uma média nunca sai da faixa dos alvos de treino: não extrapola tendências.
Cover & Hart (1967)
Com dados ilimitados, o erro do 1-NN é no máximo o dobro do menor erro possível no problema.
A parte dos "dados ilimitados" é justamente o que a maldição da dimensionalidade tira.
Perfil prático
Pontos fortes
- nada a ajustar; fronteira de qualquer forma
- multiclasse natural
- baseline forte e fácil de explicar
- usos: recomendação, busca semântica, anomalias,
KNNImputer
Fraquezas
- prever custa \(O(n \cdot d)\); memória = treino inteiro
- exige escalonamento
- sofre com atributos irrelevantes e dimensão alta
- probabilidades grosseiras (\(k + 1\) valores)
Hiperparâmetros: n_neighbors, weights, metric/p; algorithm só muda a velocidade.
Dígitos manuscritos: passos 6 a 8
- Mesmo notebook do Colab, a partir do passo 6. Sessão nova? Ambiente de execução → Executar anteriores.
- Imagens 8×8: 64 pixels são os atributos, todos na mesma unidade.
- Passo 7: olhar os vizinhos de um 9 lido como 3; simulação: deslocar um dígito um pixel.
- Passo 8: colunas de ruído; simulação: o tamanho do ruído.
Ritmo: passos 6 e 7 em 12 min; passo 8 em 8 min; discussão em 5 min.