Duas maneiras de usar os dados de treino
Regressão logística
- lê o treino inteiro
- resume tudo em \(d + 1\) números
- traça uma reta
- descarta as linhas
k-NN
- guarda todas as linhas
- para um ponto novo, acha as \(k\) mais parecidas
- elas votam
- a fronteira tem a forma que os dados sugerirem
O caminho desta parte
- Os vizinhos votamdistância a cada linha; os k mais próximos votam; o
fitsó guarda - Escalonar antesas unidades decidem a distância; o escalonador entra num pipeline
- Escolher k, testar uma vezviés e variância; a validação escolhe, o teste confirma
Um problema: ele vai gostar da série?
- Um streaming vai recomendar uma série que mistura ação e documentário.
- Para 10 assinantes que já a viram, sabemos as horas por semana de filmes de ação e de documentários e se gostaram.
- Um assinante novo assiste 4 h de ação e 4 h de documentários.
"Parecido" vira um número: a distância euclidiana até o assinante novo.
\[ d = \sqrt{(\text{ação} - 4)^2 + (\text{doc} - 4)^2} \]Primeiro: medir a distância até cada um
| posição | nome | ação | doc | gostou? | \(d\) |
|---|---|---|---|---|---|
| 1 | Ana | 5 | 4 | sim | 1,000 |
| 2 | Bruno | 2 | 5 | não | 2,236 |
| 3 | Carla | 6 | 6 | não | 2,828 |
| 4 | Davi | 4 | 7 | sim | 3,000 |
| 5 | Elisa | 7 | 3 | sim | 3,162 |
| 6–10 | Felipe, Gabi, Hugo, Iara, João: de 3,606 a 5,831 | ||||
Ana: \(\sqrt{(5-4)^2 + (4-4)^2} = 1\). Ordene do mais perto ao mais longe.
Depois: os \(k\) mais próximos votam
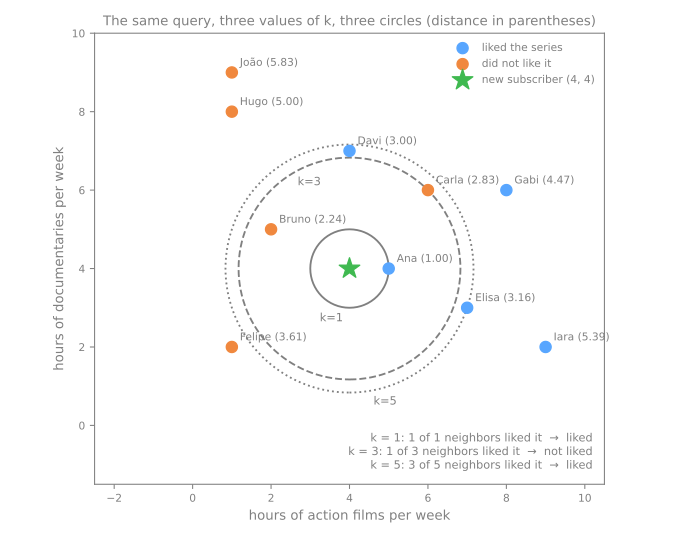
- \(k = 1\): Ana → gostou (1/1)
- \(k = 3\): 1 sim × 2 não → não gostou (1/3)
- \(k = 5\): 3 sim × 2 não → gostou (3/5)
O algoritmo em três passos
- calcule a distância da consulta \(x\) a todo ponto de treino;
- fique com os \(k\) mais próximos, a vizinhança \(N_k(x)\);
- preveja a classe mais frequente entre eles.
A "probabilidade" da classe \(c\) é só a fração de vizinhos nela:
\[ \hat{p}_c(x) = \frac{1}{k} \sum_{i \in N_k(x)} \mathbb{1}[y_i = c] \]No exemplo: predict_proba dá 1,000, 0,333 e 0,600 para \(k\) = 1, 3 e 5.
O que o fit guarda
| regressão logística | k-NN | |
|---|---|---|
o fit produz | \(d + 1\) números | uma cópia da tabela de treino |
| fronteira | uma reta (hiperplano) | qualquer forma |
custo do fit | otimização iterativa | quase nenhum: guardar |
| custo de prever | \(d\) multiplicações | \(n\) distâncias |
| explica com | um coeficiente por atributo | "estes são os casos mais parecidos" |
As unidades decidem a distância
Cliente novo de uma agência: R$ 5.000 por mês, 25 anos. Ele compra o pacote de mochilão?
| cliente | renda | idade | comprou? | \(d\) bruta | \(d\) padronizada |
|---|---|---|---|---|---|
| Rita | 5.200 | 61 | não | 203,2 | 2,57 |
| Otávio | 5.700 | 26 | sim | 700,0 | 0,32 |
- Bruta: \(\sqrt{200^2 + 36^2} = 203{,}2\). Os 36 anos somam só 3,2, porque um ano pesa o mesmo que um real. 1-NN: Rita → não.
- Padronizada (cada atributo ÷ seu desvio padrão): o mais próximo é Otávio → sim.
O mesmo caso, em figura
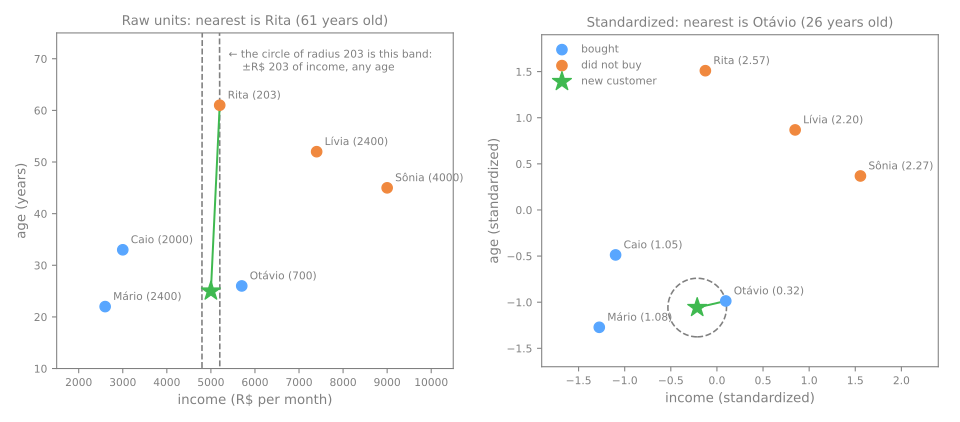
Em unidades brutas, um "círculo" de raio 203 é uma faixa de R$ 203 para cada lado que contém todas as idades.
Num conjunto real: os vinhos
Desvio padrão dos atributos do wine:
| proline | 314,91 |
| magnesium | 14,28 |
| alcalinity_of_ash | 3,34 |
| color_intensity | 2,32 |
Acurácia de teste do 5-NN (54 vinhos):
| sem escalonar | 0,722 |
StandardScaler | 0,963 |
MinMaxScaler | 0,963 |
Regra: escalone, sempre dentro de um pipeline
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

knn = make_pipeline(StandardScaler(),
                    KNeighborsClassifier(n_neighbors=5))
knn.fit(X_train, y_train)
- o escalonador aprende médias e desvios só nas linhas de treino;
- validação e teste recebem a mesma transformação, sem reajuste;
- exceção: atributos que já compartilham uma unidade (os pixels do lab avançado).
O \(k\) controla a complexidade
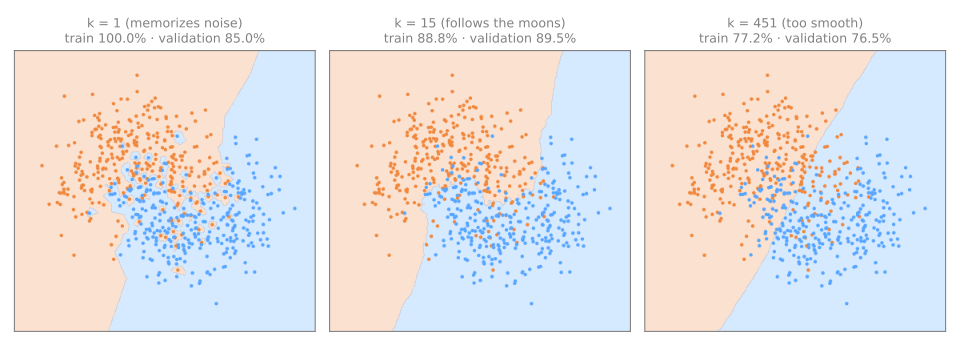
\(k = 1\): ilhas em volta de cada ponto (treino 100%, validação 85,0%) · \(k = 15\): segue as luas (89,5%) · \(k = 451\): quase uma reta (76,5%)
Escolher \(k\) na validação
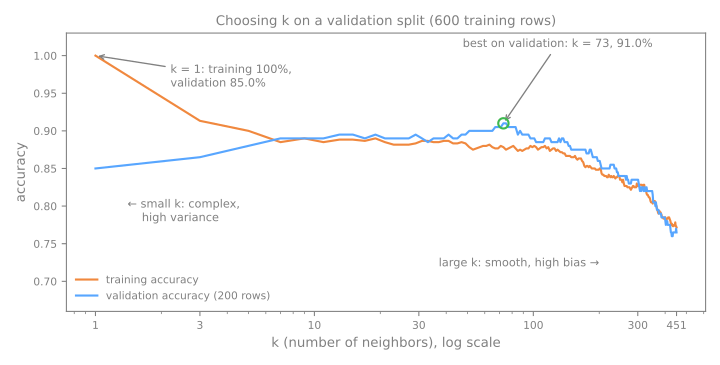
- Treino 100% em \(k = 1\) é por construção: cada ponto é o seu próprio vizinho.
- Platô: de \(k = 7\) a ~140, a validação fica entre 88,5% e 91,0%.
- \(k\) grande: treino e validação caem juntos → simples demais.
O protocolo: cada parte tem um papel
treino · 600
são as linhas que o k-NN guarda e que votam
validação · 200
escolhe o \(k\)
teste · 200
medido uma vez, no fim, após reajustar em treino + validação
Simulador: o voto dos vizinhos
Preveja. O ★ está na fronteira. Percorra o \(k\) de 1 a 25 sem movê-lo: a classe dele fica a mesma? Depois arraste-o pela sobreposição: qual \(k\) oscila mais?
Resumo: a receita do k-NN
- Pipeline com escalonador + k-NN.
- Divida antes de olhar: treino, validação, teste.
- Varra \(k\) ímpar na validação (com duas classes, \(k\) ímpar não empata).
- Reajuste em treino + validação e meça o teste uma única vez.
Vinhos: passos 1 a 5
- Abra o notebook no Colab: nada para baixar. Salve uma cópia no seu Drive para guardar as respostas.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: a unidade da prolina (passo 3) e o voto muda com \(k\) (passo 4).
- Compare com a saída e a leitura na página da aula.
Ritmo: passos 1 a 3 em 15 min; passos 4 e 5 em 20 min.