Regressão Linear
A regressão linear é o algoritmo mais antigo deste curso. Legendre publicou os mínimos quadrados em 1805 para ajustar órbitas de cometas, num apêndice intitulado Sur la Méthode des moindres quarrés e Gauss alegou usá-los desde 1795 — mas nenhum dos dois chamava aquilo de regressão. Essa palavra chegou oitenta anos depois, vinda de um estudo sobre altura humana e descrevia um fenômeno, não um método. Dois séculos adiante, o modelo continua sendo a primeira coisa a tentar em qualquer alvo contínuo: rápido, interpretável e uma baseline surpreendentemente difícil de superar.
Esta aula toma uma ideia e a segue até o fim: ajuste uma reta, olhe o que ela errou e use esses erros para melhorar. Os erros são os resíduos; usá-los de forma sistemática é o gradiente.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula no Colab; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Como escolher a reta que melhor se ajusta aos dados e como saber quão boa ela é? | Quando dá para confiar nos coeficientes, o que quebra a fórmula exata e o que a substitui? |
| conteúdo | regressão à média, o modelo e seus coeficientes, por que \(X\) não se inverte, mínimos quadrados e suas fórmulas à mão, resíduos e gráfico de resíduos, outliers e alavancagem, MAE, MSE, RMSE e R² | as suposições por trás da inferência, multicolinearidade, o custo da forma fechada em tempo e memória, o gradiente como soma ponderada pelos resíduos, a paisagem da perda e a centralização |
| lab em aula | cinco pontos, do zero: passos 1 a 4 | onde a forma fechada quebra e um ano de Ibovespa: passos 5 a 10 |
| ao final, você sabe | explicar por que a regressão à média não é uma força; ajustar uma reta à mão e conferi-la em Python; ler um coeficiente com os outros atributos fixos; diagnosticar um gráfico de resíduos; escolher entre MAE e RMSE; ler o R² contra a média | dizer de quais suposições depende uma conclusão; reconhecer multicolinearidade; saber quando \(X^\top X\) já não cabe na memória; derivar o gradiente e lê-lo; explicar por que centrar acelera o gradiente descendente; desconfiar de uma reta extrapolada |
Os dois labs usam o mesmo notebook no Colab, Regressão linear do zero: a parte fundamental vai do passo 1 ao 4 (as seções 1 a 4 do notebook); a avançada, do 5 ao 10 (as seções 5 e 6). Tudo roda no navegador; não é preciso baixar nada.
Abordagem fundamental
Uma pergunta guia esta parte: entre todas as retas que se podem traçar por uma nuvem de pontos, qual é a melhor e quão boa ela é? A resposta é uma regra (deixar os erros verticais ao quadrado tão pequenos quanto possível), duas fórmulas que saem dela e um hábito: olhar o que a reta errou. Tudo é feito primeiro à mão, em cinco pontos, e depois conferido em Python.
Esta parte segue um caminho em cinco etapas, desenhado abaixo: 1. o enigma de Galton, de onde vem a palavra regressão; 2. o modelo, a previsão como soma ponderada dos atributos; 3. mínimos quadrados, a regra que escolhe a reta; 4. resíduos, o que a reta errou; 5. medir a qualidade, como resumir esses erros num número. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- O enigma de Galtonregressão à média; a inclinação é a correlação
- O modeloŷ = Xw; lendo os coeficientes; por que não inverter X
- Mínimos quadradosminimizar os resíduos ao quadrado; as fórmulas à mão
- Resíduosgráfico de resíduos; outliers e alavancagem
- Medir a qualidadeMAE, MSE, RMSE e R²
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. De onde vem o nome
Etapa 1. Em 1886 Francis Galton publicou Regression towards Mediocrity in Hereditary Stature. Ele havia coletado as alturas de 928 filhos adultos e de seus pais; procurava medir a força da hereditariedade. O que encontrou o intrigou.
Pais muito altos de fato tinham filhos altos — mas, em média, os filhos ficavam mais perto da média populacional do que seus pais. Pais muito baixos tinham filhos baixos que, de novo, ficavam mais perto do meio. Galton chamou isso primeiro de "reversão", depois de "regressão à mediocridade". O nome grudou na técnica que ele usou para medir o efeito — e é por isso que um algoritmo sobre ajustar retas carrega uma palavra que significa "andar para trás".
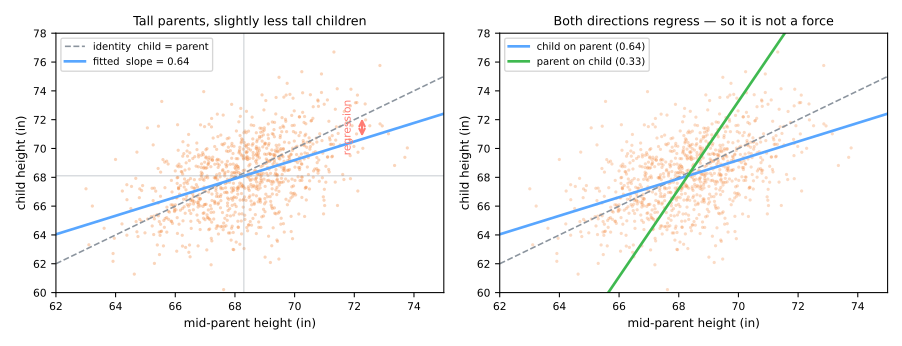
O painel da esquerda é o efeito em si. A linha tracejada é a identidade — como os dados seriam se os filhos simplesmente repetissem os pais. A reta ajustada é mais achatada. Um valor médio dos pais 3 polegadas acima da média produz um filho previsto apenas cerca de 2 polegadas acima. A seta vermelha é a diferença e essa diferença é a "regressão".
A inclinação que Galton relatou era de cerca de \(2/3\) e vale ver de onde ela sai:
Correlação e inclinação não são o mesmo número. A inclinação carrega as unidades; a correlação é o que sobra depois de removê-las. As duas coincidem apenas quando ambas as variáveis têm a mesma dispersão — que é exatamente a situação em que o simulador abaixo coloca você, para observar a geometria sem a contabilidade das unidades.
Um número dessa conta merece um segundo olhar: por que os filhos (2,52) variam mais que a média dos pais (1,80)? Não porque os pais sejam um grupo mais uniforme. A média dos pais é a média de duas pessoas e tirar média encolhe a dispersão: dois indivíduos com \(s \approx 2{,}5\) resultam em \(2{,}5/\sqrt{2} \approx 1{,}77\), que é essencialmente o 1,80 que Galton relatou. A assimetria é um artefato de como a variável \(x\) foi construída, não um fato sobre hereditariedade — e perceber isso é o mesmo hábito mental de que trata o resto desta seção.
Regressão à média não é uma força
O painel da direita da figura é a parte que quase ninguém vê. Se você regredir pais sobre filhos, essa reta também é mais achatada — um filho alto prevê pais mais próximos da média. As duas direções "regridem", o que é impossível para uma atração causal: filhos não podem estar puxando os pais em direção à média.
O que acontece de fato é aritmética. Toda medida é sinal mais ruído. Uma observação extrema é extrema em parte porque o sinal era alto e em parte porque o ruído ajudou. O sinal persiste na segunda medida; a sorte não. Então a segunda medida cai mais perto do meio — qualquer que seja a variável que você chame de "primeira".
Essa é uma das formas mais confiáveis de se enganar com dados:
- os alunos com as piores notas recebem reforço e melhoram — então o reforço funciona? Eles teriam melhorado de qualquer jeito;
- o atleta que aparece na capa da revista tem uma temporada seguinte pior — o Sports Illustrated jinx, que é apenas uma temporada excepcional seguida de uma temporada normal;
- uma clínica trata os pacientes com pressão mais alta e vê a pressão cair. Parte da queda é o tratamento. Parte é regressão à média e só um grupo de controle separa as duas.
2. O modelo
Etapa 2. Prever um alvo contínuo como uma soma ponderada de atributos:
- \(w_j\) é a variação em \(\hat{y}\) por unidade de variação em \(x_j\), mantendo os outros atributos fixos;
- \(w_0\) (intercepto ou viés) é a previsão quando todos os atributos são zero.
Em forma matricial, com uma coluna inicial de 1s absorvida em \(X\): \(\hat{y} = Xw\).
Lendo os coeficientes
De volta ao primeiro item: as palavras mantendo os outros atributos fixos pesam mais do que parecem. Leia este modelo ajustado para preços de apartamentos:
3200 não significa "apartamentos maiores custam R$ 3200 a mais por m² nesta cidade". Significa: entre apartamentos de mesma idade, um m² a mais está associado a R$ 3200 a mais. Se área e idade forem correlacionadas nos seus dados — digamos, prédios mais novos são maiores — então a relação bruta entre área e preço mistura os dois efeitos — e o coeficiente os separa deliberadamente.
Os coeficientes não são importâncias
Um reflexo comum é ordenar atributos por \(|w_j|\). Isso não significa nada, a menos que os atributos compartilhem uma escala: meça a área em km² em vez de m² e o coeficiente cresce um milhão de vezes sem que nada no modelo mude. Para comparar magnitudes, padronize os atributos antes — e mesmo assim "coeficiente grande" quer dizer "resposta íngreme", não "importante".
3. Por que não inverter \(X\)?
Escrito como \(\hat{y} = Xw\), o reflexo natural é \(w = X^{-1}y\). Não funciona — e ver exatamente por que é o caminho mais rápido para entender o que os mínimos quadrados de fato fazem.
Tome três observações e dois parâmetros:
Primeiro obstáculo: \(X\) não é quadrada. Ela é \(3 \times 2\), enquanto apenas matriz quadrada tem inversa. No caso geral \(X\) é \(n \times d\) com \(n \gg d\) — milhares de linhas, um punhado de colunas.
Segundo obstáculo, o verdadeiro: de todo modo, não existe solução exata. \(y = Xw\) são três equações com duas incógnitas — um sistema sobredeterminado. Um \(w\) exato existe apenas se \(y\) por acaso estiver no espaço-coluna de \(X\), o que aqui não acontece:
Acrescentar \(y\) elevou o posto, então \(y\) aponta para algum lugar que as colunas de \(X\) não alcançam. Nenhum \(w\) satisfaz \(Xw = y\). Isso não é azar — é a situação normal — e é a própria razão de a regressão existir. Se houvesse solução exata, todo resíduo seria zero e a reta passaria por todos os pontos.
O que fazemos no lugar
Como \(y\) está fora de alcance, contentamo-nos com o ponto alcançável mais próximo dele — minimizar \(\lVert y - Xw\rVert^2\). Igualar o gradiente a zero dá as equações normais; o truque está no que acontece com os formatos:
\(X^\top X\) é \(2 \times 2\) — quadrada — e invertível sempre que \(X\) tem posto-coluna cheio. Nunca invertemos \(X\); invertemos \(X^\top X\). São duas equações, pequenas o bastante para resolver no papel:
Os valores ajustados são \(1{,}5,\ 4,\ 6{,}5\) e os resíduos \(0{,}5,\ -1,\ 0{,}5\). Eles não se anulam — não podem — mas \(\lVert e \rVert^2 = 1{,}5\) é o menor alcançável. E repare no que as equações normais dizem nessa notação: \(X^\top e = 0\), que é exatamente o \(\sum e_i = 0\) mais o \(\sum e_i x_i = 0\) que você reencontrará adiante.
O seu instinto é o caso particular
Agora descarte a terceira observação, ficando com duas equações e duas incógnitas:
Aqui \(X^{-1}\) existe e \(w = X^{-1}y\) funciona perfeitamente — o resíduo é exatamente zero, porque uma reta por dois pontos os interpola. E a fórmula de mínimos quadrados devolve exatamente a mesma resposta, como a álgebra exige:
Então \(w = X^{-1}y\) não está errado — é o caso exatamente determinado de uma fórmula mais geral. Essa fórmula geral, \(X^{+} = (X^\top X)^{-1}X^\top\), chama-se pseudo-inversa de Moore–Penrose: o que a "inversa" vira quando a matriz não é quadrada.
4. Mínimos quadrados
Etapa 3. Precisamos de uma regra para escolher \(w\). Os mínimos quadrados ordinários — OLS, de ordinary least squares, como aparecerá daqui em diante — escolhem a reta que minimiza a soma dos quadrados dos resíduos (SSE, de sum of squared errors): as distâncias verticais ao quadrado entre os dados e a reta ajustada.
Por que distâncias verticais e por que ao quadrado? As duas escolhas merecem um instante, porque as duas poderiam ter sido diferentes.
Verticais, porque o trabalho do modelo é prever \(y\) a partir de \(x\). Um erro é "o quanto minha previsão de \(y\) errou", medido ao longo do eixo \(y\). (Minimizar a distância perpendicular é um método diferente e perfeitamente válido — é o que a PCA faz — mas responde a outra pergunta. A direção em que os erros são medidos importa: medi-los ao longo de \(x\) em vez de \(y\) é exatamente o motivo de as duas retas de regressão da figura de Galton serem diferentes.)
Ao quadrado, por três razões que por acaso se alinham:
- é suave e diferenciável em toda parte, então o cálculo funciona e existe resposta em forma fechada;
- pune um erro grande mais do que vários pequenos, que costuma ser o que se quer;
- sob ruído gaussiano, é máxima verossimilhança — a reta de mínimos quadrados é a reta mais provável.
A razão 2 é também a sua fraqueza: elevar ao quadrado deixa o ajuste hipersensível a outliers. Minimizar \(\sum|e_i|\) dá os desvios absolutos mínimos, mais robustos, ao preço de perder a forma fechada.
Arraste os pontos abaixo e veja a reta perseguir o mínimo. Depois arraste um ponto para longe dos demais e veja o quanto uma única observação consegue movê-la:
Resolvendo exatamente
Iguale o gradiente a zero, \(\nabla_w J = -2X^\top(y - Xw) = 0\) e você obtém as equações normais:
Para a regressão simples — um atributo — isso se reduz a duas fórmulas que vale memorizar:
A segunda diz algo útil: a reta ajustada sempre passa por \((\bar{x}, \bar{y})\). Faça o que fizer, ela pivota em torno do centro de massa dos dados.
Feito à mão
Cinco pontos, pequenos o bastante para conferir cada passo:
| \(x_i\) | \(y_i\) | \(x_i - \bar{x}\) | \(y_i - \bar{y}\) | produto | \((x_i-\bar{x})^2\) |
|---|---|---|---|---|---|
| 1 | 2 | −2 | −2,2 | 4,4 | 4 |
| 2 | 4 | −1 | −0,2 | 0,2 | 1 |
| 3 | 5 | 0 | 0,8 | 0,0 | 0 |
| 4 | 4 | 1 | −0,2 | −0,2 | 1 |
| 5 | 6 | 2 | 1,8 | 3,6 | 4 |
| 8,0 | 10 |
Com \(\bar{x}=3\) e \(\bar{y}=4{,}2\):
Agora os resíduos \(e_i = y_i - \hat{y}_i\):
| \(x_i\) | \(y_i\) | \(\hat{y}_i\) | \(e_i\) |
|---|---|---|---|
| 1 | 2 | 2,6 | −0,6 |
| 2 | 4 | 3,4 | 0,6 |
| 3 | 5 | 4,2 | 0,8 |
| 4 | 4 | 5,0 | −1,0 |
| 5 | 6 | 5,8 | 0,2 |
Duas coisas valem para esses números e valem para todo ajuste OLS com intercepto:
Confira: \(-0{,}6+0{,}6+0{,}8-1{,}0+0{,}2 = 0\) e \(-0{,}6+1{,}2+2{,}4-4{,}0+1{,}0 = 0\). ✓
Não são coincidências, elas são as equações normais — uma por parâmetro. Os resíduos são obrigados a ser ortogonais à coluna do intercepto e a cada coluna de atributo. Isso tem uma leitura geométrica: \(\hat{y}\) é a projeção de \(y\) sobre o espaço gerado pelas colunas de \(X\) e o vetor de resíduos é o que sobra, perpendicular a esse espaço. Mínimos quadrados é um problema de ângulo reto disfarçado.
O simulador percorre a mesma conta um passo de cada vez: as médias, cada linha da tabela desenhada como um retângulo cuja área é o produto, a inclinação, o intercepto, os resíduos e, no fim, o R² (seção 6). Antes de apertar próximo, preveja por qual ponto a reta tem de passar.
No scikit-learn a conta inteira é uma chamada; o lab a refaz com NumPy, linha a linha:
from sklearn.linear_model import LinearRegression

model = LinearRegression().fit(X_train, y_train)
model.coef_, model.intercept_
y_pred = model.predict(X_test)
5. Resíduos
Etapa 4. Tudo o que o modelo não conseguiu explicar está nos resíduos e lê-los é o hábito de diagnóstico mais útil em regressão.
O gráfico de resíduos põe \(e_i\) no eixo vertical contra o previsto \(\hat{y}_i\) no horizontal. Um gráfico saudável parece não ter nada: uma faixa sem estrutura em torno de zero. Qualquer padrão é o modelo avisando qual suposição acabou de ser quebrada.
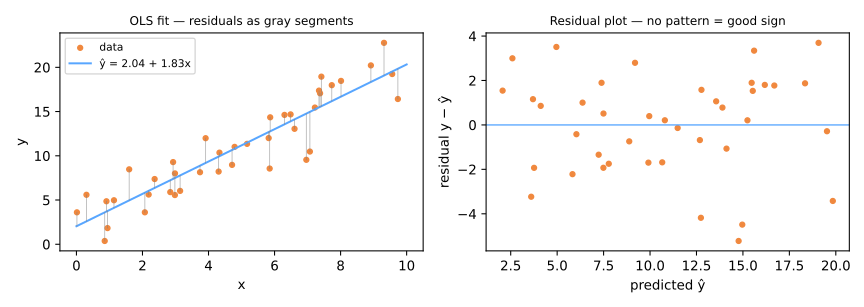
Tente diagnosticar os quatro casos abaixo antes de ler o veredicto — o painel de cima é o que você normalmente olharia e a questão é justamente que ele não basta:
| O que você vê | O que significa | O que fazer |
|---|---|---|
| Faixa sem estrutura | A forma linear serve | Nada |
| Curva em U ou ∩ | Relação não linear que a reta não acompanha | Adicionar termos polinomiais ou transformar \(x\) |
| Funil (dispersão cresce) | Heteroscedasticidade — o ruído depende de \(\hat{y}\) | Transformar \(y\) (muitas vezes \(\log\)) ou mínimos quadrados ponderados |
| Ponto extremo isolado | Outlier ou observação de alta alavancagem | Investigar; nunca apagar em silêncio |
| Ondas / deriva ao longo do índice | Erros correlacionados, tipicamente tempo | Modelo de série temporal; as barras de erro do OLS são inválidas |
O R² não enxerga nada disso
No simulador os quatro conjuntos são ajustados pelo mesmo procedimento e vários têm R² respeitável. O quarteto de Anscombe leva o argumento ao extremo: quatro conjuntos com médias, variâncias, correlação, reta de regressão e R² idênticos, que não se parecem em nada. Estatísticas-resumo comprimem; gráficos de resíduos não. Plote-os.
Outlier e alavancagem são coisas diferentes. Um outlier tem resíduo grande — o modelo errou nele. Um ponto de alta alavancagem fica longe de \(\bar{x}\) ao longo do eixo \(x\) e consegue arrastar a reta inteira para si. O caso perigoso é um ponto com alta alavancagem e puxão: ele move a reta com tanta eficácia que o próprio resíduo acaba pequeno, escondendo o estrago. É o quarto caso do simulador. Por isso "basta descartar os resíduos grandes" é um mau conselho — os piores infratores não têm resíduo grande.
6. Medindo a qualidade
Etapa 5. Toda métrica abaixo é um jeito diferente de resumir o mesmo vetor de resíduos \(e_i = y_i - \hat{y}_i\) num único número. Elas discordam porque comprimem de formas diferentes, então vale ler os nomes por extenso antes das fórmulas.
| Métrica | Significa | Fórmula | Unidade |
|---|---|---|---|
| MAE | Mean Absolute Error — erro absoluto médio | \(\frac{1}{n}\sum \lvert e_i \rvert\) | a mesma de \(y\) |
| MSE | Mean Squared Error — erro quadrático médio | \(\frac{1}{n}\sum e_i^2\) | \(y\) ao quadrado |
| RMSE | Root Mean Squared Error — raiz do erro quadrático médio | \(\sqrt{\text{MSE}}\) | a mesma de \(y\) |
| R² | coeficiente de determinação | \(1 - \frac{\sum e_i^2}{\sum (y_i - \bar{y})^2}\) | nenhuma (é razão) |
As siglas não são arbitrárias: cada uma soletra a própria receita, lida da direita para a esquerda. RMSE é Error → Squared → Mean → Root: tome cada erro, eleve ao quadrado, tire a média e então extraia a raiz. Ler o nome de trás para frente é escrever o código.
Calculando as quatro nos cinco pontos
Os resíduos do exemplo feito à mão eram \(-0{,}6,\ 0{,}6,\ 0{,}8,\ -1{,}0,\ 0{,}2\).
Leia esses números no contexto: os valores do alvo iam de 2 a 6, então errar cerca de 0,7 em média é um erro relevante, não um detalhe de arredondamento. MAE e RMSE são citáveis para quem não é técnico — "o modelo erra uns 0,7" — enquanto o MSE é 0,48 unidades ao quadrado, que não é uma frase que alguém consiga dizer em voz alta. É exatamente para isso que o RMSE existe: desfaz o quadrado e devolve o número à escala daquilo que você está prevendo.
MAE ou RMSE?
Não são intercambiáveis e a diferença está justamente em como tratam um erro grande. Dois modelos, cinco previsões cada:
| erros | MAE | RMSE | |
|---|---|---|---|
| Modelo A | 2, 2, 2, 2, 2 | 2,0 | 2,0 |
| Modelo B | 0, 0, 0, 0, 10 | 2,0 | 4,47 |
MAE idêntico e RMSE mais que o dobro no B. O MAE diz que os dois modelos são igualmente bons; o RMSE diz que o B é bem pior, porque eleva ao quadrado antes de tirar a média e o único erro de 10 contribui com 100 à soma. Nenhum dos dois está certo no abstrato — a pergunta é o que o seu problema custa. Errar o horário de uma entrega em 10 minutos uma vez costuma ser pior que errar 2 minutos cinco vezes (use RMSE); numa previsão de demanda o erro total pode ser o que importa (use MAE). Escolha antes de olhar os resultados, não depois.
O R² e por que esse nome
O R² compara o seu modelo com o mais preguiçoso possível. Ele é feito de duas somas. A primeira é a SSE (sum of squared errors, a soma dos quadrados dos erros) que a sua reta ainda comete. A segunda é a SST (total sum of squares, a soma total de quadrados), que é o erro de ignorar \(x\) por completo.
A SST, a soma total de quadrados, é o erro que você cometeria ignorando \(x\) por completo e prevendo sempre a média \(\bar{y}\). A SSE, a soma de quadrados dos erros, é o que a sua reta ainda erra. Então o R² responde: da variação que havia para explicar, que fração o modelo removeu? Daí "coeficiente de determinação" — o quanto de \(y\) fica determinado pelos atributos.
Nos cinco pontos: \(R^2 = 1 - 2{,}40/8{,}80 = 0{,}727\), ou seja, a reta removeu cerca de 73% da dispersão original. E como \(r_{xy} = 0{,}853\) e \(0{,}853^2 = 0{,}727\), note que na regressão simples o R² é mesmo a correlação ao quadrado — é de onde vem o símbolo. Deixa de valer no instante em que você acrescenta um segundo atributo.
O R² pode ser negativo em dados de teste, o que surpreende quem o aprendeu como "uma porcentagem". Significa que o modelo foi pior que a reta horizontal \(\hat{y}=\bar{y}\). Sempre ajuste essa baseline constante (DummyRegressor) e reporte-a: é incômodo ver com que frequência um modelo elaborado mal a supera.
Avalie em dados separados
Toda métrica acima só tem sentido em dados que o modelo não viu. O R² no conjunto de treino nunca diminui quando você adiciona um atributo, mesmo uma coluna de puro ruído — o que o torna inútil para escolher entre modelos. Esse é o tema de Validação Cruzada e Vazamento de Dados.
7. Resumo: a reta em cinco linhas
- Regressão à média é aritmética, não uma força: a inclinação é \(r_{xy}\,s_y/s_x\) e, sempre que a correlação fica abaixo de 1, as previsões ficam mais perto da média que as entradas.
- Um modelo linear é uma soma ponderada: cada coeficiente é o efeito do seu atributo com os outros fixos e o tamanho dele depende das unidades; não é uma importância.
- \(X\) não se inverte; os mínimos quadrados ficam com o ponto alcançável mais próximo de \(y\): \(X^\top X w = X^\top y\). Com um atributo, \(\hat w_1 = \sum(x_i-\bar x)(y_i-\bar y)/\sum(x_i-\bar x)^2\) e \(\hat w_0 = \bar y - \hat w_1 \bar x\), então a reta passa por \((\bar x, \bar y)\).
- Os resíduos somam zero e são ortogonais a cada atributo; o gráfico deles, não o R², mostra curvas, funis e pontos perigosos.
- MAE, RMSE e R² resumem os mesmos resíduos: o RMSE pune erros grandes, o R² compara com prever sempre \(\bar y\) e todos só dizem algo em dados que o modelo não viu.
| sintoma | o que está acontecendo | o que fazer |
|---|---|---|
| um padrão no gráfico de resíduos | a reta não acompanha uma curva, um funil ou uma dependência no tempo | transformar \(x\) ou \(y\), acrescentar termos ou trocar de modelo |
| um ponto longe em \(x\) com resíduo pequeno | alta alavancagem: ele puxou a reta para si | reajustar sem ele e comparar; nunca apagar em silêncio |
| MAE razoável, RMSE bem maior | poucos erros grandes dominam | olhar esses pontos; escolher a métrica pelo custo dos erros |
| R² alto no treino, negativo no teste | o modelo é pior que a média em dados novos | avaliar em dados separados, ao lado de um DummyRegressor |
Lab fundamental — cinco pontos, do zero
O problema. O LinearRegression().fit esconde a aula inteira numa chamada. Este lab a abre: só com NumPy, escreve o modelo como produto de matrizes, tenta a inversa óbvia e a vê falhar, resolve as equações normais e confere, número a número, a conta à mão da seção 4. Os cinco pontos são os do exemplo feito à mão, então toda saída pode ser conferida no papel.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Abra o notebook do lab no Colab. Não é preciso baixar nem instalar nada: o Colab roda no navegador. Para guardar as suas respostas, salve uma cópia no seu Drive (Arquivo → Salvar uma cópia no Drive) antes de editar. Rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 4, as seções 1 a 4 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 5 (a seção 5).
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 e 2 em 5 min; passo 3 e a primeira simulação em 10 min; passo 4 e a segunda simulação em 15 min.
Passo 1 — cinco pontos
Preveja. Olhe os cinco pontos antes de desenhá-los: \(x = 1, \dots, 5\) e \(y = 2, 4, 5, 4, 6\). A melhor reta vai subir ou descer? Mais ou menos quão íngreme: perto de 0,5 ou de 2 unidades de \(y\) por unidade de \(x\)?
import numpy as np
import matplotlib.pyplot as plt
import time

np.set_printoptions(precision=4, suppress=True)
print("pronto")
x = np.array([1., 2., 3., 4., 5.])
y = np.array([2., 4., 5., 4., 6.])

plt.figure(figsize=(5,3.2))
plt.scatter(x, y, s=45, color='#f0883e', zorder=3)
plt.xlabel('x'); plt.ylabel('y'); plt.grid(alpha=.3)
plt.title('cinco observações'); plt.show()

print("x =", x)
print("y =", y)
Números pequenos de propósito: tudo o que vem a seguir pode ser conferido à mão. A nuvem sobe, mas não de forma regular: o quarto ponto (4, 4) fica abaixo do terceiro (3, 5). Nenhuma reta passa pelos cinco.
Passo 2 — a forma matricial
Preveja. O modelo é \(\hat y_i = w_0 + w_1 x_i\). Se cada previsão tem de ser uma linha de um único produto de matrizes \(\hat y = Xw\), o que a primeira coluna de \(X\) precisa guardar e que formato \(X\) terá?
X = np.column_stack([np.ones_like(x), x])
print("X =")
print(X)
print("\nforma de X:", X.shape, " ->", X.shape[0], "observações,", X.shape[1], "parâmetros")
A coluna de 1s não é truque de notação: multiplicada por \(w_0\), soma o intercepto a cada linha, então o intercepto é tratado como qualquer outro peso. \(X\) é \(5 \times 2\): uma linha por observação, uma coluna por parâmetro.
Passo 3 — a tentativa óbvia: \(w = X^{-1}y\)
Preveja. Se \(\hat y = Xw\), o reflexo é \(w = X^{-1}y\). O NumPy vai calcular? Se recusar, o problema é só o formato de \(X\) ou há um mais profundo?
try:
    w = np.linalg.inv(X) @ y
    print("w =", w)
except np.linalg.LinAlgError as erro:
    print("LinAlgError:", erro)
posto_X   = np.linalg.matrix_rank(X)
posto_aug = np.linalg.matrix_rank(np.column_stack([X, y]))

print("posto(X)      =", posto_X)
print("posto([X | y]) =", posto_aug)
print()
if posto_aug > posto_X:
    print("y NÃO está no espaço-coluna de X.")
    print("=> nenhum w satisfaz Xw = y exatamente.")
else:
    print("y está no espaço-coluna: existe solução exata.")
posto(X)      = 2
posto([X | y]) = 3

y NÃO está no espaço-coluna de X.
=> nenhum w satisfaz Xw = y exatamente.
Dois obstáculos, como na seção 3. O primeiro é o formato: inv só aceita matriz quadrada e \(X\) é \(5 \times 2\). O segundo é o que importa: acrescentar \(y\) eleva o posto de 2 para 3, então \(y\) aponta numa direção que as colunas de \(X\) não alcançam. Cinco equações, duas incógnitas, nenhuma solução exata. Com dados ruidosos essa é a situação normal e é por isso que a regressão existe.
Simulação: o seu instinto, o caso particular. A seção 3 afirmou que \(w = X^{-1}y\) não está errado, é só um caso particular. Fique só com os dois primeiros pontos, para que \(X\) vire quadrada, e calcule \(w\) dos dois jeitos: com np.linalg.inv e com as equações normais. Eles concordam? Quanto valem os resíduos e por quê?
Solução
X2, y2 = X[:2], y[:2]                          # só os dois primeiros pontos: X2 é 2 × 2
w_inv = np.linalg.inv(X2) @ y2                 # o reflexo, agora permitido
w_ne  = np.linalg.solve(X2.T @ X2, X2.T @ y2)  # as equações normais
print("inv(X2) @ y2     =", w_inv)
print("equações normais =", w_ne)
print("resíduos         =", y2 - X2 @ w_inv)
Os dois caminhos dão a mesma reta, \(\hat y = 0 + 2x\), por (1, 2) e (2, 4); os dois resíduos são exatamente zero: por dois pontos sempre passa uma reta. Com \(X\) quadrada e invertível, \((X^\top X)^{-1}X^\top = X^{-1}\), então as equações normais contêm a inversa como caso particular. O instinto só falha porque dados reais têm muito mais linhas que colunas.
Passo 4 — as equações normais
Preveja. \(X^\top X\) será \(2 \times 2\). Antes de rodar: quais dois números \(w\) deve conter, se a conta à mão da seção 4 está certa? E quanto valerão \(\sum e_i\) e \(\sum e_i x_i\)?
XtX = X.T @ X
Xty = X.T @ y

print("XᵀX =");  print(XtX);  print("forma:", XtX.shape, "-> quadrada")
print("\nXᵀy =", Xty)

w = np.linalg.solve(XtX, Xty)     # resolve o sistema; NÃO usa inv()
print("\nw =", w)
print(f"reta ajustada:  ŷ = {w[0]:.1f} + {w[1]:.1f}·x")
XᵀX =
[[ 5. 15.]
 [15. 55.]]
forma: (2, 2) -> quadrada

Xᵀy = [21. 71.]

w = [1.8 0.8]
reta ajustada:  ŷ = 1.8 + 0.8·x
yhat = X @ w
resid = y - yhat

print("ŷ =", yhat)
print("e =", resid)
print()
print("Σe      =", round(resid.sum(), 12) + 0.0)
print("Σe·x    =", round((resid * x).sum(), 12) + 0.0)
print("Xᵀe     =", (X.T @ resid).round(12) + 0.0)
print()
print("Os dois zeros acima SÃO as equações normais, escritas por extenso:")
print("uma por parâmetro. O resíduo é ortogonal a cada coluna de X.")
ŷ = [2.6 3.4 4.2 5.  5.8]
e = [-0.6  0.6  0.8 -1.   0.2]

Σe      = 0.0
Σe·x    = 0.0
Xᵀe     = [0. 0.]

Os dois zeros acima SÃO as equações normais, escritas por extenso:
uma por parâmetro. O resíduo é ortogonal a cada coluna de X.
plt.figure(figsize=(5,3.2))
plt.scatter(x, y, s=45, color='#f0883e', zorder=3, label='dados')
xs = np.linspace(0.5, 5.5, 50)
plt.plot(xs, w[0] + w[1]*xs, color='#1F6B8E', lw=2, label=f'ŷ = {w[0]:.1f} + {w[1]:.1f}x')
for xi, yi, yh in zip(x, y, yhat):
    plt.plot([xi, xi], [yi, yh], color='#9E3B2E', lw=1.2, alpha=.8)
plt.legend(); plt.grid(alpha=.3); plt.xlabel('x'); plt.ylabel('y')
plt.title('os segmentos vermelhos são os resíduos'); plt.show()
O caminho matricial chega ao resultado à mão: \(\hat y = 1{,}8 + 0{,}8x\), as mesmas previsões 2,6; 3,4; 4,2; 5,0 e 5,8 e os mesmos resíduos das tabelas da seção 4. O sistema também é pequeno o bastante para o papel: \(5w_0 + 15w_1 = 21\) e \(15w_0 + 55w_1 = 71\); da primeira, \(w_0 = (21 - 15w_1)/5\) e, substituindo na segunda, \(10w_1 = 8\), logo \(w_1 = 0{,}8\) e \(w_0 = 1{,}8\). O np.linalg.solve resolve o sistema sem nunca formar uma inversa. Os dois zeros são \(X^\top e = 0\): uma equação por coluna de \(X\), a coluna de 1s dando \(\sum e_i = 0\) e a coluna de \(x\) dando \(\sum e_i x_i = 0\).
Simulação: o ponto que gira a reta. Empurre um ponto 3 unidades para baixo e reajuste, duas vezes: primeiro o ponto do meio (\(x = 3\)), depois o último (\(x = 5\)). O empurrão é o mesmo; qual muda mais a inclinação? E qual dos dois pontos movidos fica com o maior resíduo?
Solução
for i in [2, 4]:                               # o ponto do meio (x = 3), depois o último (x = 5)
    y_movido = y.copy()
    y_movido[i] -= 3                           # o mesmo empurrão: 3 unidades para baixo
    w_movido = np.linalg.solve(X.T @ X, X.T @ y_movido)
    e_movido = y_movido - X @ w_movido
    print(f"x = {x[i]:.0f} empurrado: w = {w_movido} · inclinação {w[1]:.1f} -> {w_movido[1]:.1f}"
          f" · resíduo do ponto movido {e_movido[i]:+.1f}")
x = 3 empurrado: w = [1.2 0.8] · inclinação 0.8 -> 0.8 · resíduo do ponto movido -1.6
x = 5 empurrado: w = [3.  0.2] · inclinação 0.8 -> 0.2 · resíduo do ponto movido -1.0
O ponto do meio está em \(x = \bar x\): o \(x - \bar x\) dele é 0, então ele não soma nada a \(\sum(x-\bar x)(y-\bar y)\) e não consegue inclinar a reta. Empurrá-lo para baixo só abaixa a reta inteira em \(3/5 = 0{,}6\) e o resíduo dele vira \(-1{,}6\). O último ponto é o mais distante de \(\bar x\): o mesmo empurrão derruba a inclinação de 0,8 para 0,2, um quarto do que era, e mesmo assim o resíduo dele é só \(-1{,}0\), menor que o do ponto inofensivo. Isso é alavancagem: o ponto arrastou a reta para si, então uma regra como "descartar os maiores resíduos" tiraria o ponto errado.
Para fechar a parte fundamental. Em uma frase cada: (1) por que \(w = X^{-1}y\) não está disponível num conjunto com mais linhas que colunas? (2) O que os dois zeros \(\sum e_i = 0\) e \(\sum e_i x_i = 0\) dizem sobre os resíduos? (3) Por que um ponto de resíduo pequeno pode ser o que mais estragou a reta?
Sua vez (fundamental)
Em casa:
- Sem intercepto. Refaça o passo 4 sem a coluna de 1s (\(X\) só com \(x\)). Confira que \(\sum e_i\) deixa de ser zero enquanto \(\sum e_i x_i\) continua zero e explique com a frase "uma equação normal por parâmetro".
- Os três pontos da seção 3. Rode o passo 4 com \(x = 1, 2, 3\) e \(y = 2, 3, 7\). Você obtém \(w_0 = -1\), \(w_1 = 2{,}5\) e \(\lVert e \rVert^2 = 1{,}5\)?
- As quatro métricas. Com
mean_absolute_error,mean_squared_errorer2_score(desklearn.metrics), calcule MAE, MSE, RMSE e R² deyhate confira os 0,64, 0,48, 0,69 e 0,727 da seção 6.
Abordagem avançada
A parte fundamental ajustou uma reta e a julgou. Esta parte olha por baixo: para que se pode confiar num coeficiente, onde a fórmula exata para de funcionar e o caminho iterativo que a substitui, que a próxima aula desenvolve. Os exemplos continuam os das seções 1 a 7.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. confiar nos coeficientes; 2. os limites da forma fechada; 3. o gradiente; 4. a paisagem. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Confiar nos coeficientesas suposições clássicas; multicolinearidade
- Limites da forma fechadatempo, memória e colunas colineares
- O gradienteuma soma ponderada pelos resíduos
- A paisagemvales, tigelas e por que centrar ajuda
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
8. Suposições por trás das inferências
Etapa 1. As previsões do OLS exigem muito pouco. Interpretar coeficientes, intervalos de confiança e p-valores se apoia nas suposições clássicas:
- Linearidade — a relação verdadeira é aproximadamente linear nos atributos;
- Independência — os resíduos não são correlacionados entre si (cuidado com séries temporais);
- Homoscedasticidade — a variância dos resíduos é constante ao longo da faixa de \(\hat{y}\);
- Normalidade dos resíduos — necessária para intervalos e p-valores exatos, não para o ajuste em si;
- Sem multicolinearidade severa — atributos altamente correlacionados tornam os coeficientes individuais instáveis.
Cada uma tem um desenho no gráfico de resíduos da seção 5: uma curva quebra a linearidade, um funil quebra a homoscedasticidade, ondas ao longo do tempo quebram a independência. O lab avançado encontra a última em dados reais: um ano de fechamentos de um índice de bolsa cujos resíduos passeiam longe do zero por semanas seguidas.
A multicolinearidade merece uma frase própria, porque seu sintoma é contraintuitivo. Com dois atributos correlacionados a \(r = 0{,}99\), os dados mal conseguem distinguir seus coeficientes: \(X^\top X\) fica quase singular, então, se a verdade é \((w_1, w_2) = (1, 1)\), o par \((2, 0)\) ajusta com cerca de 2% de diferença e \((3, -1)\) com cerca de 8%. Reajuste numa amostra nova e as estimativas individuais se deslocam uma unidade inteira ou mais — o bastante para trocar de sinal — enquanto a soma delas fica cravada perto de 2 e as previsões junto. O modelo está bem; a interpretação de qualquer um dos coeficientes isolado não vale nada.
9. Quando a forma fechada tem dificuldade
Etapa 2. A fórmula \(\hat w = (X^\top X)^{-1}X^\top y\) resolve o problema de uma vez, mas só enquanto três coisas valem.
- Tempo. Resolver o sistema \(d \times d\) custa \(O(d^3)\): dobrar o número de atributos multiplica o tempo por cerca de 8. Um milhão de atributos é inviável.
- Memória. \(X^\top X\) tem \(d^2\) números, qualquer que seja o número de linhas: com 100 mil atributos (um texto vetorizado com TF-IDF passa disso fácil) ela ocupa 80 GB antes de qualquer conta. O passo 5 do lab mede as duas coisas.
- Colinearidade. Quando atributos são perfeitamente colineares, \(X^\top X\) é singular e não há resposta única; quando são quase colineares, a resposta existe mas é instável, como na seção 8.
E ela não tem equivalente algum para os modelos da segunda metade do curso — uma rede neural não tem equações normais.
Ninguém calcula essa inversa
A fórmula é como a solução se escreve, não como ela é calculada. Formar \(X^\top X\) eleva o número de condição ao quadrado, então as bibliotecas resolvem o sistema direto por decomposição QR ou SVD — mais rápido e muito mais estável. O LinearRegression do scikit-learn chama scipy.linalg.lstsq, que nunca constrói inversa alguma.
10. Da resposta exata ao gradiente
Etapa 3. Temos uma fórmula que resolve o problema de uma vez, enquanto ela está disponível. Então por que o resto do aprendizado de máquina se dá ao trabalho de iterar? Porque o que generaliza é a ideia por baixo.
Repare em como chegamos à forma fechada: escrevemos \(J(w)\), tomamos o gradiente e perguntamos onde ele se anula. O gradiente descendente mantém os dois primeiros passos e desiste do terceiro. Em vez de resolver \(\nabla J = 0\) algebricamente, ele desce a ladeira até lá.
Para a regressão simples, escreva a perda como média, para que a escala não dependa de \(n\):
Derive em relação a cada parâmetro, pela regra da cadeia, lembrando que \(e_i = y_i - w_0 - w_1x_i\):
Duas coisas saem daí e as duas merecem uma pausa.
Primeira: iguale ambas a zero e você recupera exatamente as duas identidades que o exemplo feito à mão satisfazia: \(\sum e_i = 0\) e \(\sum e_i x_i = 0\). A forma fechada e o gradiente são a mesma afirmação, abordada por dois caminhos.
Segunda: veja do que o gradiente é feito — uma soma ponderada pelos resíduos. Pontos que o modelo já prevê bem contribuem com \(e_i \approx 0\) e quase não votam. Os pontos em que ele erra feio dominam o passo. A regra de atualização
lê-se, então, em português claro: mova cada parâmetro na direção para onde os erros apontam, numa quantidade proporcional ao tamanho desses erros. É a frase que continuará verdadeira, sem mudar uma vírgula, quando o modelo for uma rede de 100 camadas e \(\nabla J\) vier da retropropagação.
11. A paisagem que o gradiente percorre
Etapa 4. A figura abaixo torna a geometria concreta. À esquerda está \(J(w_0, w_1)\) como uma paisagem — cada ponto é uma reta candidata, a cor é o erro dela e a cruz branca é o ótimo em forma fechada. Clique para soltar um palpite inicial e descer:
Agora ligue centrar x e rode de novo a partir de um ponto parecido. Mesmos dados, mesmo algoritmo, comportamento radicalmente diferente.
Sem centrar, as curvas de nível formam um vale longo e estreito: \(w_0\) e \(w_1\) ficam fortemente acoplados, porque mexer na inclinação de uma reta cujos valores de \(x\) estão todos longe de zero também balança a altura dela. O gradiente aponta atravessado ao vale e não ao longo dele, então o caminho ziguezagueia e se arrasta. Centrado, o vale vira uma tigela e os mesmos passos vão quase direto à resposta.
É por isso que escalonar vem antes de ajustar
A forma fechada não liga para nada disso — \((X^\top X)^{-1}X^\top y\) devolve a mesma reta ajustada nos dois casos. Já a rota iterativa liga muito. Essa é a ligação entre pré-processamento e otimização: padronizar atributos não é arrumação cosmética, é remodelar a superfície que o otimizador tem de percorrer.
Escolher \(\eta\), fazer isso em lotes em vez do conjunto inteiro e acrescentar a \(J\) penalidades que encolhem os pesos são o tema da próxima aula: Gradiente Descendente & Regularização.
Lab avançado — onde a forma fechada quebra e um ano de Ibovespa
O lab fundamental resolveu as equações normais para cinco pontos. Esta parte pergunta até onde essa fórmula vai: mede o que custa resolver conforme o número de atributos cresce, escreve a alternativa iterativa e depois aplica as mesmas duas linhas de álgebra a dados reais, um ano de fechamentos diários do Ibovespa, para ver o que uma reta bem ajustada pode e não pode dizer sobre o futuro. Continue no mesmo notebook, na mesma sessão: os passos abaixo usam x, y, X e w dos passos 1 a 4.
Como fazer este lab em aula (cerca de 40 min, em duplas)
- Continue no notebook do Colab, a partir do passo 5 (a seção 5). Se a sessão caiu, rode antes as células dos passos 1 a 4 (Ambiente de execução → Executar anteriores).
- Como no lab fundamental: Preveja antes de rodar, compare com esta página e tente as Simulações antes de abrir a solução.
- Os seus números vão diferir em dois lugares. Os tempos do passo 5 dependem da máquina. Os passos 6 a 10 baixam o último ano de cotações no dia em que você os roda; as saídas aqui vêm de uma execução em 24/10/2026, com a janela terminando em 23/10/2026. As leituras devem valer para os seus números também: confira.
- Ritmo sugerido: passo 5 e a primeira simulação em 12 min; passos 6 e 7 e a segunda simulação em 12 min; passos 8 a 10 em 15 min.
Passo 5 — onde a forma fechada quebra: tempo e memória
Preveja. Resolver um sistema \(d \times d\) custa \(O(d^3)\). Quando \(d\) dobra, quanto o tempo deveria crescer? E o que acaba primeiro num notebook comum conforme \(d\) cresce: a paciência ou a memória?
rng = np.random.default_rng(0)
print(f"{'d':>6} {'tempo':>10} {'razão vs d/2':>14}")
anterior = None
for d in [250, 500, 1000, 2000]:
    A = rng.standard_normal((d, d)); A = A @ A.T + d*np.eye(d)   # simétrica positiva-definida
    b = rng.standard_normal(d)
    t = min(( (lambda t0: (np.linalg.solve(A, b), time.perf_counter()-t0)[1])(time.perf_counter())
              for _ in range(3) ))
    razao = f"{t/anterior:.1f}×" if anterior else "—"
    print(f"{d:>6} {t:>9.4f}s {razao:>14}")
    anterior = t
print("memória necessária só para GUARDAR XᵀX (float64):\n")
for d in [1_000, 10_000, 50_000, 100_000]:
    gb = d*d*8 / 1e9
    veredito = "cabe" if gb < 8 else "NÃO CABE em um notebook comum"
    print(f"  d = {d:>7}  ->  {gb:8.2f} GB   {veredito}")

print("\nUm texto vetorizado com TF-IDF facilmente passa de 100 mil colunas.")
print("Nesse caso XᵀX nem chega a ser construída — muito antes de haver o que inverter.")
memória necessária só para GUARDAR XᵀX (float64):

  d =    1000  ->      0.01 GB   cabe
  d =   10000  ->      0.80 GB   cabe
  d =   50000  ->     20.00 GB   NÃO CABE em um notebook comum
  d =  100000  ->     80.00 GB   NÃO CABE em um notebook comum

Um texto vetorizado com TF-IDF facilmente passa de 100 mil colunas.
Nesse caso XᵀX nem chega a ser construída — muito antes de haver o que inverter.
Os tempos são de uma execução e dependem da máquina; o que importa é a coluna da razão. Nos tamanhos pequenos o custo fixo de chamar a rotina e o paralelismo da biblioteca de álgebra linear pesam mais que a conta, então a razão começa bem abaixo de 8 e sobe em direção a ele conforme \(d\) cresce (9,4 aqui, em \(d = 2000\)). O tempo é ruim, mas administrável. O que trava é a memória: \(X^\top X\) precisa de \(8d^2\) bytes qualquer que seja o número de linhas, 80 GB com 100 mil atributos. É a seção 9, medida.
Simulação: o gradiente descendente, escrito à mão. A seção 10 derivou as duas derivadas. Escreva a descida para os cinco pontos: comece em \(w_0 = w_1 = 0\), atualize os dois pesos com \(w \leftarrow w - \eta\,\nabla J\) por 2000 iterações e teste \(\eta = 0{,}01\), \(0{,}05\), \(0{,}08\) e \(0{,}09\). Quais taxas chegam à forma fechada do passo 4, \((1{,}8; 0{,}8)\)? O que acontece com a última?
Solução
def desce(x, y, eta, iters=2000):
    w0 = w1 = 0.0
    n = len(x)
    for _ in range(iters):
        e = y - (w0 + w1 * x)                  # resíduos da reta atual
        w0 -= eta * (-2 / n * e.sum())         # ∂J/∂w0 = −(2/n)·Σe
        w1 -= eta * (-2 / n * (e * x).sum())   # ∂J/∂w1 = −(2/n)·Σe·x
    return w0, w1

for eta in [0.01, 0.05, 0.08, 0.09]:
    w0, w1 = desce(x, y, eta)
    print(f"eta {eta:.2f}: w0 = {w0:.4g} · w1 = {w1:.4g}")
eta 0.01: w0 = 1.798 · w1 = 0.8005
eta 0.05: w0 = 1.8 · w1 = 0.8
eta 0.08: w0 = 1.8 · w1 = 0.8
eta 0.09: w0 = -2.245e+105 · w1 = -8.104e+105
Com \(\eta = 0{,}05\) e \(0{,}08\), 2000 passos pequenos chegam exatamente à reta das equações normais, \(\hat y = 1{,}8 + 0{,}8x\), sem resolver sistema algum. Com \(\eta = 0{,}01\) os passos são curtos demais e 2000 deles não bastam (1,798 e 0,8005). Com \(\eta = 0{,}09\) cada passo passa do mínimo por mais que o anterior e os pesos explodem para \(10^{105}\): entre 0,08 e 0,09 está a maior taxa que este problema tolera. Escolher \(\eta\) é o primeiro tema da próxima aula.
Passo 6 — um ano de Ibovespa
Preveja. O modelo será o mais simples possível: \(y\) = o fechamento do dia, \(x\) = a posição do pregão na janela (1, 2, 3, …). Num ano, quantos pregões você espera, mais ou menos? E quão distantes ficarão as escalas das duas colunas de \(X\)?
# o yfinance não vem no Colab por padrão
%pip install -q yfinance

import yfinance as yf
import pandas as pd

print("yfinance", yf.__version__)
bruto = yf.download("^BVSP", period="1y", progress=False, auto_adjust=True)

fech = bruto["Close"]
if isinstance(fech, pd.DataFrame):      # versões recentes devolvem colunas em dois níveis
    fech = fech.iloc[:, 0]
fech = fech.dropna()

print(f"{len(fech)} pregões, de {fech.index[0]:%d/%m/%Y} a {fech.index[-1]:%d/%m/%Y}")
print(f"primeiro fechamento: {fech.iloc[0]:>12,.0f}")
print(f"último fechamento:   {fech.iloc[-1]:>12,.0f}")
print(f"variação na janela:  {100*(fech.iloc[-1]/fech.iloc[0]-1):>11.1f}%")
249 pregões, de 23/10/2025 a 23/10/2026
primeiro fechamento:      145,721
último fechamento:        205,083
variação na janela:         40.7%
y_ibov = fech.to_numpy(dtype=float)
x_ibov = np.arange(1, len(y_ibov) + 1, dtype=float)

print("x:", x_ibov[:6], "...", x_ibov[-3:])
print("y:", np.round(y_ibov[:6]), "...", np.round(y_ibov[-3:]))
print("\nn =", len(y_ibov))
x: [1. 2. 3. 4. 5. 6.] ... [247. 248. 249.]
y: [145721. 146172. 146969. 147429. 148633. 148780.] ... [206495. 204120. 205083.]

n = 249
O yfinance lê a base pública do Yahoo Finance; ^BVSP é o código do índice. Um ano tem cerca de 250 pregões (249 nesta janela): fins de semana e feriados não têm preço, então não são observações; \(x\) conta pregões, não dias de calendário. Repare nas escalas: \(y\) está na casa das centenas de milhares, \(x\) vai de 1 a 249 e a coluna de 1s vale 1. Guarde isso: é o tema da próxima simulação.
Simulação: o que centrar faz com a descida. O \(x\) do Ibovespa vai de 1 a 249, longe de zero; a seção 11 disse que isso faz o gradiente descendente ziguezaguear. Meça onde é rápido, nos cinco pontos: conte quantas iterações a descida da simulação anterior precisa para deixar os dois pesos a menos de 0,001 da solução exata, com o \(x\) cru e com o \(x - \bar x\) centrado, para \(\eta = 0{,}01\), \(0{,}05\), \(0{,}08\), \(0{,}3\) e \(0{,}45\).
Solução
def passos_ate_a_resposta(x, y, eta, tol=1e-3):
    """iterações até os dois pesos ficarem a menos de tol da solução exata"""
    A = np.column_stack([np.ones_like(x), x])
    alvo = np.linalg.solve(A.T @ A, A.T @ y)
    w0 = w1 = 0.0
    n = len(x)
    for k in range(1, 10_001):
        e = y - (w0 + w1 * x)
        w0, w1 = w0 + eta * 2 / n * e.sum(), w1 + eta * 2 / n * (e * x).sum()
        if not np.isfinite(w1) or abs(w1) > 1e6:
            return 'diverge'
        if abs(w0 - alvo[0]) < tol and abs(w1 - alvo[1]) < tol:
            return k
    return '> 10000'

xc = x - x.mean()
print(f"{'eta':>5} {'x cru':>9} {'x centrado':>11}")
for eta in [0.01, 0.05, 0.08, 0.3, 0.45]:
    print(f"{eta:5.2f} {passos_ate_a_resposta(x, y, eta):>9} {passos_ate_a_resposta(xc, y, eta):>11}")
Com a mesma taxa, centrar corta o trabalho por cerca de cinco (428 iterações contra 80 em \(\eta = 0{,}05\)). E faz mais: o problema cru diverge acima de \(\eta \approx 0{,}08\), enquanto o centrado aceita \(\eta = 0{,}3\) e chega lá em 10 iterações. A reta é a mesma nos dois casos: o ajuste centrado tem intercepto \(\bar y = 4{,}2\) e inclinação 0,8, ou seja, \(\hat y = 4{,}2 + 0{,}8(x - 3) = 1{,}8 + 0{,}8x\). Centrar mudou a forma da paisagem, um vale estreito virou uma tigela redonda, não a resposta. Com \(x\) até 249, como no Ibovespa, o vale cru é muito mais estreito ainda.
Passo 7 — as mesmas duas linhas de álgebra
Preveja. O código que ajustou cinco pontos inventados vai agora ajustar 249 fechamentos reais, sem trocar uma linha. Nesta janela o índice subiu 40,7%. A reta ajustada vai subir com força? Vai passar perto do fechamento de hoje?
X_ibov = np.column_stack([np.ones_like(x_ibov), x_ibov])

# exatamente as mesmas duas linhas da seção 4
w_ibov = np.linalg.solve(X_ibov.T @ X_ibov, X_ibov.T @ y_ibov)

print("X_ibov.shape =", X_ibov.shape)
print("w =", w_ibov)
print(f"\nreta:  fechamento ≈ {w_ibov[0]:,.0f}  +  {w_ibov[1]:,.1f} · dia")
print(f"\nou seja: a reta atribui {w_ibov[1]:,.1f} pontos de alta a cada pregão.")
X_ibov.shape = (249, 2)
w = [161854.1202    116.1611]

reta:  fechamento ≈ 161,854  +  116.2 · dia

ou seja: a reta atribui 116.2 pontos de alta a cada pregão.
yhat_ibov = X_ibov @ w_ibov
res_ibov  = y_ibov - yhat_ibov

plt.figure(figsize=(9, 4))
plt.plot(x_ibov, y_ibov, color='#f0883e', lw=1.2, label='fechamento do Ibovespa')
plt.plot(x_ibov, yhat_ibov, color='#1F6B8E', lw=2,
         label=f'reta: {w_ibov[0]:,.0f} + {w_ibov[1]:,.1f}·dia')
plt.xlabel('dia (posição na janela)'); plt.ylabel('pontos')
plt.title('um ano de Ibovespa e a reta de mínimos quadrados')
plt.legend(); plt.grid(alpha=.3); plt.show()

plt.figure(figsize=(9, 2.4))
plt.axhline(0, color='#1F6B8E', lw=1.5)
plt.plot(x_ibov, res_ibov, color='#9E3B2E', lw=1)
plt.xlabel('dia'); plt.ylabel('resíduo'); plt.title('os resíduos, sozinhos')
plt.grid(alpha=.3); plt.show()
O código não sabe que está olhando um índice de bolsa: \(X\) agora é \(249 \times 2\) em vez de \(5 \times 2\) e nada mais mudou. A reta ganha 116,2 pontos por pregão, cerca de 29 mil na janela, bem menos que os 59 mil que o índice de fato ganhou (de 145.721 a 205.083). A inclinação não é "último fechamento menos primeiro": os mínimos quadrados equilibram todos os dias do ano e esta janela teve uma subida nos primeiros meses, uma longa queda no meio e uma alta forte nos dois últimos meses. Nesta janela o valor da reta no último dia é 161.854 + 116,2 × 249 ≈ 190.800, uns 14 mil pontos abaixo do fechamento real. Olhe o gráfico dos resíduos antes de seguir: eles não se espalham em torno do zero como poeira; eles passeiam, ficando acima do zero por semanas e depois abaixo.
Passo 8 — quanto a reta explica
Preveja. A seção 8 listou a independência dos resíduos entre as suposições. No gráfico de resíduos do passo 7, o resíduo de hoje se parece muito com o de ontem. A correlação entre resíduos vizinhos vai ficar perto de 0, de 0,5 ou de 1?
n_ibov = len(y_ibov)
sse = res_ibov @ res_ibov
sst = ((y_ibov - y_ibov.mean())**2).sum()
r2  = 1 - sse/sst
s   = np.sqrt(sse/(n_ibov - 2))
rho = np.corrcoef(res_ibov[:-1], res_ibov[1:])[0, 1]

print(f"R²                                = {r2:.4f}")
print(f"desvio típico do resíduo (s)      = {s:,.0f} pontos")
print(f"   ... como % do índice de hoje   = {100*s/y_ibov[-1]:.1f}%")
print(f"correlação entre resíduos vizinhos = {rho:.4f}")
R²                                = 0.3674
desvio típico do resíduo (s)      = 11,001 pontos
   ... como % do índice de hoje   = 5.4%
correlação entre resíduos vizinhos = 0.9797
Três números. O R² é a fração da dispersão em torno da média que a reta removeu: 37% nesta janela. O \(s\) é o resíduo típico, 11.001 pontos, 5,4% do índice; ele divide por \(n - 2\) em vez de \(n\) porque dois parâmetros foram estimados dos dados. O terceiro é o que importa: a correlação entre o resíduo de hoje e o de ontem é 0,98. A suposição de independência está claramente quebrada. Preço não oscila em torno de uma tendência: cada dia parte de onde o anterior chegou. Toda barra de erro que a teoria clássica oferece supõe o contrário.
Passo 9 — onde o índice fecha o ano?
Preveja. Levar a reta até 31 de dezembro dá um número. O notebook também calcula um intervalo de 95% para ele. O intervalo vai ser estreito o bastante para dizer se o índice sobe ou cai até o fim do ano?
ultima = fech.index[-1]
fim_do_ano = pd.Timestamp(ultima.year, 12, 31)

# dias úteis restantes (não desconta feriado da B3, então sai um pouco por cima)
pregoes_restantes = len(pd.bdate_range(ultima + pd.Timedelta(days=1), fim_do_ano))
dia_fim = n_ibov + pregoes_restantes

previsao = w_ibov[0] + w_ibov[1]*dia_fim

# erro padrão de PREDIÇÃO: cresce conforme x0 se afasta do centro dos dados
Sxx = ((x_ibov - x_ibov.mean())**2).sum()
se_pred = s*np.sqrt(1 + 1/n_ibov + (dia_fim - x_ibov.mean())**2/Sxx)
lo, hi = previsao - 1.96*se_pred, previsao + 1.96*se_pred

print(f"último pregão da janela: {ultima:%d/%m/%Y}  (dia {n_ibov})")
print(f"pregões até 31/12:       {pregoes_restantes}  ->  dia {dia_fim:.0f}\n")
print(f"PREVISÃO PARA O FIM DO ANO:  {previsao:,.0f} pontos")
print(f"hoje:                        {y_ibov[-1]:,.0f} pontos")
print(f"implica:                     {100*(previsao/y_ibov[-1]-1):+.1f}%\n")
print(f"intervalo de 95%: [{lo:,.0f} ; {hi:,.0f}]   (largura: {hi-lo:,.0f} pontos)")
print(f"o intervalo contém o valor de hoje? {'SIM' if lo <= y_ibov[-1] <= hi else 'não'}")
último pregão da janela: 23/10/2026  (dia 249)
pregões até 31/12:       49  ->  dia 298

PREVISÃO PARA O FIM DO ANO:  196,470 pontos
hoje:                        205,083 pontos
implica:                     -4.2%

intervalo de 95%: [174,616 ; 218,325]   (largura: 43,709 pontos)
o intervalo contém o valor de hoje? SIM
xs = np.linspace(1, dia_fim, 400)
se_xs = s*np.sqrt(1 + 1/n_ibov + (xs - x_ibov.mean())**2/Sxx)
reta_xs = w_ibov[0] + w_ibov[1]*xs

plt.figure(figsize=(9, 4.4))
plt.fill_between(xs, reta_xs - 1.96*se_xs, reta_xs + 1.96*se_xs,
                 color='#1F6B8E', alpha=.12, label='intervalo de 95%')
plt.plot(x_ibov, y_ibov, color='#f0883e', lw=1.2, label='fechamento observado')
plt.plot(xs, reta_xs, color='#1F6B8E', lw=2, label='reta extrapolada')
plt.axvline(n_ibov, color='#9E3B2E', ls='--', lw=1.2)
plt.scatter([dia_fim], [previsao], color='#9E3B2E', s=70, zorder=5,
            label=f'31/12: {previsao:,.0f}')
plt.xlabel('dia (posição na janela)'); plt.ylabel('pontos')
plt.title('o clímax: a reta levada até o fim do ano')
plt.legend(loc='upper left', fontsize=9); plt.grid(alpha=.3); plt.show()
O intervalo não é "a reta ± \(s\)". Prever uma observação nova em \(x_0\) soma três incertezas: a do próprio ponto novo (o 1 dentro da raiz), a da altura da reta (\(1/n\)) e a da inclinação dela, que cresce com a distância ao centro dos dados, \((x_0 - \bar x)^2/\sum(x_i - \bar x)^2\): o preço de extrapolar. A 49 pregões de uma janela de 249, esse preço ainda é pequeno; quase toda a largura vem do próprio \(s\). Nesta execução a reta aponta 196.470 em 31 de dezembro, 4,2% abaixo de um índice que subiu 40,7% no ano; o intervalo, de 43.709 pontos de largura, contém o valor de hoje. Nas contas do próprio modelo, ele não sabe se o índice termina o ano em alta ou em queda. E o intervalo é otimista: supõe erros independentes, a suposição que o passo 8 mostrou quebrada.
Passo 10 — o teste honesto
Preveja. Ajuste a reta num ano, use-a para prever o último dia do ano seguinte e compare com o que aconteceu. Você espera um erro perto de \(s\), os 11 mil pontos do passo 8, ou muito maior?
d2 = yf.download("^BVSP", period="2y", progress=False, auto_adjust=True)["Close"]
if isinstance(d2, pd.DataFrame):
    d2 = d2.iloc[:, 0]
d2 = d2.dropna()

v  = d2.to_numpy(dtype=float)
n2 = len(v)
corte = n2 // 2                      # treina na primeira metade (~1 ano)

x_tr = np.arange(1, corte + 1, dtype=float)
y_tr = v[:corte]
X_tr = np.column_stack([np.ones_like(x_tr), x_tr])
w_tr = np.linalg.solve(X_tr.T @ X_tr, X_tr.T @ y_tr)

previsto = w_tr[0] + w_tr[1]*n2      # um ano à frente do fim do treino
real     = v[-1]

print(f"treino: {d2.index[0]:%d/%m/%Y} a {d2.index[corte-1]:%d/%m/%Y}  ({corte} pregões)")
print(f"alvo:   {d2.index[-1]:%d/%m/%Y}  (dia {n2})\n")
print(f"a reta previa: {previsto:>12,.0f}")
print(f"aconteceu:     {real:>12,.0f}")
print(f"erro:          {previsto-real:>+12,.0f} pontos   ({100*(previsto/real-1):+.1f}%)")
treino: 23/10/2024 a 22/10/2025  (249 pregões)
alvo:   23/10/2026  (dia 498)

a reta previa:      164,118
aconteceu:          205,083
erro:               -40,965 pontos   (-20.0%)
Este é o teste que conta, aquele sobre o qual a aula de validação se constrói: aplicar o procedimento ao passado e comparar com o que aconteceu, em dados que ele não viu. Ajustada no ano até outubro de 2025, a reta previa 164.118 para outubro de 2026; o índice fechou em 205.083. O erro, 40.965 pontos ou 20%, é quase quatro vezes o \(s\) do passo 8. A álgebra está impecável: as equações normais devolveram a melhor reta para aquela janela. O que falha é a pergunta. O R² mede o ajuste ao passado, não a capacidade de prever; extrapolar repete uma suposição, a de que a tendência continua, que nenhum dado confirmou; e com resíduos que passeiam (correlação 0,98), a inclinação medida é em boa parte o caminho que por acaso aconteceu. A reta serve para descrever a janela: em média, tantos pontos por pregão. Ela não responde a pergunta que todo mundo quer fazer.
Para fechar a aula. Em uma frase cada: (1) o que acaba primeiro quando o número de atributos cresce e o que substitui a forma fechada nesse caso? (2) Por que centrar \(x\) acelera o gradiente descendente sem mudar a reta que ele encontra? (3) Por que um R² calculado no passado não é evidência de que a reta consegue prever o futuro?
Sua vez (avançada)
Em casa, com mais tempo:
- O custo, medido mais longe. Estenda o passo 5 até
d = 4000. A razão continua perto de 8? Onde ela começa a se afastar e por quê? - A janela muda a tendência. Refaça os passos 6 e 7 com
period="5y"e comperiod="6mo"e anote a inclinação em cada caso. Se "a tendência do Ibovespa" fosse um fato do mundo, ela deveria depender tanto da janela que você escolheu? - O logaritmo em vez do nível. Ajuste a reta a \(\log(\text{fechamento})\): a inclinação passa a ser aproximadamente a taxa de crescimento por pregão e a previsão vira \(e^{\hat y}\). Por que uma reta no logaritmo é mais defensável para preço do que uma reta no nível? (Dica: o que a reta no nível supõe sobre ganhar 100 pontos partindo de 50 mil ou de 200 mil?)
Material de aula
Roteiros
Quatro materiais de apoio:
- Regressão linear: da reta ao gradiente — o roteiro de aula: Galton, mínimos quadrados à mão, resíduos e o gradiente, com simuladores ao vivo e cinco etapas de laboratório;
- Regressão linear em profundidade — o estudo aprofundado: a geometria da projeção, a álgebra das equações normais, alavancagem e influência, inferência — e onde cada suposição realmente aperta;
- Regressão linear do zero — notebook no Colab que constrói a conta inteira, de ŷ = Xw ao muro de memória e ao gradiente descendente à mão;
- Para casa: Python que roda na página — nove células executáveis via Pyodide, só biblioteca padrão, fechando com oito perguntas e respostas comentadas.
Referências
- Legendre, A.-M. "Nouvelles méthodes pour la détermination des orbites des comètes." Courcier (1805) — apêndice Sur la Méthode des moindres quarrés. texto completo
- Gauss, C. F. "Theoria motus corporum coelestium in sectionibus conicis solem ambientium." Perthes & Besser (1809). texto completo
- Galton, F. "Regression towards Mediocrity in Hereditary Stature." J. Anthropological Institute 15 (1886). texto completo
- Hanley, J. A. ""Transmuting" Women into Men: Galton's Family Data on Human Stature." The American Statistician 58 (2004). DOI
- Anscombe, F. J. "Graphs in Statistical Analysis." The American Statistician 27 (1973). DOI
- Cook, R. D. "Detection of Influential Observation in Linear Regression." Technometrics 19 (1977). DOI
Quiz
O quiz cobre a abordagem fundamental.