O algoritmo mais antigo do curso
Legendre
publica os mínimos quadrados para ajustar órbitas de cometas
Gauss
alega que já os usava desde então
Galton
estuda a altura humana e aparece a palavra regressão
O caminho desta parte
- O enigma de Galtonregressão à média; a inclinação é a correlação
- O modeloŷ = Xw; lendo os coeficientes; por que não inverter X
- Mínimos quadradosminimizar os resíduos ao quadrado; as fórmulas à mão
- Resíduosgráfico de resíduos; outliers e alavancagem
- Medir a qualidadeMAE, MSE, RMSE e R²
O enigma de Galton
- Alturas de 928 filhos adultos e de seus pais.
- Ele procurava medir a força da hereditariedade.
Os filhos voltam em direção à média
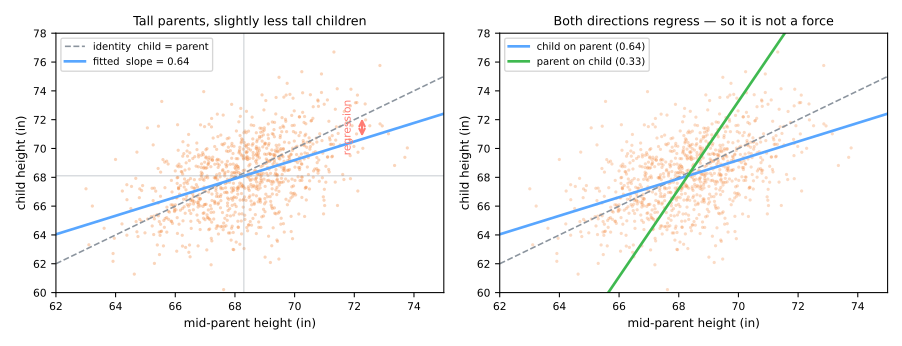
Linha tracejada: identidade (o filho igual aos pais). A reta ajustada é mais achatada: 3 polegadas acima da média nos pais → só cerca de 2 no filho.
A inclinação é a correlação com unidades
\[ \hat{w}_1 = r_{xy}\,\frac{s_y}{s_x} = 0{,}46 \times \frac{2{,}52}{1{,}80} \approx 0{,}64 \]\(r_{xy}\): correlação entre a média dos pais \(x\) e o filho \(y\); \(s_x, s_y\): os desvios padrão de cada um, em polegadas.
correlação \(r\)
sem unidade; o quanto os pontos seguem uma reta
inclinação \(\hat w_1\)
unidades de \(y\) por unidade de \(x\); igual a \(r\) só quando \(s_x = s_y\)
Simulador: regressão à média
Aqui as duas variáveis têm a mesma dispersão, então a inclinação é a correlação. Baixe a correlação e veja a reta achatar.
Regressão à média não é uma força
- Regrida pais sobre filhos: essa reta também é mais achatada. Filhos não podem puxar os pais para a média.
- É aritmética: toda medida é sinal + ruído. Um valor extremo teve ajuda da sorte; o sinal volta, a sorte não.
reforço escolar
os piores alunos melhoram — teriam melhorado de qualquer jeito
a maldição da capa
uma temporada excepcional é seguida de uma temporada normal
a clínica
parte da queda da pressão é regressão; só um grupo de controle a separa
O modelo
\[ \hat{y} = w_0 + w_1 x_1 + w_2 x_2 + \dots + w_d x_d \qquad\text{ou}\qquad \hat y = Xw \]- \(x_j\): os \(d\) atributos; \(w_j\): variação em \(\hat{y}\) por unidade de \(x_j\), mantendo os outros atributos fixos.
- \(w_0\): a previsão quando todos os atributos são zero (uma coluna de 1s em \(X\), uma linha por exemplo).
Lendo os coeficientes
\[ \widehat{\text{preço}} = 50000 + 3200\cdot\text{área} - 1500\cdot\text{idade} \]3200: entre apartamentos de mesma idade, um m² a mais vem com R$ 3200 a mais.- Não é "apartamentos maiores custam 3200 a mais por m²": se prédios mais novos são maiores, a relação bruta mistura os dois efeitos.
Preveja. \(\hat y = Xw\) parece um sistema linear. Por que não calcular simplesmente \(w = X^{-1}y\)?
Por que não inverter \(X\)?
Três pontos \((x, y)\): (1, 2), (2, 3), (3, 7). A coluna 1 de \(X\) são os 1s; a coluna 2 é \(x\).
- \(X\) não é quadrada (\(3 \times 2\)): não tem inversa.
- De todo modo não há solução exata: 3 equações, 2 incógnitas.
O que fazemos: o ponto alcançável mais próximo
Minimizar \(\lVert y - Xw\rVert^2\), a soma dos quadrados dos resíduos. Igualar o gradiente dela a zero dá as equações normais:
\[ X^\top X\,w = X^\top y \;\Rightarrow\; \begin{cases} 3w_0 + 6w_1 = 12 \\ 6w_0 + 14w_1 = 29 \end{cases} \] \[ w_0 = -1,\quad w_1 = 2{,}5 \]Previstos 1,5; 4; 6,5; resíduos 0,5; −1; 0,5; \(\lVert e\rVert^2 = 1{,}5\), o menor possível.
\(\hat y = -1 + 2{,}5x\) (verde) e os resíduos (laranja)
O seu instinto é o caso particular
Fique só com dois pontos, (1, 2) e (2, 3): duas equações, duas incógnitas.
\[ X = \begin{pmatrix} 1 & 1 \\ 1 & 2 \end{pmatrix}, \quad X^{-1} = \begin{pmatrix} 2 & -1 \\ -1 & 1 \end{pmatrix}, \quad w = X^{-1}y = \begin{pmatrix} 1 \\ 1 \end{pmatrix} \]Os mínimos quadrados dão a mesma resposta: \((X^\top X)^{-1}X^\top = X^{-1}\).
\(\hat y = 1 + x\): uma reta por dois pontos, sem resíduo
Mínimos quadrados: qual reta?
\[ J(w) = \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 = \lVert y - Xw \rVert^2 \]por que vertical?
o trabalho é prever \(y\): o erro se mede ao longo de \(y\). Distâncias perpendiculares são a PCA (análise de componentes principais), outra pergunta.
por que ao quadrado?
- suave: existe forma fechada
- um erro grande custa mais que vários pequenos
- ruído gaussiano → máxima verossimilhança
Simulador: arraste os pontos
Preveja. Arraste um ponto para longe dos demais. A reta se mexe pouco ou muito?
A solução exata, com um atributo
\[ \hat{w}_1 = \frac{\sum_i (x_i - \bar{x})(y_i - \bar{y})}{\sum_i (x_i - \bar{x})^2} = r_{xy}\frac{s_y}{s_x}, \qquad \hat{w}_0 = \bar{y} - \hat{w}_1 \bar{x} \]\(\bar x, \bar y\): as médias de \(x\) e \(y\). O numerador soma, ponto a ponto, o quanto \(x\) e \(y\) se afastam das médias, multiplicados; o denominador, os afastamentos de \(x\) ao quadrado.
Mínimos quadrados à mão, passo a passo
Preveja. Cinco pontos: (1, 2), (2, 4), (3, 5), (4, 4), (5, 6). Qual ponto não soma nada à inclinação? Depois percorra a tabela, a inclinação, o intercepto e os resíduos.
No scikit-learn
from sklearn.linear_model import LinearRegression

model = LinearRegression().fit(X_train, y_train)
model.coef_, model.intercept_
y_pred = model.predict(X_test)
Resíduos: o que o modelo não explicou
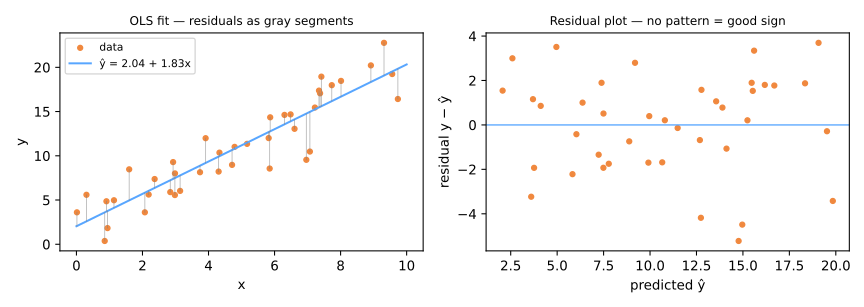
O gráfico de resíduos: \(e_i = y_i - \hat y_i\) contra \(\hat y_i\).
Um gráfico saudável parece não ter nada: uma faixa em torno de zero.
Qualquer padrão diz qual suposição quebrou.
Simulador: diagnostique antes de ler o veredicto
Preveja. Em cada conjunto, olhe só o gráfico de resíduos e decida: tudo bem, curva, funil ou ponto perigoso?
Lendo um gráfico de resíduos
| o que você vê | o que significa | o que fazer |
|---|---|---|
| faixa sem estrutura | a forma linear serve | nada |
| curva em U ou ∩ | relação não linear | termos polinomiais ou transformar \(x\) |
| funil | heteroscedasticidade: o ruído cresce com \(\hat y\) | transformar \(y\) (muitas vezes log) |
| ponto extremo isolado | outlier ou alta alavancagem | investigar; nunca apagar em silêncio |
| ondas ao longo do índice | erros correlacionados (tempo) | um modelo de série temporal |
Quatro resumos dos resíduos
| métrica | fórmula | unidade |
|---|---|---|
| MAE | \(\frac{1}{n}\sum \lvert e_i \rvert\) | de \(y\) |
| MSE | \(\frac{1}{n}\sum e_i^2\) | \(y\) ao quadrado |
| RMSE | \(\sqrt{\text{MSE}}\) | de \(y\) |
| R² | \(1 - \frac{\sum e_i^2}{\sum (y_i - \bar{y})^2}\) | nenhuma |
O nome é a receita, lida da direita para a esquerda:
RMSE = Error → Squared → Mean → Root.
MAE (mean absolute error): erro absoluto médio; MSE (mean squared error): erro quadrático médio; RMSE (root mean squared error): raiz do erro quadrático médio; R²: coeficiente de determinação.
Nos cinco pontos
\(\hat y = 1{,}8 + 0{,}8x\) e os seus cinco resíduos
\(\text{MAE} = \frac{0{,}6+0{,}6+0{,}8+1{,}0+0{,}2}{5} = \frac{3{,}2}{5} = \mathbf{0{,}64}\)
\(\text{MSE} = \frac{0{,}36+0{,}36+0{,}64+1{,}00+0{,}04}{5} = \frac{2{,}40}{5} = \mathbf{0{,}48}\)
em unidades de \(y\) ao quadrado
\(\text{RMSE} = \sqrt{0{,}48} = \mathbf{0{,}69}\)
MAE ou RMSE?
| erros | MAE | RMSE | |
|---|---|---|---|
| Modelo A | 2, 2, 2, 2, 2 | 2,0 | 2,0 |
| Modelo B | 0, 0, 0, 0, 10 | 2,0 | 4,47 |
O RMSE eleva ao quadrado antes de tirar a média: o único 10 contribui com 100 e \(\sqrt{100/5} = 4{,}47\). Nenhuma métrica está certa no abstrato: escolha a que os custos do seu problema pedem, antes de olhar os resultados.
R²: contra o modelo mais preguiçoso
\[ R^2 = 1 - \frac{\text{SSE}}{\text{SST}}, \qquad \text{SSE} = \sum (y_i - \hat y_i)^2, \quad \text{SST} = \sum (y_i - \bar y)^2 \]- SST (total sum of squares, soma total de quadrados): o erro de prever sempre \(\bar y\). SSE (sum of squared errors, soma dos quadrados dos erros): o que a reta ainda erra.
- Cinco pontos: \(R^2 = 1 - 2{,}40/8{,}80 = 0{,}727\) e \(r = 0{,}853\), \(0{,}853^2 = 0{,}727\).
DummyRegressor) e avalie em dados separados.Resumo
- Regressão à média é aritmética, não uma força: a inclinação é \(r_{xy}\,s_y/s_x\).
- Um coeficiente é o efeito do seu atributo com os outros fixos; não é uma importância.
- \(X\) não se inverte; os mínimos quadrados ficam com o ponto alcançável mais próximo de \(y\): \(X^\top X w = X^\top y\). A reta passa por \((\bar x, \bar y)\).
- Os resíduos somam zero e são ortogonais aos atributos; plote-os.
- MAE, RMSE, R²: resumos diferentes dos mesmos resíduos, com sentido em dados separados.
Cinco pontos, do zero: passos 1 a 4
- Só NumPy: a forma matricial, a inversa que falha, as equações normais, os resíduos.
- Os mesmos cinco pontos da conta à mão: toda saída pode ser conferida no papel.
- Notebook no Colab, seções 1 a 4: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: o seu instinto, o caso particular (passo 3) e o ponto que gira a reta (passo 4).
Ritmo: passos 1 e 2 em 5 min; passo 3 e a primeira simulação em 10 min; passo 4 e a segunda em 15 min.