O algoritmo mais antigo do curso
Legendre
publica os mínimos quadrados para ajustar órbitas de cometas
Gauss
alega que já os usava desde então
Galton
estuda a altura humana e aparece a palavra regressão
O caminho desta aula
- O enigma de Galtonregressão à média; a inclinação é a correlação
- O modeloŷ = Xw; por que não inverter X; lendo os coeficientes
- Mínimos quadradosminimizar os resíduos ao quadrado; a solução exata
- Resíduos e qualidadegráfico de resíduos, métricas de erro, R², suposições
- Rumo ao gradienteuma soma ponderada pelos resíduos
O enigma de Galton
- Alturas de 928 filhos adultos e de seus pais.
- Ele procurava medir a força da hereditariedade.
Os filhos voltam em direção à média
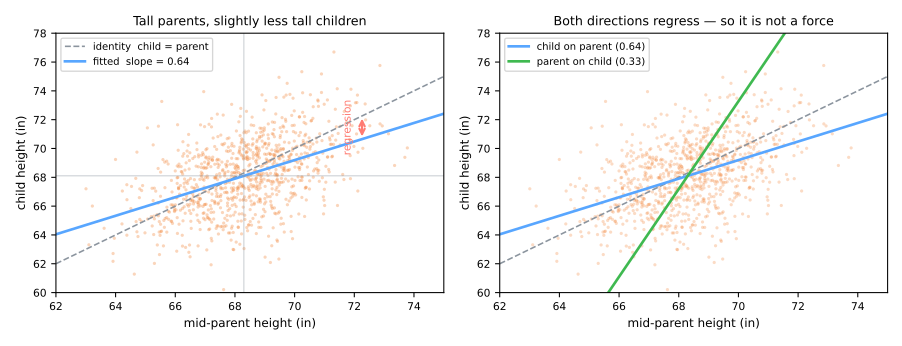
Linha tracejada: identidade (o filho igual aos pais). A reta ajustada é mais achatada: 3 polegadas acima da média nos pais → só cerca de 2 no filho.
A inclinação é a correlação com unidades
\[ \hat{w}_1 = r_{xy}\,\frac{s_y}{s_x} = 0{,}46 \times \frac{2{,}52}{1{,}80} \approx 0{,}64 \]correlação \(r\)
sem unidade; o quanto os pontos seguem uma reta
inclinação \(\hat w_1\)
unidades de \(y\) por unidade de \(x\); igual a \(r\) só quando \(s_x = s_y\)
Simulador: regressão à média
Aqui as duas variáveis têm a mesma dispersão, então a inclinação é a correlação. Baixe a correlação e veja a reta achatar.
Regressão à média não é uma força
- Regrida pais sobre filhos: essa reta também é mais achatada. Filhos não podem puxar os pais para a média.
- É aritmética: toda medida é sinal + ruído. Um valor extremo teve ajuda da sorte; o sinal volta, a sorte não.
reforço escolar
os piores alunos melhoram — teriam melhorado de qualquer jeito
a maldição da capa
uma temporada excepcional é seguida de uma temporada normal
a clínica
parte da queda da pressão é regressão; só um grupo de controle a separa
O modelo
\[ \hat{y} = w_0 + w_1 x_1 + w_2 x_2 + \dots + w_d x_d \qquad\text{ou}\qquad \hat y = Xw \]- \(w_j\): variação em \(\hat{y}\) por unidade de \(x_j\), mantendo os outros atributos fixos.
- \(w_0\): a previsão quando todos os atributos são zero (uma coluna de 1s em \(X\)).
Por que não inverter \(X\)?
- \(X\) não é quadrada (\(3 \times 2\)): não tem inversa.
- De todo modo não há solução exata: 3 equações, 2 incógnitas.
O que fazemos: o ponto alcançável mais próximo
Minimizar \(\lVert y - Xw\rVert^2\). Igualar o gradiente a zero dá as equações normais:
\[ X^\top X\,w = X^\top y \quad\Rightarrow\quad \begin{cases} 3w_0 + 6w_1 = 12 \\ 6w_0 + 14w_1 = 29 \end{cases} \quad\Rightarrow\quad w_0 = -1,\; w_1 = 2{,}5 \]previstos
1,5; 4; 6,5
resíduos
0,5; −1; 0,5
\(\lVert e\rVert^2\)
\(X^\top X\) é \(2\times 2\): quadrada. Nunca invertemos \(X\).
O seu instinto é o caso particular
Fique só com dois pontos: duas equações, duas incógnitas.
\[ X = \begin{pmatrix} 1 & 1 \\ 1 & 2 \end{pmatrix}, \quad X^{-1} = \begin{pmatrix} 2 & -1 \\ -1 & 1 \end{pmatrix}, \quad w = X^{-1}y = \begin{pmatrix} 1 \\ 1 \end{pmatrix} \]Os mínimos quadrados dão a mesma resposta: \((X^\top X)^{-1}X^\top = X^{-1}\).
Lendo os coeficientes
\[ \widehat{\text{preço}} = 50000 + 3200\cdot\text{área} - 1500\cdot\text{idade} \]3200: entre apartamentos de mesma idade, um m² a mais vem com R$ 3200 a mais.- Não é "apartamentos maiores custam 3200 a mais por m²": se prédios mais novos são maiores, a relação bruta mistura os dois efeitos.
Mínimos quadrados: qual reta?
\[ J(w) = \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 = \lVert y - Xw \rVert^2 \]OLS (ordinary least squares, mínimos quadrados ordinários): minimizar a soma dos quadrados dos resíduos.
por que vertical?
o trabalho é prever \(y\): o erro se mede ao longo de \(y\). Distâncias perpendiculares são a PCA, outra pergunta.
por que ao quadrado?
- suave: existe forma fechada
- um erro grande custa mais que vários pequenos
- ruído gaussiano → máxima verossimilhança
Simulador: arraste os pontos
Preveja. Arraste um ponto para longe dos demais. A reta se mexe pouco ou muito?
A solução exata, com um atributo
\[ \hat{w}_1 = \frac{\sum_i (x_i - \bar{x})(y_i - \bar{y})}{\sum_i (x_i - \bar{x})^2} = r_{xy}\frac{s_y}{s_x}, \qquad \hat{w}_0 = \bar{y} - \hat{w}_1 \bar{x} \]Feito à mão: cinco pontos
| \(x\) | \(y\) | \(x-\bar x\) | \(y-\bar y\) | produto | \((x-\bar x)^2\) |
|---|---|---|---|---|---|
| 1 | 2 | −2 | −2,2 | 4,4 | 4 |
| 2 | 4 | −1 | −0,2 | 0,2 | 1 |
| 3 | 5 | 0 | 0,8 | 0,0 | 0 |
| 4 | 4 | 1 | −0,2 | −0,2 | 1 |
| 5 | 6 | 2 | 1,8 | 3,6 | 4 |
| 8,0 | 10 |
\(\bar x = 3,\ \bar y = 4{,}2\)
\[ \hat w_1 = \tfrac{8{,}0}{10} = 0{,}8 \] \[ \hat w_0 = 4{,}2 - 0{,}8 \times 3 = 1{,}8 \]Os resíduos sempre se equilibram
| \(x\) | \(y\) | \(\hat y\) | \(e = y - \hat y\) |
|---|---|---|---|
| 1 | 2 | 2,6 | −0,6 |
| 2 | 4 | 3,4 | 0,6 |
| 3 | 5 | 4,2 | 0,8 |
| 4 | 4 | 5,0 | −1,0 |
| 5 | 6 | 5,8 | 0,2 |
\(\sum e_i = 0\) e \(\sum e_i x_i = -0{,}6+1{,}2+2{,}4-4{,}0+1{,}0 = 0\). Vale para todo ajuste OLS com intercepto.
No scikit-learn
from sklearn.linear_model import LinearRegression

model = LinearRegression().fit(X_train, y_train)
model.coef_, model.intercept_
y_pred = model.predict(X_test)
Resíduos: o que o modelo não explicou
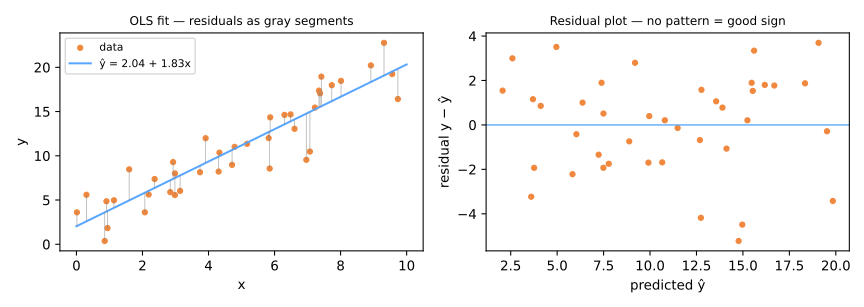
O gráfico de resíduos: \(e_i\) contra \(\hat y_i\).
Um gráfico saudável parece não ter nada: uma faixa em torno de zero.
Qualquer padrão diz qual suposição quebrou.
Simulador: diagnostique antes de ler o veredicto
Preveja. Em cada conjunto, olhe só o gráfico de resíduos e decida: tudo bem, curva, funil ou ponto perigoso?
Lendo um gráfico de resíduos
| o que você vê | o que significa | o que fazer |
|---|---|---|
| faixa sem estrutura | a forma linear serve | nada |
| curva em U ou ∩ | relação não linear | termos polinomiais ou transformar \(x\) |
| funil | heteroscedasticidade: o ruído cresce com \(\hat y\) | transformar \(y\) (muitas vezes log) |
| ponto extremo isolado | outlier ou alta alavancagem | investigar; nunca apagar em silêncio |
| ondas ao longo do índice | erros correlacionados (tempo) | um modelo de série temporal |
Medindo a qualidade: quatro resumos dos resíduos
| métrica | fórmula | unidade |
|---|---|---|
| MAE | \(\frac{1}{n}\sum \lvert e_i \rvert\) | de \(y\) |
| MSE | \(\frac{1}{n}\sum e_i^2\) | \(y\) ao quadrado |
| RMSE | \(\sqrt{\text{MSE}}\) | de \(y\) |
| R² | \(1 - \frac{\sum e_i^2}{\sum (y_i - \bar{y})^2}\) | nenhuma |
O nome é a receita, lida da direita para a esquerda:
RMSE = Error → Squared → Mean → Root.
MAE: erro absoluto médio; MSE: erro quadrático médio; RMSE: raiz do erro quadrático médio; R²: coeficiente de determinação.
Nos cinco pontos
Resíduos: −0,6; 0,6; 0,8; −1,0; 0,2
MAE
MSE
RMSE
MAE ou RMSE?
| erros | MAE | RMSE | |
|---|---|---|---|
| Modelo A | 2, 2, 2, 2, 2 | 2,0 | 2,0 |
| Modelo B | 0, 0, 0, 0, 10 | 2,0 | 4,47 |
O RMSE eleva ao quadrado antes de tirar a média: o único 10 contribui com 100. Nenhuma métrica está certa no abstrato: escolha a que os custos do seu problema pedem, antes de olhar os resultados.
R²: contra o modelo mais preguiçoso
\[ R^2 = 1 - \frac{\text{SSE}}{\text{SST}}, \qquad \text{SSE} = \sum (y_i - \hat y_i)^2, \quad \text{SST} = \sum (y_i - \bar y)^2 \]- SST (soma total de quadrados): o erro de prever sempre \(\bar y\). SSE (soma dos quadrados dos erros): o que a reta ainda erra.
- Cinco pontos: \(R^2 = 1 - 2{,}40/8{,}80 = 0{,}727\) e \(r = 0{,}853\), \(0{,}853^2 = 0{,}727\).
DummyRegressor) e avalie em dados separados.Suposições por trás das inferências
- Linearidade
- Independência dos resíduos
- Homoscedasticidade: dispersão constante
- Normalidade: para intervalos e p-valores, não para o ajuste
- Sem multicolinearidade severa
dois atributos com \(r = 0{,}99\)
Verdade \((1, 1)\); \((2, 0)\) ajusta com 2% de diferença, \((3, -1)\) com 8%.
Uma amostra nova pode inverter um sinal, enquanto a soma fica perto de 2.
As previsões estão boas; um coeficiente sozinho não quer dizer nada.
Da resposta exata ao gradiente
A forma fechada deixa de estar disponível: \(O(d^3)\), colunas colineares e modelos (redes neurais) que não têm equações normais.
\[ \frac{\partial J}{\partial w_0} = -\frac{2}{n}\sum_i e_i, \qquad \frac{\partial J}{\partial w_1} = -\frac{2}{n}\sum_i e_i x_i, \qquad w \leftarrow w - \eta\,\nabla J(w) \]Simulador: descendo a superfície de perda
Preveja. Rode, depois ligue centrar x e rode de novo a partir de um ponto parecido. O que muda no caminho?
Por que escalonar vem antes de ajustar
\(x\) sem centrar
Um vale longo e estreito. Mexer na inclinação de uma reta cujos \(x\) estão todos longe de zero também balança a altura dela, então \(w_0\) e \(w_1\) ficam acoplados. O gradiente aponta atravessado ao vale: o caminho ziguezagueia e se arrasta.
\(x\) centrado
Uma tigela redonda. O gradiente aponta para o fundo e os mesmos passos vão quase direto à resposta.
Esquema: curvas de nível de \(J(w_0, w_1)\), o ótimo (verde) e os passos do gradiente descendente (laranja).
Resumo
- Regressão à média é aritmética, não uma força.
- Mínimos quadrados = o ponto alcançável mais próximo de \(y\): \(X^\top X w = X^\top y\).
- Os resíduos são ortogonais aos atributos; plote-os.
- MAE, RMSE, R²: resumos diferentes dos mesmos resíduos; o R² compara com \(\bar y\).
- O gradiente é uma soma ponderada pelos resíduos.