O caminho desta parte
- Por que entropia cruzadao preço, o empurrão e o formato da perda
- Fronteiras curvasatributos ao quadrado e polinomiais
- Muitas classessoftmax, no wine
- Usar bempontos fortes, fraquezas, armadilhas
Por que não o erro quadrático?
\((y - \hat p)^2\) também é pequeno quando a probabilidade prevista \(\hat p\) acerta e grande quando erra. Preveja. Combinado com a sigmoide, o que pode dar errado?
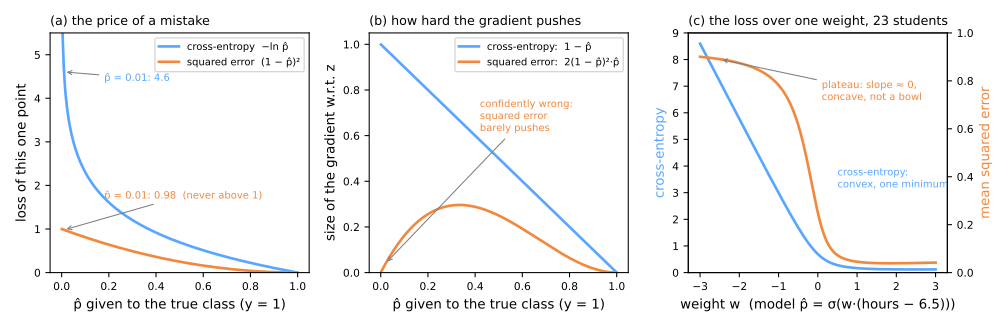
(a) o preço
o erro quadrático nunca passa de 1: \(\hat p = 0{,}1\) e \(0{,}001\) custam 0,810 e 0,998; na entropia cruzada, 2,303 e 6,908
(b) o empurrão
quanto pior o erro, mais fraco o gradiente do erro quadrático
(c) o formato
a entropia cruzada é convexa; o erro quadrático tem um platô
(b) O empurrão do gradiente
\(L\): a perda de um exemplo da classe 1 (\(y = 1\)). O gradiente descendente o corrige mexendo no escore \(z\) dele; a força é, pela regra da cadeia, \(\partial L/\partial z = \partial L/\partial \hat p \cdot \hat p(1-\hat p)\), em que \(\hat p(1-\hat p)\) é a inclinação da sigmoide:
\[ \text{erro quadrático: } -2(1-\hat p)\cdot\hat p(1-\hat p) \qquad \text{entropia cruzada: } -\tfrac{1}{\hat p}\cdot\hat p(1-\hat p) = \hat p - y \]| \(\hat p\) dada à classe certa | inclinação da sigmoide | erro quadrático | entropia cruzada |
|---|---|---|---|
| 0,5 | 0,25 | −0,250 | −0,500 |
| 0,1 | 0,09 | −0,162 | −0,900 |
| 0,01 | 0,0099 | −0,0196 | −0,990 |
| 0,001 | 0,001 | −0,0020 | −0,999 |
(c) O formato da perda
Um só peso, \(\hat p = \sigma(w\,(\text{horas} - 6{,}5))\), nos 23 estudantes: perda média sobre todos eles. \(w < 0\) aposta que quem estuda mais reprova.
| \(w\) | −3 | −1 | 0 | +1 | +3 |
|---|---|---|---|---|---|
| erro quadrático | 0,900 | 0,782 | 0,250 | 0,045 | 0,042 |
| entropia cruzada | 8,597 | 2,992 | 0,693 | 0,166 | 0,118 |
Simulador: as duas perdas lado a lado
Preveja. Gire \(w\) para o lado errado. Qual perda percebe que algo está muito errado?
Fronteiras curvas: construa os atributos
Os círculos: uma classe dentro, a outra em volta. Qualquer reta deixa pedaços do círculo externo dos dois lados.
| atributos | acurácia no teste |
|---|---|
| \(x_1, x_2\) | 0,400 |
| \(x_1^2, x_2^2\) | 1,000 |
\(w = (-16{,}83;\ -16{,}00)\), \(b = 9{,}70\): um círculo de raio \(\sqrt{9{,}70/16{,}4} \approx 0{,}77\), entre o círculo de dentro (0,5) e o de fora (1).
Quando a forma não é óbvia
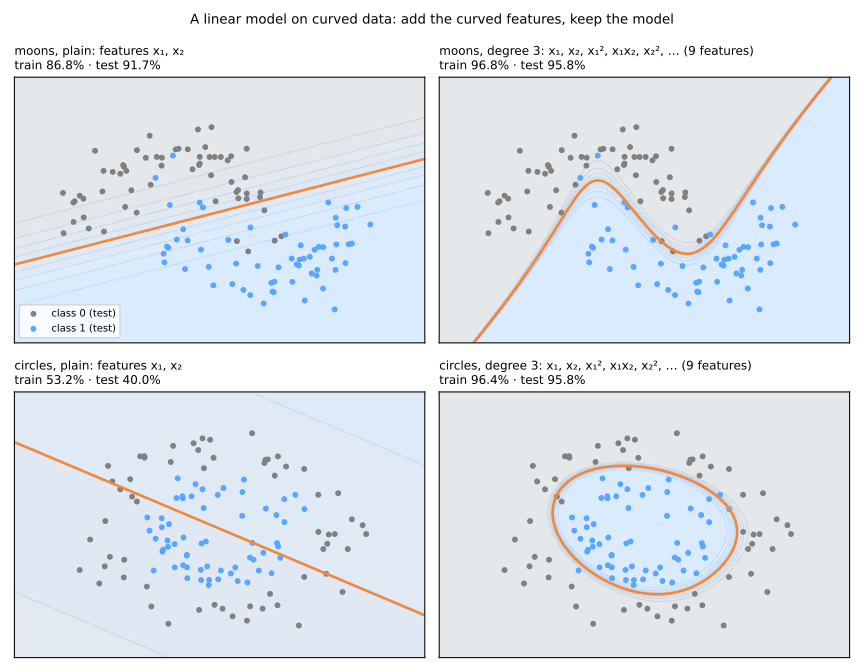
PolynomialFeatures(degree=3): 9 atributos; luas 0,917 → 0,958, círculos 0,400 → 0,958.- Nos círculos, os 2 atributos certos (100%) ganham dos 9 genéricos: conhecer a forma vence.
- Preços: os coeficientes perdem a leitura e mais atributos sobreajustam mais. Escalone depois de expandir.
Multiclasse: softmax
\(k\) classes, um escore por classe, \(z_c = w_c^\top x + b_c\); o softmax os transforma em probabilidades que somam 1:
\[ \hat{p}_c = \frac{e^{z_c}}{\sum_{j=1}^{k} e^{z_j}} \]| classe | \(z_c\) | \(e^{z_c}\) | \(\hat p_c = e^{z_c}/11{,}212\) |
|---|---|---|---|
| A | 2,0 | 7,389 | 0,659 |
| B | 1,0 | 2,718 | 0,242 |
| C | 0,1 | 1,105 | 0,099 |
| soma | 11,212 | 1,000 |
- Um vetor de pesos e um intercepto por classe.
- Uma diferença de 1 no escore é um fator \(e \approx 2{,}7\) na probabilidade.
- Com duas classes, o softmax é a sigmoide: \(\sigma(z_1 - z_0)\).
No wine: um quase empate
178 vinhos, 3 cultivares; dois atributos, teor alcoólico e flavonoides.
| vinho | cultivar verdadeira | escores | probabilidades | predict |
|---|---|---|---|---|
| 0 | 0 | 6,47; −0,22; −6,25 | 0,999; 0,001; 0 | 0 |
| 100 | 1 | −0,29; 5,32; −5,02 | 0,004; 0,996; 0 | 1 |
| 133 | 2 | −3,11; 1,56; 1,55 | 0,005; 0,502; 0,493 | 1 ✗ |
Perfil prático
pontos fortes
- rápida; convexa: a mesma resposta sempre
- probabilidades razoáveis
- interpretável pelas razões de chances
- uma baseline forte
fraquezas
- fronteira linear
- interações acrescentadas à mão
- lenta com atributos sem escala
- coeficientes correlacionados instáveis de ler
max_iter costumam indicar atributos sem escala. Colunas one-hot para todas as categorias ao lado de um intercepto deixam cada coeficiente sem sentido: descarte uma categoria de referência. Razão de chances não é razão de probabilidades.Resumo
- Com a sigmoide, o erro quadrático limita o preço do erro, apaga o empurrão nos piores casos e tem platôs; a entropia cruzada é convexa.
- O modelo é linear nos seus atributos: atributos ao quadrado ou polinomiais desenham fronteiras curvas.
- Conhecer a forma vale mais que gerar muitos atributos; escalone depois de expandir.
- Softmax: um escore por classe, probabilidades que somam 1; com duas classes, é a sigmoide.
- Recorra a ela quando precisar de uma baseline sólida e explicável, com probabilidades às quais vale aplicar um limiar.
Razões de chances e o único teste, passos 7 e 8
- Mesmo notebook, mesma sessão: os passos usam
model,w,names,passengers,dummye os conjuntos de treino e de teste. - Leia cada coeficiente como razão de chances contra a sua categoria de referência; depois toque o teste uma vez e mexa no limiar nas linhas de treino.
- Notebook no Colab, a partir do passo 7.
- Simulações: a razão de chances é a mesma para todo mundo (passo 7) e mexendo no limiar (passo 8).
Ritmo: passo 7 e a sua simulação em 12 min; passo 8 e a sua simulação em 10 min.