De números a categorias
| classes | exemplos | |
|---|---|---|
| binária | 2, codificadas 0 e 1 | aprovado/reprovado, fraude/legítimo, maligno/benigno, sobreviveu/morreu |
| multiclasse | \(k > 2\) | espécies de íris, dígito 0–9, categoria de produto |
passo 1: uma probabilidade
"este passageiro sobrevive com probabilidade 0,94"
passo 2: um limiar
"0,94 ≥ 0,5, então: sobreviveu"
O caminho desta parte
- Por que não a retauma reta falha ao classificar
- Escore → probabilidadea sigmoide; a fronteira de decisão é uma reta
- Ler as chancesum coeficiente multiplica a chance
- Perda e treinoentropia cruzada; gradiente descendente, uma iteração à mão
- Probabilidade → rótuloo limiar é uma escolha
Por que não uma reta?
23 estudantes, horas de estudo, aprovado (1) ou reprovado (0). Ajuste uma regressão linear e chame de "aprovado" tudo o que ficar acima de 0,5.
Depois acrescente cinco estudantes que estudaram de 25 a 45 horas e passaram, como qualquer um esperaria.
Pontos corretos prejudicam a reta
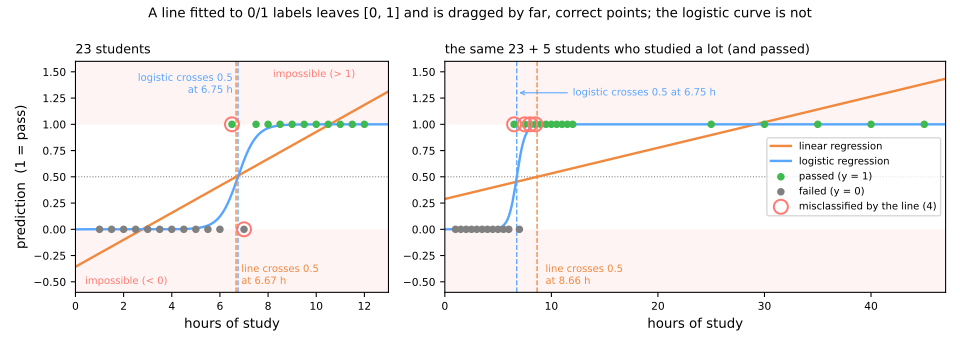
| reta: saídas | reta: cruza 0,5 | reta: erros | logística: cruza 0,5 | logística: erros | |
|---|---|---|---|---|---|
| 23 estudantes | −0,23 a 1,18 | 6,67 h | 2 | 6,75 h | 2 |
| + 5 aprovados distantes | 0,31 a 1,39 | 8,66 h | 4 | 6,75 h | 2 |
Dois problemas, uma cura
a reta sai de [0, 1]
−0,23 para uma hora, 1,18 para doze: não são probabilidades; "quão seguro está o modelo?" fica sem resposta
pontos corretos a puxam
os mínimos quadrados querem a reta perto dos distantes: ela achata e os erros vão de 2 para 4, por causa de dados que concordavam com o modelo
Da reta à probabilidade
Mantenha o escore linear (\(w\): pesos, \(x\): atributos, \(b\): intercepto):
\[ z = w^\top x + b \]e esprema-o com a sigmoide na probabilidade prevista \(\hat p\) da classe 1:
\[ \hat{p} = \sigma(z) = \frac{1}{1 + e^{-z}} \]três valores para memorizar
- \(\sigma(0) = 0{,}5\)
- \(z\) muito positivo → \(\hat p \to 1\)
- \(z\) muito negativo → \(\hat p \to 0\)
classe 1 quando \(\hat p \ge 0{,}5\), o mesmo que \(z \ge 0\)
À mão: três novos estudantes
Ajustado nos 23 estudantes: \(w = 2{,}619\) por hora, \(b = -17{,}681\). Preveja. Quem passa: 4, 6 ou 7,5 horas?
| horas \(x\) | \(z = 2{,}619x - 17{,}681\) | \(e^{-z}\) | \(\hat p = 1/(1+e^{-z})\) | classe |
|---|---|---|---|---|
| 4 | −7,205 | 1346 | 0,001 | 0 (reprova) |
| 6 | −1,967 | 7,149 | 0,123 | 0 (reprova) |
| 7,5 | 1,962 | 0,1406 | 0,877 | 1 (aprova) |
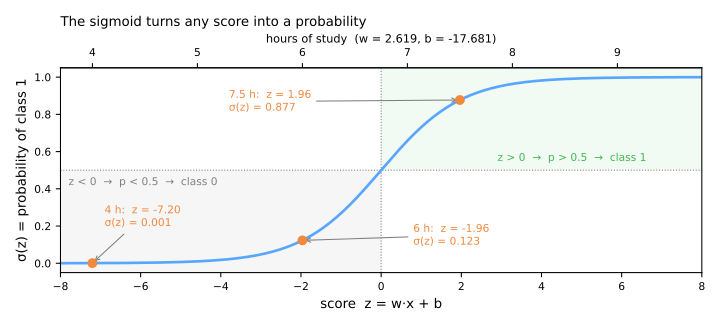
O ponto mais íngreme, \(\hat p = 0{,}5\), fica em \(-b/w = 6{,}75\) horas; um \(w\) maior faz a transição mais abrupta. predict_proba é literalmente sigmoid(decision_function).
A fronteira de decisão é uma reta
Dois atributos: \(z = w_1x_1 + w_2x_2 + b\). Onde \(z = 0\) (probabilidade 0,5) fica uma reta: um classificador linear.
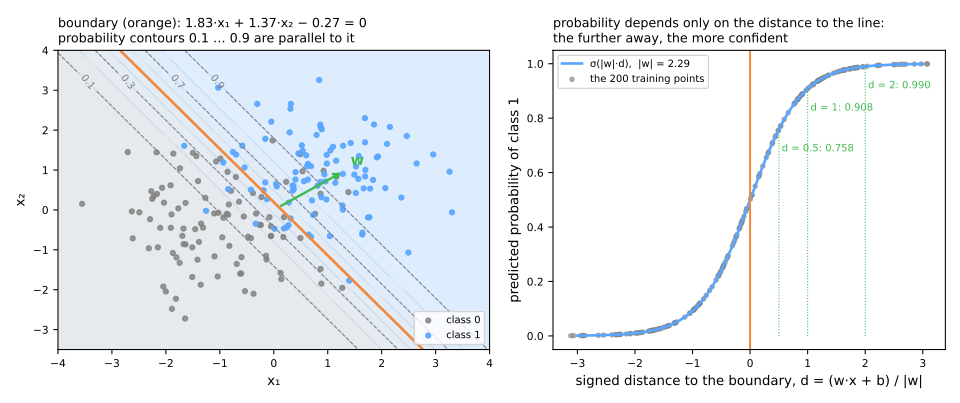
200 pontos: \(w = (1{,}832;\ 1{,}371)\), \(b = -0{,}266\), \(\lVert w\rVert = 2{,}288\).
A probabilidade só depende da distância à reta
Afaste-se da fronteira na direção de \(w\), a partir de dois pontos diferentes dela; \(d\) é a distância com sinal até a reta:
| distância com sinal \(d\) | −1 | 0 | 0,5 | 1 | 2 |
|---|---|---|---|---|---|
| \(\hat p\), de qualquer partida | 0,092 | 0,5 | 0,758 | 0,908 | 0,99 |
- \(w\) é perpendicular à fronteira e aponta para a classe 1.
- As curvas de mesma probabilidade são retas paralelas à fronteira.
- \(\lVert w\rVert = 2{,}29\): a uma unidade da reta, o modelo já tem 90,8% de certeza.
Chances (odds): a linguagem das apostas
| probabilidade \(p\) | chance \(p/(1-p)\) | em palavras |
|---|---|---|
| 0,75 | 3 | "3 para 1": em 4 casos, 3 a favor e 1 contra |
| 0,5 | 1 | "1 para 1": tanto faz |
| 0,2 | 0,25 | "1 para 4": em 5 casos, 1 a favor e 4 contra |
Uma unidade a mais multiplica a chance
Um modelo com \(w = 0{,}8\), \(b = -4\):
| \(x\) | \(z = 0{,}8x - 4\) | \(\hat p = \sigma(z)\) | chance | \(e^{z}\) |
|---|---|---|---|---|
| 4 | −0,8 | 0,310 | 0,449 | 0,449 |
| 5 | 0,0 | 0,500 | 1,000 | 1,000 |
| 6 | +0,8 | 0,690 | 2,226 | 2,226 |
No modelo das horas
\(e^{w} = e^{2{,}619} = 13{,}727\)
| horas | \(\hat p\) | chance |
|---|---|---|
| 5 | 0,01 | 0,01 |
| 6 | 0,123 | 0,14 |
| 7 | 0,658 | 1,925 |
Cada hora a mais multiplica a chance de aprovação por 13,7.
Em probabilidade: +11 pontos de 5 para 6 horas, +54 pontos de 6 para 7.
A perda: entropia cruzada
Máxima verossimilhança: tornar os rótulos observados os mais prováveis possível. Multiplique sobre os \(n\) exemplos, tome logs e troque o sinal:
\[ J(w, b) = -\frac{1}{n} \sum_{i=1}^{n} \Big[ y_i \log \hat{p}_i + (1 - y_i) \log (1 - \hat{p}_i) \Big] \]À mão: quatro previsões
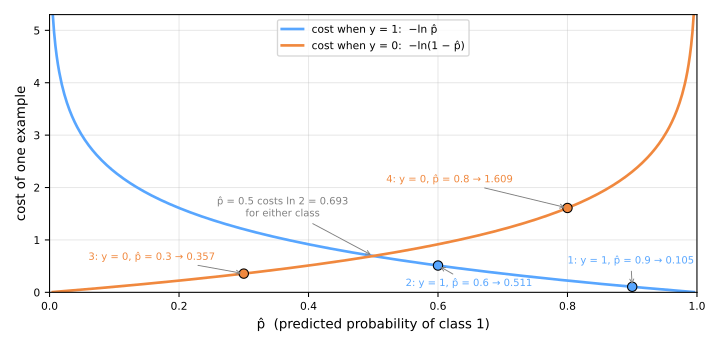
Preveja. Qual das quatro custa mais?
| \(i\) | \(y\) | \(\hat p\) | dada à verdade | \(-\ln(\cdot)\) |
|---|---|---|---|---|
| 1 | 1 | 0,9 | 0,9 | 0,105 |
| 2 | 1 | 0,6 | 0,6 | 0,511 |
| 3 | 0 | 0,3 | 0,7 | 0,357 |
| 4 | 0 | 0,8 | 0,2 | 1,609 |
Média: \((0{,}105 + 0{,}511 + 0{,}357 + 1{,}609)/4 = 0{,}646\). O erro confiante (ponto 4) é 62% do total.
Treino por gradiente descendente
Para um exemplo, a regra da cadeia através de \(\hat p = \sigma(z)\), com \(\sigma'(z) = \hat p(1-\hat p)\), dá \(\partial L/\partial z = \hat p - y\). Em média sobre as \(n\) linhas da matriz de atributos \(X\):
\[ \nabla_w J = \frac{1}{n} X^\top (\hat{p} - y), \qquad \frac{\partial J}{\partial b} = \frac{1}{n}\sum_i (\hat p_i - y_i) \]A mesma forma do gradiente da regressão linear, com \(\hat p = \sigma(Xw + b)\) no lugar de \(Xw\).
- forward: \(\hat p = \sigma(Xw + b)\)
- perda: a entropia cruzada \(J\)
- backward: os gradientes
- atualização: \(w \leftarrow w - \eta\,\nabla_w J\), \(b \leftarrow b - \eta\,\partial J/\partial b\), com taxa de aprendizado \(\eta\)
Uma iteração, à mão
Quatro dos 23 estudantes (4 h reprova, 6,5 h aprova, 7 h reprova, 9 h aprova), palpite \(w = 1\), \(b = -5\), \(\eta = 0{,}1\). Preveja. Qual estudante empurra a curva com mais força e para que lado?
Em 200 pontos: o mesmo fundo do scikit-learn
As mesmas quatro etapas, 2.000 vezes, nos 200 pontos do slide da fronteira, com \(\eta = 0{,}5\) e pesos zero na partida:
| iteração | perda |
|---|---|
| 0 | 0,6931 |
| 10 | 0,3391 |
| 100 | 0,2956 |
| 1000 | 0,2955 |
Das probabilidades aos rótulos: o limiar
| limiar | classe 1 prevista | classe 1 perdida | alarmes falsos | acurácia |
|---|---|---|---|---|
| 0,2 | 131 | 1 | 32 | 0,835 |
| 0,5 | 97 | 12 | 9 | 0,895 |
| 0,8 | 76 | 31 | 7 | 0,810 |
Resumo
- \(\hat p = \sigma(w^\top x + b)\): um escore linear espremido em (0, 1); a fronteira é uma reta.
- \(e^{w_j}\) multiplica a chance por unidade de \(x_j\); a variação em probabilidade depende de onde se parte.
- Entropia cruzada: menos o log da probabilidade dada à verdade.
- Gradiente descendente: forward, perda, backward (\(\hat p - y\)), atualização; começa em \(\ln 2\).
- O limiar é uma escolha: movê-lo troca um erro pelo outro.
Quem sobreviveu ao Titanic? Passos 1 a 6
- 891 passageiros, sete colunas cruas: um pipeline com imputação, one-hot e escalonamento; depois as probabilidades e um passageiro aberto à mão.
- Notebook no Colab: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: o efeito da idade (passo 5) e um atributo por vez (passo 6).
Ritmo: passos 1 a 4 em 20 min; passos 5 e 6, com as suas simulações, em 15 min.