De números a categorias
| classes | exemplos | |
|---|---|---|
| binária | 2, codificadas 0 e 1 | aprovado/reprovado, fraude/legítimo, maligno/benigno, sobreviveu/morreu |
| multiclasse | \(k > 2\) | espécies de íris, dígito 0–9, categoria de produto |
passo 1: uma probabilidade
"este passageiro sobrevive com probabilidade 0,94"
passo 2: um limiar
"0,94 ≥ 0,5, então: sobreviveu"
O caminho desta aula
- Por que não a retauma reta falha ao classificar
- Escore → probabilidadesigmoide, fronteira de decisão, chances (odds)
- Perda e treinoentropia cruzada, não erro quadrático; gradiente descendente
- Além da retafronteiras curvas; muitas classes com softmax
- Probabilidade → rótuloo limiar é uma escolha; quando usar o modelo
Por que não uma reta?
23 estudantes, horas de estudo, aprovado (1) ou reprovado (0). Ajuste uma regressão linear e chame de "aprovado" tudo o que ficar acima de 0,5.
Depois acrescente cinco estudantes que estudaram de 25 a 45 horas e passaram, como qualquer um esperaria.
Pontos corretos prejudicam a reta
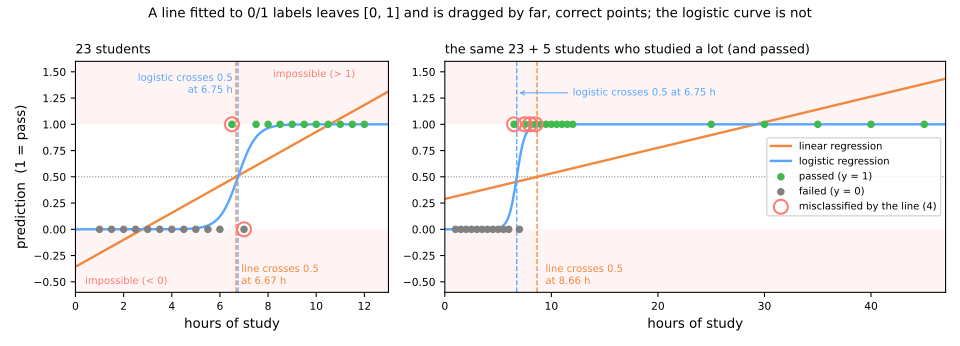
| reta: saídas | reta: cruza 0,5 | reta: erros | logística: cruza 0,5 | logística: erros | |
|---|---|---|---|---|---|
| 23 estudantes | −0,23 a 1,18 | 6,67 h | 2 | 6,75 h | 2 |
| + 5 aprovados distantes | 0,31 a 1,39 | 8,66 h | 4 | 6,75 h | 2 |
Dois problemas, uma cura
a reta sai de [0, 1]
−0,23 para uma hora, 1,18 para doze: não são probabilidades; "quão seguro está o modelo?" fica sem resposta
pontos corretos a puxam
os mínimos quadrados querem a reta perto dos distantes: ela achata e os erros vão de 2 para 4, por causa de dados que concordavam com o modelo
Da reta à probabilidade
Mantenha o escore linear:
\[ z = w^\top x + b \]e esprema-o com a sigmoide:
\[ \hat{p} = \sigma(z) = \frac{1}{1 + e^{-z}} \]três valores para memorizar
- \(\sigma(0) = 0{,}5\)
- \(z\) muito positivo → \(\hat p \to 1\)
- \(z\) muito negativo → \(\hat p \to 0\)
classe 1 quando \(\hat p \ge 0{,}5\), o mesmo que \(z \ge 0\)
À mão: três novos estudantes
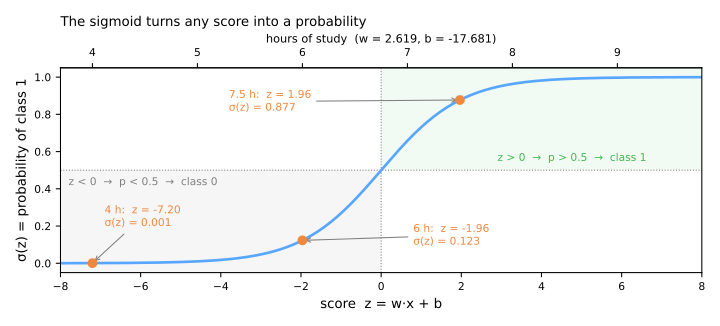
Ajustado nos 23 estudantes: \(w = 2{,}619\) por hora, \(b = -17{,}681\).
| horas \(x\) | \(z = 2{,}619x - 17{,}681\) | \(e^{-z}\) | \(\hat p = 1/(1+e^{-z})\) | classe |
|---|---|---|---|---|
| 4 | −7,205 | 1346 | 0,001 | 0 (reprova) |
| 6 | −1,967 | 7,149 | 0,123 | 0 (reprova) |
| 7,5 | 1,962 | 0,1406 | 0,877 | 1 (passa) |
Uma calculadora basta. No scikit-learn, predict_proba é literalmente sigmoid(decision_function).
A sigmoide, lida em horas
A fronteira de decisão é uma reta
Dois atributos: \(z = w_1x_1 + w_2x_2 + b\). Onde \(z = 0\) (probabilidade 0,5) é uma reta: um classificador linear.
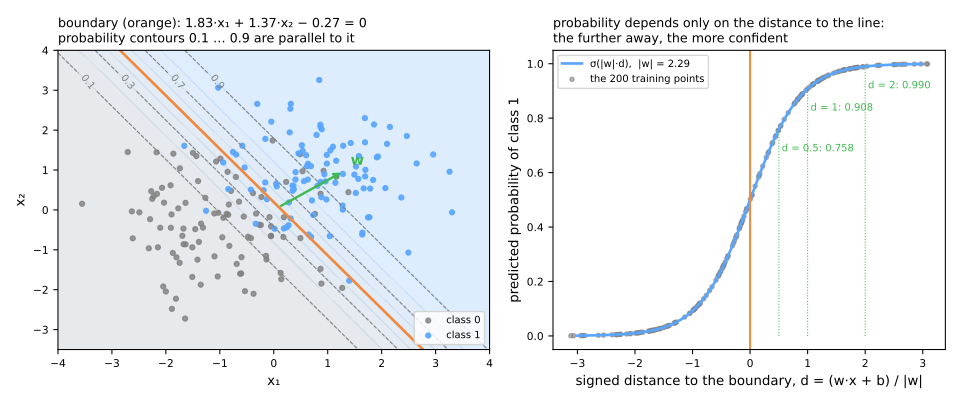
200 pontos: \(w = (1{,}832;\ 1{,}371)\), \(b = -0{,}266\), \(\lVert w\rVert = 2{,}288\).
A probabilidade só depende da distância à reta
Afaste-se da fronteira na direção de \(w\), partindo de dois pontos diferentes dela:
| distância com sinal \(d\) | −1 | 0 | 0,5 | 1 | 2 |
|---|---|---|---|---|---|
| \(\hat p\), de qualquer partida | 0,092 | 0,5 | 0,758 | 0,908 | 0,99 |
- \(w\) é perpendicular à fronteira e aponta para a classe 1.
- As curvas de mesma probabilidade são retas paralelas à fronteira.
- \(\lVert w\rVert = 2{,}29\): a uma unidade da reta o modelo já tem 90,8% de certeza.
Chances (odds): a linguagem das apostas
| probabilidade \(p\) | chance \(p/(1-p)\) | em palavras |
|---|---|---|
| 0,75 | 3 | "3 para 1": em 4 casos, 3 a favor e 1 contra |
| 0,5 | 1 | "1 para 1": tanto faz |
| 0,2 | 0,25 | "1 para 4": em 5 casos, 1 a favor e 4 contra |
Uma unidade a mais multiplica a chance
Um modelo com \(w = 0{,}8\), \(b = -4\):
| \(x\) | \(z = 0{,}8x - 4\) | \(\hat p = \sigma(z)\) | chance | \(e^{z}\) |
|---|---|---|---|---|
| 4 | −0,8 | 0,310 | 0,449 | 0,449 |
| 5 | 0,0 | 0,500 | 1,000 | 1,000 |
| 6 | +0,8 | 0,690 | 2,226 | 2,226 |
No modelo das horas
\(e^{w} = 13{,}727\)
| horas | \(\hat p\) | chance |
|---|---|---|
| 5 | 0,01 | 0,01 |
| 6 | 0,123 | 0,14 |
| 7 | 0,658 | 1,925 |
Cada hora a mais multiplica a chance de aprovação por 13,7.
Em probabilidade: +11 pontos de 5 para 6 horas, +54 pontos de 6 para 7.
A perda: entropia cruzada
Máxima verossimilhança: tornar os rótulos observados os mais prováveis possível. Tome logs e troque o sinal:
\[ J(w, b) = -\frac{1}{n} \sum_{i=1}^{n} \Big[ y_i \log \hat{p}_i + (1 - y_i) \log (1 - \hat{p}_i) \Big] \]À mão: quatro previsões
| \(i\) | \(y\) | \(\hat p\) | probabilidade dada à verdade | \(-\ln(\cdot)\) |
|---|---|---|---|---|
| 1 | 1 | 0,9 | 0,9 | 0,105 |
| 2 | 1 | 0,6 | 0,6 | 0,511 |
| 3 | 0 | 0,3 | 0,7 | 0,357 |
| 4 | 0 | 0,8 | 0,2 | 1,609 |
Média: \((0{,}105 + 0{,}511 + 0{,}357 + 1{,}609)/4 = 0{,}646\). O erro confiante (ponto 4) é 62% do total.
Referências: dizer sempre 0,5 custa \(\ln 2 = 0{,}693\); um modelo perfeito custa 0.
Cada classe tem a sua curva
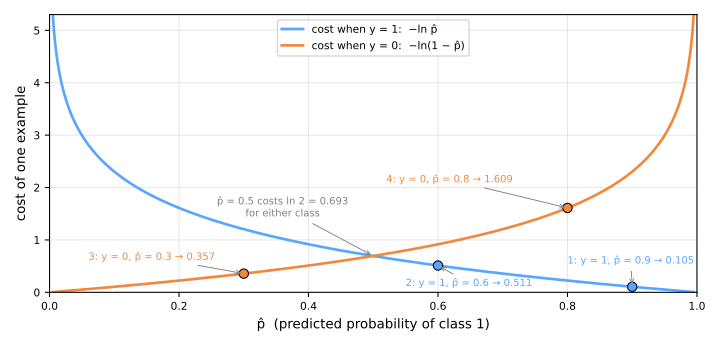
Cada curva é 0 na ponta correta e cresce sem limite na ponta errada: de 0,8 para 0,99 na classe errada, o ponto 4 vai de 1,609 para 4,6.
Por que não o erro quadrático?
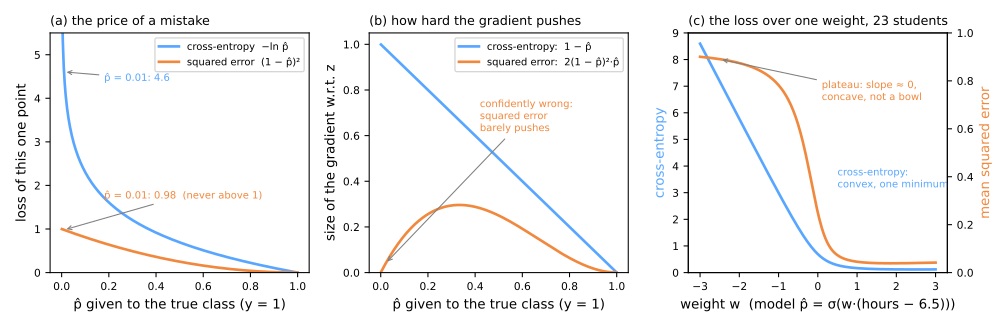
(a) o preço
o erro quadrático nunca passa de 1: \(\hat p = 0{,}1\) e \(0{,}001\) custam 0,810 e 0,998
(b) o empurrão
quanto pior o erro, mais fraco o gradiente do erro quadrático
(c) a forma
a entropia cruzada é convexa; o erro quadrático tem um platô
(b) O empurrão do gradiente
\[ \frac{\partial L}{\partial z} = \frac{\partial L}{\partial \hat p} \cdot \underbrace{\hat p\,(1 - \hat p)}_{\text{inclinação da sigmoide}} \qquad \text{entropia cruzada: } \frac{\partial L}{\partial z} = \hat p - y \]| \(\hat p\) dado à classe verdadeira | inclinação da sigmoide | erro quadrático | entropia cruzada |
|---|---|---|---|
| 0,5 | 0,25 | −0,250 | −0,500 |
| 0,1 | 0,09 | −0,162 | −0,900 |
| 0,01 | 0,0099 | −0,0196 | −0,990 |
| 0,001 | 0,001 | −0,0020 | −0,999 |
(c) A forma da perda
Um só peso, \(\hat p = \sigma(w\,(\text{horas} - 6{,}5))\), nos 23 estudantes. \(w < 0\) aposta que quem estuda mais reprova.
| \(w\) | −3 | −1 | 0 | +1 | +3 |
|---|---|---|---|---|---|
| erro quadrático | 0,900 | 0,782 | 0,250 | 0,045 | 0,042 |
| entropia cruzada | 8,597 | 2,992 | 0,693 | 0,166 | 0,118 |
Simulador: as duas perdas lado a lado
Preveja. Gire \(w\) para o lado errado. Qual perda percebe que algo está muito errado?
Treino por gradiente descendente
\[ \nabla_w J = \frac{1}{n} X^\top (\hat{p} - y), \qquad \frac{\partial J}{\partial b} = \frac{1}{n}\sum_i (\hat p_i - y_i) \]A mesma forma do gradiente da regressão linear, com \(\hat p = \sigma(Xw + b)\) no lugar de \(Xw\).
- forward: \(\hat p = \sigma(Xw + b)\)
- perda: a entropia cruzada \(J\)
- backward: os gradientes
- atualização: \(w \leftarrow w - \eta\,\nabla_w J\)
| iteração | perda |
|---|---|
| 0 | 0,6931 |
| 10 | 0,3391 |
| 100 | 0,2956 |
| 1000 | 0,2955 |
Os pesos terminam a menos de 0,0005 dos do scikit-learn (1,8317; 1,3713): uma função convexa tem um só fundo. Os quatro nomes voltam nas redes neurais.
Fronteiras curvas: construa os atributos
Os círculos: uma classe dentro, a outra em volta. Qualquer reta deixa pedaços do círculo de fora dos dois lados.
| atributos | acurácia no teste |
|---|---|
| \(x_1, x_2\) | 0,400 |
| \(x_1^2, x_2^2\) | 1,000 |
\(w = (-16{,}83;\ -16{,}00)\), \(b = 9{,}70\): um círculo de raio \(\approx 0{,}77\), entre o círculo de dentro (0,5) e o de fora (1).
Quando a forma não é óbvia
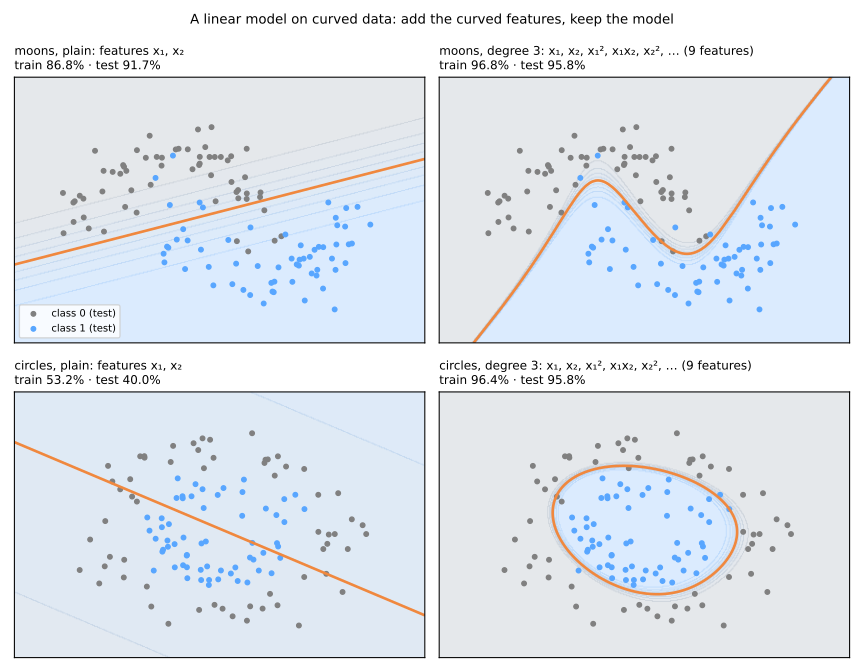
PolynomialFeatures(degree=3): 9 atributos; luas 0,917 → 0,958, círculos 0,400 → 0,958.- Nos círculos, os 2 atributos certos (100%) ganham de 9 genéricos: conhecer a forma vence.
- Os preços: os coeficientes perdem a leitura e mais atributos sobreajustam mais. Escalone depois de expandir.
Multiclasse: softmax
\[ \hat{p}_c = \frac{e^{z_c}}{\sum_{j=1}^{k} e^{z_j}} \]| classe | \(z_c\) | \(e^{z_c}\) | \(\hat p_c\) |
|---|---|---|---|
| A | 2,0 | 7,389 | 0,659 |
| B | 1,0 | 2,718 | 0,242 |
| C | 0,1 | 1,105 | 0,099 |
| soma | 11,212 | 1,000 |
- Um vetor de pesos e um intercepto por classe.
- Uma diferença de 1 no escore é um fator \(e \approx 2{,}7\) na probabilidade.
- Com duas classes, a softmax é a sigmoide.
No wine: um quase empate
178 vinhos, 3 cultivares; dois atributos, álcool e flavonoides.
| vinho | cultivar verdadeiro | escores | probabilidades | predict |
|---|---|---|---|---|
| 0 | 0 | 6,47; −0,22; −6,25 | 0,999; 0,001; 0 | 0 |
| 100 | 1 | −0,29; 5,32; −5,02 | 0,004; 0,996; 0 | 1 |
| 133 | 2 | −3,11; 1,56; 1,55 | 0,005; 0,502; 0,493 | 1 ✗ |
Das probabilidades aos rótulos: o limiar
| limiar | classe 1 prevista | classe 1 perdida | alarmes falsos | acurácia |
|---|---|---|---|---|
| 0,2 | 131 | 1 | 32 | 0,835 |
| 0,5 | 97 | 12 | 9 | 0,895 |
| 0,8 | 76 | 31 | 7 | 0,810 |
Perfil prático
pontos fortes
- rápida; convexa: a mesma resposta sempre
- probabilidades razoáveis
- interpretável pelas razões de chances
- uma baseline forte
pontos fracos
- fronteira linear
- interações acrescentadas à mão
- lenta com atributos sem escala
- coeficientes correlacionados instáveis de ler
max_iter costumam indicar atributos sem escala. Razão de chances não é razão de probabilidades.Resumo
- \(\hat p = \sigma(w^\top x + b)\): um escore linear espremido em (0, 1); a fronteira é uma reta.
- \(e^{w_j}\) multiplica a chance por unidade de \(x_j\).
- Entropia cruzada: menos o log da probabilidade dada à verdade; convexa.
- Gradiente \(\frac{1}{n}X^\top(\hat p - y)\): forward, perda, backward, atualização.
- Curvas pedem atributos; softmax para \(k\) classes; o limiar é uma escolha.
Prevendo a sobrevivência no Titanic
- Abra o notebook no Colab e salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: o efeito da idade (passo 5), um atributo por vez (passo 6), a razão de chances é a mesma para todo mundo (passo 7), mexendo no limiar (passo 8).
- Compare com a saída e a leitura na página da aula.
Ritmo: passos 1 a 4 em 20 min; passos 5 a 7 em 25 min; passo 8 e o fechamento em 15 min.