O panorama de ML
Antes de mergulhar nos algoritmos, precisamos de um mapa: que tipos de aprendizado existem, como é um projeto de ML real de ponta a ponta e o que significa um modelo generalizar.
Esta aula desenha esse mapa quase sem algoritmos. Os modelos que aparecem — polinômios, uma tabela de consulta, uma reta, vizinhos mais próximos, uma pequena árvore — são usados como caixas-pretas; cada um tem a sua aula mais adiante. O que importa aqui é o que eles mostram: um erro medido nos dados de treino diz pouco, nenhum modelo vence em todo problema e um modelo aprende o que os seus dados contêm, inclusive os erros do passado. Todo número citado vem dos blocos de código ou dos scripts das figuras que ficam ao lado desta página.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Que tipo de aprendizado é um problema, que passos um projeto percorre e como saber se um modelo funciona em dados que nunca viu? | Como um desejo vira um problema de ML, por que nenhum modelo vence em tudo e o que dá errado quando as decisões de um modelo chegam às pessoas? |
| conteúdo | aprendizado supervisionado, não supervisionado e por reforço; regressão e classificação; os seis passos do ciclo de um projeto; erro de treino e erro em dados novos; subajuste e sobreajuste; a regra de ouro | formular um problema (alvo, momento, métrica, baseline), a perda esperada, sem almoço grátis, viés nos dados e variáveis substitutas, justiça, privacidade, transparência, ciclos de retroalimentação |
| lab em aula | a forma do erro, passos 1 a 4 | sem almoço grátis, um passado enviesado e um ciclo que se alimenta, passos 5 a 7 |
| ao final, você sabe | dizer o paradigma e a tarefa de um problema pelos seus dados; situar uma tarefa no ciclo do projeto; distinguir subajuste de sobreajuste pelos dois erros; explicar por que um modelo nunca é julgado nos seus dados de treino | formular um problema antes de tocar nos dados; explicar por que o curso compara várias famílias; reconhecer uma variável substituta que carrega um viés; reconhecer um modelo que escreve os próprios dados de treino |
Os dois labs rodam a partir desta página: não há notebook para baixar. Abra um notebook em branco no Colab (ele já tem NumPy, pandas e scikit-learn), cole cada bloco de código numa célula própria e rode-as em ordem: a parte fundamental vai do passo 1 ao 4; a avançada, do 5 ao 7.
Abordagem fundamental
Uma pergunta guia esta parte: diante de um problema, que tipo de aprendizado ele é, que passos o projeto vai percorrer e como você vai saber se o modelo funciona em dados que nunca viu? As duas primeiras respostas são um vocabulário e um ciclo; a terceira é o problema central do curso inteiro, e o lab o mede com números.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. tipos de aprendizado, separados pelo feedback que o aprendiz recebe; 2. o ciclo do projeto, os passos de um projeto real da pergunta ao modelo em produção; 3. generalização, o que torna um modelo bom em dados que ele nunca viu. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Tipos de aprendizadosupervisionado, não supervisionado, por reforço: pelo feedback
- O ciclo do projetoformular, obter dados, preparar, treinar, avaliar, implantar: um ciclo
- Generalizaçãotreino e dados novos; subajuste e sobreajuste
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Paradigmas de aprendizado
Etapa 1. Os problemas de machine learning são classificados pelo tipo de feedback disponível ao aprendiz.
Aprendizado supervisionado
O conjunto de dados contém entradas \(x\) e as saídas desejadas \(y\) (rótulos). O objetivo é aprender uma função \(f\) tal que \(f(x) \approx y\) em dados novos.
- Regressão — \(y\) é contínuo: prever preços de imóveis, demanda de energia, o tempo de internação de um paciente (as aulas de regressão).
- Classificação — \(y\) é categórico: spam/não spam, tumor benigno/maligno, qual dígito está na imagem (as aulas de classificação, árvores e ensembles).
Aprendizado não supervisionado
Apenas as entradas \(x\) — sem rótulos. O objetivo é descobrir estrutura:
- Agrupamento — agrupar observações semelhantes, como segmentos de clientes (Agrupamento);
- Redução de dimensionalidade — comprimir muitos atributos em poucos informativos (PCA, t-SNE, UMAP);
- Modelagem de tópicos — descobrir temas em uma coleção de documentos (BERTopic).
Aprendizado por reforço
Um agente interage com um ambiente, recebe recompensas e aprende uma política que maximiza a recompensa de longo prazo — o paradigma por trás de sistemas que jogam (AlphaGo) e do controle robótico. Está fora do escopo deste curso, mas você deve reconhecê-lo no mapa.
No meio-termo
Projetos reais frequentemente misturam paradigmas: aprendizado semissupervisionado (poucos rótulos, muitos exemplos não rotulados), aprendizado autossupervisionado (rótulos fabricados a partir dos próprios dados — como os modelos de fundação são pré-treinados) e supervisão fraca (rótulos ruidosos e programáticos).
2. O fluxo de trabalho de ML
Etapa 2. Um modelo é uma pequena parte de um processo maior e iterativo. Este curso é organizado em torno deste ciclo:
Duas verdades práticas sobre este diagrama:
- A maior parte do trabalho está nos passos 2–3. É comum profissionais relatarem que passam a maior parte do tempo entendendo e preparando dados, não ajustando modelos.
- O ciclo nunca termina. Modelos implantados se degradam conforme o mundo muda (drift); monitorar e retreinar fazem parte do trabalho, não são um detalhe para depois.
A primeira caixa, formular o problema, parece a mais fácil e é onde um projeto mais vezes se condena sem que ninguém perceba; a abordagem avançada lhe dá uma seção própria.
3. Generalização: o problema central
Etapa 3. Um modelo que memoriza perfeitamente os dados de treino ainda pode ser inútil. O que importa é o desempenho em dados que ele nunca viu.
- Subajuste (underfitting): o modelo é simples demais para capturar o padrão — desempenho ruim mesmo nos dados de treino.
- Sobreajuste (overfitting): o modelo captura ruído como se fosse sinal — excelente nos dados de treino, ruim em dados novos.
Três modelos, a olho
A figura mostra as duas falhas e o equilíbrio entre elas nos dados do lab fundamental: 15 pontos de treino sorteados em torno de uma curva suave (tracejada) e 1.000 pontos novos do mesmo processo, que os modelos nunca veem. Cada painel ajusta um polinômio aos 15 pontos; o erro embaixo dele é o erro quadrático médio (MSE, mean squared error), a média dos quadrados das distâncias verticais entre os pontos e a curva (script da figura):
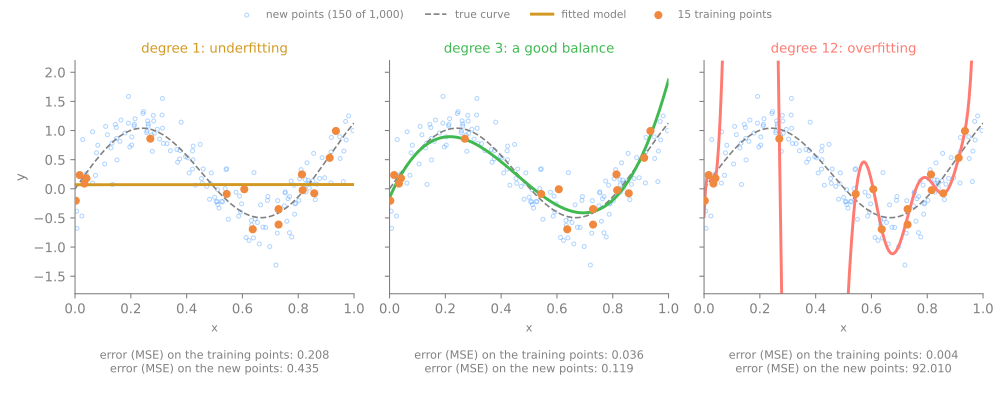
Leia os erros de treino da esquerda para a direita: 0,208, 0,036, 0,004, sempre caindo. Os erros nos pontos novos contam outra história: 0,435, 0,119 e depois 92,010. A curva de grau 12 é a melhor nos pontos que viu e de longe a pior nos que não viu.
Experimente: o simulador de generalização
No simulador abaixo, mova o grau do polinômio de 1 a 15 e observe os dois erros: onde o modelo está em subajuste e onde ele começa a sobreajustar? Depois aperte mais dados e suba o grau de novo.
O erro de treino só cai à medida que o modelo fica mais flexível; é o erro de teste que diz quando ele começou a decorar o ruído. Com mais dados o mesmo modelo flexível tem bem menos espaço para sobreajustar.
A regra de ouro
No lab e no simulador, os "pontos novos" vêm de um gerador que nós escrevemos, então dá para sortear quantos quisermos. Um projeto real não tem esse gerador: o único dado que pode fazer o papel do futuro é o que você separa e nunca usa no treino. Tudo nas aulas de regularização, validação cruzada e seleção de modelos — divisões treino/teste, validação cruzada, regularização, o trade-off viés–variância — existe para gerenciar essa tensão. Por ora, guarde uma regra:
A regra de ouro
Nunca avalie um modelo com dados em que ele foi treinado. Os dados de teste devem simular o futuro: nunca vistos, intocados, usados uma única vez.
4. Resumo: o mapa em cinco linhas
- Os paradigmas se separam pelo feedback: rótulos (supervisionado), nenhum (não supervisionado), recompensas (por reforço).
- No aprendizado supervisionado o tipo do \(y\) dá nome à tarefa: um número é regressão; uma categoria, classificação.
- Um projeto é um ciclo — formular, obter dados, preparar, treinar, avaliar, implantar — e a maior parte do trabalho está nos dados.
- Leia dois erros, nunca um: os dois altos é subajuste; treino baixo e dados novos alto é sobreajuste.
- O erro de treino não julga um modelo: só dados que o modelo nunca viu julgam, e é por isso que o conjunto de teste fica trancado.
| o que você vê | o que está acontecendo | o que fazer |
|---|---|---|
| erros de treino e em dados novos ambos altos e próximos | subajuste: o modelo é simples demais | um modelo mais flexível, atributos melhores |
| erro de treino minúsculo, erro em dados novos muito maior | sobreajuste: ele decorou o ruído | um modelo mais simples, mais dados |
| uma nota perto de 100% medida nas linhas de treino | nada ainda: isso não é evidência | medir em dados que o modelo nunca viu |
| um modelo em produção piorando aos poucos | drift: o mundo mudou | monitorar e retreinar |
Lab fundamental — a forma do erro
O problema. Você vai construir um pequeno mundo em que conhece a verdade: pontos sorteados em torno de uma curva suave, mais ruído. Nele dá para fazer algo que um projeto real nunca pode, sortear quantos pontos novos do futuro quiser, e assim ver o que costuma ficar escondido: como um modelo se sai em dados que nunca viu. Depois você vai ajustar modelos cada vez mais flexíveis e encontrar, com números, o subajuste, o sobreajuste e o equilíbrio da figura da seção 3.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Abra um notebook em branco no Colab (Arquivo → Novo notebook). Não é preciso baixar nem instalar nada: o Colab roda no navegador e já tem NumPy e scikit-learn. Cole cada bloco de código desta página numa célula própria e rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 4. O lab avançado continua no mesmo notebook, a partir do passo 5.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 e 2 em 8 min; passo 3 e a primeira simulação em 10 min; passo 4 e a segunda simulação em 12 min.
Passo 1 — um mundo que você controla
Preveja. Os pontos são a curva mais um ruído de desvio-padrão 0,3. Um modelo perfeito, que encontrasse a curva exata, conseguiria levar a zero o erro nos pontos novos? Por quê?
import numpy as np

def true_curve(x):
    return 0.9 * np.sin(2.2 * np.pi * x) + 0.6 * x

def draw(n, seed):
    rng = np.random.default_rng(seed)
    x = rng.uniform(0, 1, n)
    y = true_curve(x) + rng.normal(0, 0.3, n)        # a curva mais ruído
    return x, y

x_train, y_train = draw(15, seed=0)                  # o que o modelo usa para aprender
x_new, y_new = draw(1000, seed=1)                    # o futuro: nunca mostrado ao modelo
print(len(x_train), 'training points ·', len(x_new), 'new points')
print('first three training points:', ', '.join(f'({a:.2f}, {b:.2f})' for a, b in zip(x_train[:3], y_train[:3])))
print('noise variance, the floor of the error on new points:', 0.3 ** 2)
15 training points · 1000 new points
first three training points: (0.64, -0.69), (0.27, 0.86), (0.04, 0.18)
noise variance, the floor of the error on new points: 0.09
Quinze pontos para aprender e mil para julgar. O ruído faz parte de cada ponto novo e nenhum modelo consegue prevê-lo: até a própria curva verdadeira erraria cada ponto novo pelo ruído, e o seu erro quadrático médio seria a variância do ruído, \(0{,}3^2 = 0{,}09\). Esse é o piso, a linha verde "nível do ruído" do simulador da seção 3. Num projeto real ninguém lhe entrega a draw; aqui ela deixa ver diretamente o erro no futuro.
Passo 2 — três modelos, a olho
Preveja. Polinômios de grau 1, 3 e 12 são ajustados aos mesmos 15 pontos. Ordene-os pelo erro de treino. A ordem pelo erro nos pontos novos será a mesma?
from numpy.polynomial import Polynomial

def mse(model, x, y):
    return np.mean((y - model(x)) ** 2)              # erro quadrático médio

for degree in [1, 3, 12]:
    model = Polynomial.fit(x_train, y_train, degree)
    print(f"degree {degree:2d}: train {mse(model, x_train, y_train):.3f} · new {mse(model, x_new, y_new):.3f}")
degree  1: train 0.208 · new 0.435
degree  3: train 0.036 · new 0.119
degree 12: train 0.004 · new 92.010
São os três painéis da figura da seção 3. Pelo erro de treino a ordem é 12, 3, 1: quanto mais flexível, melhor. Pelo erro nos pontos novos é 3, 1, 12, e o polinômio de grau 12 não é um pouco pior, é 92,010 contra 0,119. As duas ordens discordam, e só a segunda descreve o que o modelo vai fazer em produção.
Passo 3 — a curva inteira
Preveja. Agora todos os graus de 0 a 14. Antes de rodar, esboce os dois erros em função do grau. Qual deles só cai? Onde o outro tem o seu mínimo?
print('degree   train            new')
for degree in range(15):
    model = Polynomial.fit(x_train, y_train, degree)
    print(f"{degree:6d} {mse(model, x_train, y_train):7.3f} {mse(model, x_new, y_new):14,.3f}")
degree   train            new
     0   0.208          0.434
     1   0.208          0.435
     2   0.173          0.514
     3   0.036          0.119
     4   0.036          0.118
     5   0.035          0.111
     6   0.035          0.107
     7   0.028          0.514
     8   0.028          0.513
     9   0.023          1.765
    10   0.007         25.078
    11   0.006         83.926
    12   0.004         92.010
    13   0.002     79,229.911
    14   0.000 455,507,179.027
A coluna de treino nunca sobe: cada grau a mais só pode dobrar a curva para mais perto dos 15 pontos, e no grau 14 há 15 coeficientes para 15 pontos, então a curva passa por todos eles e o erro de treino é 0,000. A coluna dos dados novos tem a forma de U do simulador. Os graus 0 a 2 estão em subajuste (de 0,43 a 0,51, os dois erros altos); os graus 3 a 6 ficam entre 0,107 e 0,119, perto do piso de 0,09; do grau 7 em diante o sobreajuste toma conta e, no grau 14, a curva oscila tanto entre os pontos de treino que o seu erro nos novos chega às centenas de milhões. O grau 0, uma reta horizontal na média do treino, é o modelo mais simples de todos: é o baseline que qualquer modelo precisa superar.
Simulação: mais dados. Sorteie 100 pontos de treino em vez de 15 (draw(100, seed=0), com os mesmos x_new e y_new) e reajuste os graus 1, 3, 5, 8, 12 e 14. O polinômio de grau 14 ainda explode nos pontos novos?
Solução
x_big, y_big = draw(100, seed=0)
for degree in [1, 3, 5, 8, 12, 14]:
    model = Polynomial.fit(x_big, y_big, degree)
    print(f"degree {degree:2d}, 100 points: train {mse(model, x_big, y_big):.3f} · new {mse(model, x_new, y_new):.3f}")
degree  1, 100 points: train 0.392 · new 0.327
degree  3, 100 points: train 0.092 · new 0.114
degree  5, 100 points: train 0.079 · new 0.104
degree  8, 100 points: train 0.076 · new 0.109
degree 12, 100 points: train 0.075 · new 0.111
degree 14, 100 points: train 0.074 · new 0.114
Com 100 pontos o polinômio de grau 14 faz 0,114 nos pontos novos, o mesmo que o grau 3, em vez de 455 milhões. Os seus 15 coeficientes já não conseguem passar por todos os pontos, então ele precisa seguir a tendência, e o ruído de cem pontos em boa parte se compensa. Repare também que os erros de treino agora estão perto do piso de 0,09 e perto dos erros nos dados novos: com tantos dados, o erro de treino para de mentir. "Flexível demais" é sempre relativo a quantos dados você tem.
Passo 4 — um modelo que decora
Preveja. O "modelo" mais simples possível guarda os pontos de treino e responde, para qualquer \(x\), o \(y\) do ponto de treino mais próximo. Qual será o seu erro de treino? Nos pontos novos, ele vai superar o polinômio de grau 3?
def memorizer(x_seen, y_seen):
    def model(x):
        nearest = np.abs(x[:, None] - x_seen[None, :]).argmin(axis=1)    # índice do x visto mais próximo
        return y_seen[nearest]
    return model

memo = memorizer(x_train, y_train)
cubic = Polynomial.fit(x_train, y_train, 3)
print(f"memorizer: train {mse(memo, x_train, y_train):.3f} · new {mse(memo, x_new, y_new):.3f}")
print(f"degree 3:  train {mse(cubic, x_train, y_train):.3f} · new {mse(cubic, x_new, y_new):.3f}")
Nos seus pontos de treino o decorador é perfeito por construção: o ponto de treino mais próximo de um ponto de treino é ele mesmo. Nos pontos novos ele faz 0,175, pior que o polinômio de grau 3, porque cada resposta carrega o ruído do único ponto que copiou. Uma nota de treino perfeita é a cara de quem decorou, e é exatamente por isso que a regra de ouro existe: se você julgasse esses dois modelos nos seus pontos de treino, escolheria o pior.
Simulação: nada para aprender. Embaralhe os rótulos de treino (np.random.default_rng(0).permutation(y_train)), de modo que cada \(y\) caia num \(x\) qualquer e não sobre padrão nenhum, e construa um decorador sobre eles. Qual é o erro de treino agora? Nos pontos novos, compare com o 0,434 do grau 0 no passo 3, o modelo que sempre responde a média do treino.
Solução
y_random = np.random.default_rng(0).permutation(y_train)      # os mesmos valores de y, embaralhados: sem padrão
memo_random = memorizer(x_train, y_random)
print(f"memorizer, shuffled y: train {mse(memo_random, x_train, y_random):.3f} · new {mse(memo_random, x_new, y_new):.3f}")
Com rótulos aleatórios não há nada para aprender, e o erro de treino continua 0,000: um decorador é perfeito nos dados de treino com sinal ou sem sinal. Nos pontos novos ele faz 0,717, muito pior que o 0,434 de simplesmente responder a média. O erro de treino de um modelo flexível o bastante para decorar não diz nada; só dados novos separam os dois casos.
Para fechar a parte fundamental. Em uma frase cada: (1) o que o erro de treino diz sobre um modelo e o que ele não consegue dizer? (2) Por que 100 pontos domaram o polinômio de grau 14? (3) Nos termos da seção 1, que paradigma e que tarefa é este lab?
Sua vez (fundamental)
Em casa:
- Dados reais não têm gerador. Sorteie 30 pontos com
draw(30, seed=2), divida-os comtrain_test_split(x, y, test_size=0.5, random_state=0)(desklearn.model_selection) e refaça o passo 3 com a metade de teste no papel dos pontos novos. As duas colunas mantêm a forma? Por que a coluna de teste fica mais ruidosa que com 1.000 pontos novos? - Diga o paradigma. Para cada caso, dê o paradigma e, se for supervisionado, a tarefa: (a) a demanda de eletricidade de uma cidade amanhã, a partir de cinco anos de demanda hora a hora; (b) agrupar músicas pelos atributos de áudio, sem gêneros dados; (c) marcar transações de cartão fraudulentas, a partir de transações passadas marcadas por analistas; (d) um robô aspirador que aprende uma rota a partir de uma nota que recebe no fim de cada volta.
- Um mundo mais silencioso. Mude o ruído da
drawde 0,3 para 0,1 e rode de novo os passos 1 a 3. Até onde cai agora o erro nos dados novos? O sobreajuste começa num grau mais alto ou mais baixo?
Abordagem avançada
A parte fundamental desenhou o mapa e encontrou o seu problema central: um modelo precisa funcionar em dados que nunca viu. Esta parte pergunta o que o mapa deixa de fora: como um desejo vago vira um problema que um modelo resolve, por que nenhum modelo vence em todo problema e o que dá errado quando as decisões de um modelo chegam às pessoas. Os blocos de código continuam os do lab fundamental.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. formular o problema; 2. nenhum modelo vence em tudo; 3. viés nos dados; 4. ciclos de retroalimentação. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Formular o problemaalvo, momento, métrica, baseline
- Nenhum modelo vence em tudoa perda esperada; sem almoço grátis
- Viés nos dadosum modelo aprende o passado; variáveis substitutas
- Ciclos de retroalimentaçãoum modelo que decide o que vai ver
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
5. Formular um problema: alvo, momento, métrica, baseline
Etapa 1. "Reduzir o número de pacientes que faltam às consultas" é um desejo, não um problema de ML. A primeira caixa do ciclo o transforma num problema respondendo a quatro perguntas, antes de tocar em qualquer dado:
| pergunta | o que ela fixa | a clínica, por exemplo |
|---|---|---|
| alvo | o que exatamente se prevê e, portanto, a tarefa | o paciente faltou à consulta: sim ou não — classificação |
| momento | quando a previsão é feita e, portanto, que atributos são permitidos | 48 horas antes: idade, faltas anteriores, dias desde o agendamento; não uma ligação de cancelamento feita na véspera, que ninguém conhece ainda |
| métrica | como o sucesso é medido, nos termos de quem paga pelos erros | uma falta não prevista custa um horário vazio; um alarme falso custa um telefonema: contar as faltas pegas com as ligações que a equipe consegue fazer |
| baseline | quanto faz a resposta razoável mais simples | "ninguém falta"; ou, na regressão, a média do treino (o grau 0 do passo 3, o DummyRegressor do passo 5) |
Cada pergunta protege contra uma falha diferente. Um alvo vago produz um modelo que responde bem à pergunta errada. Um momento errado é vazamento (leakage): um atributo que só se conhece depois do fato faz o modelo parecer excelente no laboratório e inútil em produção (as aulas de pré-processamento e de pipelines voltam a ele). Uma métrica escolhida por conveniência otimiza algo que não interessa a ninguém (a aula de métricas de classificação trata dessa escolha). E sem um baseline não há como saber se 0,80 é impressionante ou pior que não fazer nada. Às vezes a resposta honesta às quatro perguntas é que nenhum modelo é necessário: uma regra escrita por uma pessoa é mais barata de construir, de explicar e de corrigir.
6. O objetivo, por escrito
Etapa 2. O problema central da parte fundamental cabe numa linha:
Cada símbolo nomeia algo do lab. \(f\) é o modelo; \((x, y)\) é um exemplo novo, sorteado de \(\mathcal{D}\), a distribuição dos dados que o modelo vai encontrar em produção (no lab, a função draw); \(L\) é a perda, o preço de uma resposta errada (no lab, o erro quadrático \((y - f(x))^2\)); e \(\mathbb{E}\) é a média sobre todos esses exemplos novos. A coluna "new" do passo 3 é essa média estimada com 1.000 sorteios, o que só foi possível porque tínhamos a draw. Com dados reais, um conjunto de teste faz esse papel e só estima a perda esperada com honestidade se o modelo nunca o viu. Duas coisas podem quebrar a estimativa em produção: um conjunto de teste que vazou para o treino e uma \(\mathcal{D}\) que muda depois da implantação (o drift do ciclo).
7. Sem almoço grátis
O teorema No Free Lunch (Wolpert, 1996) diz que, na média sobre todos os problemas possíveis, nenhum algoritmo de aprendizado é melhor que qualquer outro. Na prática, isso significa: não existe modelo universalmente melhor — você precisa experimentar várias famílias e validar. É por isso que este curso ensina um portfólio (modelos lineares, vizinhos, kernels, árvores, ensembles, redes) em vez de uma única bala de prata.
A figura mostra a ideia em dois mundos pequenos, os mesmos que o passo 5 do lab mede: um reto (\(y = 2x\) mais ruído) e a curva ondulada do lab fundamental. Uma reta e um modelo de 5 vizinhos mais próximos (ele responde a média do \(y\) dos 5 pontos de treino mais próximos) são ajustados a 30 pontos de cada um (script da figura):
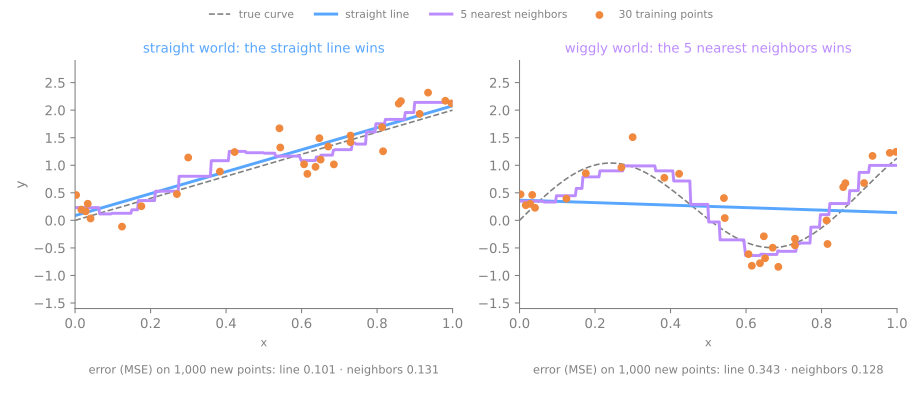
A reta vence no mundo reto (0,101 contra 0,131) e perde feio no ondulado (0,343 contra 0,128). Nenhum dos dois modelos é melhor; cada um é melhor em alguma coisa. A reta supõe que a resposta muda a uma taxa constante e vence exatamente onde essa suposição é verdadeira; os vizinhos supõem apenas que entradas próximas têm respostas próximas, o que é verdade com mais frequência, mas lhes custa precisão onde a suposição mais forte vale. Todo modelo carrega suposições assim, o seu viés indutivo, e o teorema diz que nenhum conjunto de suposições vence em todo problema.
Duas leituras erradas a evitar. O teorema não diz que todos os modelos são iguais no seu problema: num conjunto de dados concreto alguns são muito melhores, e descobrir quais é o trabalho da validação e da seleção de modelos. Nem diz que a experiência é inútil: problemas reais não são sorteados de "todos os problemas possíveis", e é por isso que algumas famílias, como as árvores com boosting em tabelas, vencem tantas vezes na prática. Ele diz que a razão de vencerem é um encaixe entre as suas suposições e os dados, e que esse encaixe precisa ser verificado a cada vez.
8. Ética e responsabilidade
Etapa 3. Modelos treinados em dados históricos herdam vieses históricos. Antes de colocar um modelo em produção, pergunte:
- Justiça — o modelo tem desempenho igual entre grupos demográficos? Um modelo de crédito treinado em decisões enviesadas as reproduz em escala.
- Privacidade — os dados foram coletados com consentimento? As pessoas podem ser reidentificadas?
- Transparência — as decisões podem ser explicadas aos afetados? (A aula de explicabilidade trata disso.)
- Ciclos de retroalimentação — implantar o modelo altera os dados com que ele será retreinado? (O policiamento preditivo é o exemplo canônico de alerta, e a próxima seção faz a conta à mão.)
Um modelo aprende o passado
Um modelo supervisionado aprende a reproduzir os seus rótulos e, quando os rótulos são decisões humanas do passado, ele aprende as decisões, não a verdade que elas deveriam capturar. O passo 6 do lab monta o menor caso possível: 4.000 pedidos de empréstimo antigos de dois grupos, A e B, com a mesma distribuição de notas de pagamento, julgados por analistas que aprovavam A a partir da nota 50 e B só a partir de 65. Uma pequena árvore é treinada para imitar essas decisões e depois avalia 2.000 pedidos novos (script da figura):
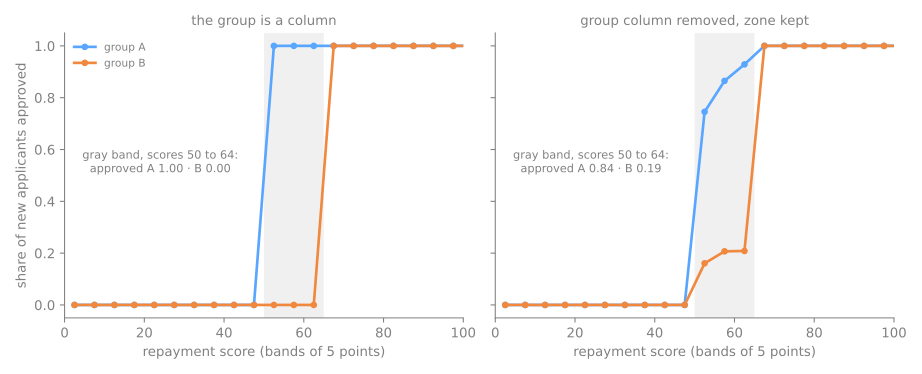
À esquerda o modelo aprendeu o duplo padrão com exatidão: entre 50 e 64, todo pedido do grupo A é aprovado e nenhum do grupo B, embora os dois grupos paguem igual. Ninguém programou essa regra; ela estava nos rótulos. À direita a coluna do grupo foi apagada — o primeiro instinto de costume —, mas a zona onde as pessoas moram ficou, e 80% do grupo B mora numa mesma zona. O modelo usa a zona no lugar do grupo: 0,84 contra 0,19 na mesma faixa. Um atributo que faz as vezes de outro que foi removido é uma variável substituta (proxy), e remover uma coluna sensível não remove o viés enquanto sobrar uma substituta. O que ajuda é medir: comparar os erros e as decisões do modelo entre grupos, com notas iguais, antes e depois da implantação.
Aviso
"O modelo disse isso" nunca é uma justificativa aceitável para uma decisão que afeta pessoas. Você — o profissional — é responsável pelas consequências.
9. Ciclos de retroalimentação: um modelo que escreve os próprios dados
Etapa 4. A última pergunta da lista é a menos intuitiva, porque os dados parecem perfeitamente honestos. Uma cidade tem dois bairros e uma viatura. Todo dia um modelo manda a viatura aonde mais crimes foram registrados; a viatura registra toda ocorrência que vê lá, e no outro bairro só as ligações de moradores chegam aos registros, 2 por dia. O bairro A tem 10 ocorrências por dia; B tem 12. O histórico começa com 55 registros em A e 45 em B. Dia a dia:
| dia | o modelo prevê (registros de A e de B) | viatura | registros depois do dia |
|---|---|---|---|
| 1 | 55 ≥ 45 | A | A 55 + 10 = 65 · B 45 + 2 = 47 |
| 2 | 65 ≥ 47 | A | A 75 · B 49 |
| 3 | 75 ≥ 49 | A | A 85 · B 51 |
| 10 | 145 ≥ 63 | A | A 155 · B 65 |
Todo dia a diferença cresce 8 (10 registrados em A, 2 em B), então B nunca alcança A. Depois de dez dias os registros dizem que A tem 2,4 vezes o crime de B (155 contra 65), enquanto B teve mais ocorrências em todos os dias: se toda ocorrência tivesse sido registrada, os dois empatariam no dia 5 (105 cada) e B estaria na frente a partir do dia 6. Cada registro é uma ocorrência real; os registros erram onde está o crime porque é o modelo que decide onde olhar. O simulador percorre os dez dias e depois revela o que aconteceu de fato:
Retreinar não resolve, porque cada modelo novo é treinado com registros que o anterior moldou. As saídas mudam o que é medido: mandar a viatura, parte do tempo, aonde o modelo não espera crime (explorar) e comparar ocorrências por dia patrulhado em vez de totais brutos. O passo 7 do lab roda as duas coisas: com um dia em cada cinco dedicado a explorar, as estimativas saem 10 e 12 por dia, a verdade. Sistemas reais de policiamento preditivo mostram a mesma disparada com registros reais (Lum e Isaac, 2016; Ensign et al., 2018), e o mesmo vale para sistemas de recomendação que só aprendem com os itens que eles mesmos escolheram mostrar.
10. Resumo: cinco perguntas para levar a todo projeto
- O problema está formulado? Alvo, momento, métrica e baseline, escritos antes de tocar nos dados.
- O que o modelo vai encontrar? O objetivo é a perda esperada em dados novos; um conjunto de teste só a estima se ficou intocado e se o mundo não mudar.
- Por que este modelo? Sem almoço grátis: cada família vence onde as suas suposições combinam com os dados, então compare várias e valide.
- O que os rótulos lhe ensinaram? Um modelo aprende o passado, vieses incluídos; remover uma coluna não remove as suas substitutas, então meça as decisões entre grupos.
- O modelo escolhe os próprios dados? Se as suas decisões decidem o que é registrado, retreinar amplia o erro; explore e meça por unidade de esforço.
Lab avançado — sem almoço grátis, um passado enviesado e um ciclo que se alimenta
O lab fundamental mediu a generalização num mundo que você controlava. Esta parte usa mais três mundos pequenos, cada um construído para tornar visível uma ideia da abordagem avançada: dois problemas com vencedores opostos, um passado cheio de decisões enviesadas e uma viatura que decide os próprios dados. Continue no mesmo notebook, na mesma sessão: o passo 5 usa np e true_curve do passo 1.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Continue no mesmo notebook do Colab, a partir do passo 5. Se a sessão caiu, rode antes a célula do passo 1 de novo (Ambiente de execução → Executar anteriores).
- Como no lab fundamental: Preveja antes de rodar, compare com esta página e tente as Simulações antes de abrir a solução.
- Ritmo sugerido: passo 5 em 8 min; passo 6 e a primeira simulação em 12 min; passo 7 e a segunda simulação em 10 min.
Passo 5 — sem almoço grátis, medido
Preveja. Dois mundos, um reto e a curva ondulada do passo 1, e três modelos: a média do treino (o baseline), uma reta e 5 vizinhos mais próximos. Que modelo vence em cada mundo? Algum vence nos dois?
from sklearn.dummy import DummyRegressor
from sklearn.linear_model import LinearRegression
from sklearn.neighbors import KNeighborsRegressor

worlds = {'straight': lambda x: 2 * x, 'wiggly': true_curve}

def draw_world(world, n, seed):
    rng = np.random.default_rng(seed)
    x = rng.uniform(0, 1, n)
    return x.reshape(-1, 1), worlds[world](x) + rng.normal(0, 0.3, n)

models = {
    'mean (baseline)': DummyRegressor(),                    # responde sempre a média do treino
    'straight line': LinearRegression(),
    '5 nearest neighbors': KNeighborsRegressor(n_neighbors=5),   # média dos 5 pontos de treino mais próximos
}
print(f"{'error on new points':22s}{'straight':>10s}{'wiggly':>10s}")
for name, model in models.items():
    errors = []
    for world in worlds:
        X, y = draw_world(world, 30, seed=0)
        X_future, y_future = draw_world(world, 1000, seed=1)
        model.fit(X, y)
        errors.append(np.mean((y_future - model.predict(X_future)) ** 2))
    print(f"{name:22s}{errors[0]:10.3f}{errors[1]:10.3f}")
error on new points     straight    wiggly
mean (baseline)            0.464     0.364
straight line              0.101     0.343
5 nearest neighbors        0.131     0.128
São os dois painéis da figura da seção 7. A reta vence no mundo reto e mal supera o baseline no ondulado (0,343 contra 0,364); os vizinhos vencem no mundo ondulado e perdem no reto. Nenhuma linha é a melhor nas duas colunas. A linha do baseline é a referência da seção 5: um modelo que não o supera com folga não aprendeu nada útil.
Passo 6 — um modelo aprende o passado
Preveja. 4.000 decisões de empréstimo antigas: notas de 0 a 100, distribuídas igualmente nos grupos A e B, mas os analistas aprovavam A a partir de 50 e B só a partir de 65. Uma pequena árvore é treinada para imitá-los. Entre os pedidos novos com notas de 50 a 64, que fração de cada grupo o modelo vai aprovar?
import pandas as pd
from sklearn.tree import DecisionTreeClassifier

rng = np.random.default_rng(0)
def applicants(n):
    group_B = rng.integers(0, 2, n)                               # 1 = grupo B, 0 = grupo A
    return pd.DataFrame({
        'score': rng.integers(0, 101, n),                         # capacidade de pagar, de 0 a 100: igual nos dois grupos
        'group_B': group_B,
        'zone': (rng.random(n) < np.where(group_B == 1, 0.8, 0.2)).astype(int),  # onde moram (simulação)
    })

past = applicants(4000)
# os analistas aprovavam o grupo A a partir da nota 50, mas o grupo B só a partir de 65
past['approved'] = (past['score'] >= np.where(past['group_B'] == 1, 65, 50)).astype(int)

model = DecisionTreeClassifier(max_depth=3, random_state=0)      # uma caixa-preta, por enquanto
model.fit(past[['score', 'group_B']], past['approved'])

new = applicants(2000)
new['approved'] = model.predict(new[['score', 'group_B']])

def approval(df):
    rate = df.groupby('group_B')['approved'].mean()
    return f"group A {rate[0]:.2f} · group B {rate[1]:.2f}"

print('approved, all new applicants: ', approval(new))
print('approved, scores 50 to 64:    ', approval(new[new['score'].between(50, 64)]))
approved, all new applicants:  group A 0.50 · group B 0.34
approved, scores 50 to 64:     group A 1.00 · group B 0.00
No conjunto dos pedidos a diferença parece moderada (0,50 contra 0,34), porque a maior parte das notas cai onde as duas regras concordam. Entre 50 e 64 ela é total: 1,00 contra 0,00. O modelo é um ótimo aluno, reproduz os seus rótulos sem erro, e é exatamente esse o problema: os rótulos eram decisões enviesadas. Nada no código fala de discriminação; a árvore (a aula de árvores de decisão a abre) achou o corte em group_B porque era a melhor maneira de imitar os analistas.
Simulação: apagar a coluna. A primeira correção de costume é tirar group_B. Treine a mesma árvore só com score e zone (a coluna zone já está nos dados: 80% do grupo B mora na zona 1; do grupo A, 20%), preveja de novo os pedidos novos e imprima as mesmas duas linhas. O viés sumiu?
Solução
blind = DecisionTreeClassifier(max_depth=3, random_state=0)
blind.fit(past[['score', 'zone']], past['approved'])             # sem a coluna do grupo
new['approved'] = blind.predict(new[['score', 'zone']])
print('share of group B in zone 1:', round(new.loc[new['zone'] == 1, 'group_B'].mean(), 2))
print('approved, all new applicants: ', approval(new))
print('approved, scores 50 to 64:    ', approval(new[new['score'].between(50, 64)]))
share of group B in zone 1: 0.82
approved, all new applicants:  group A 0.48 · group B 0.37
approved, scores 50 to 64:     group A 0.84 · group B 0.19
O modelo nunca vê o grupo e ainda assim aprova 0,84 do grupo A e 0,19 do grupo B com as mesmas notas. Ele aprendeu a regra pela zona: 82% da zona 1 é do grupo B, então "zona 1" é quase "grupo B". A zona é uma variável substituta. Apagar a coluna sensível só tornou o viés mais difícil de ver; medir as decisões por grupo, como fazem estas duas linhas, é o que o revela.
Passo 7 — um ciclo que se alimenta
Preveja. A viatura da seção 9, rodando 30 dias em vez de 10. Depois de um mês, que bairro os registros apontam como mais perigoso, e por quanto?
true_per_day = {'A': 10, 'B': 12}          # ocorrências por dia: B na verdade tem mais
records = {'A': 55, 'B': 45}               # o histórico de onde o modelo parte
for day in range(1, 31):
    hotspot = max(records, key=records.get)          # o "modelo": onde mais crime foi registrado
    for hood in records:
        if hood == hotspot:
            records[hood] += true_per_day[hood]      # a viatura registra toda ocorrência que vê
        else:
            records[hood] += 2                       # no outro bairro, só as ligações de moradores: 2 por dia
    if day in (1, 2, 3, 10, 30):
        print(f"day {day:2d}: patrol in {hotspot} · records A {records['A']:3d} · B {records['B']:3d}")
day  1: patrol in A · records A  65 · B  47
day  2: patrol in A · records A  75 · B  49
day  3: patrol in A · records A  85 · B  51
day 10: patrol in A · records A 155 · B  65
day 30: patrol in A · records A 355 · B 105
Os dias 1 a 10 são a tabela da seção 9. Depois de 30 dias os registros dizem que A tem 3,4 vezes o crime de B (355 contra 105), e a razão continua crescendo: quanto mais o ciclo roda, mais certo o modelo fica de algo falso. Cada retreino com esses registros o confirmaria.
Simulação: olhar onde você não olha. Mude a regra de duas maneiras: nos dias 1, 6, 11, … (um dia em cada cinco, day % 5 == 1), mande a viatura ao bairro que ela patrulhou menos; nos outros dias, mande-a aonde ela viu mais ocorrências por dia patrulhado. Conte só o que a própria viatura registra. Depois de 30 dias, quantos dias cada bairro recebeu e quais são as duas estimativas por dia?
Solução
seen = {'A': 0, 'B': 0}                    # ocorrências que a própria viatura registrou
days = {'A': 0, 'B': 0}                    # dias que a viatura passou lá
for day in range(1, 31):
    if day % 5 == 1:                       # um dia em cada cinco, olhar onde não se olhou
        hotspot = min(days, key=days.get)
    else:                                  # nos outros, ir aonde a viatura viu mais por dia
        hotspot = max(days, key=lambda h: seen[h] / days[h] if days[h] else 0)
    seen[hotspot] += true_per_day[hotspot]
    days[hotspot] += 1
print('days patrolled:', days)
print('incidents per patrolled day:', {h: seen[h] / days[h] for h in days})
O primeiro dia de exploração (dia 1) vai para A; o segundo (dia 6) é a primeira visita a B, que mostra 12 ocorrências contra as 10 por dia de A, e do dia 7 em diante a viatura vai sobretudo a B: 21 dias contra 9. As duas mudanças eram necessárias. Só explorar ainda compararia totais brutos, que A continua vencendo; só dividir pelos dias patrulhados nunca visitaria B para descobrir. Juntas, elas medem a mesma coisa nos dois lugares, e as estimativas batem com a verdade, 10 e 12.
Para fechar a aula. Em uma frase cada: (1) por que nem a reta nem os vizinhos vencem nos dois mundos do passo 5? (2) Por que apagar group_B não removeu o viés? (3) O que o modelo da viatura do passo 7 errou, se cada registro era uma ocorrência real?
Sua vez (avançado)
Em casa, com mais tempo:
- O futuro fora do passado. No passo 5, sorteie os pontos novos do mundo reto com \(x\) entre 1 e 1,5 em vez de entre 0 e 1 (fora da faixa do treino). Que modelo vence agora e por que os vizinhos não conseguem acompanhar a reta ali?
- Dois tipos de justiça. No passo 6, calcule a taxa de aprovação por grupo para todos os pedidos e para cada faixa de 10 pontos de nota. Um modelo pode ter taxas de aprovação iguais para os dois grupos no total e ainda tratar notas iguais de forma diferente? Construa um, mudando a regra dos analistas.
- Viaturas proporcionais. No passo 7, em vez de mandar a viatura ao foco, divida o tempo de patrulha de cada dia na proporção dos registros (A fica com \(55/100\) do primeiro dia e os seus registros crescem \(10 \times 0{,}55\)). A fatia de A nos registros continua crescendo, fica onde começou ou se move rumo à verdade?
Referências
- Wolpert, D. H. "The Lack of A Priori Distinctions Between Learning Algorithms." Neural Computation 8 (1996). DOI
- Lum, K.; Isaac, W. "To Predict and Serve?" Significance 13, n. 5 (2016): 14–19 — um modelo de policiamento preditivo treinado com prisões por drogas manda a polícia aonde a polícia já estava. DOI
- Ensign, D.; Friedler, S. A.; Neville, S.; Scheidegger, C.; Venkatasubramanian, S. "Runaway Feedback Loops in Predictive Policing." Proceedings of the Conference on Fairness, Accountability and Transparency, PMLR 81 (2018): 160–171 — o ciclo da seção 9, como modelo matemático. Artigo
- Barocas, S.; Hardt, M.; Narayanan, A. Fairness and Machine Learning: Limitations and Opportunities. MIT Press (2023) — rótulos enviesados, variáveis substitutas e por que remover uma coluna sensível não basta. Livre on-line