O caminho desta parte
- Formular o problemaalvo, momento, métrica, baseline
- Nenhum modelo vence em tudoa perda esperada; sem almoço grátis
- Viés nos dadosum modelo aprende o passado; variáveis substitutas
- Ciclos de retroalimentaçãoum modelo que decide o que vai ver
Um desejo não é um problema
"Reduzir o número de pacientes que faltam às consultas."
Quatro perguntas antes de tocar nos dados
| pergunta | o que ela fixa | a clínica |
|---|---|---|
| alvo | o que se prevê e, portanto, a tarefa | faltou à consulta: sim ou não (classificação) |
| momento | quando e, portanto, que atributos são permitidos | 48 h antes: idade, faltas anteriores, dias desde o agendamento; não uma ligação de cancelamento feita na véspera |
| métrica | o sucesso, nos termos de quem paga pelos erros | um horário vazio contra um telefonema: as faltas pegas com as ligações que a equipe consegue fazer |
| baseline | quanto faz a resposta mais simples | "ninguém falta"; na regressão, a média do treino |
O objetivo, por escrito
\[ \text{minimizar } \underbrace{\mathbb{E}_{(x,y)\sim \mathcal{D}}\big[L\big(f(x),\,y\big)\big]}_{\text{perda esperada em dados novos}} \quad \text{observando apenas uma amostra finita} \]- \(f\): o modelo. \((x, y)\): um exemplo novo, sorteado de \(\mathcal{D}\), a distribuição dos dados que o modelo vai encontrar (no lab, a função
draw). - \(L\): a perda, o preço de uma resposta errada (no lab, o erro quadrático \((y - f(x))^2\)). \(\mathbb{E}\): a média sobre todos os exemplos novos.
Sem almoço grátis
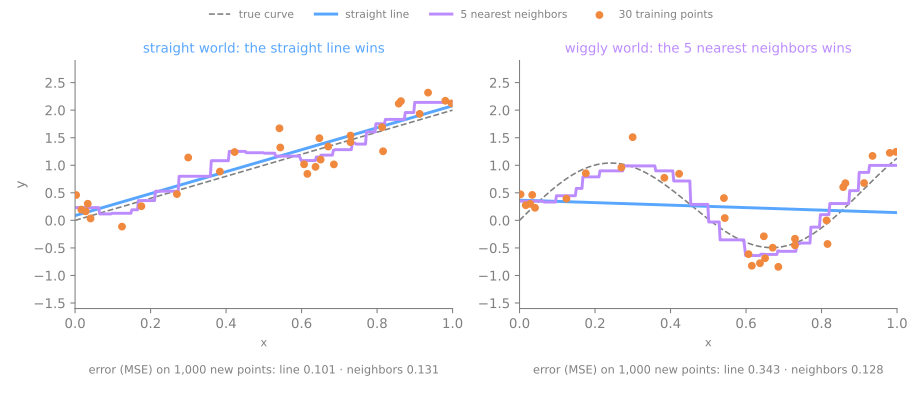
- Wolpert (1996): na média sobre todos os problemas possíveis, nenhum algoritmo de aprendizado é melhor que qualquer outro.
- Na prática: não existe modelo universalmente melhor. Experimente várias famílias e valide.
Dois mundos, dois vencedores
O que o teorema não diz
não: "todos os modelos são iguais"
no seu conjunto de dados alguns são muito melhores; descobrir quais é o trabalho da validação e da seleção de modelos
não: "a experiência é inútil"
problemas reais não são sorteados ao acaso; algumas famílias (árvores com boosting em tabelas) vencem com frequência, porque as suas suposições combinam
Ética: quatro perguntas antes de colocar um modelo em produção
Modelos treinados em dados históricos herdam vieses históricos.
justiça
desempenho igual entre grupos? Um modelo de crédito treinado em decisões enviesadas as reproduz em escala
privacidade
os dados foram coletados com consentimento? as pessoas podem ser reidentificadas?
transparência
as decisões podem ser explicadas aos afetados?
ciclos de retroalimentação
implantar o modelo altera os dados com que ele será retreinado? (policiamento preditivo)
Um modelo aprende o passado
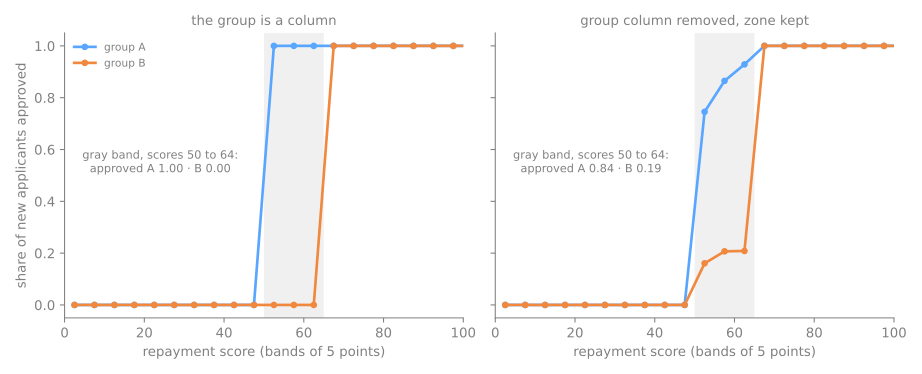
4.000 empréstimos antigos. Os grupos A e B pagam igual, mas os analistas aprovavam A a partir da nota 50 e B só a partir de 65. Uma pequena árvore os imita. Preveja: com notas de 50 a 64, que fração de cada grupo ela aprova? E se a coluna do grupo for apagada?
De quem é a decisão
Um ciclo de retroalimentação, dia a dia
Uma viatura, dois bairros: A tem 10 ocorrências por dia; B, 12. O modelo manda a viatura aonde há mais crime registrado; no outro bairro só entram nos registros 2 ligações por dia. Preveja: a viatura vai algum dia para B?
Por que retreinar não resolve
- Cada registro é uma ocorrência real; os registros erram onde está o crime porque é o modelo que decide onde olhar.
- Cada modelo novo é treinado com registros que o anterior moldou: depois de 30 dias, A 355 contra B 105.
explorar
um dia em cada cinco, mandar a viatura aonde ela foi menos
medir por esforço
ocorrências por dia patrulhado, não totais brutos
Resumo: cinco perguntas para todo projeto
- O problema está formulado? Alvo, momento, métrica, baseline, antes dos dados.
- O que o modelo vai encontrar? A perda esperada em dados novos; um teste só a estima se ficou intocado.
- Por que este modelo? Sem almoço grátis: compare várias famílias e valide.
- O que os rótulos lhe ensinaram? O passado, vieses incluídos; as substitutas sobrevivem a colunas apagadas.
- Ele escolhe os próprios dados? Então explore e meça por unidade de esforço.
Sem almoço grátis, um passado enviesado e um ciclo que se alimenta, passos 5 a 7
- Passo 5: dois mundos, três modelos (entre eles o baseline), vencedores opostos.
- Passo 6: uma árvore treinada com decisões de crédito enviesadas, medida grupo a grupo.
- Passo 7: o ciclo da viatura, rodando 30 dias.
- O mesmo notebook do Colab do lab fundamental, na mesma sessão; em cada passo, primeiro o Preveja.
- Simulações: apagar a coluna do grupo (passo 6) e olhar onde você não olha (passo 7).
Ritmo: passo 5 em 8 min; passo 6 e a primeira simulação em 12 min; passo 7 e a segunda em 10 min.