O caminho desta parte
- Tipos de aprendizadosupervisionado, não supervisionado, por reforço: pelo feedback
- O ciclo do projetoformular, obter dados, preparar, treinar, avaliar, implantar: um ciclo
- Generalizaçãotreino e dados novos; subajuste e sobreajuste
Paradigmas de aprendizado: pelo feedback
Os problemas de machine learning (ML, aprendizado de máquina) são classificados pelo tipo de feedback que o aprendiz recebe.
Três paradigmas
Aprendizado supervisionado: as entradas e as respostas
Os dados contêm as entradas \(x\) e as saídas desejadas \(y\) (rótulos). Objetivo: aprender uma função \(f\) com \(f(x) \approx y\) em dados novos.
regressão
\(y\) é contínuo: preços de imóveis, demanda de energia, o tempo de internação de um paciente
classificação
\(y\) é categórico: spam ou não, tumor benigno ou maligno, qual dígito está na imagem
Aprendizado não supervisionado: só as entradas
Sem rótulos. O objetivo é descobrir estrutura.
agrupamento
agrupar observações semelhantes, como segmentos de clientes
redução de dimensionalidade
comprimir muitos atributos em poucos informativos: PCA (análise de componentes principais), t-SNE, UMAP
modelagem de tópicos
descobrir temas numa coleção de documentos (BERTopic)
Aprendizado por reforço e as misturas
- Um agente age num ambiente, recebe recompensas e aprende uma política que maximiza a recompensa de longo prazo: sistemas que jogam (AlphaGo), controle robótico.
- Fora do escopo deste curso, mas você deve reconhecê-lo no mapa.
semissupervisionado
poucos rótulos, muitos exemplos não rotulados
autossupervisionado
rótulos fabricados a partir dos próprios dados: como os modelos de fundação são pré-treinados
supervisão fraca
rótulos ruidosos e programáticos
O fluxo de trabalho de ML
Um modelo é uma pequena parte de um processo maior e iterativo. O curso é organizado em torno deste ciclo.
Duas verdades práticas sobre o ciclo
a maior parte do trabalho está nos passos 2–3
é comum profissionais relatarem que passam a maior parte do tempo entendendo e preparando dados, não ajustando modelos
o ciclo nunca termina
modelos implantados se degradam conforme o mundo muda (drift); monitorar e retreinar fazem parte do trabalho
Generalização: o problema central
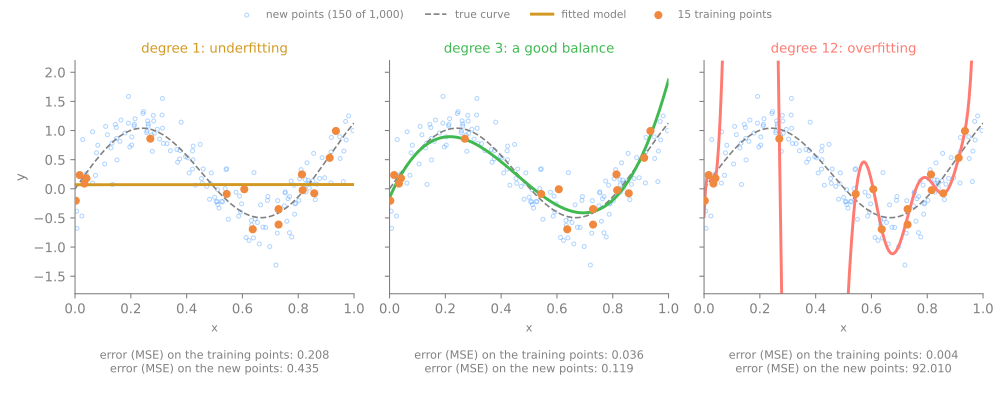
Ele ainda pode ser inútil. O que importa é o desempenho em dados que ele nunca viu.
subajuste (underfitting)
simples demais para capturar o padrão: ruim até nos dados de treino
sobreajuste (overfitting)
captura ruído como se fosse sinal: excelente no treino, ruim em dados novos
Três modelos, a olho
15 pontos de treino (laranja) em torno de uma curva com ruído; 1.000 pontos novos (azul), que os modelos nunca veem. Erro: MSE (mean squared error, erro quadrático médio), a média dos quadrados das distâncias verticais. Preveja: ordene os graus 1, 3 e 12 pelo erro de treino. A ordem é a mesma nos pontos novos?
Simulador: subajuste e sobreajuste
Preveja. Quando o grau vai de 1 a 15, o que acontece com o erro de treino? E com o erro de teste? Depois aperte mais dados.
A regra de ouro
- No lab e no simulador, os "pontos novos" vêm de um gerador que nós escrevemos: dá para sortear o futuro à vontade.
- Um projeto real não tem esse gerador. O único substituto do futuro é o dado que você separa e nunca usa no treino.
- Divisões treino/teste, validação cruzada, regularização, o trade-off viés–variância: tudo existe para gerenciar essa tensão.
Resumo
- Paradigmas pelo feedback: supervisionado (rótulos), não supervisionado (estrutura), por reforço (recompensas).
- No aprendizado supervisionado o tipo do \(y\) dá nome à tarefa: regressão ou classificação.
- O fluxo de trabalho é um ciclo; a maior parte do trabalho está nos dados.
- Leia dois erros, nunca um: os dois altos é subajuste; treino baixo e dados novos alto é sobreajuste.
- Só dados que o modelo nunca viu o julgam: nunca avalie nos dados de treino.
| o que você vê | o que está acontecendo |
|---|---|
| os dois erros altos e próximos | subajuste: simples demais |
| treino minúsculo, dados novos muito maior | sobreajuste: decorou o ruído |
| um modelo em produção piorando aos poucos | drift: o mundo mudou |
A forma do erro, passos 1 a 4
- Um mundo que você controla: 15 pontos de treino em torno de uma curva e 1.000 pontos novos do mesmo processo.
- Polinômios de grau crescente e depois um modelo que só decora: acompanhe o erro de treino e o erro nos pontos novos.
- O código está na página da aula: cole cada bloco num notebook em branco do Colab, em ordem. Nada para instalar.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: mais dados (passo 3) e nada para aprender (passo 4).
Ritmo: passos 1 e 2 em 8 min; passo 3 e a primeira simulação em 10 min; passo 4 e a segunda em 12 min.