O caminho desta parte
- Empacotar e servir em escalaskops e ONNX, latência por chamada
- Registrar cada execuçãoum registro de experimentos, um registro de modelos
- Detectar e reagirp-valores com dados grandes; degradar, detectar, retreinar
- Mudar com segurançadesalinhamento, laços de realimentação, troca com portão, testes, maturidade
Um formato mais seguro: skops
Um arquivo do joblib é um pickle, então carregá-lo pode rodar código. Ao carregar, o skops só reconstrói tipos de uma lista permitida; qualquer outro tipo precisa ser declarado confiável explicitamente.
| pipeline | tipos não confiáveis | carregando sem confiar |
|---|---|---|
| scaler + one-hot + logística | [] | carrega, probabilidades idênticas |
| com uma função própria | ['__main__.cap_amount'] | UntrustedTypesFoundException |
Fora do Python, o ONNX (Open Neural Network Exchange, via skl2onnx) converte um pipeline ajustado num grafo portátil para runtimes em C++, Java ou JavaScript.
Latência: paga-se por chamada, não por linha
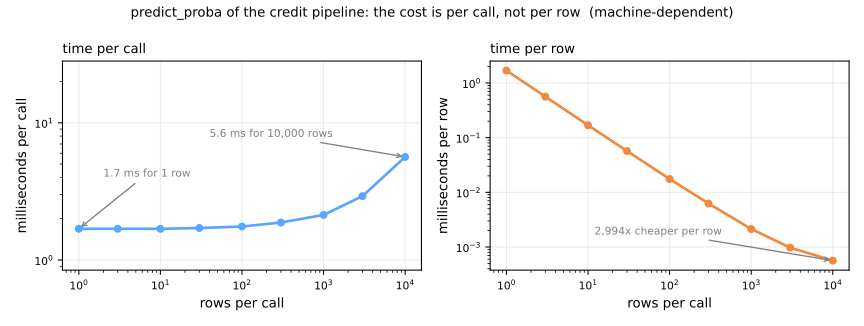
Na máquina que gerou a página: 1,724 ms/linha uma de cada vez, 0,0006 ms/linha num só lote, cerca de 2.700×. Uma chamada custa cerca de 1,7 ms quer carregue uma linha, quer mil: trabalho fixo, não aritmética.
Um registro de experimentos: uma linha por execução, nunca editada
| dados | C | AUC na VC | dp na VC |
|---|---|---|---|
| 68ad024c9661 | 0,01 | 0,7495 | 0,0292 |
| 68ad024c9661 | 0,10 | 0,7599 | 0,0224 |
| 68ad024c9661 | 1,00 | 0,7522 | 0,0244 |
| 68ad024c9661 | 10,00 | 0,7442 | 0,0230 |
VC: validação cruzada; dp: desvio padrão entre folds; AUC (area under the curve): área sob a curva ROC; C: o inverso da penalidade da regressão logística.
C = 0.1 sobre C = 1 (0,0077) fica muito abaixo dos desvios padrão entre folds (cerca de 0,02): trate-as como empatadas. Guarde as execuções perdedoras: elas registram quantas coisas foram tentadas. O MLflow faz o mesmo com uma interface web e um registro de modelos.p-valores com dados grandes
| deslocamento de 0,02 dp, n = | 1.000 | 10.000 | 100.000 | 1.000.000 |
|---|---|---|---|---|
| p-valor do KS | 0,097 | 0,14 | 0,00049 | 1,6e-41 |
| PSI (índice de estabilidade populacional) | 0,0344 | 0,0018 | 0,0004 | 0,0005 |
Degradar, detectar, retreinar
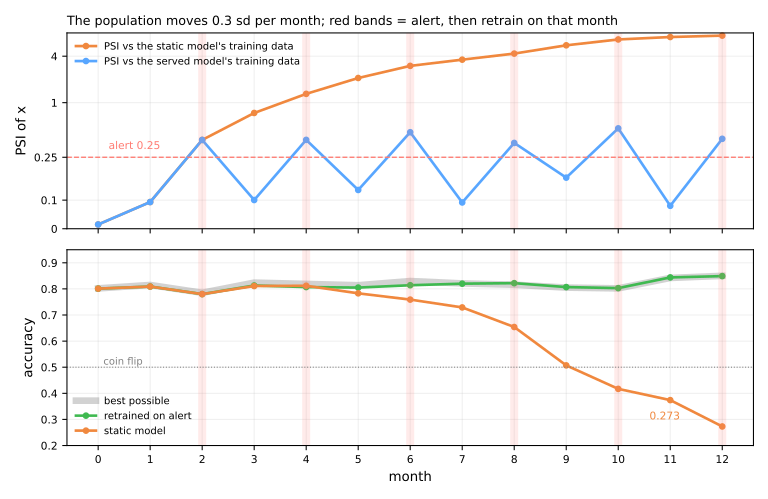
A população se move 0,3 dp por mês. Modelo estático vs um modelo retreinado sempre que o PSI da sua entrada passa de 0,25.
| mês | estático | monitorado | melhor possível |
|---|---|---|---|
| 0 | 0,801 | 0,801 | 0,802 |
| 2 (alerta) | 0,780 | 0,780 | 0,785 |
| 6 | 0,759 | 0,814 | 0,830 |
| 8 | 0,654 | 0,822 | 0,816 |
| 12 | 0,273 | 0,849 | 0,850 |
Desalinhamento treino–serving, medido
Um novo aplicativo cliente manda um campo em outra unidade. O conjunto de teste, de três jeitos:
| AUC | sinalizados | decisões mudadas | rejeitados pelo schema | |
|---|---|---|---|---|
| como no treino | 0,783 | 20,0% | 0,0% | 1% |
| valor em milhares | 0,775 | 14,8% | 5,2% | 100% |
| duração em anos | 0,751 | 2,8% | 17,2% | 93% |
Colocando um modelo novo no ar com segurança
Primeiro um portão de avaliação: vencer o modelo atual em dados recentes e rotulados que nenhum dos dois viu, por mais do que o ruído. Depois, liberar em etapas:
| estratégia | como | protege de |
|---|---|---|
| shadow | pontua o tráfego real, respostas só registradas | quedas, latência, escores estranhos |
| canary | 1–5% do tráfego | problemas que só aparecem com usuários reais |
| teste A/B | divisão aleatória, uma métrica de negócio | "AUC melhor" que não é resultado melhor |
| rollback | o artefato anterior fica pronto | todo o resto, em minutos |
Testes, documentação e maturidade
O ML Test Score
28 testes em 4 grupos: dados, desenvolvimento do modelo, infraestrutura, monitoramento (Breck et al., 2017). A nota é o mínimo entre os grupos.
Model card
uso pretendido, fatores, métricas, dados de treino e de avaliação, considerações éticas, ressalvas (Mitchell et al., 2019)
Uma escada sensata
- script + artefatos versionados
- CI/CD (integração e entrega contínuas): testes antes de qualquer modelo ir para produção
- logs, painéis, alertas de drift
- retreino com portões e rollback
Suba quando a dor justificar.
O panorama de ferramentas
| trabalho | ferramentas | nesta aula |
|---|---|---|
| salvar um modelo ajustado | joblib, skops, ONNX | joblib e skops |
| servir por HTTP | FastAPI, BentoML | esboço em FastAPI |
| empacotar o ambiente | Docker, lock files | versões fixas |
| rastrear experimentos, registrar modelos | MLflow, Weights & Biases | um log em JSON lines |
| versionar dados | DVC (Data Version Control), lakeFS | um hash dos dados |
| validar dados | pandera, Great Expectations, pydantic | uma função de schema |
| monitorar drift | Evidently, NannyML, whylogs | PSI e KS à mão |
HTTP (HyperText Transfer Protocol): o protocolo da web; JSON lines: um registro JSON por linha. O ecossistema muda rápido; os conceitos, não.
Resumo
- Um pickle roda código; o skops só carrega tipos confiáveis. Uma chamada custa um tempo fixo: batch sempre que der.
- Registre toda execução, perdedoras incluídas; empate dentro do ruído dos folds é empate.
- Com lotes grandes, alertas por magnitude, não por p-valor; drift não é dano e retreinar exige rótulos.
- O desalinhamento muda decisões enquanto o AUC mal se mexe; o schema o pega.
- Modelos novos passam por um portão e são liberados em etapas, com rollback pronto.
Alertas, retreino e um model card, passos 9 a 11
- Mesmo notebook, mesma sessão: os passos usam
production,served,meta,monitoreperfdos passos 1 a 8. - Transformar os monitores em regras de alerta, retreinar a cada trimestre com os últimos seis meses, gerar o model card a partir dos metadados.
- Notebook do lab, a partir do passo 9. Responda o Preveja antes de rodar.
- Simulações: lotes mensais (passo 9) e corrija só a taxa base (passo 10).
Ritmo: passo 9 e a simulação dele em 12 min; passo 10 e a simulação dele em 13 min; passo 11 em 5 min.