Esta aula começa onde as outras terminaram
- Até aqui, toda aula terminava quando o escore de teste era impresso.
- O que gera valor são predições entregues de forma confiável a quem age com base nelas.
- MLOps (machine-learning operations, operações de aprendizado de máquina): os hábitos de engenharia que levam um pipeline ajustado para produção e o mantêm confiável depois que ele chega lá.
O modelo é a caixa pequena
Sculley et al. (2015), Hidden Technical Debt in Machine Learning Systems: o código que aprende é uma caixinha cercada de infraestrutura e a maioria das falhas acontece na infraestrutura.
fit + definem o modeloO resto carrega, verifica, empacota, serve, monitora e compara.
O laço e o que o monitor manda de volta
Clique nos botões: o que um alerta de drift manda de volta? E um bug de dados?
Cada seta pode quebrar sem erro nenhum
| etapa | falha em silêncio quando... |
|---|---|
| empacotar | o arquivo carrega em outra versão da biblioteca e prediz diferente |
| servir | uma requisição malformada ainda recebe uma probabilidade com cara de confiável |
| treinar de novo | ninguém sabe dizer que dados, código e semente produziram o modelo em produção |
| monitorar | o mundo muda e o modelo continua respondendo como se não tivesse mudado |
| servir vs treinar | o código de serving calcula um atributo de forma diferente do código de treino |
As quatro primeiras linhas são esta parte; a última abre a abordagem avançada.
O caminho desta parte
- Empacotar o modeloo pipeline inteiro, riscos do pickle, versões fixas
- Servir prediçõesbatch ou online, um schema na frente, um endpoint
- Reproduzir e versionarsementes, impressão digital dos dados
- Monitorar o drifttrês mudanças, PSI e KS à mão, rótulos atrasados
Empacotamento: o artefato é o pipeline inteiro
Crédito alemão (1.000 empréstimos passados): 3 colunas numéricas e 5 categóricas → scaler + one-hot → regressão logística.
joblib.dump(pipe, path)                  # o pipeline INTEIRO, um arquivo
loaded = joblib.load(path)
np.array_equal(proba, loaded.predict_proba(X_test)[:, 1])
AUC de teste
no disco
ida e volta
Por que não distribuir só o modelo?
LogisticRegression ajustada de dentro do pipeline e dê a ela a tabela crua. O que acontece?
ValueError: X has 8 features, but LogisticRegression is expecting 30 features as input.
- O modelo viu as 30 colunas do column transformer: 3 números padronizados + 27 indicadores one-hot.
- Servi-lo sozinho exige reconstruir essas 30 colunas à mão: mesmas médias, mesma ordem de categorias, mesmos desconhecidos. Qualquer diferença produz predições erradas sem erro nenhum.
Um pickle é um programa
class Innocent:
    def __reduce__(self):                 # diz ao pickle como reconstruir este objeto...
        return (print, ('this line ran while the file was being LOADED',))

obj = pickle.loads(pickle.dumps(Innocent()))   # ...e o carregamento obedece
this line ran while the file was being LOADED
print por os.system e o carregamento roda um comando de shell. Carregue arquivos de modelo apenas de fontes em que você confiaria para rodar código na sua máquina.Fixe as versões
O scikit-learn carimba sua versão em todo estimador que salva. Forjamos um arquivo de outra versão trocando um dígito do carimbo:
InconsistentVersionWarning for: ['StandardScaler', 'OneHotEncoder',
  'ColumnTransformer', 'LogisticRegression', 'Pipeline']
Todo estimador reclama e ainda assim o arquivo carrega. Ele pode predizer diferente.
- guarde as versões (Python, scikit-learn, NumPy) ao lado do modelo, num arquivo de metadados;
- fixe-as no ambiente de serving (
requirements.txt, uma imagem de contêiner); - ao atualizar a biblioteca, retreine e revalide.
Serving: como o modelo é chamado
| padrão | latência | exemplo |
|---|---|---|
| batch | horas | escores de churn gravados num banco de dados toda noite |
| online (uma API, application programming interface, interface de programação) | milissegundos | decisão de crédito durante o checkout |
| streaming | segundos | alertas de fraude num fluxo de transações |
| edge | no dispositivo | previsão de teclado no celular |
O pipeline aceita lixo
| requisição | resposta |
|---|---|
| requisição boa | P(bad) = 0,626 |
| idade = −3 | P(bad) = 0,784 |
| valor em milhares | P(bad) = 0,574 |
propósito desconhecido 'crypto' | P(bad) = 0,519 |
| housing ausente | ValueError: columns are missing |
Só uma. As outras três recebem uma probabilidade que parece tão confiável quanto a da boa.
Um schema e uma função que o verifica
Registre o que o modelo viu no treino (uma faixa por número, uma lista por categoria) e confira cada requisição antes de predizer:
| requisição | status | mensagem |
|---|---|---|
| requisição boa | ok | 0,626 |
| idade = −3 | rejeitada | age: −3 outside training range [19, 75] |
| valor em milhares | rejeitada | credit_amount: 4 outside training range [250, 15945] |
| propósito desconhecido | rejeitada | purpose: unknown category 'crypto' |
| housing ausente | rejeitada | housing: missing |
A mesma função atrás de um endpoint HTTP
HTTP: HyperText Transfer Protocol, o protocolo da web.
# app.py  (ilustrativo: rode com uvicorn, não num notebook)
from fastapi import FastAPI
from service import predict_one           # a função testada

app = FastAPI()

@app.post('/predict')
def predict(payload: dict):
    return predict_one(payload)
predict_one, uma função comum que você testa num notebook.Reprodutibilidade: cada ingrediente tem uma versão
| ingrediente | o que registrar | ferramenta típica |
|---|---|---|
| código | o commit que o treinou | git |
| dados | uma impressão digital e um jeito de recuperar as linhas | DVC (Data Version Control), lakeFS, snapshots |
| ambiente | versões das bibliotecas | lock files, um contêiner |
| aleatoriedade | cada semente | random_state |
| configuração | hiperparâmetros, atributos, limiares | um arquivo de configuração no git |
| resultados | métricas, o artefato | rastreador, registro de modelos |
Sementes: mesmo escore, decisões diferentes
Duas random forests que diferem só na semente:
AUC
probabilidades
decisões
A impressão digital dos dados
training data      68ad024c9661
one value changed  7eb64a1901f0
rows shuffled      a662547f0332
same data again    68ad024c9661
- Um único valor alterado entre 6.000 dá uma impressão digital completamente diferente; outra ordem das linhas também.
- "Foi treinado com a extração deste mês?" vira uma comparação de strings.
Um hash apenas identifica os dados; reconstruir exige as próprias linhas (DVC, lakeFS, snapshots somente leitura).
Monitoramento: modelos se degradam em silêncio
O serviço continua respondendo 200 OK enquanto suas predições pioram. Três camadas: sistema, qualidade dos dados, drift estatístico.
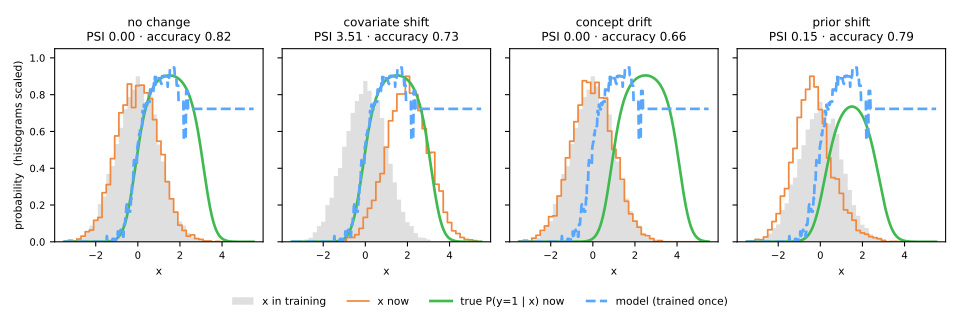
| mudança | o que muda | o que fica fixo | exemplo |
|---|---|---|---|
| covariate shift | \(P(x)\) | \(P(y \mid x)\) | o banco vende para clientes mais jovens |
| concept drift | \(P(y \mid x)\) | \(P(x)\) | uma crise muda quem paga |
| prior shift | \(P(y)\) | \(P(x \mid y)\) | uma epidemia: mais pacientes doentes |
\(x\): as entradas de uma requisição; \(y\): o rótulo dela, o desfecho que o modelo prevê.
PSI à mão: uma faixa de cada vez
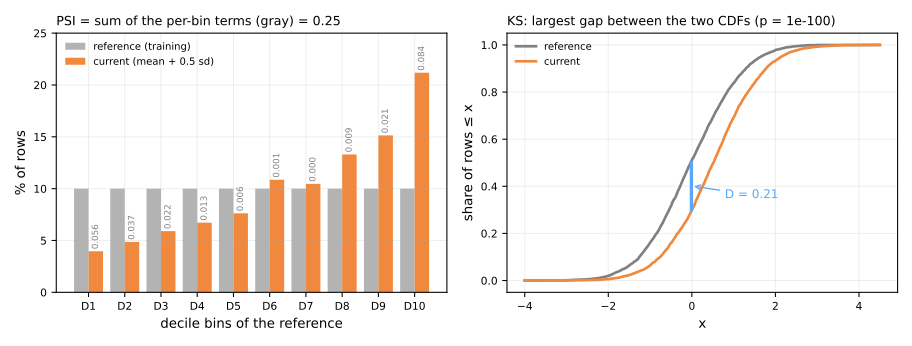
PSI (population stability index, índice de estabilidade populacional): faixas nos quartis do treino, \(e_i\) = fração esperada, \(a_i\) = fração desta semana. Preveja. Qual faixa contribui mais? A soma passa de 0,25?
O que quer dizer PSI = 0,25?
| média deslocada em | 0 | 0,1 dp | 0,25 dp | 0,5 dp | 1 dp |
|---|---|---|---|---|---|
| PSI (10 faixas) | 0,005 | 0,015 | 0,064 | 0,250 | 0,929 |
O nível de alarme é um deslocamento de meio desvio padrão (dp). Sem deslocamento nenhum, o PSI não é exatamente zero: duas amostras nunca têm histogramas idênticos.
Leitura usual (Siddiqi, 2006): abaixo de 0,1, nenhuma mudança relevante · de 0,1 a 0,25, merece atenção · acima de 0,25, significativa.
Simulador: desloque a distribuição de produção
Preveja. Ligue o concept drift sem mexer nas entradas. O que acontece com o PSI e com a acurácia?
A estatística KS, à mão
KS (Kolmogorov–Smirnov): \(D = \max_x |F_{\text{ref}}(x) - F_{\text{cur}}(x)|\), \(F\) = fração da amostra em \(x\) ou abaixo. Referência 1–5, atual 3–7. Preveja. Em que \(x\) a distância é maior?
As duas estatísticas em 5.000 linhas
As três mudanças, medidas
| PSI(x) | p do KS | acurácia | precisão | taxa real | média prevista | |
|---|---|---|---|---|---|---|
| sem mudança | 0,004 | 0,695 | 0,816 | 0,769 | 0,462 | 0,465 |
| covariate shift | 3,505 | 0,000 | 0,728 | 0,729 | 0,720 | 0,780 |
| concept drift | 0,003 | 0,340 | 0,660 | 0,329 | 0,167 | 0,459 |
| prior shift | 0,152 | 0,000 | 0,794 | 0,491 | 0,200 | 0,339 |
Os rótulos chegam atrasados: monitorar em duas velocidades
imediatamente
verificações de qualidade dos dados, PSI ou KS de cada entrada e a distribuição dos próprios escores do modelo: um dos detectores de mudança mais eficazes, por uma linha (Rabanser et al., 2019)
depois, com os desfechos
as métricas de verdade (AUC, precisão, calibração) por lote, contra a estimativa de validação
Resumo
- Distribua o pipeline inteiro, confira a ida e volta, fixe as versões; um pickle é um programa.
- Ponha um schema na frente do modelo: rejeite o impossível, avise sobre o novo, responda com a versão.
- Versione código, dados (uma impressão digital), ambiente, sementes e configuração.
- Meça as mudanças com magnitudes: o PSI faixa a faixa, a estatística KS como a maior distância.
- Monitore entradas e escores na hora, desfechos depois; só os rótulos revelam o concept drift.
| sintoma | o que fazer |
|---|---|
| uma requisição quebrada recebe uma probabilidade com cara de normal | um schema: rejeitar ou avisar |
| o PSI de uma entrada passa de 0,25 | olhar a origem antes de retreinar |
| entradas estáveis, acurácia caindo quando os rótulos chegam | concept drift: métricas de desfecho, rótulos auditados |
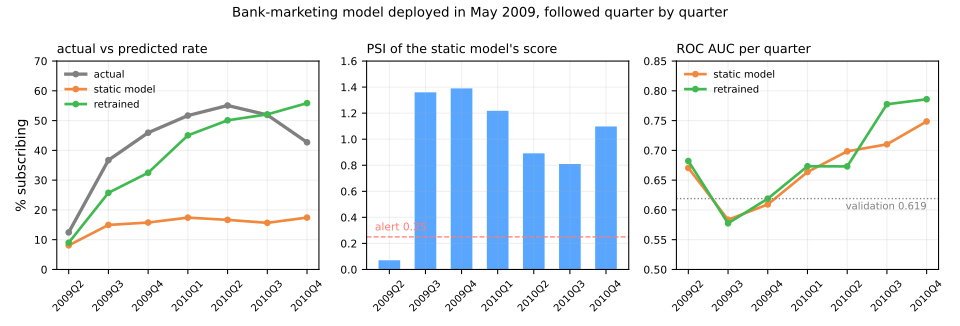
Produção e monitoramento de um modelo de marketing bancário, passos 1 a 8
45.211 ligações de telemarketing, de maio de 2008 a novembro de 2010, na ordem em que foram feitas. Implantado em 1º de maio de 2009, acompanhado por 19 meses.
Construir e validar (1–3), empacotar e proteger (4–6), monitorar sem rótulos (7) e depois com eles (8). Em cada passo, responda o Preveja antes de rodar.
Simulações: o vazamento, em produção (passo 2) e de onde vem o PSI de contact (passo 7).
Notebook do lab (Jupyter ou Colab, Arquivo → Fazer upload de notebook).
Ritmo: passos 1 e 2 e a primeira simulação em 12 min; passos 3 a 6 em 15 min; passo 7 e a segunda em 13 min; passo 8 em 5 min.