Esta aula começa onde as outras terminaram
- Até aqui, toda aula terminava quando o escore de teste era impresso.
- O que gera valor são predições entregues de forma confiável a quem age com base nelas.
- MLOps (machine-learning operations): os hábitos de engenharia que levam um pipeline ajustado para produção e o mantêm confiável depois que ele chega lá.
O modelo é a caixa pequena
Sculley et al. (2015), Hidden Technical Debt in Machine Learning Systems: o código que aprende é uma caixinha cercada de infraestrutura e a maioria das falhas acontece na infraestrutura.
fit + definem o modeloO resto carrega, verifica, empacota, serve, monitora e compara.
O laço e o que o monitor manda de volta
Clique nos botões: o que um alerta de drift manda de volta? E um bug de dados?
Cada seta pode quebrar sem erro nenhum
| etapa | falha em silêncio quando... |
|---|---|
| empacotar | o arquivo carrega em outra versão da biblioteca e prediz diferente |
| servir | uma requisição malformada ainda recebe uma probabilidade com cara de confiável |
| treinar de novo | ninguém sabe dizer que dados, código e semente produziram o modelo em produção |
| monitorar | o mundo muda e o modelo continua respondendo como se não tivesse mudado |
| servir vs treinar | o código de serving calcula um atributo de forma diferente do código de treino |
O caminho desta aula
- Empacotar o modeloo pipeline inteiro, riscos do pickle, versões fixas, skops
- Servir prediçõesbatch ou online, checagem de schema, endpoint, latência
- Reproduzir e versionarsementes, impressão digital dos dados, registro de experimentos
- Monitorar o driftmedir a mudança, rótulos atrasados, retreino
- Mudar com segurançadesalinhamento treino–serving, laços de realimentação, troca segura, maturidade
Empacotamento: o artefato é o pipeline inteiro
Crédito alemão (1.000 empréstimos passados): 3 colunas numéricas e 5 categóricas → scaler + one-hot → regressão logística.
joblib.dump(pipe, path)                  # o pipeline INTEIRO, um arquivo
loaded = joblib.load(path)
np.array_equal(proba, loaded.predict_proba(X_test)[:, 1])
AUC de teste
no disco
ida e volta
Por que não distribuir só o modelo?
LogisticRegression ajustada de dentro do pipeline e dê a ela a tabela crua. O que acontece?
ValueError: X has 8 features, but LogisticRegression is expecting 30 features as input.
- O modelo viu as 30 colunas do column transformer: 3 números padronizados + 27 indicadores one-hot.
- Servi-lo sozinho exige reconstruir essas 30 colunas à mão: mesmas médias, mesma ordem de categorias, mesmos desconhecidos. Qualquer diferença produz predições erradas sem erro nenhum.
Um pickle é um programa
class Innocent:
    def __reduce__(self):                 # diz ao pickle como reconstruir este objeto...
        return (print, ('this line ran while the file was being LOADED',))

obj = pickle.loads(pickle.dumps(Innocent()))   # ...e o carregamento obedece
this line ran while the file was being LOADED
print por os.system e o carregamento roda um comando de shell. Carregue arquivos de modelo apenas de fontes em que você confiaria para rodar código na sua máquina.Fixe as versões
O scikit-learn carimba sua versão em todo estimador que salva. Forjamos um arquivo de outra versão trocando um dígito do carimbo:
InconsistentVersionWarning for: ['StandardScaler', 'OneHotEncoder',
  'ColumnTransformer', 'LogisticRegression', 'Pipeline']
Todo estimador reclama e ainda assim o arquivo carrega. Ele pode predizer diferente.
- guarde as versões (Python, scikit-learn, NumPy) ao lado do modelo, num arquivo de metadados;
- fixe-as no ambiente de serving (
requirements.txt, uma imagem de contêiner); - ao atualizar a biblioteca, retreine e revalide.
Um formato mais seguro: skops
Ao carregar, o skops só reconstrói tipos de uma lista permitida; qualquer outro tipo precisa ser declarado confiável explicitamente.
| pipeline | tipos não confiáveis | carregando sem confiar |
|---|---|---|
| scaler + one-hot + logística | [] | carrega, probabilidades idênticas |
| com uma função própria | ['__main__.cap_amount'] | UntrustedTypesFoundException |
Fora do Python, o ONNX (Open Neural Network Exchange, via skl2onnx) converte um pipeline ajustado num grafo portátil para runtimes em C++, Java ou JavaScript.
Serving: como o modelo é chamado
| padrão | latência | exemplo |
|---|---|---|
| batch | horas | escores de churn gravados num banco de dados toda noite |
| online (API) | milissegundos | decisão de crédito durante o checkout |
| streaming | segundos | alertas de fraude num fluxo de transações |
| edge | no dispositivo | previsão de teclado no celular |
O pipeline aceita lixo
| requisição | resposta |
|---|---|
| requisição boa | P(bad) = 0,626 |
| idade = −3 | P(bad) = 0,784 |
| valor em milhares | P(bad) = 0,574 |
propósito desconhecido 'crypto' | P(bad) = 0,519 |
| housing ausente | ValueError: columns are missing |
Só uma. As outras três recebem uma probabilidade que parece tão confiável quanto a da boa.
Um schema e uma função que o verifica
Registre o que o modelo viu no treino (uma faixa por número, uma lista por categoria) e confira cada requisição antes de predizer:
| requisição | status | mensagem |
|---|---|---|
| requisição boa | ok | 0,626 |
| idade = −3 | rejeitada | age: −3 outside training range [19, 75] |
| valor em milhares | rejeitada | credit_amount: 4 outside training range [250, 15945] |
| propósito desconhecido | rejeitada | purpose: unknown category 'crypto' |
| housing ausente | rejeitada | housing: missing |
A mesma função atrás de um endpoint HTTP
# app.py  (ilustrativo: rode com uvicorn, não num notebook)
from fastapi import FastAPI
from service import predict_one           # a função testada

app = FastAPI()

@app.post('/predict')
def predict(payload: dict):
    return predict_one(payload)
predict_one, uma função comum que você testa num notebook.Latência: paga-se por chamada, não por linha
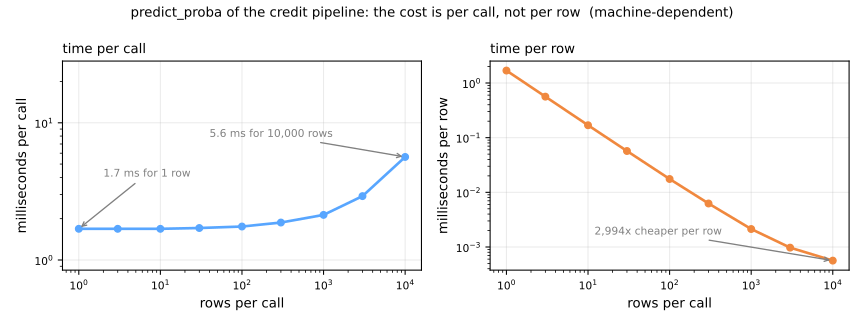
Na máquina que gerou a página: 1,724 ms/linha uma de cada vez, 0,0006 ms/linha num só lote, cerca de 2.700×. Uma chamada custa cerca de 1,7 ms quer carregue uma linha, quer mil: trabalho fixo, não aritmética.
Reprodutibilidade: cada ingrediente tem uma versão
| ingrediente | o que registrar | ferramenta típica |
|---|---|---|
| código | o commit que o treinou | git |
| dados | uma impressão digital e um jeito de recuperar as linhas | DVC, lakeFS, snapshots |
| ambiente | versões das bibliotecas | lock files, um contêiner |
| aleatoriedade | cada semente | random_state |
| configuração | hiperparâmetros, atributos, limiares | um arquivo de configuração no git |
| resultados | métricas, o artefato | rastreador, registro de modelos |
Sementes: mesmo escore, decisões diferentes
Duas random forests que diferem só na semente:
AUC
probabilidades
decisões
A impressão digital dos dados
training data      68ad024c9661
one value changed  7eb64a1901f0
rows shuffled      a662547f0332
same data again    68ad024c9661
- Um único valor alterado entre 6.000 dá uma impressão digital completamente diferente; outra ordem das linhas também.
- "Foi treinado com a extração deste mês?" vira uma comparação de strings.
Um hash apenas identifica os dados; reconstruir exige as próprias linhas (DVC, lakeFS, snapshots somente leitura).
Um registro de experimentos: uma linha por execução, nunca editada
| dados | C | AUC na VC | dp na VC |
|---|---|---|---|
| 68ad024c9661 | 0,01 | 0,7495 | 0,0292 |
| 68ad024c9661 | 0,10 | 0,7599 | 0,0224 |
| 68ad024c9661 | 1,00 | 0,7522 | 0,0244 |
| 68ad024c9661 | 10,00 | 0,7442 | 0,0230 |
VC: validação cruzada; dp: desvio padrão entre folds.
C = 0.1 sobre C = 1 (0,0077) fica muito abaixo dos desvios padrão entre folds (cerca de 0,02): trate-as como empatadas. Guarde as execuções perdedoras: elas registram quantas coisas foram tentadas.Monitoramento: modelos se degradam em silêncio
O serviço continua respondendo 200 OK enquanto suas predições pioram. Três camadas: sistema, qualidade dos dados, drift estatístico.
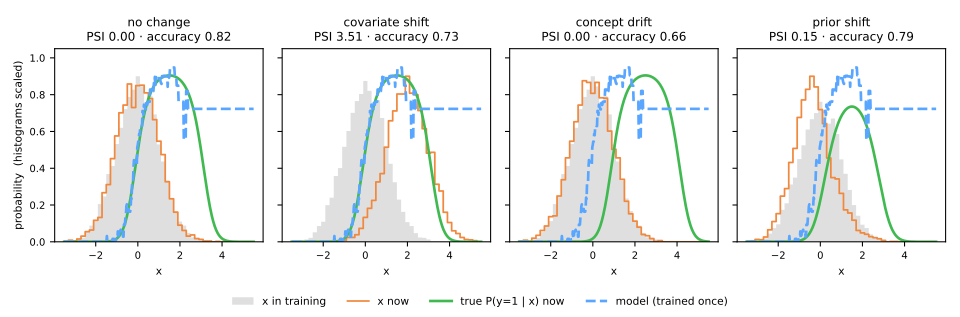
| mudança | o que muda | o que fica fixo | exemplo |
|---|---|---|---|
| covariate shift | \(P(x)\) | \(P(y \mid x)\) | o banco vende para clientes mais jovens |
| concept drift | \(P(y \mid x)\) | \(P(x)\) | uma crise muda quem paga |
| prior shift | \(P(y)\) | \(P(x \mid y)\) | uma epidemia: mais pacientes doentes |
Medindo uma mudança: o PSI, à mão
PSI: índice de estabilidade populacional (population stability index).
\[ \text{PSI} = \sum_{i=1}^{B} (a_i - e_i)\,\ln\frac{a_i}{e_i} \]| faixa | \(e_i\) | \(a_i\) | \(\ln(a_i/e_i)\) | termo |
|---|---|---|---|---|
| 1 | 0,25 | 0,10 | −0,916 | 0,1374 |
| 2 | 0,25 | 0,20 | −0,223 | 0,0112 |
| 3 | 0,25 | 0,30 | +0,182 | 0,0091 |
| 4 | 0,25 | 0,40 | +0,470 | 0,0705 |
| PSI | 0,228 |
Faixas cortadas nos quartis do treino. Todo termo é positivo.
< 0,1 nenhuma mudança relevante · 0,1–0,25 merece atenção · > 0,25 significativa (Siddiqi, 2006)
O que quer dizer PSI = 0,25?
| média deslocada em | 0 | 0,1 dp | 0,25 dp | 0,5 dp | 1 dp |
|---|---|---|---|---|---|
| PSI (10 faixas) | 0,005 | 0,015 | 0,064 | 0,250 | 0,929 |
O nível de alarme é um deslocamento de meio desvio padrão (dp). Sem deslocamento nenhum, o PSI não é exatamente zero: duas amostras nunca têm histogramas idênticos.
Simulador: PSI faixa a faixa
Preveja. Ligue o concept drift sem mexer nas entradas. O que acontece com o PSI e com a acurácia?
Medindo uma mudança: o teste KS
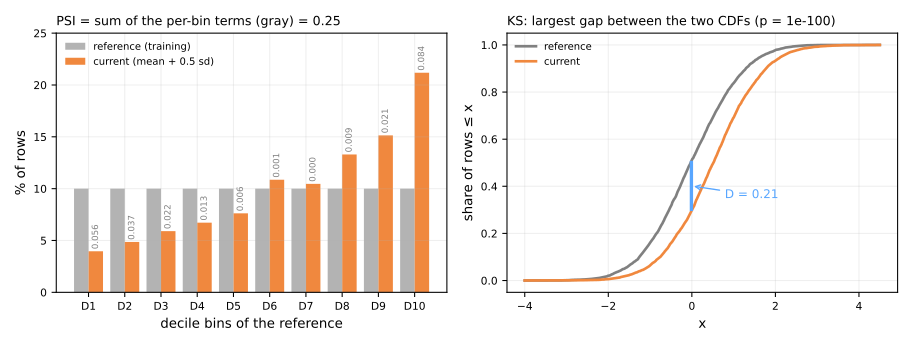
KS: Kolmogorov–Smirnov.
\[ D = \max_x \left| F_{\text{ref}}(x) - F_{\text{cur}}(x) \right| \]À mão, 1–5 contra 3–7: \(D = 0{,}4\), \(p = 0{,}873\): nada surpreendente com cinco pontos de cada lado.
| deslocamento de 0,02 dp, n = | 1.000 | 10.000 | 100.000 | 1.000.000 |
|---|---|---|---|---|
| p-valor do KS | 0,097 | 0,14 | 0,00049 | 1,6e-41 |
| PSI | 0,0344 | 0,0018 | 0,0004 | 0,0005 |
As três mudanças, medidas
| PSI(x) | p do KS | acurácia | precisão | taxa real | média prevista | |
|---|---|---|---|---|---|---|
| sem mudança | 0,004 | 0,695 | 0,816 | 0,769 | 0,462 | 0,465 |
| covariate shift | 3,505 | 0,000 | 0,728 | 0,729 | 0,720 | 0,780 |
| concept drift | 0,003 | 0,340 | 0,660 | 0,329 | 0,167 | 0,459 |
| prior shift | 0,152 | 0,000 | 0,794 | 0,491 | 0,200 | 0,339 |
Os rótulos chegam atrasados: monitorar em duas velocidades
imediatamente
verificações de qualidade dos dados, PSI ou KS de cada entrada e a distribuição dos próprios escores do modelo: um dos detectores de mudança mais eficazes, por uma linha (Rabanser et al., 2019)
depois, com os desfechos
as métricas de verdade (AUC, precisão, calibração) por lote, contra a estimativa de validação
Degradar, detectar, retreinar
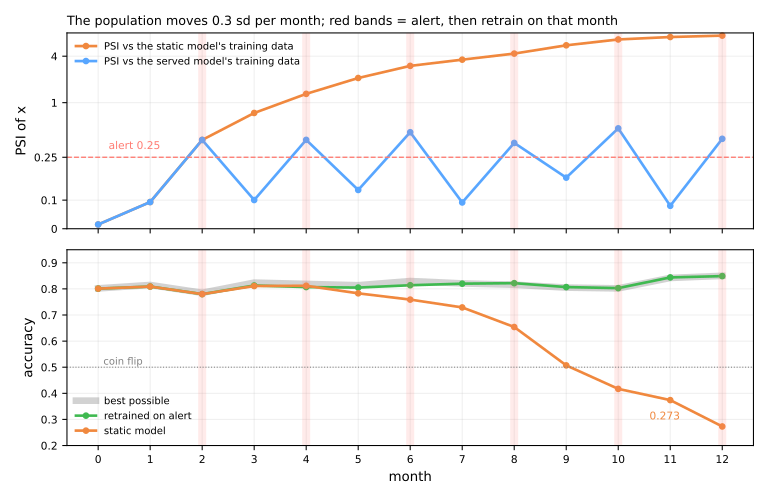
A população se move 0,3 dp por mês. Modelo estático vs um modelo retreinado sempre que o PSI da sua entrada passa de 0,25.
| mês | estático | monitorado | melhor possível |
|---|---|---|---|
| 0 | 0,801 | 0,801 | 0,802 |
| 2 (alerta) | 0,780 | 0,780 | 0,785 |
| 6 | 0,759 | 0,814 | 0,830 |
| 8 | 0,654 | 0,822 | 0,816 |
| 12 | 0,273 | 0,849 | 0,850 |
Desalinhamento treino–serving, medido
Um novo aplicativo cliente manda um campo em outra unidade. O conjunto de teste, de três jeitos:
| AUC | sinalizados | decisões mudadas | rejeitados pelo schema | |
|---|---|---|---|---|
| como no treino | 0,783 | 20,0% | 0,0% | 1% |
| valor em milhares | 0,775 | 14,8% | 5,2% | 100% |
| duração em anos | 0,751 | 2,8% | 17,2% | 93% |
Colocando um modelo novo no ar com segurança
Primeiro um portão de avaliação: vencer o modelo atual em dados recentes e rotulados que nenhum dos dois viu, por mais do que o ruído. Depois, liberar em etapas:
| estratégia | como | protege de |
|---|---|---|
| shadow | pontua o tráfego real, respostas só registradas | quedas, latência, escores estranhos |
| canary | 1–5% do tráfego | problemas que só aparecem com usuários reais |
| teste A/B | divisão aleatória, uma métrica de negócio | "AUC melhor" que não é resultado melhor |
| rollback | o artefato anterior fica pronto | todo o resto, em minutos |
Testes, documentação e maturidade
O ML Test Score
28 testes em 4 grupos: dados, desenvolvimento do modelo, infraestrutura, monitoramento (Breck et al., 2017). A nota é o mínimo entre os grupos.
Model card
uso pretendido, fatores, métricas, dados de treino e de avaliação, considerações éticas, ressalvas (Mitchell et al., 2019)
Uma escada sensata
- script + artefatos versionados
- CI/CD (integração e entrega contínuas): testes antes de qualquer modelo ir para produção
- logs, painéis, alertas de drift
- retreino com portões e rollback
Suba quando a dor justificar.
Produção e monitoramento de um modelo de marketing bancário
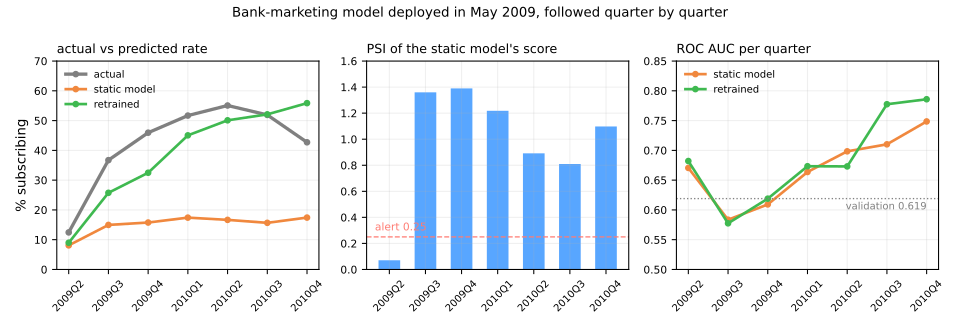
45.211 ligações de telemarketing, de maio de 2008 a novembro de 2010, na ordem em que foram feitas. Implantado em 1º de maio de 2009, acompanhado por 19 meses.
Construir e validar (1–3), empacotar e proteger (4–6), monitorar (7–9), retreinar (10), escrever o model card (11).
O PSI do escore salta para acima de 0,8 a partir do segundo trimestre: o monitor isolado mais barato e mais útil.
Notebook do lab (Jupyter ou Colab, Arquivo → Fazer upload de notebook).
Resumo
- Distribua o pipeline inteiro, confira a ida e volta, fixe as versões; um pickle é um programa.
- Ponha um schema na frente do modelo e responda com a versão dele.
- Versione código, dados (um hash), ambiente, sementes e resultados.
- Monitore entradas e escores na hora, desfechos depois; PSI para magnitudes.
- Drift não é dano; concept drift exige rótulos.
- Modelos novos passam por um portão e são liberados em etapas, com rollback pronto.