Seleção de Modelos
Você já encontrou o sobreajuste muitas vezes: o polinômio de grau 15 da aula de gradiente descendente, as ilhas que o k-vizinhos mais próximos (k-NN, do inglês k-Nearest Neighbors) desenha em torno de pontos isolados quando \(k = 1\) (aula de k-NN), a curva de C do lab de validação cruzada e, nesta seção, a árvore de decisão que cresce até decorar, a random forest que tira essa variância pela média e o gradient boosting que precisa ser parado antes da hora. A aula de validação cruzada deu então a maquinaria para escolher com honestidade: validação cruzada (CV, do inglês cross-validation), GridSearchCV, comparações fold a fold, a regra de um erro-padrão e a CV aninhada. Esta aula fecha a seção de modelos e não repete essa maquinaria. Ela trata do porquê e do para que lado: por que todo modelo falha em uma de duas direções opostas, como dizer, a partir dos dados, em qual das duas você está e o que fazer em cada caso.
A teoria é a decomposição viés–variância, que não vamos só enunciar, mas medir, número por número, em um problema cuja verdade conhecemos. As ferramentas práticas são as curvas de validação e as curvas de aprendizado. A armadilha mais antiga é a regressão à média. E a aula termina com um resultado que põe os pés no chão, não existe almoço grátis: nenhuma família de modelos vence em todo lugar, então escolher entre famílias faz parte do trabalho. Todo número citado abaixo vem dos blocos de código ou dos scripts de figura ao lado desta página.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula no Colab; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Meu modelo erra por ser rígido demais ou por dar ouvidos demais à amostra? E o que fazer em cada caso? | Como escolher entre famílias de modelos sem se enganar com a sorte |
| conteúdo | viés, variância e ruído; a decomposição medida; curvas de validação; curvas de aprendizado; o diagnóstico; os botões de complexidade | número efetivo de parâmetros, regressão à média, a família como hiperparâmetro, não existe almoço grátis, a navalha de Occam, o fluxo completo |
| lab em aula | preços de casas: diagnosticar e tratar, passos 1 a 6 | selecionar e testar, passos 7 a 9 |
| ao final, você sabe | dizer, por duas curvas, se um modelo sofre de viés ou de variância; prever se mais dados vão ajudar; girar o botão certo para o lado certo | comparar famílias numa única busca; reconhecer um empate; desconfiar da nota do vencedor; medir a precisão da nota de teste |
Os dois labs usam o mesmo notebook no Colab: a parte fundamental vai do passo 1 ao 6; a avançada, do 7 ao 9. Tudo roda no navegador; não é preciso baixar nada.
Abordagem fundamental
Uma pergunta guia esta parte: quando um modelo erra, ele erra por quê? Há só duas direções possíveis, opostas, e cada uma tem um remédio que piora a outra. Esta parte mede as duas num problema cuja verdade conhecemos e depois ensina a reconhecê-las, sem conhecer a verdade, a partir de duas curvas.
Esta parte segue um pipeline em quatro etapas, desenhado abaixo: 1. duas maneiras de errar, subajuste e sobreajuste em muitos ajustes de uma verdade; 2. decompor o erro em viés², variância e ruído, medidos; 3. diagnosticar com curvas, as curvas de validação e de aprendizado quando a verdade é desconhecida; 4. girar o botão, o botão de complexidade de cada família, posto em prática no lab. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Duas maneiras de errarmuitos ajustes de uma verdade: subajuste e sobreajuste
- Decompor o erroviés² + variância + ruído, medidos
- Diagnosticar com curvascurva de validação, curva de aprendizado, o diagnóstico
- Girar o botãoo botão de complexidade de cada família, depois o lab: diagnosticar e tratar
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Duas maneiras de errar
Etapa 1. Para ver o que um modelo erra sistematicamente, você precisaria de algo que nenhum projeto real tem: muitos conjuntos de treino independentes, tirados da mesma fonte. Em um problema que nós inventamos, dá para ter. A verdade é \(f(x) = \sin(2\pi x)\) em \([0, 1]\); um conjunto de treino são 30 pontos \(x\) sorteados, cada um com \(y = f(x)\) mais um ruído gaussiano de desvio-padrão 0,3. Sorteamos cinco desses conjuntos, ajustamos polinômios de grau 1, 3 e 12 em cada um e olhamos o que cada modelo ajustado prevê em um ponto, \(x = 0{,}25\), onde a verdade é \(f(0{,}25) = 1\):
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler


def f(x):                                          # a verdade, que na vida real ninguém conhece
    return np.sin(2 * np.pi * x)


def poly(degree):
    return make_pipeline(PolynomialFeatures(degree), StandardScaler(), LinearRegression())


rng = np.random.default_rng(0)
x0 = np.array([[0.25]])                            # o ponto que observamos; f(0.25) = 1
print('training set   degree 1   degree 3   degree 12')
for s in range(5):
    x = rng.uniform(0, 1, 30)                      # uma amostra nova de 30 pontos...
    y = f(x) + rng.normal(0, 0.3, 30)              # ...com ruído de desvio-padrão 0.3
    preds = [poly(d).fit(x.reshape(-1, 1), y).predict(x0)[0] for d in (1, 3, 12)]
    print(f"{s + 1:12d}   " + '   '.join(f"{p:8.2f}" for p in preds))
training set   degree 1   degree 3   degree 12
           1       0.24       1.09       1.05
           2       0.57       1.05       1.06
           3       0.60       0.97       0.95
           4       0.39       1.18       1.29
           5       0.43       1.01       1.08
Um exemplo resolvido, à mão. Tome a coluna do grau 1. As cinco previsões têm média \((0{,}24 + 0{,}57 + 0{,}60 + 0{,}39 + 0{,}43)/5 = 0{,}446\). A verdade é 1, então a reta erra por \(0{,}446 - 1 = -0{,}554\) em média: esse erro sistemático é o viés, cujo quadrado é \(0{,}307\). Em torno da própria média, as cinco previsões se espalham por \(-0{,}206, +0{,}124, +0{,}154, -0{,}056, -0{,}016\); a média dos quadrados, \((0{,}0424 + 0{,}0154 + 0{,}0237 + 0{,}0031 + 0{,}0003)/5 = 0{,}017\), é a variância. Para o grau 3, a mesma conta dá média 1,060, logo um viés de apenas 0,060 (ao quadrado: 0,0036) e uma variância de \((0{,}03^2 + 0{,}01^2 + 0{,}09^2 + 0{,}12^2 + 0{,}05^2)/5 = 0{,}0052\).
O simulador faz esta conta um conjunto de treino por vez, para os graus 1, 3 e 12: os cinco primeiros conjuntos são os de cima, e mais quinze mostram as estimativas se assentando.
Os dois números respondem a perguntas diferentes. Viés: se eu pudesse fazer a média sobre todos os conjuntos de treino que poderiam ter caído na minha mão, eu acertaria? Variância: quanto a minha resposta depende de qual conjunto de treino eu recebi? A reta erra em \(x = 0{,}25\) do mesmo jeito todas as vezes: ela não consegue se curvar. O grau 12 parece quase tão bom quanto o grau 3 neste ponto — um alerta contra olhar um ponto só. A figura abaixo desenha curvas inteiras, 20 por grau, tiradas dos 500 conjuntos de treino usados na próxima seção (script da figura):
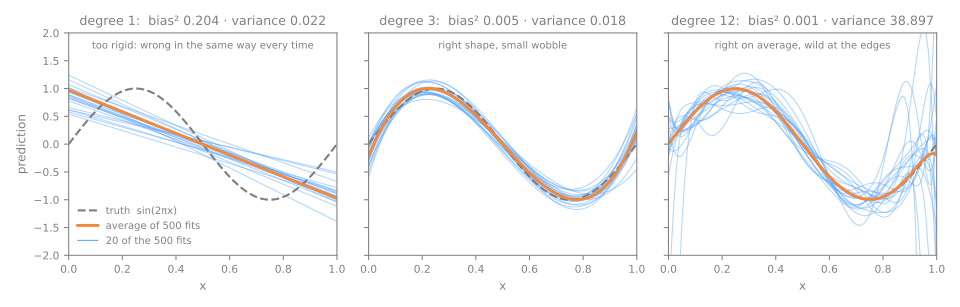
Os ajustes de grau 1 (à esquerda) concordam entre si e estão todos errados: viés alto, variância baixa. Os de grau 12 (à direita) acertam na média (a média laranja de 500 ajustes fica quase em cima da verdade), mas qualquer um deles, sozinho, pode estar longe, sobretudo perto das bordas, onde um conjunto de treino pode não ter nenhum ponto e o polinômio fica livre para subir ou descer: viés baixo, variância alta. O grau 3 (no meio) tem os dois pequenos. A primeira falha se chama subajuste; a segunda, sobreajuste.
A imagem clássica dessas duas falhas é um alvo. Cada dardo é um modelo, treinado numa amostra diferente; o centro é a verdade. O viés é a distância entre o centro e o ponto médio dos dardos; a variância é o quanto os dardos se espalham em torno desse ponto médio. Os rótulos usam os números medidos na próxima seção (script da figura):
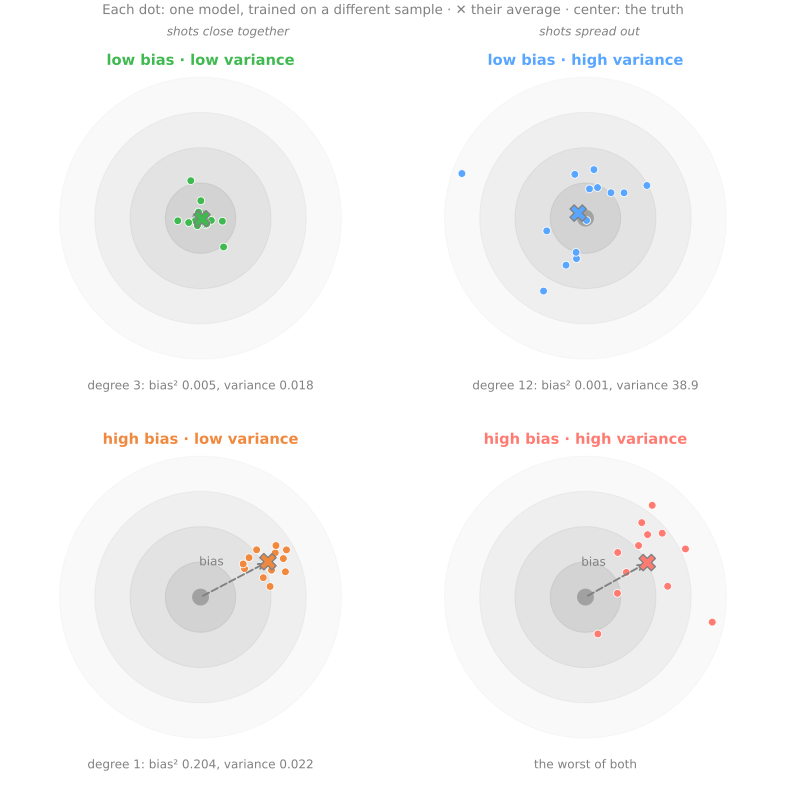
Repare no alvo de cima, à direita: a média dos dardos acerta o centro, mas nenhum dardo isolado é confiável. É o modelo que parece ótimo "em média" e decepciona no único conjunto de treino que você realmente tem.
2. O trade-off viés–variância
Etapa 2. Para o erro quadrático, as duas quantidades do exemplo resolvido, mais o ruído, somam exatamente o erro de teste esperado. Fixe um ponto \(x\). Uma observação nova ali é \(y = f(x) + \varepsilon\), com ruído \(\varepsilon\) de média 0 e variância \(\sigma^2\). A previsão \(\hat f(x)\) também é aleatória, porque depende do conjunto de treino. Tirando a média sobre os dois:
Por que a soma fecha, em duas linhas. Primeiro, \(y - \hat f = (f - \hat f) + \varepsilon\); o ruído novo \(\varepsilon\) é independente do conjunto de treino e tem média 0, então o termo cruzado some e \(\mathbb{E}[(y - \hat f)^2] = \mathbb{E}[(f - \hat f)^2] + \sigma^2\). Segundo, para qualquer quantidade aleatória \(Z\), \(\mathbb{E}[Z^2] = (\mathbb{E}[Z])^2 + \operatorname{Var}(Z)\) (a média dos quadrados é o quadrado da média mais o espalhamento); com \(Z = f - \hat f\), isso é viés² + variância. Em \(x = 0{,}25\), os cinco conjuntos do exemplo resolvido põem o erro esperado do grau 1 em cerca de \(0{,}307 + 0{,}017 + 0{,}09 = 0{,}414\) e o do grau 3 em cerca de \(0{,}0036 + 0{,}0052 + 0{,}09 = 0{,}099\).
- Viés é o erro da melhor tentativa da família de modelos em média: uma reta não acompanha um seno, por mais amostras que veja;
- Variância é o preço de dar ouvidos à amostra específica: quanto mais liberdade o modelo tem, mais a resposta muda quando a amostra muda;
- Ruído \(\sigma^2\) é a parte de \(y\) que não depende de \(x\). Aqui \(\sigma^2 = 0{,}3^2 = 0{,}09\); nenhum modelo consegue ficar abaixo disso.
Medido, com 500 conjuntos de treino
Cinco conjuntos de treino dão uma ideia; 500 dão números bem mais estáveis. A função abaixo treina um modelo em 500 conjuntos de treino novos, registra suas previsões em 101 pontos espalhados por \([0, 1]\) e também avalia cada modelo ajustado em dados de teste novos, para que a decomposição possa ser conferida contra uma medida direta:
def bias_variance(make_model, n_sets=500, n=30, sigma=0.3, seed=0):
    """Treina make_model() em n_sets amostras novas; divide o erro de teste em três partes."""
    rng = np.random.default_rng(seed)              # mesma semente -> todo modelo vê as mesmas amostras
    x_grid = np.linspace(0, 1, 101)                # onde olhamos as previsões
    preds, test_mse = [], []
    for _ in range(n_sets):
        x = rng.uniform(0, 1, n)
        y = f(x) + rng.normal(0, sigma, n)
        p = make_model().fit(x.reshape(-1, 1), y).predict(x_grid.reshape(-1, 1))
        y_new = f(x_grid) + rng.normal(0, sigma, x_grid.size)     # dados de teste novos
        preds.append(p)
        test_mse.append(np.mean((y_new - p) ** 2))
    preds = np.array(preds)                                   # n_sets x 101
    bias2 = np.mean((preds.mean(axis=0) - f(x_grid)) ** 2)    # curva média vs verdade
    variance = np.mean(preds.var(axis=0))                     # espalhamento em torno da curva média
    return bias2, variance, sigma ** 2, np.mean(test_mse)


print('degree   bias²   variance   noise     sum   measured test MSE')
for d in [0, 1, 3, 5, 7, 9, 12]:
    b2, var, noise, mse = bias_variance(lambda: poly(d))
    print(f"{d:6d} {b2:7.3f} {var:10.3f} {noise:7.2f} {b2 + var + noise:7.3f} {mse:10.3f}")
degree   bias²   variance   noise     sum   measured test MSE
     0   0.495      0.020    0.09   0.605      0.603
     1   0.204      0.022    0.09   0.316      0.314
     3   0.005      0.018    0.09   0.113      0.112
     5   0.000      0.045    0.09   0.135      0.135
     7   0.001      0.635    0.09   0.726      0.723
     9   0.005      3.434    0.09   3.529      3.525
    12   0.001     38.897    0.09  38.987     38.985
Como ler:
- As colunas fecham. Em todos os graus, viés² + variância + ruído bate com o erro quadrático médio (MSE, do inglês mean squared error) de teste medido diretamente em dados novos, com diferença de no máximo 0,004. Essa concordância não tem como falhar: a decomposição é uma identidade, então as duas colunas concordam por construção, a menos do ruído dos dados de teste novos. Não é uma metáfora: é aritmética e aqui dá para vê-la funcionar.
- O viés cai e depois fica em zero. O grau 0 (uma constante) tem viés² 0,495; o grau 1 o reduz para 0,204; do grau 3 em diante ele é praticamente 0, porque uma cúbica já consegue acompanhar um período de seno.
- A variância sobe, devagar e depois com violência. 0,018 no grau 3, 0,045 no grau 5, 0,635 no grau 7, 38,897 no grau 12. Com 30 pontos e 13 coeficientes, basta uma amostra azarada (um buraco perto de uma borda) para a curva disparar. Leia as variâncias grandes como ordens de grandeza, não como valores precisos: um punhado das 500 amostras produz a maior parte delas, então outra semente muda bastante esses dígitos. A forma de U e o fundo no grau 3 não mudam.
- A soma tem forma de U, com o fundo no grau 3: 0,113, apenas 0,023 acima do piso de ruído de 0,09. É o melhor que um polinômio consegue com 30 pontos deste problema e a resposta que a seleção de modelos deveria encontrar.
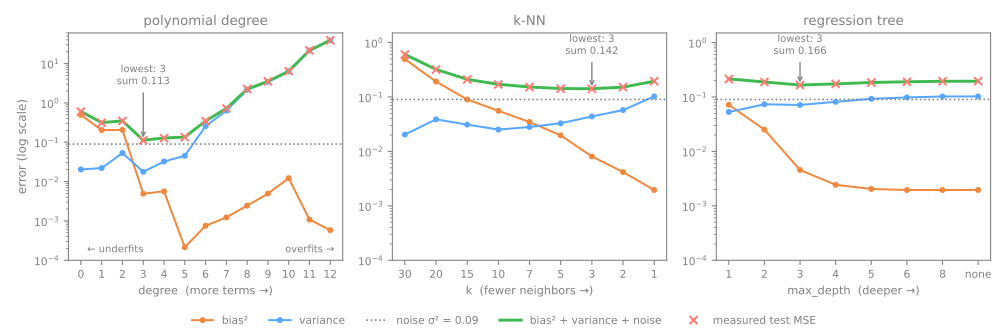
Eis o mesmo experimento para todos os graus de 0 a 12 e para os botões de complexidade de duas outras famílias (script da figura):
As mesmas três famílias de curvas, rodadas com a mesma função:
from sklearn.neighbors import KNeighborsRegressor
from sklearn.tree import DecisionTreeRegressor

print('k-NN:  k   bias²   variance  test MSE')
for k in [30, 15, 7, 3, 1]:
    b2, var, noise, mse = bias_variance(lambda: KNeighborsRegressor(n_neighbors=k))
    print(f"{k:10d} {b2:7.3f} {var:10.3f} {mse:9.3f}")
print('tree: depth  bias²   variance  test MSE')
for depth in [1, 2, 3, 5, None]:
    b2, var, noise, mse = bias_variance(lambda: DecisionTreeRegressor(max_depth=depth, random_state=0))
    print(f"{str(depth):>11s} {b2:7.3f} {var:10.3f} {mse:9.3f}")
k-NN:  k   bias²   variance  test MSE
        30   0.495      0.020     0.603
        15   0.090      0.031     0.210
         7   0.035      0.028     0.152
         3   0.008      0.044     0.141
         1   0.002      0.102     0.195
tree: depth  bias²   variance  test MSE
          1   0.072      0.053     0.214
          2   0.025      0.073     0.188
          3   0.005      0.071     0.166
          5   0.002      0.093     0.185
       None   0.002      0.102     0.195
Três fatos desta tabela podem ser previstos à mão, o que é um bom teste para saber se a decomposição faz sentido para você:
- O k-NN com \(k = 30\) é o polinômio de grau 0. Com 30 pontos de treino, os 30 vizinhos mais próximos de qualquer \(x\) são todos eles, então a previsão é a média de \(y\), em todo lugar. Seus números (viés² 0,495, variância 0,020, MSE 0,603) são os do grau 0 na tabela anterior. No k-NN o botão gira ao contrário: \(k\) pequeno é o modelo complexo, como você viu na aula de k-NN.
- O 1-NN tem variância \(\approx \sigma^2\) e erro de teste \(\approx 2\sigma^2\). A previsão em \(x\) é o \(y\) do ponto de treino mais próximo, ou seja, a verdade perto de \(x\) mais o ruído daquele ponto. Então sua variância é mais ou menos a variância do ruído, 0,09 (medido: 0,102, um pouco mais porque o ponto mais próximo muda de lugar), seu viés é quase zero (0,002) e seu erro de teste fica em torno de \(0{,}09 + 0{,}09 = 0{,}18\) (medido: 0,195): uma dose de ruído no rótulo de treino que ele copia, outra no rótulo de teste.
- Uma árvore crescida até o fim é o 1-NN, aqui. Sem limite de profundidade, uma árvore de regressão em um único atributo continua dividindo até cada folha ter um ponto de treino, cortando no meio do caminho entre valores vizinhos de \(x\): ela prevê o \(y\) do ponto mais próximo. Sua linha (0,002, 0,102, 0,195) é idêntica à do 1-NN. Como na aula de árvores de decisão,
max_depthé o botão delas; aqui a profundidade 3 é a melhor (0,166).
Todo botão desenha o mesmo U. As famílias diferem em quão baixo chega o fundo do U. Em MSE de teste medido: 0,112 para o polinômio (grau 3), 0,141 para o k-NN (\(k = 3\)), 0,166 para a árvore (profundidade 3). Um seno é suave e uma família suave vence quando a verdade é suave; com outra verdade a ordem muda, que é o assunto da seção 10.
Explore o trade-off você mesmo. O simulador ajusta polinômios a 22 pontos ruidosos do mesmo seno e os avalia em outros 22; deslize do grau 0 (puro viés) ao 12 (pura variância) e veja os dois erros se separarem:
3. Curvas de validação: o U a partir de um único conjunto de dados
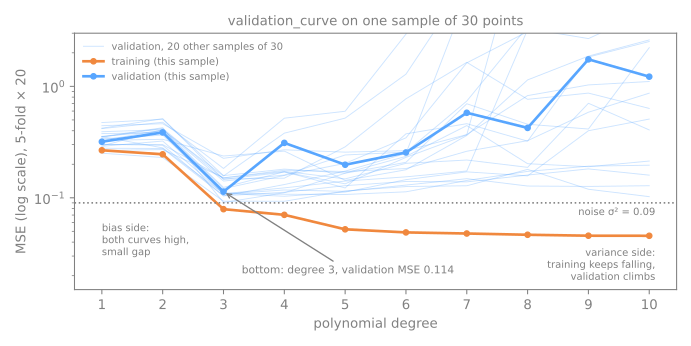
Etapa 3. Em um projeto real há um conjunto de dados e nenhuma verdade, então a decomposição não pode ser calculada. O que você pode calcular é a soma, aproximadamente: a validação cruzada estima o erro de teste de cada configuração. Uma curva de validação faz isso para cada valor de um hiperparâmetro e devolve também o erro de treino. É a imagem da curva de C da aula de validação cruzada; o scikit-learn tem uma função para ela. Em uma amostra de 30 pontos do mesmo seno, com CV 5-fold repetida 20 vezes para estabilizar a estimativa:
from sklearn.model_selection import RepeatedKFold, validation_curve

rng = np.random.default_rng(1)
x = rng.uniform(0, 1, 30)
y = f(x) + rng.normal(0, 0.3, 30)                  # UMA amostra: tudo o que se tem na prática
X = x.reshape(-1, 1)

degrees = np.arange(1, 11)
rcv = RepeatedKFold(n_splits=5, n_repeats=20, random_state=0)
train, val = validation_curve(poly(1), X, y, param_name='polynomialfeatures__degree',
                              param_range=degrees, cv=rcv, scoring='neg_mean_squared_error')
train, val = -train.mean(axis=1), -val.mean(axis=1)    # o scikit-learn maximiza: o MSE vem negativo
print('degree  train MSE  validation MSE     gap')
for d, tr, va in zip(degrees, train, val):
    print(f"{d:6d} {tr:10.3f} {va:15.3f} {va - tr:7.3f}")
degree  train MSE  validation MSE     gap
     1      0.267           0.319   0.052
     2      0.246           0.386   0.140
     3      0.079           0.114   0.034
     4      0.070           0.311   0.241
     5      0.052           0.198   0.146
     6      0.049           0.255   0.206
     7      0.048           0.579   0.532
     8      0.047           0.424   0.377
     9      0.046           1.748   1.702
    10      0.046           1.222   1.176
Como ler uma curva de validação:
- A curva de treino só desce (0,267 no grau 1, 0,046 no grau 10). Mais liberdade sempre ajusta melhor a amostra que você tem. Ela não enxerga o sobreajuste; escolher por ela levaria ao modelo mais complexo toda vez.
- À esquerda do fundo: o lado do viés. Nos graus 1 e 2 os dois erros são altos (treino 0,25–0,27, validação 0,32–0,39) e a distância entre eles é modesta perto do que vem depois. O modelo erra nos dados que viu quase tanto quanto nos que não viu.
- À direita do fundo: o lado da variância. O erro de treino continua caindo enquanto o de validação sobe, até 1,748 no grau 9: a distância entre as curvas é a assinatura da variância.
- O fundo, grau 3 com 0,114, cai onde a decomposição com 500 amostras o colocou. Uma amostra de 30 pontos, poucas linhas de código e a mesma resposta da simulação que conhecia a verdade.
A figura acrescenta um alerta. As linhas finas são as curvas de validação de 20 outras amostras de 30 pontos. Do lado esquerdo elas concordam; do lado direito se espalham por três ordens de grandeza (a maior parte dessa faixa fica acima do topo do gráfico, cortado em 3); mesmo a curva desta amostra faz zigue-zague (0,311 no grau 4, 0,198 no grau 5). Modelos de alta variância não só preveem de forma errática: suas notas de validação também são erráticas, porque um único fold que explode domina a média. É mais um motivo para preferir a ponta simples de um fundo achatado, a regra de um erro-padrão da aula de validação cruzada.
A árvore de churn, um cliente de fora por vez
A mesma curva cabe num exemplo que dá para acompanhar cliente por cliente: os 12 clientes de churn da aula de árvores de decisão, com tenure e bill, e o botão max_depth. Com 12 linhas, a validação cruzada mais natural é a leave-one-out da aula de validação cruzada: 12 folds, cada um deixando um cliente de fora para ser previsto pela árvore crescida nos outros 11. A profundidade 0 é o modelo sem pergunta, que diz "fica" para todo mundo:
import pandas as pd
from sklearn.dummy import DummyClassifier
from sklearn.model_selection import LeaveOneOut, cross_val_score
from sklearn.tree import DecisionTreeClassifier

customers = pd.DataFrame({
    'tenure': [2, 3, 5, 6, 8, 11, 14, 19, 24, 30, 38, 50],               # meses como cliente
    'bill':   [95, 120, 60, 110, 45, 130, 70, 115, 55, 125, 100, 65],    # conta mensal, R$
    'churn':  [1, 1, 0, 1, 0, 1, 0, 0, 0, 1, 0, 0],                      # 1 = cancelou
}, index=list('ABCDEFGHIJKL'))
X_ch, y_ch = customers[['tenure', 'bill']], customers['churn']

print('max_depth   train   leave-one-out')
for d in [0, 1, 2, 3]:                             # 0 = sem pergunta: sempre a classe mais comum
    model = DummyClassifier() if d == 0 else DecisionTreeClassifier(max_depth=d, random_state=0)
    train = model.fit(X_ch, y_ch).score(X_ch, y_ch)
    loo = cross_val_score(model, X_ch, y_ch, cv=LeaveOneOut()).mean()
    print(f"{d:9d} {train:7.3f} {loo:15.3f}")
- O treino só sobe: 0,583, 0,833, 0,917 e, na profundidade 3, 1,000. A árvore completa acerta todos os 12 clientes que viu.
- A validação para e depois cai: 0,667 nas profundidades 1 e 2 e 0,583 na 3, a mesma nota do modelo sem pergunta. A terceira pergunta da árvore completa,
bill ≤ 120, existia só para isolar o cliente J; a aula de árvores perguntava se aquilo era padrão ou acidente, e o leave-one-out responde: acidente. - As profundidades 1 e 2 empatam; num empate, fique com a mais simples.
O simulador refaz a conta fold a fold: para cada profundidade, a árvore crescida nos 12 e depois as 12 árvores com um cliente de fora, cada uma prevendo o seu. À direita, a curva de validação vai se formando. Preveja antes de rodar: na profundidade 3, a árvore que deixa J de fora acerta J?
4. Curvas de aprendizado: mais dados valem a pena?
Uma curva de validação varia a complexidade com uma quantidade fixa de dados. Uma curva de aprendizado faz o contrário: fixa o modelo e varia o número de linhas de treino. Ela responde à pergunta mais cara de um projeto: mais dados ajudariam? Tome uma amostra maior (1.000 pontos do mesmo seno) e compare um modelo que sabemos ser rígido demais (grau 1) com um que tem mais liberdade do que 30 pontos conseguem sustentar (grau 9):
from sklearn.model_selection import KFold, learning_curve

rng = np.random.default_rng(3)
x = rng.uniform(0, 1, 1000)
y = f(x) + rng.normal(0, 0.3, 1000)
X = x.reshape(-1, 1)
cv = KFold(n_splits=5, shuffle=True, random_state=0)

for d in [1, 9]:
    sizes, train, val = learning_curve(poly(d), X, y, train_sizes=[15, 30, 60, 120, 250, 500, 800],
                                       cv=cv, scoring='neg_mean_squared_error')
    print(f"degree {d}   n: " + ' '.join(f"{n:7d}" for n in sizes))
    print("   train MSE: " + ' '.join(f"{v:7.3f}" for v in -train.mean(axis=1)))
    print("   valid MSE: " + ' '.join(f"{v:7.3f}" for v in -val.mean(axis=1)))
degree 1   n:      15      30      60     120     250     500     800
   train MSE:   0.182   0.254   0.243   0.273   0.248   0.255   0.269
   valid MSE:   0.301   0.275   0.279   0.279   0.271   0.270   0.270
degree 9   n:      15      30      60     120     250     500     800
   train MSE:   0.022   0.067   0.064   0.079   0.080   0.078   0.087
   valid MSE: 297.835   0.163   0.116   0.097   0.092   0.088   0.089
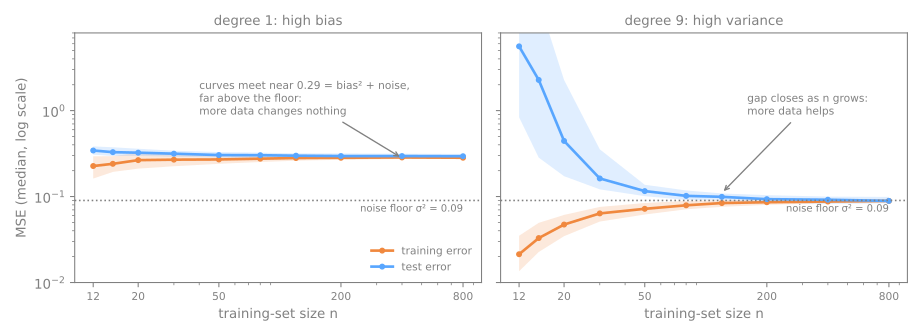
Para cada \(n\) em train_sizes, a learning_curve treina nas primeiras \(n\) linhas de cada fold de treino e avalia no fold de validação inteiro. A figura mostra as curvas típicas, calculadas a partir da verdade conhecida: para cada tamanho, a mediana de 300 conjuntos de treino, com a metade central deles sombreada (script da figura):
Duas formas, dois diagnósticos:
- Viés alto (grau 1). O erro de treino sobe com \(n\) (0,182 → 0,269: ajustar 15 pontos é mais fácil que ajustar 800), o de validação cai um pouco (0,301 → 0,270) e, a partir de uns 120 pontos, os dois ficam a menos de 0,03 um do outro, terminando em 0,269 e 0,270. Mais dados não mudam nada. As curvas se encontram no melhor que uma reta consegue, viés² + ruído: cerca de 0,29 na figura, ou seja, uns 0,2 acima do piso de ruído de 0,09 (0,18 nesta amostra). Mais dados não vão ajudar; um modelo mais flexível ou atributos melhores vão.
- Variância alta (grau 9). Com 15 pontos e 10 coeficientes, o erro de validação é 297,835: o polinômio enlouquece entre os pontos. Ele cai rápido (0,163 com 30 pontos, 0,097 com 120) e chega ao piso de ruído (0,088–0,089) com 500 pontos, enquanto o erro de treino sobe ao seu encontro. A distância entre as curvas é o sintoma da variância e, para um modelo com um número fixo de coeficientes, são os dados que a fecham. Com 30 pontos este modelo sobreajusta; com 800 ele é o modelo certo. É o "complexo demais é relativo à quantidade de dados" da aula de gradiente descendente, agora em forma de curva.
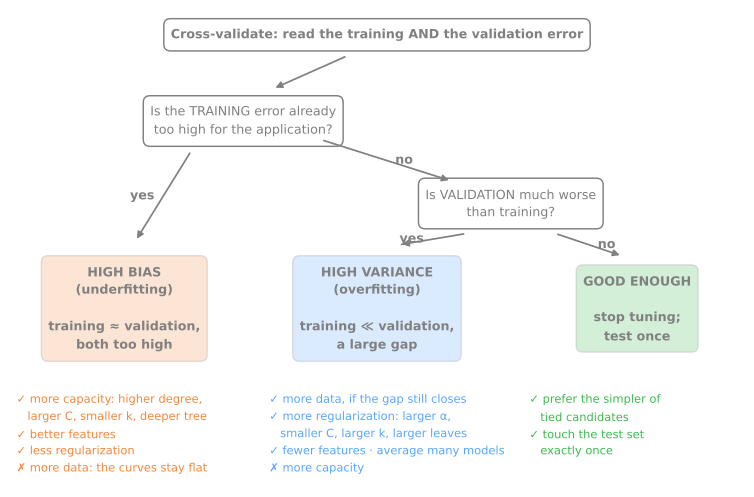
Na prática o piso de ruído é desconhecido, então "alto" precisa significar outra coisa: o erro que a aplicação tolera, o erro de um baseline DummyRegressor ou o erro do melhor modelo que você tem. O que você olha é a forma: para onde as curvas vão e se a distância entre elas ainda está fechando na borda direita do gráfico. O lab faz isso com dados reais. O diagnóstico inteiro cabe em uma tabela:
| o que as curvas mostram | diagnóstico | ajuda | não ajuda |
|---|---|---|---|
| treino ≈ validação, ambos altos demais, planos para \(n\) grande | viés alto (subajuste) | mais capacidade (grau maior, C maior, k menor, árvore mais funda), atributos melhores, menos regularização | mais dados; mais regularização |
| treino ≪ validação, distância ainda fechando no maior \(n\) | variância alta (sobreajuste) | mais dados, mais regularização (α maior, C menor, k maior, min_samples_leaf), menos atributos, média de muitos modelos (Random Forest) | mais capacidade |
| treino ≈ validação, ambos bons o bastante | pronto | pare de ajustar | — |
O mesmo diagnóstico como fluxograma: duas perguntas sobre os erros de treino e de validação decidem o caso e cada desfecho diz o que ajuda e o que não ajuda (script da figura):
Quatro ferramentas desta aula se confundem com facilidade, porque todas produzem erros de treino e de validação. O que separa cada uma é o que se varia, o que fica fixo e o que se mede:
| ferramenta | o que se varia | o que fica fixo | o que se mede | precisa conhecer a verdade? | no scikit-learn |
|---|---|---|---|---|---|
| decomposição viés–variância | o conjunto de treino (500 amostras da mesma fonte) | o modelo | viés², variância e ruído, em separado | sim | — (só em simulação) |
| curva de validação | a complexidade (um hiperparâmetro) | os dados | erro de treino e de validação | não | validation_curve |
| curva de aprendizado | o número de linhas de treino | o modelo | erro de treino e de validação | não | learning_curve |
| busca em grade | combinações de hiperparâmetros (até a família, seção 9) | os dados e o cv | só a nota de validação, para escolher | não | GridSearchCV |
A curva de validação e a busca em grade fazem a mesma conta, validação cruzada para cada configuração: a curva desenha para você diagnosticar; a busca escolhe. E nenhuma das três ferramentas práticas mede viés e variância em separado, porque isso exige muitos conjuntos de treino de uma verdade conhecida: elas veem a soma e você lê a forma das curvas.
5. Toda família tem um botão de complexidade
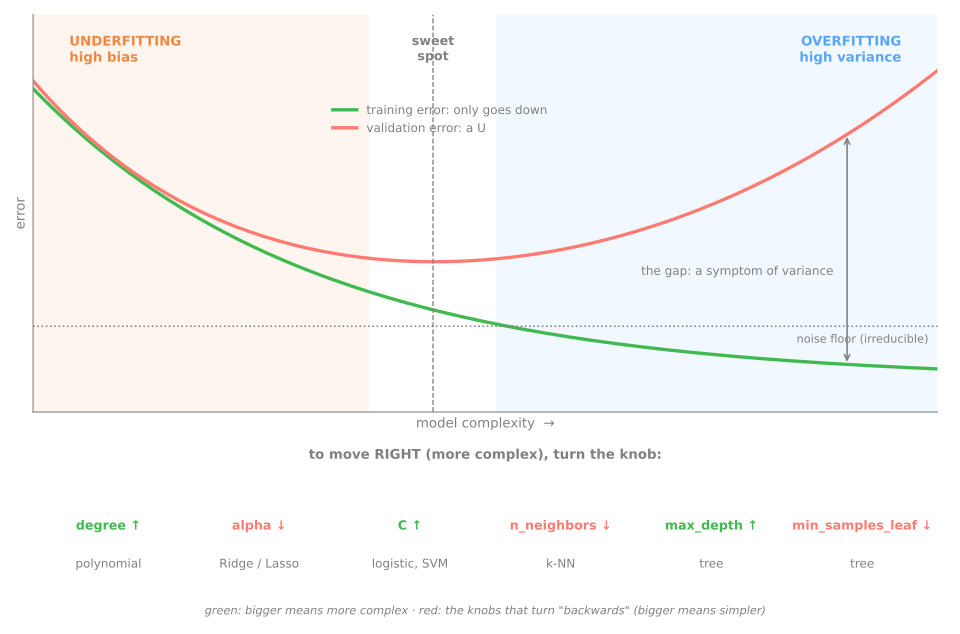
Etapa 4. Toda família de modelos que você conheceu tem pelo menos um hiperparâmetro que a desliza ao longo do U, do viés alto à variância alta. Alguns botões são discretos (um grau), a maioria é contínua (uma penalidade) e nem todos apontam para o mesmo lado:
| modelo | botão | mais simples (mais viés, menos variância) quando | medido em |
|---|---|---|---|
| atributos polinomiais | degree | menor | aula de gradiente descendente, esta aula |
| Ridge, Lasso | alpha | maior | aula de gradiente descendente |
| regressão logística | C (penalidade inversa) | menor | aula de validação cruzada |
| k-NN | n_neighbors | maior | aula de k-NN, esta aula |
| máquina de vetores de suporte (SVM, do inglês support vector machine), kernel de função de base radial (RBF, do inglês radial basis function) | C, gamma | C menor, gamma menor | aula de SVM |
| árvore de decisão | max_depth, min_samples_leaf | profundidade menor, folhas maiores | esta aula, aula de árvores de decisão |
| random forest | max_features, min_samples_leaf (n_estimators é orçamento, não complexidade) | menos atributos por corte, folhas maiores | aula de random forest |
| gradient boosting | n_estimators, learning_rate, max_depth | menos, menor, mais rasa | aula de gradient boosting |
| rede neural | weight decay, épocas de treino | mais decay, menos épocas (parada antecipada) | aula de redes neurais |
"Regularização" no sentido estrito é a penalidade sobre o tamanho dos coeficientes da aula de gradiente descendente. No sentido amplo usado na seleção de modelos, é qualquer coisa que restrinja a liberdade com que um modelo segue a amostra de treino; todos os botões acima se qualificam. Três deles giram ao contrário e são os que mais confundem: alpha maior, k maior e min_samples_leaf maior deixam o modelo mais simples, enquanto C maior, como um grau maior, o deixa mais complexo.
Uma figura resume a aula inteira: todo modelo anda sobre o mesmo eixo de complexidade e cada família tem o seu botão para andar nele (script da figura):
6. Resumo: o diagnóstico em cinco linhas
- Erro de teste = viés² + variância + ruído. O ruído é um piso; os outros dois disputam o resto.
- Viés é errar do mesmo jeito em toda amostra: treino ≈ validação, ambos altos. Variância é mudar de resposta a cada amostra: treino ≪ validação.
- Curva de validação varia a complexidade com os dados fixos; curva de aprendizado varia os dados com o modelo fixo.
- Num modelo de capacidade fixa, mais dados curam a variância e não o viés; mais capacidade só cura viés. Modelos locais com \(k\) ou tamanho de folha fixo são a exceção: mais dados baixam o viés deles e a variância fica. Errar o diagnóstico é gastar recurso no remédio errado.
- Todo modelo tem um botão de complexidade e alguns giram ao contrário (
alpha,k,min_samples_leaf: maior é mais simples).
Os padrões típicos, lidos nas curvas de erro de treino e de validação (aqui, baixo é bom):
| o que você vê | diagnóstico | ação |
|---|---|---|
| treino ≈ validação, ambos altos, curvas planas | viés | ajustar o modelo (mais capacidade) |
| treino baixo, validação alta, distância fechando | variância | mais dados |
| treino baixo, validação alta, distância parada | variância | regularizar ou simplificar |
| treino alto e distância grande | os dois | primeiro capacidade, depois rever |
| ambos baixos, juntos | ok | pare (talvez seja o piso de ruído) |
| treino 0 (ou 100% de acurácia) num modelo sem limite | memorização | limitar o modelo; olhar só a validação |
| validação errática entre folds | modelo de alta variância, nota instável | preferir a ponta simples de um fundo achatado |
No exemplo da aula: no grau 1, os erros de treino e de teste se encontram perto de 0,29 e ficam planos, então mais dados não ajudam. No grau 9, a distância é enorme com 12 pontos (erro de teste 5,6) e fecha até o piso de ruído por volta de 200 pontos, então mais dados resolvem.
"Alto" é relativo. Na prática você não conhece o \(\sigma^2\), então compare com um baseline (o DummyRegressor, que prevê a média, ou um modelo simples) ou com o erro aceitável para o negócio. Se o erro de treino já está perto desse limite, o que sobra provavelmente é ruído, que nenhuma das duas ações remove.
As duas curvas. A curva de aprendizado diz se vale buscar dados. A curva de validação (erro por complexidade) diz para onde girar o botão quando a resposta é mexer no modelo. O fluxo completo é rodar a curva de validação para achar a complexidade e depois a curva de aprendizado nesse ponto para decidir sobre os dados. No scikit-learn: learning_curve(modelo, X, y, train_sizes=np.linspace(0.1, 1.0, 8), cv=5, scoring="neg_mean_squared_error"). Troque o sinal, plote a média de treino e a de validação e leia a tabela acima.
Lab fundamental — diagnosticar e tratar
O problema. Cada uma das 20.640 linhas é um distrito da Califórnia no censo de 1990, descrito por sua localização, a idade das casas, as contagens de cômodos, quartos, pessoas e domicílios, a renda mediana dos moradores e a distância até o oceano. O alvo é o valor mediano das casas do distrito. É a cópia do professor do conjunto usado ao longo do curso (Pace & Barry, 1997, na versão com valores faltantes e uma coluna ocean_proximity). As perguntas deste lab são as perguntas desta aula: para três famílias de modelos, o erro é viés ou variância? Mais dados ajudariam? O que corrige cada diagnóstico? E qual modelo colocamos em produção?
O fluxo é o da aula de validação: trancar um conjunto de teste, usar um único objeto cv para tudo e tocar o teste uma única vez, no passo 9. Esta parte faz o diagnóstico (passos 3 e 4) e trata cada falha (passos 5 e 6); a seleção e o teste ficam para o lab avançado.
Como fazer este lab em aula (cerca de 40 min, em duplas)
- Abra o notebook do lab no Colab. Não é preciso baixar nem instalar nada: o Colab roda no navegador. Para guardar as suas respostas, salve uma cópia no seu Drive (Arquivo → Salvar uma cópia no Drive) antes de editar. Rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 6 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 7.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 a 3 e a primeira simulação em 15 min; passos 4 a 6 e a segunda simulação em 25 min. Os passos 4 e 5 levam alguns segundos cada para rodar.
Passo 1 — carregar e olhar
Preveja. O alvo é o valor mediano das casas de cada distrito. Você espera uma distribuição simétrica ou com cauda longa? E se o censo tivesse um teto para os valores altos, o que isso faria com o erro de qualquer modelo?
import numpy as np
import pandas as pd

url = 'https://raw.githubusercontent.com/hsandmann/biblio/refs/heads/main/ml/aula02/housing.csv'
df = pd.read_csv(url)
print(df.shape)
print(df.isna().sum()[lambda s: s > 0])
print(df['median_house_value'].describe().round(0))
print('districts at the 500,001 cap:', (df['median_house_value'] >= 500_001).sum())
(20640, 10)
total_bedrooms    207
dtype: int64
count     20640.0
mean     206856.0
std      115396.0
min       14999.0
25%      119600.0
50%      179700.0
75%      264725.0
max      500001.0
Name: median_house_value, dtype: float64
districts at the 500,001 cap: 965
20.640 distritos e 10 colunas. Só total_bedrooms tem valores faltantes (207 linhas); um imputador no pipeline cuida deles. O alvo tem média de US$ 206.856 e mediana de US$ 179.700, com uma cauda longa à direita. Há também um detalhe que vale conhecer antes de treinar qualquer modelo: 965 distritos estão exatamente em US$ 500.001. O censo registrou "mais de US$ 500.000" como esse único valor, então para esses distritos o valor verdadeiro é desconhecido e todo modelo é avaliado contra um número que não é o preço real. Eles inflam os erros abaixo, mas não por igual: um modelo linear, que não consegue se achatar num teto, paga mais por eles do que uma árvore, que consegue.
Passo 2 — trancar o conjunto de teste, um cv para tudo
Preveja. O baseline prevê o mesmo preço para todo distrito. A raiz do erro quadrático médio (RMSE, do inglês root mean squared error) dele deve ficar perto de qual estatística dos preços que você viu no passo 1?
from sklearn.compose import ColumnTransformer
from sklearn.dummy import DummyRegressor
from sklearn.impute import SimpleImputer
from sklearn.model_selection import KFold, cross_validate, train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import FunctionTransformer, OneHotEncoder, StandardScaler

X = df.drop(columns='median_house_value')
y = df['median_house_value']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

counts = ['total_rooms', 'total_bedrooms', 'population', 'households']      # assimétricas: log nelas
others = ['longitude', 'latitude', 'housing_median_age', 'median_income']
pre = ColumnTransformer([
    ('counts', make_pipeline(SimpleImputer(strategy='median'), FunctionTransformer(np.log1p),
                             StandardScaler()), counts),
    ('others', StandardScaler(), others),
    ('ocean', OneHotEncoder(handle_unknown='ignore'), ['ocean_proximity']),
])
cv = KFold(n_splits=5, shuffle=True, random_state=42)                      # um cv para tudo


def rmse(model):
    """RMSE médio de treino e de validação nos 5 folds e o desvio-padrão da validação entre folds."""
    r = cross_validate(model, X_train, y_train, cv=cv, return_train_score=True,
                       scoring='neg_root_mean_squared_error')
    return abs(r['train_score'].mean()), abs(r['test_score'].mean()), r['test_score'].std()


print(X_train.shape, X_test.shape)
print('dummy (predicts the mean): train %.0f · validation %.0f ± %.0f' % rmse(DummyRegressor()))
16.512 distritos para desenvolvimento, 4.128 trancados até o passo 9. Tudo o que aprende com os dados mora no transformador pre, então a validação cruzada o reajusta dentro de cada fold: a mediana usada para preencher total_bedrooms, os escalonadores e a lista de categorias de ocean_proximity. As quatro colunas de contagem são somas sobre um distrito inteiro e vão de um punhado a dezenas de milhares, então passam primeiro por um log (log1p): do contrário, alguns distritos enormes dominariam a escala e, mais adiante, os atributos polinomiais. O objeto cv é criado uma vez e usado em todos os passos, então todo número abaixo é medido nos mesmos cinco folds.
O scikit-learn maximiza notas, então reporta o RMSE com sinal de menos (neg_root_mean_squared_error); o abs() o devolve para dólares. O baseline prevê o preço médio para todo distrito e erra por US$ 114.793 em média (no sentido do RMSE): isso é simplesmente o desvio-padrão dos preços. Todo modelo deve ser lido contra ele.
Passo 3 — três famílias, um primeiro diagnóstico
Preveja. Uma árvore sem limite de profundidade e uma regressão linear: qual delas vai ter o menor erro de treino? E a maior distância entre treino e validação?
from sklearn.linear_model import LinearRegression
from sklearn.neighbors import KNeighborsRegressor
from sklearn.tree import DecisionTreeRegressor

candidates = {
    'linear': make_pipeline(pre, LinearRegression()),
    'k-NN (k=5)': make_pipeline(pre, KNeighborsRegressor()),
    'tree (no limits)': make_pipeline(pre, DecisionTreeRegressor(random_state=42)),
}
print(f"{'':17s} {'train':>7s} {'valid':>7s} {'gap':>7s}")
for name, model in candidates.items():
    tr, va, sd = rmse(model)
    print(f"{name:17s} {tr:7.0f} {va:7.0f} {va - tr:7.0f}")
Uma tabela, três retratos diferentes:
- Regressão linear: treino 66.369, validação 66.460, uma distância de apenas US$ 91. Ela vai tão mal nos distritos em que foi ajustada quanto nos novos. Essa é a assinatura do viés alto: ela cortou 42% do erro do baseline e não tem mais nada a aprender com uma função linear destes atributos.
- Árvore sem limites: RMSE de treino 0. A árvore cresceu até cada folha reproduzir exatamente seus distritos de treino e depois errou os novos por 67.266. Uma distância de US$ 67.266 é variância alta na forma mais pura.
- k-NN com o \(k = 5\) padrão: a melhor nota de validação das três (59.967), com uma distância clara de US$ 11.069: alguma variância.
Um único número por modelo (o RMSE de validação) os ordenaria k-NN, linear, árvore e pararia aí. A distância diz por que cada um falha e, portanto, o que tentar a seguir. Ela ainda não diz se mais dados ajudariam: esse é o trabalho do próximo passo.
Simulação: a variância, vista de perto. A distância entre treino e validação é um sintoma; a variância é a causa: o quanto o modelo muda quando a amostra muda. Meça isso diretamente. Divida X_train em três partes disjuntas, A, B e C; treine cada família duas vezes, uma em A e outra em B, e compare as previsões das duas versões nos mesmos distritos de C. Qual família muda mais de uma amostra para outra?
Solução
from sklearn.base import clone

parts = np.array_split(np.random.default_rng(0).permutation(len(X_train)), 3)
(XA, yA), (XB, yB), (XC, yC) = [(X_train.iloc[p], y_train.iloc[p]) for p in parts]
print(f"three disjoint parts of {len(XA)}, {len(XB)} and {len(XC)} districts")
for name, model in candidates.items():
    pa = clone(model).fit(XA, yA).predict(XC)          # versão treinada na parte A
    pb = clone(model).fit(XB, yB).predict(XC)          # versão treinada na parte B
    err = np.sqrt(np.mean((yC - pa) ** 2))
    shift = np.sqrt(np.mean((pa - pb) ** 2))
    print(f"{name:17s} RMSE on C {err:6.0f} · A and B versions differ by {shift:6.0f}")
three disjoint parts of 5504, 5504 and 5504 districts
linear            RMSE on C  65458 · A and B versions differ by   4405
k-NN (k=5)        RMSE on C  62645 · A and B versions differ by  38519
tree (no limits)  RMSE on C  72083 · A and B versions differ by  79944
As duas versões da regressão linear discordam em US$ 4.405 (como raiz da média dos quadrados, RMS, do inglês root mean square) nos mesmos distritos: trocar a amostra quase não muda a reta. As duas versões da árvore sem limites discordam em US$ 79.944, mais do que o erro de cada uma (US$ 72.083): cada árvore memorizou a sua parte, ruído incluído, e o ruído de A não é o de B. O k-NN fica no meio (US$ 38.519). É a definição de variância da seção 1, agora num conjunto real: não foi preciso conhecer a verdade para vê-la, bastaram duas amostras. Repare também que, com um terço dos dados, a árvore e o k-NN erram mais do que no passo 3 (72.083 e 62.645, contra 67.266 e 59.967), enquanto a regressão linear fica onde estava: é exatamente o que as curvas de aprendizado do próximo passo vão mostrar.
Passo 4 — curvas de aprendizado: mais dados ajudariam?
Preveja. O modelo linear já erra quase o mesmo no treino e na validação. Dobrar o número de distritos vai baixar o erro de validação dele? E o da árvore sem limites?
import matplotlib.pyplot as plt
from sklearn.model_selection import learning_curve

fractions = [0.02, 0.05, 0.1, 0.2, 0.4, 0.7, 1.0]
fig, axes = plt.subplots(1, 3, figsize=(12, 3.5), sharey=True)
for ax, (name, model) in zip(axes, candidates.items()):
    sizes, train, val = learning_curve(model, X_train, y_train, train_sizes=fractions, cv=cv,
                                       scoring='neg_root_mean_squared_error')
    train, val = np.abs(train.mean(axis=1)), np.abs(val.mean(axis=1))
    print(f"{name:17s} n     " + ' '.join(f"{n:6d}" for n in sizes))
    print(f"{'':17s} train " + ' '.join(f"{v / 1000:6.1f}" for v in train))
    print(f"{'':17s} valid " + ' '.join(f"{v / 1000:6.1f}" for v in val))
    ax.plot(sizes, train, 'o-', label='training')
    ax.plot(sizes, val, 'o-', label='validation')
    ax.set_title(name)
    ax.set_xlabel('training rows')
axes[0].set_ylabel('RMSE (US$)')
axes[0].legend()
plt.show()
linear            n        264    660   1320   2641   5283   9246  13209
                  train   59.2   64.4   66.2   66.4   65.9   66.5   66.4
                  valid   67.8   67.6   67.0   66.8   66.5   66.5   66.5
k-NN (k=5)        n        264    660   1320   2641   5283   9246  13209
                  train   59.0   56.5   54.8   52.5   50.8   50.1   48.9
                  valid   78.0   72.0   69.3   65.8   62.9   61.3   60.0
tree (no limits)  n        264    660   1320   2641   5283   9246  13209
                  train    0.0    0.0    0.0    0.0    0.0    0.0    0.0
                  valid   91.5   85.6   83.9   77.5   72.7   71.8   67.3
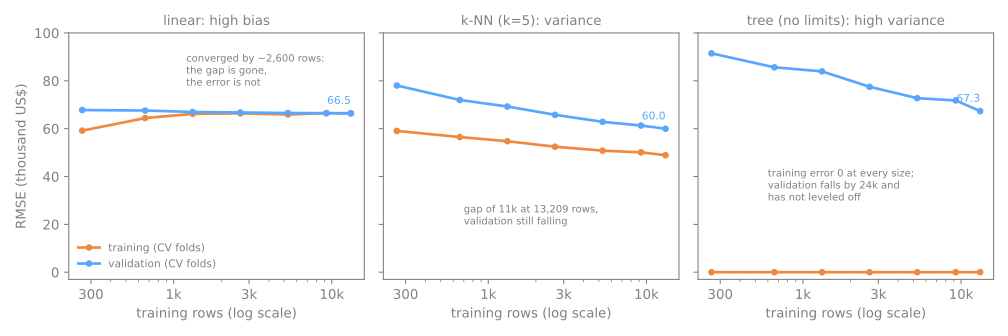
A tabela e a figura mostram os mesmos números, em milhares de dólares:
- Linear: mais dados são inúteis. O erro de treino sobe de 59,2 para 66,4 e o de validação cai de 67,8 para 66,5; com 2.641 linhas eles já se encontraram (66,4 e 66,8) e as últimas 10.000 linhas não mudam nada. O modelo aprendeu tudo o que um hiperplano consegue aprender com estes atributos. Coletar mais distritos custaria dinheiro e não traria ganho nenhum; o remédio é mais flexibilidade (passo 6).
- k-NN: mais dados ajudariam. A validação cai de 78,0 para 60,0 e ainda está caindo na borda direita (61,3 → 60,0 nas últimas 4.000 linhas), enquanto resta uma distância de 11 mil dólares. Dados mais densos significam vizinhos mais próximos, logo menos viés. Com \(k\) fixo, cada previsão continua sendo a média de só 5 preços ruidosos, então essa parte da variância fica: um \(k\) maior a ataca (passo 5).
- Árvore: mais dados ajudariam, devagar. O erro de treino é 0 em todos os tamanhos e a validação cai de 91,5 para 67,3, ainda descendo. A validação cai porque, com mais distritos, folhas mais finas seguem a verdade mais de perto (menos viés). Mas uma folha com um único distrito copia o ruído desse distrito em qualquer tamanho, então a distância pode encolher, mas nunca fecha: a variância dela tem um piso do tamanho do ruído. Regularizar é o remédio (passo 5).
Dados não são o único recurso escasso. O que as curvas dizem é qual recurso gastar: esforço de engenharia de atributos no modelo linear, regularização nos outros dois (mais dados ainda baixam o erro deles, mas não fecham a distância).
Passo 5 — curvas de validação: tratar a variância
Preveja. Exigir mais distritos em cada folha da árvore vai aumentar ou diminuir o erro de treino? E o de validação: anda sempre na mesma direção ou primeiro numa e depois na outra?
from sklearn.model_selection import validation_curve

knobs = {'tree': (candidates['tree (no limits)'], 'decisiontreeregressor__min_samples_leaf',
                  [1, 2, 5, 10, 20, 50, 100]),
         'k-NN': (candidates['k-NN (k=5)'], 'kneighborsregressor__n_neighbors', [1, 3, 5, 10, 20, 50])}
for name, (model, param, values) in knobs.items():
    train, val = validation_curve(model, X_train, y_train, param_name=param, param_range=values,
                                  cv=cv, scoring='neg_root_mean_squared_error')
    print(f"{name}: {param.split('__')[1]}")
    for v, tr, va in zip(values, np.abs(train.mean(axis=1)), np.abs(val.mean(axis=1))):
        print(f"  {v:4d}   train {tr:6.0f}   valid {va:6.0f}   gap {va - tr:6.0f}")
tree: min_samples_leaf
     1   train      0   valid  67266   gap  67266
     2   train  18723   valid  64812   gap  46089
     5   train  34461   valid  60469   gap  26008
    10   train  43023   valid  57796   gap  14773
    20   train  49663   valid  58079   gap   8415
    50   train  56655   valid  59891   gap   3236
   100   train  61413   valid  63505   gap   2092
k-NN: n_neighbors
     1   train      0   valid  73873   gap  73873
     3   train  43627   valid  61904   gap  18277
     5   train  48898   valid  59967   gap  11069
    10   train  53606   valid  59182   gap   5576
    20   train  57036   valid  59931   gap   2895
    50   train  61204   valid  62371   gap   1168
As duas tabelas têm a forma de U desta aula, lidas pela coluna da distância (gap):
- Árvore. Exigir pelo menos
min_samples_leafdistritos em cada folha obriga cada previsão a ser uma média; médias têm menos variância. A distância encolhe sem parar (67.266 → 14.773 em 10 → 2.092 em 100), enquanto o erro de validação primeiro cai e depois volta a subir: o fundo émin_samples_leaf = 10, 57.796. Um botão levou a árvore do pior dos três modelos ao melhor, um ganho de US$ 9.470. Com 100 distritos por folha a árvore já passou para o lado do viés (distância pequena, 63.505). - k-NN. \(k = 1\) memoriza (treino 0, validação 73.873); \(k = 50\) está do lado do viés (distância 1.168, validação 62.371). O fundo é \(k = 10\), com 59.182, apenas US$ 785 melhor que o \(k = 5\) padrão: aqui o padrão já estava perto do fundo de um U achatado.
Passo 6 — tratar o viés do modelo linear
Preveja. Acrescentar ao modelo linear os quadrados e os produtos dos atributos deve baixar o erro de treino, o de validação ou os dois? O que pode dar errado com termos cúbicos?
from sklearn.linear_model import Ridge
from sklearn.preprocessing import PolynomialFeatures

print('degree   alpha    train    valid  ± std')
for degree, alpha in [(1, 1), (2, 1), (3, 0.1), (3, 10), (3, 100)]:
    model = make_pipeline(pre, PolynomialFeatures(degree), StandardScaler(), Ridge(alpha=alpha))
    tr, va, sd = rmse(model)
    print(f"{degree:6d} {alpha:7g} {tr:8.0f} {va:8.0f} {sd:6.0f}")
degree   alpha    train    valid  ± std
     1       1    66369    66460   1597
     2       1    58649    59741   1823
     3     0.1    52092    63828   7751
     3      10    53038    57510   2955
     3     100    54582    57473   2381
O modelo linear precisa de flexibilidade, que o PolynomialFeatures fornece: o grau 2 acrescenta os quadrados e os produtos dois a dois das 13 colunas pré-processadas; o grau 3, também os termos cúbicos (560 colunas no total). Leia as linhas em ordem:
- O grau 2 reduz os dois erros, treino 66.369 → 58.649 e validação 66.460 → 59.741. A curva inteira desceu: é assim que reduzir o viés aparece.
- O grau 3 com penalidade fraca (
alpha = 0.1) passa do ponto e cai do lado da variância: treino 52.092, validação 63.828 e um desvio-padrão entre folds de 7.751, de quatro a cinco vezes o dos graus 1 e 2, porque em certos folds os termos cúbicos extrapolam loucamente para alguns distritos incomuns. - O grau 3 com
alpha = 100mantém a capacidade e deixa a penalidade retirar o que os dados não sustentam: validação 57.473 ± 2.381, o melhor número até aqui.
O grau acrescenta capacidade; o alpha a retira de forma contínua. Usados juntos, são as duas mãos do trade-off viés–variância; é por isso que "atributos polinomiais + Ridge" é uma receita padrão. Repare no que não aconteceu: nenhum dado novo foi necessário.
Simulação: o alpha como botão contínuo. O passo 6 testou três valores de alpha para o grau 3. Varra de 0,01 a 1.000.000 (oito ordens de grandeza) e acompanhe o treino, a validação, a distância entre eles e o desvio entre folds. Em qual ponta o modelo fica do lado da variância e em qual do lado do viés?
Solução
print('alpha      train    valid    gap  ± std')
for alpha in [0.01, 1, 100, 1e4, 1e6]:
    tr, va, sd = rmse(make_pipeline(pre, PolynomialFeatures(3), StandardScaler(), Ridge(alpha=alpha)))
    print(f"{alpha:<8g} {tr:7.0f} {va:8.0f} {va - tr:6.0f} {sd:6.0f}")
alpha      train    valid    gap  ± std
0.01       51931    66098  14167   8694
1          52426    60366   7940   5378
100        54582    57473   2890   2381
10000      66352    66926    574   1330
1e+06     106790   106832     42   1318
Leia a coluna gap de cima para baixo: 14.167 → 42. Com alpha = 0.01 os 560 termos ficam quase livres: treino 51.931, validação 66.098 e um desvio entre folds de 8.694, o lado da variância. Com alpha = 1e6 a penalidade esmaga quase todos os coeficientes: treino e validação se encontram em cerca de US$ 106.800, perto dos 114.793 do baseline, com uma distância de US$ 42 — o lado do viés. O fundo do U fica em alpha = 100 (57.473). Mesmo grau, mesmos atributos: só o alpha levou o modelo de uma ponta à outra do U. E o botão gira "ao contrário": alpha maior é modelo mais simples.
Para fechar a parte fundamental. Em uma frase cada: (1) o que a distância entre o erro de treino e o de validação mede e o que ela não mede? (2) Por que mais distritos não ajudariam o modelo linear do passo 4? (3) Que botão você giraria, e para que lado, para tirar a árvore do lado da variância?
Sua vez (fundamental)
Para casa:
- Mais pontos. Rode de novo a
bias_varianceda seção 2 para polinômios comn=100em vez de 30. Qual grau é o melhor agora e o que aconteceu com a variância do grau 12? Relacione a resposta com as curvas de aprendizado. - Mais ruído. Rode com
sigma=0.6. O melhor grau se move para modelos mais simples ou mais complexos? Explique com os três termos da decomposição. - Atributos contra o viés. Acrescente três razões ao
Xantes da divisão: cômodos por domicílio, quartos por cômodo e pessoas por domicílio (elas exigem uma pequena mudança emcounts/others). Rode o passo 6 de novo. O platô do modelo de grau 1 se move? Por mais de um desvio-padrão entre folds?
Abordagem avançada
A parte fundamental ensinou a diagnosticar e a tratar um modelo. Esta parte trata da escolha entre muitos: o que a seleção faz com as próprias notas (a regressão à média), como comparar famílias inteiras numa única busca, por que nenhuma família vence em todo lugar e como desempatar quando os dados não conseguem. Os blocos de código continuam os das seções 1 a 5.
Esta parte segue um pipeline em quatro etapas: 1. uma escala comum para a complexidade, o número efetivo de parâmetros; 2. regressão à média, por que o escore do vencedor cai ao medir de novo; 3. comparar famílias numa só busca, com o "não existe almoço grátis" e a navalha de Occam; 4. o fluxo completo, com uma porta de mão única antes do teste; por fim, o lab. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Uma escala comumo número efetivo de parâmetros
- Regressão à médiapor que o escore do vencedor cai ao medir de novo
- Comparar famíliasuma busca sobre todas as famílias, não existe almoço grátis, a navalha de Occam
- O fluxo completocinco passos, uma porta de mão única antes do teste, depois o lab
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
7. Uma escala comum: o número efetivo de parâmetros
Etapa 1. Os botões podem até ser postos numa escala comum. Para modelos cujas previsões nos pontos de treino são uma soma ponderada dos rótulos de treino, o número efetivo de parâmetros é a soma, sobre os pontos de treino, do peso que o rótulo de cada ponto recebe na sua própria previsão (Hastie, Tibshirani & Friedman, cap. 7). Para mínimos quadrados com \(p\) colunas, essa soma é \(p\). No k-NN, cada ponto de treino é um dos seus próprios \(k\) vizinhos mais próximos e recebe peso \(1/k\), então o total é \(n/k\): com 30 pontos, \(k = 30\) gasta 1 parâmetro (a média, o polinômio de grau 0: os mesmos números na tabela acima), \(k = 3\) gasta 10 e \(k = 1\) gasta 30, um por ponto, o que é memorização. No Ridge, o número efetivo de parâmetros cai continuamente de \(p\) em direção a 1 à medida que \(\alpha\) cresce (esse 1 é o intercepto, que não é penalizado). É por isso que uma penalidade é um botão tão conveniente: ela transforma a escada dos graus em uma rampa.
O simulador põe essa escala em prática na amostra de 30 pontos da seção 3. Ele desenha as curvas de validação de três botões diferentes (o grau de um polinômio, o \(k\) do k-NN e o \(\alpha\) de um Ridge sobre atributos de grau 9), todas com a mesma CV 5-fold repetida 20 vezes, no mesmo eixo: o número efetivo de parâmetros de um modelo ajustado num fold de treino de 24 pontos. Um grau \(d\) gasta \(d + 1\); o k-NN gasta \(24/k\); o Ridge gasta \(1 + \sum_j d_j^2 / (d_j^2 + \alpha)\), em que \(d_j\) são os valores singulares dos atributos padronizados. Os três fundos caem perto uns dos outros: 4 parâmetros para o polinômio (grau 3, MSE 0,114), cerca de 5 para o Ridge (\(\alpha \approx 0{,}003\), MSE 0,106) e 8 para o k-NN (\(k = 3\), MSE 0,108).
8. Regressão à média
Etapa 2. Francis Galton deu nome à regressão em 1886, intrigado porque pais muito altos tinham filhos mais perto da altura média; a história, os dados e um simulador estão na aula de regressão linear. O mecanismo merece uma segunda olhada aqui, porque a seleção de modelos esbarra nele toda vez que escolhe um vencedor.
Todo desempenho medido é parte habilidade, parte sorte. Simule 10.000 estudantes cuja habilidade verdadeira tem média 70 e desvio-padrão 8; cada prova acrescenta a sorte do dia. Selecione os 10% melhores numa primeira prova e olhe os mesmos estudantes numa segunda, para três níveis de sorte:
rng = np.random.default_rng(0)
n = 10_000
ability = rng.normal(70, 8, n)                     # o que cada estudante realmente sabe (dp 8)
print('luck sd   r = 8²/(8²+luck²)   top 10% on exam 1   same students, exam 2   predicted')
for luck in [2, 6, 16]:
    exam1 = ability + rng.normal(0, luck, n)       # a sorte de um dia...
    exam2 = ability + rng.normal(0, luck, n)       # ...e a de outro
    top = exam1 >= np.quantile(exam1, 0.9)
    r = 8 ** 2 / (8 ** 2 + luck ** 2)
    predicted = exam1.mean() + r * (exam1[top].mean() - exam1.mean())
    print(f"{luck:7d} {r:19.2f} {exam1[top].mean():19.1f} {exam2[top].mean():23.1f} {predicted:11.1f}")
luck sd   r = 8²/(8²+luck²)   top 10% on exam 1   same students, exam 2   predicted
      2                0.94                84.4                    83.5        83.6
      6                0.64                87.6                    80.9        81.3
     16                0.20               101.4                    76.1        76.3
A habilidade de ninguém mudou entre as provas e, mesmo assim, o grupo de cima cai todas as vezes. Quanto ele cai pode ser calculado de antemão. A parcela da variação das notas que é habilidade (e não sorte) é a confiabilidade, \(r = \sigma^2_\text{habilidade} / (\sigma^2_\text{habilidade} + \sigma^2_\text{sorte})\). Um grupo selecionado a uma distância \(D\) acima da média na primeira medida é esperado a \(r \times D\) acima dela na segunda. Com sorte de desvio-padrão 6: \(r = 64/100 = 0{,}64\), o grupo de cima tirou 87,6, ou seja, 17,6 acima da média de 70, então o esperado é \(70 + 0{,}64 \times 17{,}6 \approx 81{,}3\); a simulação dá 80,9. Com pouca sorte (\(r = 0{,}94\)) o grupo de cima quase não se mexe, 84,4 → 83,5. Com muita (\(r = 0{,}20\)) a maior parte da vantagem era sorte, 101,4 → 76,1 (script da figura):
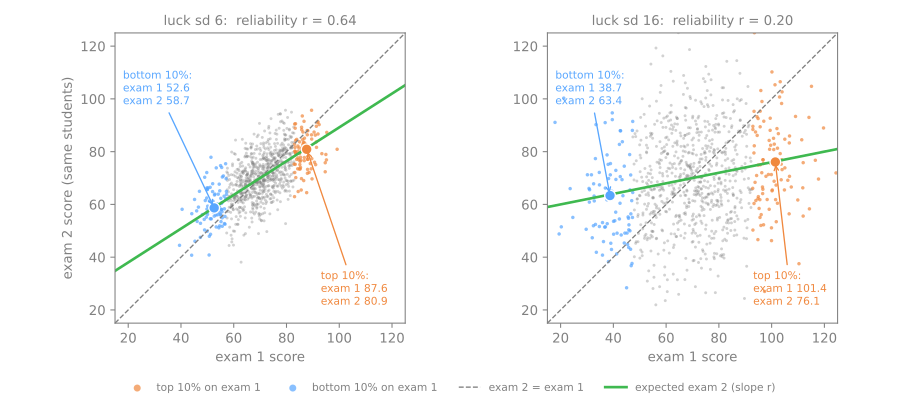
O efeito vale nos dois sentidos: os 10% de baixo melhoram, de 52,6 para 58,7 (e de 38,7 para 63,4 com muita sorte), sem ajuda de ninguém. Uma nota extrema é extrema em parte porque a sorte foi extrema — e a sorte não se repete. É por isso que o atleta da capa da revista tem uma temporada seguinte pior, que o fundo com o melhor retorno do ano costuma decepcionar no ano seguinte e que uma aula de reforço para as piores notas "funciona" mesmo que não ensine nada.
Agora traduza para a seleção de modelos. Uma configuração é um estudante; seu desempenho verdadeiro em dados futuros é a habilidade; sua nota de validação cruzada é uma prova, cuja sorte vem de quais linhas caíram em qual fold e de qual amostra do mundo você conseguiu coletar; o vencedor de uma busca em grade é o primeiro da turma. A confiabilidade é mais baixa exatamente onde a seleção acontece: perto do topo de uma grade, as configurações diferem muito pouco entre si (pouca variação de habilidade), enquanto o ruído da CV não diminui (a mesma sorte). Então a nota do vencedor regride. Quanto mais candidatos você compara, mais extremo (e mais sortudo) é o vencedor. A aula de validação cruzada mediu o caso extremo: em puro ruído toda configuração tem a mesma habilidade (\(r = 0\)) e o vencedor de 100 notas de validação caiu de 61,2% até 50,9% no teste. A validação cruzada aninhada mediu um caso brando, em dados reais: o 0,712 de um vencedor regredindo para cerca de 0,70.
A seleção infla as notas; medir de novo as desinfla
Como regra de bolso, a melhor de muitas notas ruidosas superestima a própria nota verdadeira em aproximadamente \((1 - r)\) vezes a sua vantagem sobre o pelotão (uma heurística: ela supõe ruídos independentes e configurações vizinhas de uma grade compartilham a maior parte do seu). Nunca reporte a nota que foi usada para escolher o vencedor. Meça de novo em dados que não tiveram nenhum papel na escolha: o conjunto de teste trancado ou a CV aninhada. Rodar a CV de novo com outros folds sobre os mesmos dados não basta: isso mostra quanto do ranking é sorte dos folds (lab, passo 8), mas o vencedor continua escolhido nestas linhas. E quando algo é feito porque uma nota foi extrema (retreinar só o pior segmento, premiar só a melhor equipe), espere alguma melhora ou piora só por regressão à média: apenas um grupo de comparação separa isso do efeito do que você fez.
O simulador faz a conta exata para qualquer nível de sorte: com a habilidade normal, os 10% de cima na primeira prova ficam, em média, \(D = s\,\varphi(z)/0{,}1\) acima de 70, com \(s = \sqrt{8^2 + \sigma^2}\) e \(z\) o quantil 0,9, e voltam para \(70 + r \cdot D\) na segunda. Com \(\sigma = 6\): \(D = 17{,}5\), de 87,5 para 81,2, contra 87,6 e 80,9 na simulação acima. O segundo botão relê o mesmo gráfico como seleção de modelos.
9. Busca em grade com validação cruzada: a família como hiperparâmetro
Etapa 3. A mecânica está na aula de validação cruzada: envolva o pré-processamento e o modelo num pipeline, dê ao GridSearchCV uma grade e um único objeto cv, leia best_params_ e cv_results_, compare os candidatos fold a fold, prefira o mais simples quando empatam e avalie o vencedor em dados que ele nunca viu. A validation_curve, acima, é uma busca em grade sobre um único hiperparâmetro que também devolve as notas de treino (no GridSearchCV você as pede com return_train_score=True).
Vale conhecer uma extensão: a própria família de modelos pode ser um hiperparâmetro. Uma etapa do pipeline é uma vaga em que uma grade pode pôr estimadores diferentes. Passar uma lista de grades permite que cada família traga os próprios botões; 'passthrough' remove uma etapa onde a família não precisa dela (uma árvore não liga para escalonamento). Eis seis famílias numa única busca, as quatro que você conheceu antes desta seção e os dois ensembles desta, nos retornos de radar do lab de SVM:
import pandas as pd
from sklearn.datasets import fetch_openml
from sklearn.ensemble import HistGradientBoostingClassifier, RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV, StratifiedKFold
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier

pipe = Pipeline([('scale', StandardScaler()), ('model', LogisticRegression())])  # 'model' é uma vaga
param_grid = [                                     # uma lista de grades: uma por família
    {'model': [LogisticRegression(max_iter=5000)], 'model__C': np.logspace(-3, 3, 7)},
    {'model': [KNeighborsClassifier()], 'model__n_neighbors': [1, 3, 5, 9, 15, 25, 51]},
    {'model': [SVC()], 'model__C': [0.1, 1, 10, 100], 'model__gamma': ['scale', 0.01, 0.1]},
    {'model': [DecisionTreeClassifier(random_state=0)], 'scale': ['passthrough'],
     'model__max_depth': [1, 2, 3, 4, 6, 8, 12, None]},
    {'model': [RandomForestClassifier(n_estimators=200, random_state=0)], 'scale': ['passthrough'],
     'model__max_features': ['sqrt', 0.5], 'model__min_samples_leaf': [1, 5]},
    {'model': [HistGradientBoostingClassifier(random_state=0)], 'scale': ['passthrough'],
     'model__learning_rate': [0.05, 0.1], 'model__max_leaf_nodes': [7, 31]},
]
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
search = GridSearchCV(pipe, param_grid, cv=cv, scoring='accuracy', n_jobs=-1)

FAMILY = {'LogisticRegression': 'logistic', 'KNeighborsClassifier': 'k-NN', 'SVC': 'SVM',
          'DecisionTreeClassifier': 'tree', 'RandomForestClassifier': 'forest',
          'HistGradientBoostingClassifier': 'boosting'}


def best_per_family(search):
    """A melhor configuração de cada família, lida do cv_results_."""
    res = pd.DataFrame(search.cv_results_)
    res['family'] = [FAMILY[type(p['model']).__name__] for p in res['params']]
    best = res.loc[res.groupby('family')['mean_test_score'].idxmax()]
    best['setting'] = [', '.join(f"{k.split('__')[1]}={v}" for k, v in p.items() if '__' in k)
                       for p in best['params']]
    return best.set_index('family')[['mean_test_score', 'std_test_score', 'setting']]


ion = fetch_openml(data_id=59, as_frame=True)                # 351 retornos de radar, 34 atributos
X_ion, y_ion = ion.data, (ion.target == 'g').astype(int)
search.fit(X_ion, y_ion)
print(len(search.cv_results_['params']), 'configurations, 6 families, one search')
print(best_per_family(search).round(3).to_string())
42 configurations, 6 families, one search
          mean_test_score  std_test_score                                setting
family
SVM                 0.946           0.037                       C=10, gamma=0.01
boosting            0.940           0.027   learning_rate=0.05, max_leaf_nodes=7
forest              0.943           0.032  max_features=sqrt, min_samples_leaf=1
k-NN                0.866           0.034                          n_neighbors=1
logistic            0.883           0.035                                 C=10.0
tree                0.897           0.040                            max_depth=2
Uma busca, 42 configurações, 210 ajustes e a melhor configuração de cada família lida de volta do cv_results_. A SVM com kernel fica em primeiro (0,946), como o lab de SVM antecipava, mas a floresta (0,943) e o boosting (0,940) ficam a menos de 0,006 dela, bem dentro do seu desvio-padrão entre folds (0,037): três famílias empatam no topo. A árvore sozinha fica uns 0,05 atrás delas, com 0,897, e é esse o ponto das aulas de ensembles: as mesmas árvores, em média ou somadas em sequência, saem do meio da tabela para o topo. Como toda configuração foi avaliada no mesmo cv, as notas por fold de quaisquer duas famílias (split0_test_score, …) podem ser comparadas fold a fold direto do cv_results_. O que não muda: o best_score_ continua sendo a melhor de 42 estimativas ruidosas, então carrega a maldição do vencedor da seção 8. Num projeto real, a busca roda só na parte de treino, com um conjunto de teste trancado (como no lab).
O custo de uma grade se multiplica a cada hiperparâmetro que você acrescenta. O RandomizedSearchCV tem a mesma interface, mas testa um número fixo n_iter de combinações sorteadas de distribuições que você fornece (por exemplo loguniform(1e-3, 1e3) para C): seu custo deixa de depender de quão fino você descreve o espaço. Como em geral só poucos hiperparâmetros importam de verdade, combinações aleatórias cobrem esses poucos muito melhor do que uma grade (Bergstra & Bengio, 2012). Buscas mais espertas, que aprendem com as configurações já testadas (successive halving, otimização bayesiana com Optuna), são o assunto de AutoML.
10. Não existe almoço grátis
Qual família é a melhor, então? Rode a mesma search, com as seis famílias, em mais cinco conjuntos de dados: dois outros reais e três sintéticos, cada um construído para que uma suposição seja verdadeira.
from sklearn.datasets import load_breast_cancer, make_moons


def rule_data(n=500, p=20, seed=0):
    """Uma regra alinhada aos eixos em 2 de 20 colunas; as outras 18 são ruído."""
    r = np.random.default_rng(seed)
    X = r.uniform(0, 1, (n, p))
    y = (((X[:, 0] > 0.6) & (X[:, 1] > 0.3)) | (X[:, 0] < 0.2)).astype(int)
    flip = r.random(n) < 0.05                                  # 5% de rótulos trocados
    return X, np.where(flip, 1 - y, y)


def linear_data(n=200, p=40, seed=0):
    """Uma fronteira linear em 40 dimensões, com apenas 200 linhas."""
    r = np.random.default_rng(seed)
    X = r.normal(size=(n, p))
    return X, (X @ r.normal(size=p) + r.normal(0, 2, n) > 0).astype(int)


credit = fetch_openml(data_id=31, as_frame=True)
datasets = {
    'ionosphere (real)': (X_ion, y_ion),
    'breast cancer (real)': load_breast_cancer(return_X_y=True),
    'credit-g (real)': (pd.get_dummies(credit.data, dtype=float), (credit.target == 'good').astype(int)),
    'linear, 40-d': linear_data(),
    'two moons': make_moons(n_samples=400, noise=0.3, random_state=0),
    'axis-aligned rule': rule_data(),
}
table = {}
for name, (X, y) in datasets.items():
    best = best_per_family(search.fit(X, y))
    scores = best['mean_test_score']
    winner = scores.idxmax()
    table[name] = {**{fam: f"{acc:.3f}" for fam, acc in scores.items()}, 'winner': winner,
                   'its std': f"{best.loc[winner, 'std_test_score']:.3f}"}
print(pd.DataFrame(table).T[['logistic', 'k-NN', 'SVM', 'tree', 'forest', 'boosting', 'winner', 'its std']]
      .to_string())
                     logistic   k-NN    SVM   tree forest boosting    winner its std
ionosphere (real)       0.883  0.866  0.946  0.897  0.943    0.940       SVM   0.037
breast cancer (real)    0.979  0.965  0.979  0.930  0.967    0.972  logistic   0.014
credit-g (real)         0.761  0.735  0.760  0.719  0.764    0.771  boosting   0.010
linear, 40-d            0.820  0.710  0.805  0.725  0.735    0.720  logistic   0.033
two moons               0.853  0.900  0.895  0.887  0.893    0.895      k-NN   0.036
axis-aligned rule       0.640  0.636  0.686  0.938  0.948    0.944    forest   0.025
Toda família chega ao topo (sozinha ou empatada) em algum lugar e toda família perde feio em algum lugar:
- Linear, 40-d: 200 linhas, uma fronteira que é de fato um hiperplano. A regressão logística fica em primeiro (0,820), empatada com a SVM (0,805: 0,015 atrás, bem dentro do desvio-padrão entre folds do vencedor, 0,033). O k-NN, a árvore e os dois ensembles ficam entre 0,710 e 0,735. O k-NN e a árvore gastam sua liberdade ajustando ruído: com 200 pontos em 40 dimensões, eles estão do lado da variância. Os ensembles corrigem a variância, mas não a aposta: toda árvore corta ao longo de um eixo por vez, e um hiperplano inclinado em 40 dimensões, desenhado com degraus alinhados aos eixos a partir de 200 linhas, vira uma escada grosseira, não importa quantas árvores entrem na média ou na soma.
- Duas luas: uma fronteira curva em 2 dimensões, com pontos de sobra. O k-NN fica em primeiro (0,900), mas cinco famílias terminam entre 0,887 e 0,900, dentro do desvio-padrão entre folds de 0,036: um empate. Só a regressão logística, que só sabe traçar uma reta, fica para trás (0,853).
- Regra alinhada aos eixos: o rótulo depende de limiares em 2 de 20 colunas. A família das árvores vence de lavada: a floresta com 0,948, o boosting com 0,944 e a árvore sozinha com 0,938 (um empate a três) contra no máximo 0,686. As árvores escolhem as duas colunas úteis e cortam ao longo delas. O k-NN e a SVM medem distâncias nas 20 dimensões, onde 18 colunas de ruído afogam as 2 que importam (a maldição da dimensionalidade da aula de k-NN); uma reta não consegue expressar "\(x_0 < 0{,}2\) ou (\(x_0 > 0{,}6\) e \(x_1 > 0{,}3\))".
- Os conjuntos reais são menos dramáticos: nos retornos de radar a SVM, a floresta e o boosting empatam; em breast cancer a regressão logística e a SVM empatam com 0,979, com o boosting 0,007 atrás; em credit-g o boosting fica em primeiro (0,771), 0,010 à frente da regressão logística, cerca de um desvio-padrão entre folds.
- Os ensembles são a aposta mais segura desta tabela: a floresta ou o boosting fica em primeiro, ou dentro do ruído do primeiro, em cinco dos seis conjuntos; é por isso que ensembles de árvores costumam ser a primeira tentativa em dados tabulares (gradient boosting). Mais segura não quer dizer sempre: no problema linear eles perdem 0,085 e 0,100 para uma regressão logística.
Esse é o conteúdo prático dos teoremas de não existe almoço grátis (no free lunch) de Wolpert (1996): na média sobre todos os problemas possíveis, todo algoritmo de aprendizado tem o mesmo erro nos pontos que não viu. Um algoritmo só vence em alguns problemas perdendo em outros. O aprendizado funciona na prática porque os problemas reais não são arbitrários. Eles têm estrutura e cada família aposta em um tipo de estrutura (seu viés indutivo): um hiperplano para a regressão logística, "pontos próximos compartilham rótulos" para o k-NN, uma fronteira suave para o kernel RBF, "poucos limiares em poucos atributos" para as árvores, mantida pelos ensembles, que só baixam a variância (a floresta) ou o viés (o boosting) dessa aposta. Uma família vence quando sua aposta combina com o problema. Não dá para saber a combinação de antemão; é por isso que a seleção de modelos compara famílias, nos mesmos folds, antes de escolher.
O simulador mostra a tabela como um mapa: cada célula é a melhor acurácia de uma família num conjunto, com moldura quando ela está a menos de um desvio-padrão entre folds do vencedor, ou seja, empatada com ele. Clique num conjunto para ver as barras e a aposta que explica o resultado:
A palavra viés apareceu nesta aula com três sentidos diferentes, que vale separar:
| palavra | onde | o que quer dizer | o que fazer com ele |
|---|---|---|---|
| viés (do viés–variância) | seções 1 e 2 | o erro sistemático de uma família, na média sobre os conjuntos de treino | mais capacidade ou atributos melhores o reduzem |
| viés indutivo | esta seção | a aposta de uma família sobre a forma do problema (um hiperplano, vizinhos, limiares) | nada a reduzir: escolher a família cuja aposta combina com os dados |
| viés de seleção (maldição do vencedor) | seção 8 | a nota do vencedor de uma busca superestima o seu desempenho | medir de novo em dados que não participaram da escolha |
A navalha de Occam, operacionalizada
Em breast cancer a regressão logística e a SVM chegam ambas a 0,979, com o boosting 0,007 atrás. Quando candidatos estão dentro do ruído uns dos outros, vale a regra da aula de validação cruzada: prefira o mais simples e, dentro de uma família, fique com a configuração mais simples a menos de um erro-padrão da melhor. Aqui isso significa a regressão logística: em breast cancer, 31 números para guardar, um produto escalar por previsão, coeficientes que podem ser explicados, contra um conjunto de vetores de suporte e um kernel, ou centenas de árvores. Em credit-g a vantagem do boosting (0,010) é de cerca de um desvio-padrão entre folds: antes de pagar pelo ensemble, compare os dois fold a fold.
Essa é a navalha de Occam tornada operacional e ela é mais do que gosto. Quando os dados não conseguem distinguir dois modelos, a diferença entre seus erros verdadeiros é pequena de qualquer jeito. Mas um modelo mais flexível tem notas de validação cruzada mais ruidosas (seção 3), então uma vitória apertada do modelo complexo tem mais chance de ser sorte da seleção; o mais simples também é menos sensível à amostra específica, então tem mais chance de se sustentar quando os dados mudarem. Além disso, é mais barato de guardar, rodar e explicar. Mais simples não quer dizer "menos linhas de código": quer dizer menos parâmetros efetivos, regularização mais forte, menos atributos.
11. O fluxo completo
Etapa 4. Tudo o que esta aula e a de validação ensinaram cabe em cinco passos e só um deles toca o conjunto de teste (script da figura):
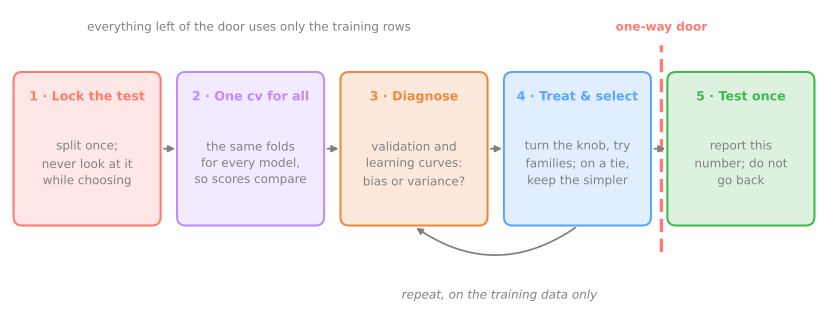
- Tranque o teste antes de olhar qualquer coisa: toda decisão tomada com ele o transforma em validação.
- Um único
cvpara todos os candidatos, para que as notas possam ser comparadas fold a fold. - Diagnostique antes de ajustar: as curvas dizem se o recurso a gastar é capacidade, regularização ou dados.
- Trate e selecione na validação cruzada, comparando famílias; num empate dentro do ruído, fique com o mais simples. A nota do vencedor é otimista (seção 8).
- Teste uma vez e reporte esse número, sem voltar à etapa 4 para "melhorar".
Por que a porta é de mão única fica visível numa simulação. Tome 42 configurações (o tamanho da busca da seção 9) com acurácia verdadeira em torno de 0,80, espalhada por \(\tau = 0{,}01\), e notas de validação e de teste com ruído \(\sigma = 0{,}015\). Escolhendo o vencedor pela validação, a nota de validação dele é em média 0,839, mas a acurácia verdadeira é 0,812, e o teste, aberto uma vez, dá 0,812: honesto. Escolhendo pelo teste (espiando), é o teste que vira 0,839, e só um conjunto de teste novo voltaria a mostrar 0,811. Mexa no número de candidatos e no ruído:
Lab avançado — selecionar e testar
O lab fundamental terminou com três famílias tratadas: um Ridge cúbico regularizado, uma árvore com folhas de 10 distritos e um k-NN com \(k = 10\). Esta parte as põe numa única busca junto com os dois ensembles desta seção, uma random forest e um gradient boosting, mede o quanto o ranking é confiável e só então abre o conjunto de teste. Continue no mesmo notebook, na mesma sessão: os passos abaixo usam pre, cv, rmse e candidates dos passos 1 a 6.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Continue no notebook do Colab, a partir do passo 7. Se a sessão caiu, rode antes as células dos passos 1 a 6 (Ambiente de execução → Executar anteriores).
- Como no lab fundamental: Preveja antes de rodar, compare com esta página e tente as Simulações antes de abrir a solução.
- Ritmo sugerido: passo 7 e a primeira simulação em 12 min (a busca ajusta 150 modelos: de um a dois minutos no Colab); passo 8 em 8 min; passo 9 e a segunda simulação em 10 min.
Passo 7 — uma busca sobre as cinco famílias
Preveja. Uma única busca põe Ridge, k-NN, árvore, uma random forest e um gradient boosting lado a lado. Você espera que o vencedor supere a melhor configuração de cada outra família por mais ou por menos que a oscilação da diferença entre eles de um fold para outro? E o segundo colocado da sua própria família?
from sklearn.ensemble import HistGradientBoostingRegressor, RandomForestRegressor
from sklearn.model_selection import GridSearchCV
from sklearn.pipeline import Pipeline

pipe = Pipeline([('pre', pre), ('poly', PolynomialFeatures()), ('scale', StandardScaler()),
                 ('model', Ridge())])
skip = {'poly': ['passthrough'], 'scale': ['passthrough']}      # etapas que a família não usa
param_grid = [
    {'model': [Ridge()], 'poly__degree': [1, 2, 3], 'model__alpha': [1, 10, 100, 1000]},
    {'model': [KNeighborsRegressor()], **skip,
     'model__n_neighbors': [5, 10, 20], 'model__weights': ['uniform', 'distance']},
    {'model': [DecisionTreeRegressor(random_state=42)], **skip, 'model__min_samples_leaf': [5, 10, 20, 40]},
    {'model': [RandomForestRegressor(n_estimators=100, random_state=42)], **skip,
     'model__max_features': [0.33, 1.0], 'model__min_samples_leaf': [1, 5]},
    {'model': [HistGradientBoostingRegressor(max_iter=500, early_stopping=True, random_state=42)], **skip,
     'model__learning_rate': [0.05, 0.1], 'model__max_leaf_nodes': [15, 31]},
]
search = GridSearchCV(pipe, param_grid, cv=cv, scoring='neg_root_mean_squared_error', n_jobs=-1)
search.fit(X_train, y_train)


def describe(params):
    name = type(params['model']).__name__
    knobs = ', '.join(f"{k.split('__')[-1]}={v}" for k, v in params.items() if k != 'model'
                      and v != 'passthrough')
    return f"{name}({knobs})"


res = pd.DataFrame(search.cv_results_).sort_values('rank_test_score')
print(len(res), 'configurations ·', len(res) * cv.get_n_splits(), 'fits')
for _, row in res.iloc[[0, 1, 2, 3, 4, 8, 10, 12]].iterrows():
    print(f"{row['rank_test_score']:2d}  {abs(row['mean_test_score']):6.0f} ± {row['std_test_score']:5.0f}"
          f"  {describe(row['params'])}")
30 configurations · 150 fits
 1   46644 ±  1311  HistGradientBoostingRegressor(learning_rate=0.05, max_leaf_nodes=31)
 2   46707 ±  1079  HistGradientBoostingRegressor(learning_rate=0.1, max_leaf_nodes=31)
 3   47436 ±  1034  HistGradientBoostingRegressor(learning_rate=0.1, max_leaf_nodes=15)
 4   47620 ±  1130  HistGradientBoostingRegressor(learning_rate=0.05, max_leaf_nodes=15)
 5   49022 ±  1407  RandomForestRegressor(max_features=0.33, min_samples_leaf=1)
 9   57473 ±  2381  Ridge(alpha=100, degree=3)
11   57796 ±  1534  DecisionTreeRegressor(min_samples_leaf=10)
13   58517 ±  1084  KNeighborsRegressor(n_neighbors=10, weights=distance)
Os passos 3 a 6 foram diagnóstico; este é seleção. Um único GridSearchCV contém as cinco famílias: a vaga model recebe um Ridge, um k-NN, uma árvore, uma floresta ou um boosting; 'passthrough' (o dicionário skip) desliga as etapas polinomial e de escalonamento para as famílias que não as usam. 30 configurações, 150 ajustes, os mesmos cinco folds de todos os passos anteriores. A saída mostra as quatro configurações de boosting e a melhor de cada outra família.
O ranking tem duas mensagens, uma por nível:
- Entre famílias, uma ordem clara. As quatro configurações de boosting ocupam os quatro primeiros lugares (de 46.644 a 47.620); as florestas vêm em seguida (49.022 na melhor); as três famílias do lab fundamental só começam no 9º lugar, com o Ridge cúbico em 57.473, mais de US$ 10.000 atrás do vencedor. É o que o diagnóstico dos passos 4 a 6 pedia: a família das árvores era limitada pela variância, que é o que a média de árvores corta (a floresta), e o boosting soma árvores pequenas, cada uma corrigindo o viés deixado pela soma até ali.
- Dentro da família do boosting, um empate. Os dois primeiros, 46.644 e 46.707, estão a US$ 63 um do outro. A regra da aula de validação cruzada (compare fold a fold) compara a diferença média com o espalhamento das diferenças fold a fold: aqui, US$ 63 contra US$ 365 (simulação abaixo). Os dados não distinguem uma taxa de 0,05 de uma de 0,1 com árvores de 31 folhas. O
GridSearchCVdevolve o 1º lugar porque precisa devolver alguma coisa.
Simulação: as duas mensagens, fold a fold. Confirme as duas com os números de cada fold: o cv_results_ guarda a nota de cada configuração em cada um dos cinco folds (split0_test_score, …). Ponha o vencedor ao lado do segundo colocado, da melhor floresta e do melhor Ridge. Em quantos folds o vencedor fica à frente de cada um e por quanto?
Solução
res7 = pd.DataFrame(search.cv_results_)
family = [type(p['model']).__name__ for p in res7['params']]
best_of = lambda name: res7[[f == name for f in family]]['mean_test_score'].idxmax()
rows = {'winner': res7['rank_test_score'].idxmin(), 'runner-up': res7.index[res7['rank_test_score'] == 2][0],
        'forest': best_of('RandomForestRegressor'), 'ridge': best_of('Ridge')}
folds = pd.DataFrame({name: [abs(res7.loc[i, f'split{k}_test_score']) for k in range(5)]
                      for name, i in rows.items()})
print(folds.round(0).astype(int).to_string())
for other in ['runner-up', 'forest', 'ridge']:
    d = folds[other] - folds['winner']
    print(f"{other} - winner: mean {d.mean():5.0f} · std {d.std(ddof=0):4.0f} · "
          f"winner ahead in {(d > 0).sum()} of 5 folds")
   winner  runner-up  forest  ridge
0   46446      46412   48782  55775
1   45246      45898   47727  60561
2   45642      45914   48265  54694
3   46890      46506   48592  56265
4   48997      48806   51744  60068
runner-up - winner: mean    63 · std  365 · winner ahead in 2 of 5 folds
forest - winner: mean  2378 · std  365 · winner ahead in 5 of 5 folds
ridge - winner: mean 10829 · std 2354 · winner ahead in 5 of 5 folds
Contra o segundo colocado da própria família, o vencedor fica à frente em só 2 dos 5 folds, e a diferença média, US$ 63, é um sexto do desvio das diferenças (US$ 365): um empate, o sinal troca de um fold para outro. Contra a melhor floresta ele fica à frente em todos os folds, por US$ 2.378 em média, seis vezes e meia o espalhamento das diferenças: uma diferença real, embora as médias das duas famílias estejam a só uns dois desvios-padrão entre folds uma da outra. Contra o melhor Ridge, a distância é de US$ 10.829. Repare também quais folds são difíceis: o fold 4 é o pior para os dois boostings e para a floresta, enquanto o pior do Ridge é o fold 1, em que o boosting vai melhor. Famílias construídas sobre apostas diferentes erram em linhas diferentes.
Passo 8 — regressão à média: medir de novo os líderes
Preveja. Validando as mesmas 30 configurações com outros folds, os três primeiros mantêm a ordem? E a ordem do ranking inteiro, do melhor ao pior?
search_new = GridSearchCV(pipe, param_grid, cv=KFold(n_splits=5, shuffle=True, random_state=7),
                          scoring='neg_root_mean_squared_error', n_jobs=-1).fit(X_train, y_train)
old = np.abs(search.cv_results_['mean_test_score'])
new = np.abs(search_new.cv_results_['mean_test_score'])
print('old rank  new rank    old RMSE  new RMSE')
for i in np.argsort(old)[:5]:
    print(f"{search.cv_results_['rank_test_score'][i]:8d} {search_new.cv_results_['rank_test_score'][i]:9d}"
          f" {old[i]:11.0f} {new[i]:9.0f}   {describe(search.cv_results_['params'][i])}")
print(f"old RMSE of all {len(old)} configurations: from {old.min():.0f} to {old.max():.0f}")
print(f"correlation between the two runs, all {len(old)} configurations: {np.corrcoef(old, new)[0, 1]:.3f}")
old rank  new rank    old RMSE  new RMSE
       1         1       46644     46631   HistGradientBoostingRegressor(learning_rate=0.05, max_leaf_nodes=31)
       2         2       46707     46793   HistGradientBoostingRegressor(learning_rate=0.1, max_leaf_nodes=31)
       3         3       47436     47109   HistGradientBoostingRegressor(learning_rate=0.1, max_leaf_nodes=15)
       4         4       47620     47512   HistGradientBoostingRegressor(learning_rate=0.05, max_leaf_nodes=15)
       5         5       49022     49369   RandomForestRegressor(max_features=0.33, min_samples_leaf=1)
old RMSE of all 30 configurations: from 46644 to 68593
correlation between the two runs, all 30 configurations: 0.998
As mesmas 30 configurações, validadas de novo com folds embaralhados de outro jeito (random_state=7). No conjunto, as duas rodadas concordam quase perfeitamente (correlação 0,998): as configurações diferem muito entre si (de US$ 46.644 a US$ 68.593), então a maior parte da variação é "habilidade" e a confiabilidade do ranking como um todo é alta.
Desta vez os cinco primeiros também mantêm a ordem, mas leia o tamanho dos movimentos: a terceira configuração se move US$ 327 (47.436 → 47.109) e a floresta, US$ 347, cinco vezes os US$ 63 que separam os dois primeiros. Que a ordem deles tenha sobrevivido a este embaralhamento também é sorte: com random_state de 1 a 5, os dois primeiros trocam de lugar três vezes. Na linguagem da seção de regressão à média, a variação de habilidade entre os dois líderes é quase zero, então a ordem entre eles é quase pura sorte dos folds; entre o boosting e a floresta ela é grande, e essa ordem se mantém. O que o embaralhamento não consegue mostrar é se os líderes estão inflados: as duas rodadas usam as mesmas linhas, então a sorte de quais distritos foram coletados é a mesma nas duas, e o vencedor foi escolhido nelas. Só dados que não participaram da escolha podem mostrar isso, e o passo 9 faz isso. A lição deste passo é mais estreita: um ranking dentro da faixa de ruído não é uma descoberta.
Passo 9 — o único teste
Preveja. O RMSE de teste do vencedor vai ficar acima, abaixo ou perto dos US$ 46.644 da validação cruzada? Que diferença seria motivo de preocupação?
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

final = search.best_estimator_                        # já reajustado em todo o X_train
pred = final.predict(X_test)
print(describe(search.best_params_))
print(f"CV RMSE (selection): {abs(search.best_score_):.0f}")
print(f"test RMSE (once):    {root_mean_squared_error(y_test, pred):.0f}")
print(f"test MAE:            {mean_absolute_error(y_test, pred):.0f}")
HistGradientBoostingRegressor(learning_rate=0.05, max_leaf_nodes=31)
CV RMSE (selection): 46644
test RMSE (once):    46998
test MAE:            30681
O vencedor encontra os 4.128 distritos trancados, uma vez: RMSE de US$ 46.998, contra os US$ 46.644 da validação cruzada usados para selecioná-lo. A diferença, US$ 354, está bem dentro de um desvio-padrão entre folds (1.311): é compatível com uma estimativa honesta e com uma maldição do vencedor pequena (umas 13.000 linhas de treino por fold, 30 candidatos). O empate do passo 7 significa que o segundo colocado, com taxa 0,1, muito provavelmente teria caído no mesmo lugar. O erro típico ainda é grande: um erro absoluto médio de US$ 30.681, em distritos cujo valor mediano fica em torno de US$ 180.000 (passo 1).
Onde mora o erro que resta? As curvas de aprendizado do passo 4 foram desenhadas para os modelos sem tratamento (a curva do próprio vencedor é o primeiro exercício abaixo), então elas só sugerem uma resposta. O modelo linear puro tinha esgotado o que um hiperplano consegue aprender, o que os termos polinomiais corrigiram só em parte, e a família das árvores era limitada pela variância; os ensembles responderam às duas coisas, como preveem as aulas de random forest e de gradient boosting. Parte do que sobra nem pode ser aprendida com estas colunas: os 965 distritos no teto de US$ 500.001 são avaliados contra um número que não é o preço deles. O que você não deve fazer agora é voltar ao passo 7 e testar mais configurações até o RMSE de teste melhorar: o conjunto de teste viraria um conjunto de validação, e os US$ 46.998 deixariam de significar qualquer coisa.
Simulação: quão precisa é a nota de teste? Uma única nota de teste também é uma medida ruidosa: outros 4.128 distritos dariam outro número. Estime esse ruído sem tocar em dados novos: reamostre com reposição, 1.000 vezes, os pares (valor verdadeiro, previsão) do teste e recalcule o RMSE de cada reamostra. Os US$ 46.644 da CV caem dentro da faixa?
Solução
boot = np.random.default_rng(0)
yt, pt = y_test.to_numpy(), pred
scores = []
for _ in range(1000):
    idx = boot.integers(0, len(yt), len(yt))           # uma reamostra dos distritos de teste
    scores.append(root_mean_squared_error(yt[idx], pt[idx]))
lo, hi = np.percentile(scores, [2.5, 97.5])
print(f"test RMSE {root_mean_squared_error(yt, pt):.0f} · 95% of resamples between {lo:.0f} and {hi:.0f} "
      f"(width {hi - lo:.0f})")
print(f"CV RMSE of the winner: {abs(search.best_score_):.0f}")
test RMSE 46998 · 95% of resamples between 44728 and 49270 (width 4541)
CV RMSE of the winner: 46644
95% das reamostras ficam entre US$ 44.728 e US$ 49.270: a nota de teste vale "uns 47 mil, com 2 mil para cada lado". A estimativa da CV, 46.644, fica bem dentro da faixa, então a diferença de US$ 354 entre CV e teste não é evidência de nada. Isso não autoriza testar o segundo colocado ou a floresta para ver qual se sai melhor: a nota de teste só vale para o modelo escolhido antes de olhar.
Para fechar a aula. Em uma frase cada: (1) por que a nota do vencedor de uma busca em grade tende a cair quando medida de novo? (2) Como decidir entre dois candidatos cuja diferença média é menor que o espalhamento das suas diferenças fold a fold? (3) Por que nenhuma família de modelos vence em todo problema?
Sua vez (avançado)
Para casa, com mais tempo:
- O vencedor esgotou as opções? Desenhe a curva de aprendizado do pipeline vencedor (
search.best_estimator_) como no passo 4. Ele está do lado do viés ou da variância agora? Mais distritos o ajudariam? - Aleatória em vez de grade. Troque a grade do passo 7 por um
RandomizedSearchCVcomn_iter=30,loguniform(1, 1e4)paraalpha,randint(3, 60)paran_neighborsemin_samples_leafeloguniform(0.02, 0.3)para alearning_ratedo boosting (doscipy.stats). Ele encontra uma configuração a menos de um desvio-padrão entre folds do vencedor da grade, com menos ajustes? - Avalie o procedimento (750 ajustes: vários minutos no Colab). Envolva a
searchemcross_val_score(search, X_train, y_train, cv=KFold(5, shuffle=True, random_state=1), scoring='neg_root_mean_squared_error')(CV aninhada). Compare o resultado com osearch.best_score_e com o RMSE de teste do passo 9. - A confiabilidade certa. Na simulação de regressão à média da seção 8, que confiabilidade \(r\) faria os 10% de cima manterem metade da vantagem? Encontre o desvio-padrão da sorte que a produz e confira com o código.
- Uma sétima família. Acrescente à
param_gridda seção 9 umaSVC(kernel='linear')com uma grade sobreC. Em quais conjuntos da tabela de "não existe almoço grátis" ela empata com a regressão logística e por que você esperaria isso?
Referências
- Geman, S.; Bienenstock, E.; Doursat, R. "Neural Networks and the Bias/Variance Dilemma." Neural Computation 4, no. 1 (1992): 1–58 — o artigo que fez da decomposição a lente padrão sobre o sobreajuste. DOI
- Hastie, T.; Tibshirani, R.; Friedman, J. The Elements of Statistical Learning, 2ª ed. Springer (2009), cap. 7 "Model Assessment and Selection" — a decomposição viés–variância, o número efetivo de parâmetros, a validação cruzada. PDF gratuito
- Galton, F. "Regression towards Mediocrity in Hereditary Stature." Journal of the Anthropological Institute 15 (1886): 246–263 — a regressão à média e a origem da palavra. PDF (galton.org)
- Wolpert, D. H. "The Lack of A Priori Distinctions Between Learning Algorithms." Neural Computation 8, no. 7 (1996): 1341–1390 — os teoremas de "não existe almoço grátis" para o aprendizado supervisionado. DOI
- Stone, M. "Cross-Validatory Choice and Assessment of Statistical Predictions." JRSS B 36 (1974). DOI
- Bergstra, J.; Bengio, Y. "Random Search for Hyper-Parameter Optimization." JMLR 13 (2012). texto completo
- Pace, R. K.; Barry, R. "Sparse Spatial Autoregressions." Statistics & Probability Letters 33, no. 3 (1997): 291–297 — os dados de preços de casas da Califórnia usados no lab. DOI
Quiz
O quiz cobre a abordagem fundamental.