O caminho desta parte
- Uma escala comumo número efetivo de parâmetros
- Regressão à médiapor que o escore do vencedor cai ao medir de novo
- Comparar famíliasuma busca sobre todas as famílias, não existe almoço grátis, a navalha de Occam
- O fluxo completocinco passos, uma porta de mão única antes do teste, depois o lab
Uma escala comum: parâmetros efetivos
Para modelos cuja previsão é uma soma ponderada dos rótulos de treino: some o peso que cada ponto dá ao próprio rótulo.
\(n\): pontos de treino · \(p\): colunas · \(k\): vizinhos no k-vizinhos mais próximos (k-NN, do inglês k-Nearest Neighbors) · \(\alpha\): a penalidade do Ridge.
| modelo | parâmetros efetivos | com \(n = 30\) |
|---|---|---|
| mínimos quadrados, \(p\) colunas | \(p\) | |
| k-NN | \(n / k\) | \(k = 30\): 1 · \(k = 3\): 10 · \(k = 1\): 30 |
| Ridge | cai de \(p\) em direção a 1 (o intercepto, sem penalidade) à medida que \(\alpha\) cresce | contínuo |
Simulador: três botões, uma escala
Grau, \(k\) e \(\alpha\) na mesma amostra de 30 pontos, no eixo de parâmetros efetivos. Preveja. Os três fundos caem perto uns dos outros?
Regressão à média
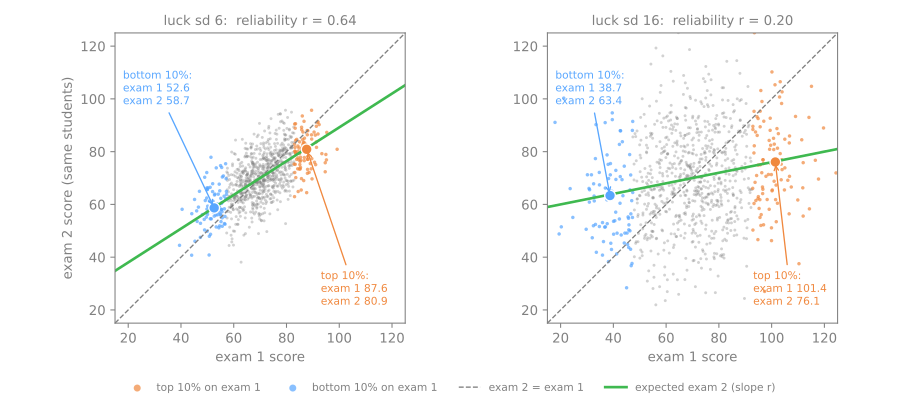
Nota = habilidade (desvio-padrão, dp, 8) + sorte do dia (o dp dela na primeira coluna). Confiabilidade: \(r = \frac{\sigma^2_\text{habilidade}}{\sigma^2_\text{habilidade} + \sigma^2_\text{sorte}} = \frac{8^2}{8^2 + \text{sorte}^2}\).
Preveja. Os 10% de cima na prova 1 mantêm a nota na prova 2? E quando a sorte cresce?
| dp da sorte | \(r\) | prova 1 | prova 2 |
|---|---|---|---|
| 2 | 0,94 | 84,4 | 83,5 |
| 6 | 0,64 | 87,6 | 80,9 |
| 16 | 0,20 | 101,4 | 76,1 |
Na seleção de modelos
- Uma configuração é um estudante; seu desempenho futuro, a habilidade; sua nota de validação cruzada (CV, do inglês cross-validation), uma prova com sorte (os folds, a amostra).
- Perto do topo de uma grade, as configurações quase não diferem (pouca habilidade) e o ruído da CV continua o mesmo: confiabilidade baixa.
- Mais candidatos → vencedor mais extremo → mais sortudo. Em puro ruído, o melhor de 100 caiu de 61,2% para 50,9%.
Simulador: regressão à média, exata
Os 10% de cima voltam para \(70 + r \cdot D\). Preveja. Com \(\sigma = 0\), quanto eles caem? E com \(\sigma = 16\)?
A família como hiperparâmetro
pipe = Pipeline([('scale', StandardScaler()), ('model', LogisticRegression())])
param_grid = [                                     # uma lista de grades: uma por família
    {'model': [LogisticRegression(max_iter=5000)], 'model__C': np.logspace(-3, 3, 7)},
    {'model': [KNeighborsClassifier()], 'model__n_neighbors': [1, 3, 5, 9, 15, 25, 51]},
    {'model': [SVC()], 'model__C': [0.1, 1, 10, 100], 'model__gamma': ['scale', 0.01, 0.1]},
    {'model': [DecisionTreeClassifier(random_state=0)], 'scale': ['passthrough'],
     'model__max_depth': [1, 2, 3, 4, 6, 8, 12, None]},
    {'model': [RandomForestClassifier(n_estimators=200, random_state=0)], 'scale': ['passthrough'],
     'model__max_features': ['sqrt', 0.5], 'model__min_samples_leaf': [1, 5]},
    {'model': [HistGradientBoostingClassifier(random_state=0)], 'scale': ['passthrough'],
     'model__learning_rate': [0.05, 0.1], 'model__max_leaf_nodes': [7, 31]},
]
Retornos de radar: 42 configurações, 6 famílias, uma busca. Máquina de vetores de suporte (SVM, do inglês support vector machine) 0,946 · floresta 0,943 · boosting 0,940 (empate a três) · árvore 0,897 · logística 0,883 · k-NN 0,866.
model recebe estimadores diferentes; 'passthrough' desliga uma etapa. Mesmo cv para todas: dá para comparar fold a fold.Não existe almoço grátis
| conjunto | logística | k-NN | SVM | árvore | floresta | boosting |
|---|---|---|---|---|---|---|
| ionosphere (real) | 0,883 | 0,866 | 0,946 | 0,897 | 0,943 | 0,940 |
| breast cancer (real) | 0,979 | 0,965 | 0,979 | 0,930 | 0,967 | 0,972 |
| credit-g (real) | 0,761 | 0,735 | 0,760 | 0,719 | 0,764 | 0,771 |
| linear, 40-d | 0,820 | 0,710 | 0,805 | 0,725 | 0,735 | 0,720 |
| two moons | 0,853 | 0,900 | 0,895 | 0,887 | 0,893 | 0,895 |
| axis-aligned rule | 0,640 | 0,636 | 0,686 | 0,938 | 0,948 | 0,944 |
As apostas de cada família
Regressão logística
a fronteira é um hiperplano
k-NN
pontos próximos compartilham rótulos
SVM com kernel de função de base radial (RBF, do inglês radial basis function)
a fronteira é suave
Árvore, floresta, boosting
poucos limiares em poucos atributos; a floresta tira a variância dessa aposta pela média, o boosting tira o viés
Simulador: não existe almoço grátis
Moldura = a menos de 1 dp entre folds do vencedor. Preveja. Em quantos conjuntos as árvores (floresta ou boosting) ficam no topo ou empatadas com ele?
Três sentidos de "viés"
A mesma palavra, três ideias desta aula.
| o que quer dizer | o que fazer | |
|---|---|---|
| viés (viés–variância) | erro sistemático da família, na média sobre conjuntos de treino | mais capacidade, atributos melhores |
| viés indutivo | a aposta da família sobre a forma do problema | escolher a família cuja aposta combina |
| viés de seleção | a nota do vencedor de uma busca é otimista | medir de novo em dados que não escolheram |
A navalha de Occam, operacionalizada
- Breast cancer: logística e SVM, ambas 0,979, com o boosting 0,007 atrás. Credit-g: boosting 0,771, logística 0,761, a um desvio-padrão entre folds.
- Num empate dentro do ruído, fique com o mais simples: 31 números e um produto escalar, contra vetores de suporte e um kernel, ou centenas de árvores.
- Por quê? Um modelo mais flexível tem notas de CV mais ruidosas, então sua vitória apertada tem mais chance de ser sorte da seleção; o mais simples também depende menos da amostra, se sustenta melhor quando os dados mudam e é mais barato de rodar e explicar.
O fluxo completo
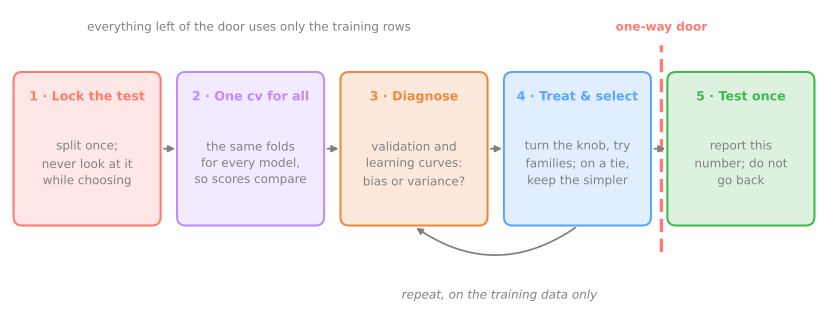
Simulador: a porta de mão única
42 configurações de acurácia parecida, notas com ruído. Preveja. A nota de validação do vencedor fica acima, abaixo ou igual à sua acurácia verdadeira? E se você escolher pelo teste?
Selecionar e testar, passos 7 a 9
- Mesmo notebook, mesma sessão: os passos usam
pre,cv,rmseecandidatesdos passos 1 a 6. - Uma busca sobre cinco famílias: Ridge, k-NN, árvore, uma random forest e um gradient boosting (150 ajustes, de um a dois minutos); reembaralhar os folds para ver quanto do ranking é sorte; abrir o teste uma vez.
- Notebook no Colab, a partir do passo 7.
- Simulações: as duas mensagens, fold a fold (passo 7) e quão precisa é a nota de teste? (passo 9).
Ritmo: passo 7 e a primeira simulação em 12 min; passo 8 em 8 min; passo 9 e a segunda simulação em 10 min.