O caminho desta parte
- Duas maneiras de errarmuitos ajustes de uma verdade: subajuste e sobreajuste
- Decompor o erroviés² + variância + ruído, medidos
- Diagnosticar com curvascurva de validação, curva de aprendizado, o diagnóstico
- Girar o botãoo botão de complexidade de cada família, depois o lab: diagnosticar e tratar
Um exemplo à mão, em \(x = 0{,}25\)
Cada conjunto de treino ajusta um polinômio e prevê em \(x = 0{,}25\), onde a verdade vale 1. Viés \(= \overline{\hat f} - f(0{,}25)\); variância \(= \tfrac{1}{k}\sum_i (\hat f_i - \overline{\hat f})^2\). Preveja. Qual grau acerta em média, e qual se espalha mais?
Duas maneiras de errar
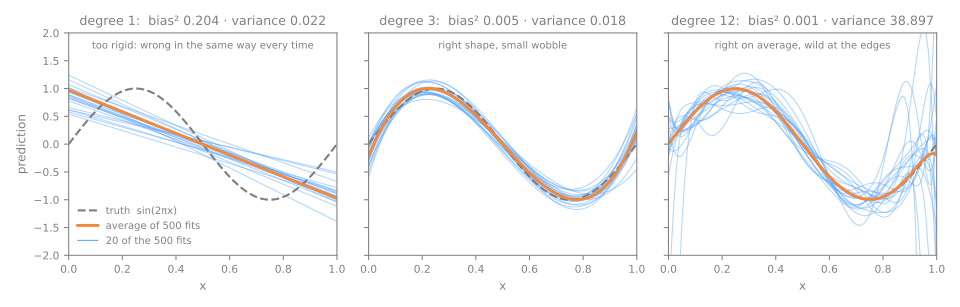
Verdade: \(\sin(2\pi x)\). Cada curva é um polinômio ajustado num conjunto de treino diferente de 30 pontos.
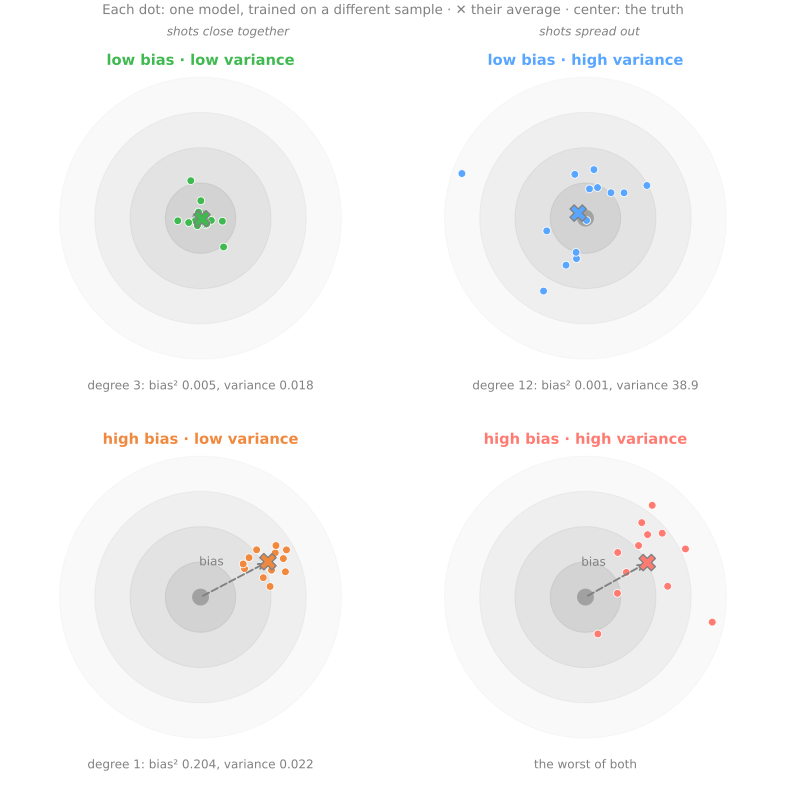
O alvo: viés e variância
A decomposição
Num \(x\) fixo: a verdade \(f(x)\); uma observação nova \(y = f(x) + \varepsilon\), ruído \(\varepsilon\) de média 0 e variância \(\sigma^2\); a previsão \(\hat f(x)\), aleatória porque depende do conjunto de treino; \(\mathbb{E}\): a média sobre conjuntos de treino e ruído.
\[ \mathbb{E}\big[(y - \hat f(x))^2\big] = \underbrace{\big(f(x) - \mathbb{E}[\hat f(x)]\big)^2}_{\text{viés}^2} + \underbrace{\mathbb{E}\big[(\hat f(x) - \mathbb{E}[\hat f(x)])^2\big]}_{\text{variância}} + \underbrace{\sigma^2}_{\text{ruído}} \]- \(y - \hat f = (f - \hat f) + \varepsilon\); o \(\varepsilon\) novo tem média 0 e é independente do conjunto de treino, então o termo cruzado some: \(\mathbb{E}[(y - \hat f)^2] = \mathbb{E}[(f - \hat f)^2] + \sigma^2\).
- Para qualquer \(Z\) aleatório: \(\mathbb{E}[Z^2] = (\mathbb{E}[Z])^2 + \operatorname{Var}(Z)\). Com \(Z = f - \hat f\): viés² + variância.
Viés: a melhor tentativa da família erra em média (uma reta não acompanha um seno). Variância: o preço de dar ouvidos à amostra. Ruído: a parte de \(y\) que não depende de \(x\); aqui \(\sigma^2 = 0{,}3^2 = 0{,}09\) e ninguém fica abaixo disso.
Medido com 500 conjuntos de treino
Preveja. 500 conjuntos de treino de 30 pontos por grau. Em que grau o erro quadrático médio (MSE, do inglês mean squared error) de teste é o menor? E o que acontece com a variância no grau 12?
| grau | viés² | variância | ruído | soma | MSE de teste medido |
|---|---|---|---|---|---|
| 0 | 0,495 | 0,020 | 0,09 | 0,605 | 0,603 |
| 1 | 0,204 | 0,022 | 0,09 | 0,316 | 0,314 |
| 3 | 0,005 | 0,018 | 0,09 | 0,113 | 0,112 |
| 5 | 0,000 | 0,045 | 0,09 | 0,135 | 0,135 |
| 7 | 0,001 | 0,635 | 0,09 | 0,726 | 0,723 |
| 12 | 0,001 | 38,897 | 0,09 | 38,987 | 38,985 |
- As colunas fecham por construção (a decomposição é uma identidade): a soma bate com o erro medido em dados novos, a menos do ruído novo (diferença ≤ 0,004).
- O viés cai até zero; a variância sobe devagar e depois com violência. Lida contra o grau, a soma tem forma de U: alta à esquerda (viés), mínima no grau 3, alta à direita (variância). As variâncias grandes são ordens de grandeza: um punhado das 500 amostras produz a maior parte delas.
Três famílias, a mesma forma de U
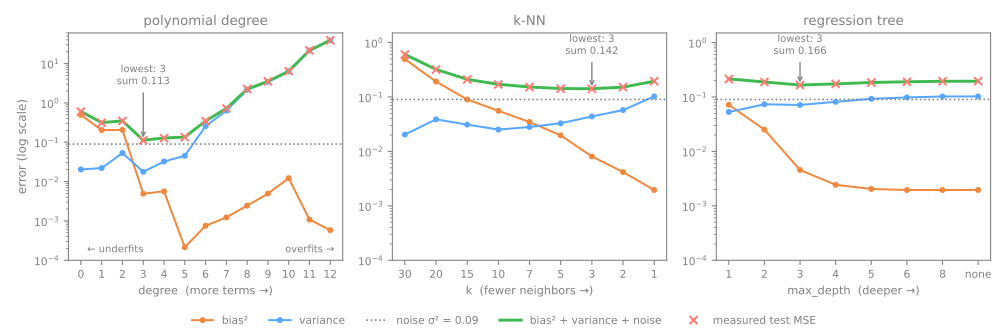
- O U é a curva verde, viés² + variância + ruído (o erro de teste esperado), contra a complexidade, que cresce para a direita (eixo vertical em escala log). Ela desce enquanto o viés cai mais rápido do que a variância sobe e volta a subir quando a variância domina. Fundos: grau 3 (0,113), \(k = 3\) (0,142) e profundidade 3 (0,166); o U da árvore é raso.
- O k-vizinhos mais próximos (k-NN, do inglês k-Nearest Neighbors) com \(k = 30\) (todos os pontos) é o polinômio de grau 0; no k-NN, \(k\) pequeno é o modelo complexo.
- O 1-NN copia um rótulo ruidoso: variância ≈ \(\sigma^2\) (a variância do ruído, 0,09), erro de teste ≈ \(2\sigma^2\) (medido: 0,195).
Simulador: subajuste ↔ sobreajuste, ao vivo
Preveja. Deslize o grau de 0 (puro viés) a 12 (pura variância). Qual erro só cai e qual volta a subir?
Curva de validação: o U sem conhecer a verdade
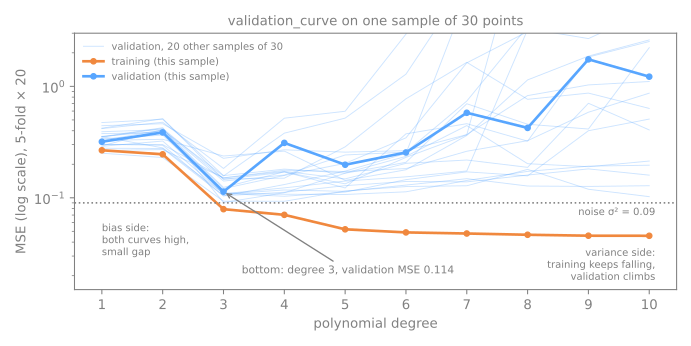
- Treino só desce: 0,267 → 0,046. Escolher por ele dá sempre o mais complexo.
- À esquerda: os dois altos e próximos — viés.
- À direita: treino cai, validação sobe até 1,748 — variância.
- Fundo no grau 3 (0,114): o mesmo da simulação com 500 amostras.
Curva de aprendizado: mais dados valem a pena?
Preveja. Cada vez mais pontos de treino: o erro do grau 1 continua caindo? E o do grau 9?
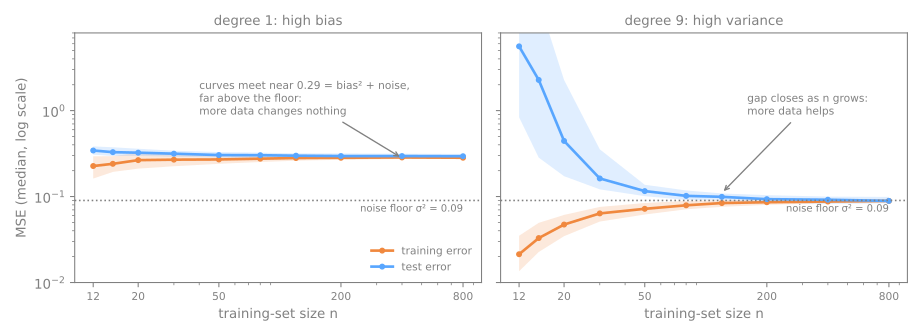
- Mediana de 300 conjuntos de treino por tamanho.
- Grau 1: treino e teste se encontram perto de 0,29 e ficam lá. Mais dados não ajudam.
- Grau 9: erro de teste 5,6 com 12 pontos, no piso de ruído por volta de 200. Com os coeficientes fixos, os dados fecham a distância.
O diagnóstico
Quatro ferramentas que se confundem
O que separa cada uma é o que se varia e o que fica fixo.
| o que se varia | o que fica fixo | precisa da verdade? | |
|---|---|---|---|
| decomposição viés–variância | o conjunto de treino (500 amostras) | o modelo | sim |
| curva de validação | a complexidade | os dados | não |
| curva de aprendizado | o número de linhas de treino | o modelo | não |
| busca em grade | combinações de hiperparâmetros | os dados e o cv | não |
Toda família tem um botão
Um botão é o hiperparâmetro que leva o modelo pelo eixo de complexidade do U: para a esquerda, mais viés (subajuste); para a direita, mais variância (sobreajuste). Viés alto pede girar para a direita; variância alta, para a esquerda. Preveja. Para deixar cada modelo mais complexo, para que lado você gira cada botão?
| família | botão | mais complexo (→ variância) | mais simples (→ viés) |
|---|---|---|---|
| polinômio | degree (grau) | maior | menor |
| Ridge, Lasso | alpha (força da penalidade) | menor | maior |
| regressão logística | C (inverso da penalidade) | maior | menor |
| k-NN | n_neighbors (\(k\), vizinhos que votam) | menor | maior |
| árvore | max_depth (profundidade) | maior | menor |
| árvore | min_samples_leaf (linhas mínimas por folha) | menor | maior |
alpha, n_neighbors e min_samples_leaf, maior é mais simples: mais penalidade, mais vizinhos na média, folhas maiores.GridSearchCV: a curva de validação que escolhe sozinha
from sklearn.model_selection import GridSearchCV, RepeatedKFold

# 1. o modelo, com o botão ainda solto
modelo = make_pipeline(PolynomialFeatures(), StandardScaler(),
                       LinearRegression())

# 2. os valores do botão a experimentar
#    (nome do passo + __ + hiperparâmetro)
grade = {"polynomialfeatures__degree": [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]}

# 3. como medir cada valor: 5 folds × 20 repetições (o cv do slide 10)
cv = RepeatedKFold(n_splits=5, n_repeats=20, random_state=0)
busca = GridSearchCV(modelo, grade, cv=cv,
                     scoring="neg_mean_squared_error")

# 4. mede os 10 graus, escolhe o menor erro
#    e reajusta o vencedor nas 30 linhas
busca.fit(X, y)
busca.best_params_       # {'polynomialfeatures__degree': 3}
O que a busca mediu (busca.cv_results_):
| grau | MSE de validação |
|---|---|
| 1 | 0,319 |
| 2 | 0,386 |
| 3 | 0,114 |
| 4 | 0,311 |
| 5 | 0,198 |
| 6 | 0,255 |
| 7 | 0,579 |
| 8 | 0,424 |
| 9 | 1,748 |
| 10 | 1,222 |
busca.predict passa a usar o grau 3. O MSE entra negativo (neg_mean_squared_error) porque o scikit-learn sempre maximiza.Resumo
- Erro de teste = viés² + variância + ruído. O ruído é um piso.
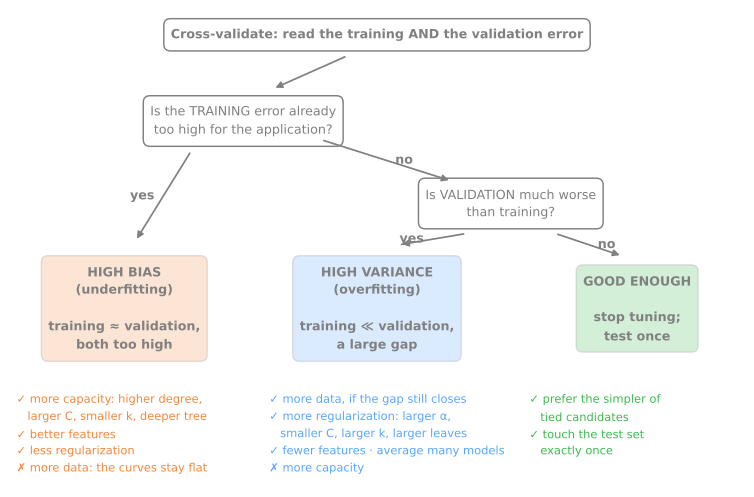
- Viés: treino ≈ validação, ambos altos. Variância: treino ≪ validação.
- Curva de validação varia a complexidade; curva de aprendizado varia os dados.
- Num modelo de capacidade fixa, mais dados curam a variância e não o viés; mais capacidade só cura viés.
- Todo modelo tem um botão de complexidade e alguns giram ao contrário.
Os padrões típicos
Nas curvas de erro de treino e de validação (aqui, baixo é bom):
| o que você vê | diagnóstico | ação |
|---|---|---|
| treino ≈ validação, ambos altos, curvas planas | viés | ajustar o modelo (mais capacidade) |
| treino baixo, validação alta, distância fechando | variância | mais dados |
| treino baixo, validação alta, distância parada | variância | regularizar ou simplificar |
| treino alto e distância grande | os dois | primeiro capacidade, depois rever |
| ambos baixos, juntos | ok | pare (talvez seja o piso de ruído) |
"Alto" é relativo: sem conhecer o \(\sigma^2\) (a variância do ruído), compare com um baseline (prever a média, um modelo simples) ou com o erro aceitável para o negócio.
Preços de casas: diagnosticar e tratar, passos 1 a 6
- California housing: 20.640 distritos, 9 atributos, alvo = valor mediano das casas.
- Três famílias (linear, k-NN, árvore): qual sofre de viés e qual de variância? Mais dados ajudariam? Qual botão girar?
- Notebook no Colab: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: a variância, vista de perto (passo 3) e o alpha como botão contínuo (passo 6).
Ritmo: passos 1 a 3 e a primeira simulação em 15 min; passos 4 a 6 e a segunda em 25 min.