Redes Neurais
Uma rede neural é construída a partir de uma peça que você já conhece bem. A regressão logística da aula de regressão logística calcula uma soma ponderada dos atributos, soma um viés e espreme o resultado com uma sigmoide: isso é um neurônio artificial. Uma rede neural liga muitos deles em camadas (as saídas de uma camada viram os atributos da seguinte) e treina todos os pesos juntos por gradiente descendente.
Esta aula constrói essa ideia em passos pequenos, cada um medido: o neurônio isolado e o perceptron de Rosenblatt (com um simulador), o problema do XOR que nenhum neurônio sozinho resolve, uma rede de duas camadas que o resolve com pesos escolhidos à mão, por que a função de ativação precisa ser não linear, a passagem direta como produtos de matrizes, a retropropagação (backpropagation) feita número a número numa rede 2-2-1 e, por fim, o MLPClassifier do scikit-learn na prática, incluindo uma comparação honesta com o gradient boosting da aula anterior em dados tabulares. A aula termina com um simulador passo a passo da retropropagação. A história completa (redes convolucionais, transformers, PyTorch) pertence ao curso de Deep Learning; aqui o objetivo é entender o que uma rede calcula e como ela aprende. Todo número citado vem dos blocos de código ou dos scripts das figuras que ficam ao lado desta página.
A aula segue um único pipeline em cinco etapas, desenhado abaixo: 1. um neurônio, a regressão logística lida como neurônio e o perceptron; 2. camadas ocultas, o XOR e por que a ativação precisa ser não linear; 3. passagem direta, o que uma rede calcula, como produtos de matrizes; 4. retropropagação, como cada peso aprende com o erro; 5. na prática, o treino com o scikit-learn e quando uma rede vale a pena. Cada etapa leva à sua seção; nos slides, uma faixa embaixo mostra em que etapa você está.
- Um neurônioa regressão logística como neurônio; o perceptron
- Camadas ocultasXOR, uma camada oculta, ativações não lineares
- Passagem diretaum produto de matrizes por camada; contar parâmetros
- Retropropagaçãoregra da cadeia, seis passos, uma perda não convexa
- Na práticaescala, largura, weight decay; dados tabulares
Slides
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
Da regressão logística a um neurônio
Etapa 1. Um neurônio artificial recebe entradas \(x_1, \dots, x_d\), calcula uma pré-ativação \(z\) (uma soma ponderada mais um viés) e a passa por uma função de ativação \(\varphi\):
Com \(\varphi = \sigma\), a sigmoide \(\sigma(z) = 1/(1 + e^{-z})\), isso é exatamente a regressão logística: \(a\) é a probabilidade prevista da classe positiva. Um exemplo numérico com \(w = (2, -1)\), \(b = 0{,}5\) e a entrada \(x = (1, 2)\): \(z = 2 \cdot 1 - 1 \cdot 2 + 0{,}5 = 0{,}5\) e \(a = \sigma(0{,}5) = 0{,}622\).
Tudo nesta aula muda uma de duas coisas: a ativação \(\varphi\) (um degrau, uma sigmoide, uma ReLU) ou a ligação (um neurônio ou camadas deles alimentando umas às outras). A primeira escolha histórica foi um degrau.
O perceptron
A regra de atualização
O perceptron de Frank Rosenblatt (1958) é um neurônio cuja ativação é um degrau: ele responde \(+1\) se \(z > 0\) e \(-1\) caso contrário, com rótulos \(y \in \{-1, +1\}\) como na aula de SVM. Ele foi construído como máquina, o Mark I Perceptron, com fotocélulas como entradas e potenciômetros movidos a motor como pesos. A regra de aprendizado não precisa de cálculo. Visite os pontos de treino um de cada vez; se o ponto \(i\) está do lado errado da fronteira ou exatamente sobre ela (\(y_i z_i \le 0\)), mova os pesos na direção dele:
se ele está do lado certo, não mude nada. Por que isso ajuda: depois da atualização, o escore do mesmo ponto passa a ser
ou seja, o escore com sinal do ponto mal classificado cresce \(\eta(\lVert x_i \rVert^2 + 1) > 0\): a fronteira gira e se desloca no sentido de classificá-lo corretamente. Uma atualização pode não bastar e ainda estragar outro ponto; por isso o procedimento percorre os dados em épocas (passadas completas) até que uma época não tenha nenhum erro.
Três atualizações à mão
Seis pontos (três de cada classe) e o início em \(w = (0, 0)\), \(b = 0\), \(\eta = 1\):
| ponto | \(x_1\) | \(x_2\) | \(y\) |
|---|---|---|---|
| A | 4 | 2 | +1 |
| B | 0 | 2 | −1 |
| C | 1 | 3 | −1 |
| D | 2 | 4 | −1 |
| E | 3 | 0 | +1 |
| F | 3 | 1 | +1 |
À mão, época 1.
- A: \(z = 0\), então \(y z = 0 \le 0\), um erro (todo ponto está "sobre a reta" quando \(w = 0\)). Atualização: \(w = (0, 0) + (+1)(4, 2) = (4, 2)\), \(b = 0 + 1 = 1\).
- B: \(z = 4 \cdot 0 + 2 \cdot 2 + 1 = 5\), mas \(y = -1\): \(y z = -5\), um erro. Atualização: \(w = (4, 2) - (0, 2) = (4, 0)\), \(b = 1 - 1 = 0\).
- C: \(z = 4 \cdot 1 + 0 \cdot 3 + 0 = 4\), \(y = -1\): um erro. Atualização: \(w = (4, 0) - (1, 3) = (3, -3)\), \(b = -1\).
- D, E, F: \(z = 3 \cdot 2 - 3 \cdot 4 - 1 = -7\), \(z = 9 - 0 - 1 = 8\), \(z = 9 - 3 - 1 = 5\), todos do lado certo. Nada muda.
A época 2 visita os seis pontos sem nenhum erro, então o perceptron para com a fronteira \(3x_1 - 3x_2 - 1 = 0\), a reta \(x_2 = x_1 - \tfrac{1}{3}\). O código segue os mesmos passos:
import numpy as np
import pandas as pd

X = np.array([[4, 2], [0, 2], [1, 3], [2, 4], [3, 0], [3, 1]])
y = np.array([+1, -1, -1, -1, +1, +1])


def perceptron(X, y, eta=1.0, epochs=20, trace=False):
    """Regra de Rosenblatt: visita os pontos em ordem e só atualiza nos erros."""
    w, b = np.zeros(X.shape[1]), 0.0
    history = []                                   # (erros, w, b) ao fim de cada época
    for epoch in range(1, epochs + 1):
        mistakes = 0
        for i in range(len(X)):
            z = w @ X[i] + b
            mistake = y[i] * z <= 0                # lado errado ou sobre a reta
            if mistake:
                w, b = w + eta * y[i] * X[i], b + eta * y[i]
                mistakes += 1
            if trace and epoch == 1:
                print(f"x = ({X[i][0]:g}, {X[i][1]:g})  y = {y[i]:+d}  z = {z:+g}  y·z = {y[i] * z + 0.0:+g}  "   # + 0.0: imprime -0 como 0
                      + (f"mistake -> w = ({w[0]:g}, {w[1]:g}), b = {b:g}" if mistake else "correct"))
        history.append((mistakes, w.copy(), b))
        if mistakes == 0:
            break
    return w, b, history


w, b, history = perceptron(X, y, trace=True)
print("mistakes per epoch:", [m for m, _, _ in history])
print(f"final w = ({w[0]:g}, {w[1]:g}), b = {b:g}")
x = (4, 2)  y = +1  z = +0  y·z = +0  mistake -> w = (4, 2), b = 1
x = (0, 2)  y = -1  z = +5  y·z = -5  mistake -> w = (4, 0), b = 0
x = (1, 3)  y = -1  z = +4  y·z = -4  mistake -> w = (3, -3), b = -1
x = (2, 4)  y = -1  z = -7  y·z = +7  correct
x = (3, 0)  y = +1  z = +8  y·z = +8  correct
x = (3, 1)  y = +1  z = +5  y·z = +5  correct
mistakes per epoch: [3, 0]
final w = (3, -3), b = -1
A biblioteca implementa a mesma regra. O Perceptron do scikit-learn, com passo constante eta0=1 e os pontos visitados na ordem original (shuffle=False), chega aos mesmos pesos; e, como o início é \(w = 0\), o tamanho do passo só muda a escala deles:
from sklearn.linear_model import Perceptron

skl = Perceptron(eta0=1.0, shuffle=False, tol=None, max_iter=20).fit(X, y)
print("scikit-learn:", skl.coef_[0], skl.intercept_[0])
w_small, b_small, _ = perceptron(X, y, eta=0.1)
print("eta = 0.1:   ", w_small.round(2), round(b_small, 2), "-> the same line, scaled by 0.1")
Os quatro estados da fronteira: nenhuma reta no início e uma reta depois de cada atualização (script da figura):
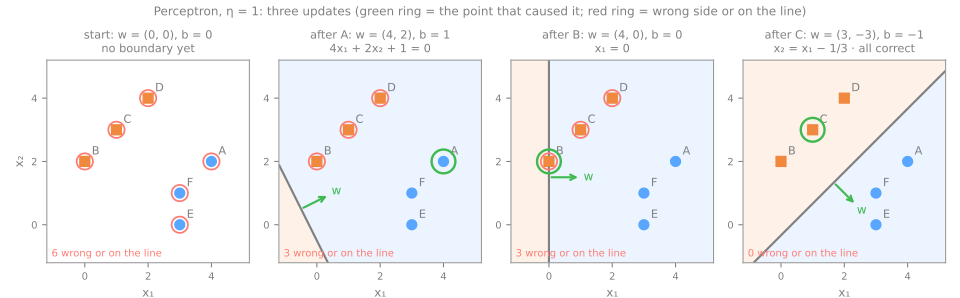
Repare no que a atualização faz geometricamente. O vetor \(w\) é perpendicular à fronteira e aponta para o lado \(+1\). Um erro num ponto \(-1\) (B, C) subtrai esse ponto de \(w\), girando o lado \(+1\) para longe dele; um erro num ponto \(+1\) o soma.
Convergência. Se uma reta separa as duas classes com alguma margem \(\gamma > 0\) e todo ponto fica a uma distância de no máximo \(R\) da origem (contando o viés como uma entrada extra fixa em 1), o perceptron comete no máximo \((R / \gamma)^2\) erros, qualquer que seja a ordem dos pontos (Novikoff, 1962). Ele para em alguma reta separadora, não na melhor; escolher a rua mais larga é o que a SVM acrescenta. E, se nenhuma reta separa as classes, o teorema não promete nada, como mostra a próxima seção.
Experimente: o simulador do perceptron
O simulador roda a mesma regra. Passo visita um ponto e mostra a conta: o escore \(z\), o teste \(y z \le 0\) e, num erro, a atualização com os números. Época inteira roda até o fim da passada atual e Rodar anima. O primeiro exemplo é o de seis pontos acima; o segundo sorteia um conjunto aleatório separável a cada clique; o terceiro é o XOR, o assunto da próxima seção: veja os erros por época nunca chegarem a zero.
XOR: por que uma reta não basta
Etapa 2. O ou-exclusivo tem quatro pontos: \((0, 1)\) e \((1, 0)\) são \(+1\); \((0, 0)\) e \((1, 1)\) são \(-1\). Nenhuma reta põe as duas diagonais em lados diferentes. A álgebra é curta: uma reta separadora precisaria de
- \((0,0)\) negativo: \(b < 0\);
- \((0,1)\) e \((1,0)\) positivos: \(w_2 + b > 0\) e \(w_1 + b > 0\);
- \((1,1)\) negativo: \(w_1 + w_2 + b < 0\).
Somando as duas desigualdades do meio, \(w_1 + w_2 + 2b > 0\), logo \(w_1 + w_2 + b > -b > 0\), o que contradiz a última. O perceptron tenta mesmo assim:
X_xor = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
y_xor = np.array([-1, +1, +1, -1])

w, b, history = perceptron(X_xor, y_xor, epochs=8, trace=True)
print("mistakes per epoch:", [m for m, _, _ in history])
print("weights at the end of every epoch:", {f"w = ({w_e[0]:g}, {w_e[1]:g}), b = {b_e:g}" for _, w_e, b_e in history})
x = (0, 0)  y = -1  z = +0  y·z = +0  mistake -> w = (0, 0), b = -1
x = (0, 1)  y = +1  z = -1  y·z = -1  mistake -> w = (0, 1), b = 0
x = (1, 0)  y = +1  z = +0  y·z = +0  mistake -> w = (1, 1), b = 1
x = (1, 1)  y = -1  z = +3  y·z = -3  mistake -> w = (0, 0), b = 0
mistakes per epoch: [4, 4, 4, 4, 4, 4, 4, 4]
weights at the end of every epoch: {'w = (0, 0), b = 0'}
Toda visita é um erro e as quatro atualizações de uma época somam exatamente zero: \(\sum_i y_i x_i = -(0,0) + (0,1) + (1,0) - (1,1) = (0,0)\) e \(\sum_i y_i = 0\). Assim, depois de cada época os pesos voltam a \(w = (0, 0)\), \(b = 0\); as mesmas quatro atualizações se repetem para sempre. Com outro início ou outra ordem o caminho é diferente, mas nunca termina, porque nenhuma época pode ficar sem erros.
Foi essa a observação que Minsky e Papert tornaram famosa no livro Perceptrons (1969): um perceptron de uma camada não consegue calcular o XOR nem, de modo mais geral, qualquer função que dependa de uma combinação de atributos que nenhuma reta expressa. O livro foi lido como um veredito sobre as redes neurais como um todo. O financiamento migrou para outras áreas por mais de uma década, parte do que a introdução chama de primeiro inverno da IA.
A mesma parede barra a regressão logística, que também é um único neurônio. Medido num XOR ruidoso, 400 pontos espalhados em volta dos quatro cantos, com validação cruzada de 5 folds:
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score

rng = np.random.default_rng(0)
corners = rng.integers(0, 2, size=(400, 2))              # cada ponto começa num canto do quadrado
X_nx = corners + rng.normal(0, 0.2, size=(400, 2))       # e é borrado por ruído
y_nx = corners[:, 0] ^ corners[:, 1]                     # rótulo: XOR das coordenadas do canto
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)

print("class balance:", np.bincount(y_nx))
print(f"logistic regression, CV accuracy: {cross_val_score(LogisticRegression(), X_nx, y_nx, cv=cv).mean():.3f}")
p = LogisticRegression().fit(X_nx, y_nx).predict_proba(X_nx)[:, 1]
print(f"fitted on all 400 points, P(class 1) goes only from {p.min():.2f} to {p.max():.2f}")
class balance: [205 195]
logistic regression, CV accuracy: 0.485
fitted on all 400 points, P(class 1) goes only from 0.37 to 0.61
As classes estão equilibradas (205 e 195 pontos), então chutar acerta cerca de metade das vezes; a regressão logística não faz melhor (0,485). Uma reta poderia superar o acaso (cortar um canto acerta três dos quatro cantos), mas a log loss prefere ficar em cima do muro: ajustada nos 400 pontos, a probabilidade prevista da classe 1 fica entre 0,37 e 0,61 em todo lugar. Um neurônio não tem nada melhor a oferecer.
Uma camada oculta resolve o XOR
O caminho é parar de pedir a um neurônio que faça tudo. O XOR é "\(x_1\) OU \(x_2\), mas NÃO os dois" e cada uma dessas peças é linearmente separável. Então use dois neurônios para calcular as peças e um terceiro para combiná-las:
- o neurônio oculto \(h_1\) dispara quando \(x_1 + x_2 - 0{,}5 > 0\): é o OU;
- o neurônio oculto \(h_2\) dispara quando \(x_1 + x_2 - 1{,}5 > 0\): é o E;
- a saída dispara quando \(h_1 - h_2 - 0{,}5 > 0\): "OU e não E", que é o XOR.
Todos os pesos aqui foram escolhidos à mão. A tabela, para as quatro entradas:
step = lambda z: (z > 0).astype(int)

X4 = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
W1 = np.array([[1, 1],        # h1: x1 + x2 - 0.5 > 0  (OU)
               [1, 1]])       # h2: x1 + x2 - 1.5 > 0  (E)
b1 = np.array([-0.5, -1.5])
w2, b2 = np.array([1, -1]), -0.5                    # saída: h1 - h2 - 0.5 > 0

Z1 = X4 @ W1.T + b1                                 # pré-ativações ocultas, uma linha por entrada
H = step(Z1)                                        # ativações ocultas
z_out = H @ w2 + b2
print(pd.DataFrame({'x1': X4[:, 0], 'x2': X4[:, 1], 'z1': Z1[:, 0], 'h1 (OR)': H[:, 0],
                    'z2': Z1[:, 1], 'h2 (AND)': H[:, 1], 'z_out': z_out,
                    'output': step(z_out), 'XOR': X4[:, 0] ^ X4[:, 1]}).to_string(index=False))
 x1  x2   z1  h1 (OR)   z2  h2 (AND)  z_out  output  XOR
  0   0 -0.5        0 -1.5         0   -0.5       0    0
  0   1  0.5        1 -0.5         0    0.5       1    1
  1   0  0.5        1 -0.5         0    0.5       1    1
  1   1  1.5        1  0.5         1   -0.5       0    0
Confira a linha \((1, 1)\) com uma calculadora: \(z_1 = 1 + 1 - 0{,}5 = 1{,}5\), então \(h_1 = 1\); \(z_2 = 1 + 1 - 1{,}5 = 0{,}5\), então \(h_2 = 1\); \(z_{\text{out}} = 1 - 1 - 0{,}5 = -0{,}5\), então a saída é 0. A rede calcula o XOR exatamente.
O que aconteceu é mais fácil de ver do que de dizer (script da figura):
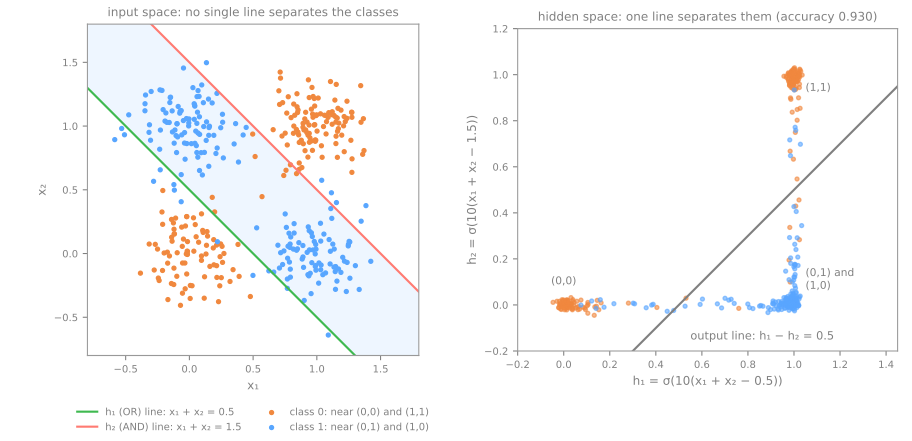
À esquerda, cada neurônio oculto traça uma reta no espaço de entrada e a classe 1 é a faixa entre as duas retas, algo que nenhuma reta sozinha descreve. À direita estão os mesmos dados vistos através da camada oculta, \((h_1, h_2)\) no lugar de \((x_1, x_2)\) (com a versão sigmoide da rede, logo abaixo, para que os pontos ruidosos não desabem todos em exatamente três cantos). Nesse novo espaço, \((0,0)\) fica em \((0,0)\), \((1,1)\) vai para \((1,1)\) e os dois cantos da classe 1 caem em \((1, 0)\). Agora uma reta separa as classes e o neurônio de saída só precisa traçá-la.
Essa é a ideia central da aula: a camada oculta calcula atributos novos, nos quais o problema fica linearmente separável; a camada de saída é um classificador linear sobre esses atributos. Você já fez isso à mão, acrescentando colunas \(x^2\) como atributos polinomiais ou deixando o kernel da SVM fazê-lo implicitamente. Uma rede aprende esses atributos a partir dos dados, por gradiente descendente.
Há um obstáculo. O gradiente descendente precisa de derivadas, mas a função degrau tem derivada 0 em todo lugar (e nenhuma em 0): uma mudança pequena num peso nunca muda a saída, então o gradiente não diz nada. A solução é trocar o degrau por uma função suave com a mesma forma. Com a sigmoide e todos os pesos multiplicados por 10, a mesma rede devolve probabilidades:
sigmoid = lambda z: 1 / (1 + np.exp(-z))

H_soft = sigmoid(10 * (X4 @ W1.T + b1))
p = sigmoid(10 * (H_soft @ w2 + b2))
print(pd.DataFrame({'x1': X4[:, 0], 'x2': X4[:, 1], 'h1': H_soft[:, 0].round(3),
                    'h2': H_soft[:, 1].round(3), 'P(XOR = 1)': p.round(3)}).to_string(index=False))
 x1  x2    h1    h2  P(XOR = 1)
  0   0 0.007 0.000       0.007
  0   1 0.993 0.007       0.992
  1   0 0.993 0.007       0.992
  1   1 1.000 0.993       0.007
As duas entradas da classe 0 recebem probabilidade 0,007 e as duas da classe 1 recebem 0,992: a mesma rede, agora diferenciável. Multiplicar os pesos por 10 deixa cada sigmoide íngreme, perto de um degrau; pesos menores dariam probabilidades mais suaves. É esse tipo de rede que um treino baseado em gradiente consegue encontrar sozinho a partir de pesos aleatórios; é o que o MLPClassifier faz nas próximas seções.
Funções de ativação
Sigmoide, tanh e ReLU
Três ativações cobrem quase toda a prática:
| ativação | \(\varphi(z)\) | imagem | derivada \(\varphi'(z)\) | maior derivada |
|---|---|---|---|---|
| sigmoide | \(1 / (1 + e^{-z})\) | \((0, 1)\) | \(\varphi(z)\,(1 - \varphi(z))\) | 0,25, em \(z = 0\) |
| tanh | \((e^{z} - e^{-z}) / (e^{z} + e^{-z})\) | \((-1, 1)\) | \(1 - \varphi(z)^2\) | 1, em \(z = 0\) |
| ReLU | \(\max(0, z)\) | \([0, \infty)\) | 0 se \(z < 0\), 1 se \(z > 0\) | 1, para todo \(z > 0\) |
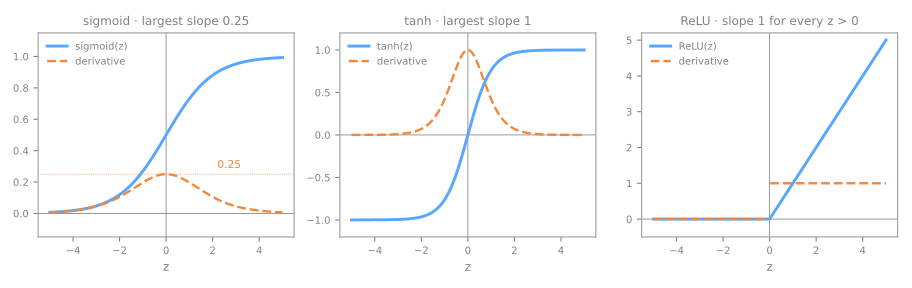
A coluna da derivada é a que importa para o treino, porque a retropropagação (abaixo) multiplica uma derivada de ativação por camada. Com sigmoides, cada camada multiplica o gradiente por no máximo 0,25; ao longo de 10 camadas, isso dá no máximo \(0{,}25^{10} \approx 10^{-6}\) e as primeiras camadas quase não aprendem. Esse gradiente que desaparece (vanishing gradient) é o motivo de a ReLU (Nair & Hinton, 2010; Glorot, Bordes & Bengio, 2011) ter virado o padrão nas camadas ocultas: sua inclinação é exatamente 1 onde o neurônio está ativo. É também o padrão do scikit-learn (activation='relu'). A sigmoide continua sendo a escolha natural para a saída de um classificador binário, porque produz uma probabilidade, exatamente como na regressão logística; para \(k\) classes a saída é uma softmax.
Sem não linearidade, as camadas colapsam
Por que não dispensar a ativação e empilhar camadas lineares puras? Porque uma função linear de uma função linear é linear. Duas camadas \(W_2 (W_1 x + b_1) + b_2\) equivalem a uma camada com pesos \(W_2 W_1\) e viés \(W_2 b_1 + b_2\). Numericamente, com pesos aleatórios (3 unidades ocultas):
rng = np.random.default_rng(0)
W1r, b1r = rng.normal(size=(3, 2)), rng.normal(size=3)       # camada 1: 2 entradas -> 3 unidades
W2r, b2r = rng.normal(size=(1, 3)), rng.normal(size=1)       # camada 2: 3 unidades -> 1 saída
x_new = np.array([1.0, -2.0])

two_linear_layers = W2r @ (W1r @ x_new + b1r) + b2r
W_merged, b_merged = W2r @ W1r, W2r @ b1r + b2r
print("two linear layers:", two_linear_layers.round(4))
print("one merged layer: ", (W_merged @ x_new + b_merged).round(4), "with W =", W_merged.round(3))
print("with a ReLU between them:", (W2r @ np.maximum(0, W1r @ x_new + b1r) + b2r).round(4))
two linear layers: [-5.4084]
one merged layer:  [-5.4084] with W = [[-0.58   0.117]]
with a ReLU between them: [-5.3273]
As duas camadas lineares e a camada única fundida imprimem o mesmo número (−5,4084) e imprimiriam o mesmo para qualquer entrada: as três unidades ocultas não acrescentaram nada; a rede 2 → 3 → 1 inteira é o modelo linear \(-0{,}58\,x_1 + 0{,}117\,x_2 + b\). Ponha uma ReLU entre as camadas e a saída muda (−5,3273 aqui), porque a rede não pode mais ser reescrita como uma única matriz.
O mesmo, medido no XOR ruidoso: um MLPClassifier com 8 unidades ocultas e activation='identity' (sem não linearidade) contra a mesma rede com ReLU, nos mesmos folds da regressão logística:
from sklearn.neural_network import MLPClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

for act in ['identity', 'relu']:
    net = make_pipeline(StandardScaler(),
                        MLPClassifier(hidden_layer_sizes=(8,), activation=act, max_iter=2000, random_state=0))
    print(f"8 hidden units, activation={act:8s}: CV accuracy {cross_val_score(net, X_nx, y_nx, cv=cv).mean():.3f}")
8 hidden units, activation=identity: CV accuracy 0.510
8 hidden units, activation=relu    : CV accuracy 0.983
Sem ativação, a rede de 8 unidades é um modelo linear disfarçado e marca 0,510, o mesmo nível de acaso da regressão logística (0,485). Com ReLU chega a 0,983. As unidades, o solver e os dados são idênticos; só a não linearidade mudou.
A passagem direta como produtos de matrizes
Uma camada é um produto de matrizes
Etapa 3. Escreva os pesos de uma camada como uma matriz, uma linha por neurônio. Para a rede 2-2-1 abaixo:
Para um lote inteiro de \(n\) linhas de uma vez, empilhe as entradas como linhas de \(X\) e a mesma conta vira \(H = \sigma(X W^\top + b^h)\): um produto de matrizes e uma função elemento a elemento por camada. Essa é a passagem direta (forward pass). É por isso que as redes neurais rodam tão bem em GPUs, que são máquinas de multiplicar matrizes.
Uma rede 2-2-1, à mão
A rede abaixo é a usada no curso de Deep Learning e no simulador do fim desta página: duas entradas, duas unidades ocultas sigmoides, uma saída sigmoide, um exemplo de treino \(x = (0{,}5;\ 0{,}8)\) com alvo \(y = 0\) e estes pesos iniciais:
| de → para | peso | de → para | peso |
|---|---|---|---|
| \(x_1 \to h_1\) | \(w_{11} = 0{,}2\) | \(h_1 \to \hat y\) | \(v_{11} = 0{,}3\) |
| \(x_2 \to h_1\) | \(w_{12} = 0{,}4\) | \(h_2 \to \hat y\) | \(v_{12} = 0{,}5\) |
| \(x_1 \to h_2\) | \(w_{21} = 0{,}6\) | viés \(\to \hat y\) | \(b^{y}_1 = 0{,}4\) |
| \(x_2 \to h_2\) | \(w_{22} = 0{,}8\) | ||
| viés \(\to h_1\) | \(b^{h}_1 = 0{,}1\) | ||
| viés \(\to h_2\) | \(b^{h}_2 = 0{,}2\) |
À mão: \(z_1 = 0{,}2 \cdot 0{,}5 + 0{,}4 \cdot 0{,}8 + 0{,}1 = 0{,}52\) e \(z_2 = 0{,}6 \cdot 0{,}5 + 0{,}8 \cdot 0{,}8 + 0{,}2 = 1{,}14\); \(h_1 = \sigma(0{,}52)\) e \(h_2 = \sigma(1{,}14)\); depois \(u = 0{,}3 h_1 + 0{,}5 h_2 + 0{,}4\) e \(\hat y = \sigma(u)\). Para manter os números idênticos aos do curso de Deep Learning, este exemplo mede o erro com a perda quadrática \(L = (\hat y - y)^2\):
x = np.array([0.5, 0.8])
y_true = 0.0
W = np.array([[0.2, 0.4],       # linha i = os pesos que entram na unidade oculta h_i
              [0.6, 0.8]])
b_h = np.array([0.1, 0.2])
v = np.array([0.3, 0.5])        # pesos que entram na saída
b_y = 0.4

z = W @ x + b_h                 # pré-ativações ocultas
h = sigmoid(z)                  # ativações ocultas
u = v @ h + b_y                 # pré-ativação da saída
y_hat = sigmoid(u)              # saída
L = (y_hat - y_true) ** 2       # perda quadrática
print("z =", z.round(3), " h =", h.round(3))
print(f"u = {u:.3f}  y_hat = {y_hat:.3f}  L = {L:.4f}")
As pré-ativações ocultas são \(z = (0{,}52;\ 1{,}14)\), as ativações ocultas \(h = (0{,}627;\ 0{,}758)\), a pré-ativação da saída \(u = 0{,}3 \cdot 0{,}627 + 0{,}5 \cdot 0{,}758 + 0{,}4 = 0{,}967\) e a previsão \(\hat y = \sigma(0{,}967) = 0{,}725\). O alvo é 0, então a rede erra bastante: \(L = 0{,}725^2 = 0{,}5249\).
O scikit-learn calcula a mesma coisa. Carregue esses pesos num MLPClassifier com unidades ocultas sigmoides (activation='logistic'); o atributo coefs_ guarda uma matriz por camada, no formato (entradas × unidades), a transposta do nosso \(W\):
import warnings
from sklearn.exceptions import ConvergenceWarning

warnings.filterwarnings('ignore', category=ConvergenceWarning)
net = MLPClassifier(hidden_layer_sizes=(2,), activation='logistic', max_iter=1).fit([[0, 0], [1, 1]], [0, 1])
net.coefs_ = [W.T, v.reshape(2, 1)]              # nossos pesos substituem os iniciais
net.intercepts_ = [b_h, np.array([b_y])]
print("scikit-learn P(y = 1 | x) =", net.predict_proba([x])[0, 1].round(4))
Contando parâmetros
Uma camada com \(n_\text{ent}\) entradas e \(n_\text{sai}\) unidades tem \(n_\text{ent} \cdot n_\text{sai}\) pesos e \(n_\text{sai}\) vieses, \((n_\text{ent} + 1) \cdot n_\text{sai}\) parâmetros ao todo. Para imagens de dígitos de 8 × 8 (64 pixels, 10 classes):
def n_params(sizes):
    return sum((n_in + 1) * n_out for n_in, n_out in zip(sizes[:-1], sizes[1:]))


for sizes in [(2, 2, 1), (64, 10), (64, 32, 10), (64, 256, 10), (64, 64, 64, 10)]:
    print(f"{' -> '.join(map(str, sizes)):22s} {n_params(sizes):6,d} parameters")
2 -> 2 -> 1                 9 parameters
64 -> 10                  650 parameters
64 -> 32 -> 10          2,410 parameters
64 -> 256 -> 10        19,210 parameters
64 -> 64 -> 64 -> 10    8,970 parameters
A rede 2-2-1 tem 9 parâmetros (6 na primeira camada, 3 na segunda): os da tabela acima. A regressão softmax sobre 64 pixels tem \(65 \cdot 10 = 650\). Uma camada oculta de 32 unidades leva a conta a \(65 \cdot 32 + 33 \cdot 10 = 2.410\); com 256 unidades, são 19.210, mais parâmetros do que imagens em todo o conjunto de dígitos (1.797). Duas camadas ocultas de 64 unidades têm menos parâmetros (8.970) do que uma de 256: a conta cresce com o produto das larguras vizinhas. Com tantos parâmetros por exemplo, a regularização (abaixo) não é opcional.
Treino: retropropagação
A perda e a regra da cadeia
Etapa 4. Treinar é escolher todos os pesos para minimizar uma perda no conjunto de treino. O MLPClassifier do scikit-learn minimiza a mesma entropia cruzada da regressão logística, mais uma penalidade L2 nos pesos, \(\tfrac{\alpha}{2} \lVert W \rVert^2\), a mesma penalidade do Ridge; na literatura de redes neurais ela se chama weight decay (decaimento de pesos) e, no scikit-learn, corresponde ao parâmetro alpha. O gradiente descendente precisa de \(\partial L / \partial w\) para todo peso \(w\). Os pesos da camada de saída são fáceis, mas um peso da primeira camada só influencia a perda através de tudo o que vem depois dele:
A regra da cadeia multiplica as derivadas locais ao longo desse caminho. A retropropagação (Rumelhart, Hinton & Williams, 1986) é a regra da cadeia organizada para que nada seja calculado duas vezes: comece pela perda, calcule a derivada em relação à pré-ativação de cada camada (o delta dela, \(\delta\)) e passe-a para trás, uma camada de cada vez. O gradiente de cada peso é então "o delta da unidade que ele alimenta × o valor que entrou por ele".
Para a rede 2-2-1, com a perda quadrática, os seis passos são:
- gradiente da perda: \(\partial L / \partial \hat y = 2(\hat y - y)\);
- delta da saída: \(\delta_y = \partial L / \partial u = 2(\hat y - y) \cdot \hat y (1 - \hat y)\), porque \(\sigma'(u) = \hat y(1 - \hat y)\);
- pesos da saída: \(\partial L / \partial v_{1j} = \delta_y \, h_j\) e \(\partial L / \partial b^y_1 = \delta_y\);
- deltas ocultos: \(\delta_{h_j} = \delta_y \, v_{1j} \cdot h_j (1 - h_j)\), o delta da saída mandado de volta pelo peso \(v_{1j}\), vezes a inclinação local da sigmoide;
- pesos ocultos: \(\partial L / \partial w_{jk} = \delta_{h_j} \, x_k\) e \(\partial L / \partial b^h_j = \delta_{h_j}\);
- atualizar todos os parâmetros: \(p \leftarrow p - \eta \, \partial L / \partial p\).
Os seis passos, com números
dL_dyhat = 2 * (y_hat - y_true)                  # 1. gradiente da perda
delta_y = dL_dyhat * y_hat * (1 - y_hat)         # 2. delta da saída, dL/du
grad_v = delta_y * h                             # 3. pesos da saída
grad_b_y = delta_y
delta_h = delta_y * v * h * (1 - h)              # 4. deltas ocultos, dL/dz
grad_W = np.outer(delta_h, x)                    # 5. pesos ocultos: delta da unidade × sua entrada
grad_b_h = delta_h

print(f"1. dL/dy_hat = 2({y_hat:.3f} - {y_true:.0f}) = {dL_dyhat:.3f}")
print(f"2. delta_y   = {dL_dyhat:.3f} · {y_hat:.3f}(1 - {y_hat:.3f}) = {delta_y:.4f}")
print(f"3. dL/dv     = {grad_v.round(4)}   dL/db_y = {grad_b_y:.4f}")
print(f"4. delta_h   = {delta_h.round(4)}")
print(f"5. dL/dW     = {grad_W.round(4).tolist()}   dL/db_h = {grad_b_h.round(4)}")
1. dL/dy_hat = 2(0.725 - 0) = 1.449
2. delta_y   = 1.449 · 0.725(1 - 0.725) = 0.2892
3. dL/dv     = [0.1814 0.2191]   dL/db_y = 0.2892
4. delta_h   = [0.0203 0.0266]
5. dL/dW     = [[0.0101, 0.0162], [0.0133, 0.0212]]   dL/db_h = [0.0203 0.0266]
Leia os números de cima para baixo:
- o gradiente da perda, 1,449: se \(\hat y\) sobe um pouco, a perda sobe cerca de 1,449 vezes isso, então o treino precisa empurrar \(\hat y\) para baixo, em direção ao alvo 0;
- o delta da saída, 0,289: a inclinação da sigmoide na saída é \(0{,}725 \times 0{,}275 = 0{,}199\) e \(1{,}449 \times 0{,}199 = 0{,}289\);
- os pesos da saída: \(0{,}289 \times h\) dá 0,181 para \(v_{11}\) e 0,219 para \(v_{12}\), maior porque \(h_2 = 0{,}758\) contribuiu mais para a saída;
- os deltas ocultos, 0,0203 e 0,0266: cerca de dez vezes menores que o delta da saída, porque no caminho de volta cada um foi multiplicado por um peso menor que 1 (0,3 e 0,5) e por uma inclinação de sigmoide menor que 0,25 (\(0{,}627 \times 0{,}373 = 0{,}234\) para \(h_1\));
- os gradientes da primeira camada, os deltas ocultos vezes as entradas 0,5 e 0,8, vão de 0,0101 a 0,0212: os menores de todos. É o gradiente que desaparece da seção de ativações, em miniatura.
Isso é mesmo a derivada? Confira pelo caminho lento: empurre cada um dos 9 parâmetros em \(\pm 10^{-6}\), recalcule a perda e tome o quociente de diferenças (uma checagem por diferenças finitas):
def loss(params):
    W_, b_h_, v_, b_y_ = params[:4].reshape(2, 2), params[4:6], params[6:8], params[8]
    return (sigmoid(v_ @ sigmoid(W_ @ x + b_h_) + b_y_) - y_true) ** 2


params = np.r_[W.ravel(), b_h, v, b_y]           # os 9 parâmetros num só vetor
backprop = np.r_[grad_W.ravel(), grad_b_h, grad_v, grad_b_y]
eps = 1e-6
numeric = np.array([(loss(params + eps * e) - loss(params - eps * e)) / (2 * eps) for e in np.eye(9)])
print("largest difference, backprop vs finite differences:", f"{np.abs(numeric - backprop).max():.1e}")

eta = 0.5                                        # 6. um passo de gradiente nos 9 parâmetros
new_params = params - eta * backprop
print(f"loss before: {loss(params):.4f} · after one step with eta = {eta}: {loss(new_params):.4f}")
largest difference, backprop vs finite differences: 1.3e-10
loss before: 0.5249 · after one step with eta = 0.5: 0.4405
A retropropagação e as diferenças finitas concordam até \(10^{-10}\), o erro de arredondamento dos quocientes: a retropropagação não é uma aproximação, é a derivada exata, calculada de forma eficiente. Um passo de gradiente com \(\eta = 0{,}5\) nos 9 parâmetros baixa a perda deste exemplo de 0,5249 para 0,4405.
A checagem por diferenças finitas precisou de 18 passagens diretas extras para 9 parâmetros; a retropropagação obteve os 9 gradientes com uma única passagem de volta, que custa mais ou menos o mesmo que a passagem direta. Para os 2.410 parâmetros de uma rede de dígitos 64-32-10, é uma passagem de volta em vez de 4.820 passagens diretas; para as redes modernas, com bilhões de parâmetros, essa razão é o que torna o treino possível.
Uma observação que liga de volta à regressão logística: com a perda de entropia cruzada no lugar da quadrática, os passos 1 e 2 se fundem num só, \(\delta_y = \hat y - y\) (aqui \(0{,}725\)), o mesmo "previsão menos alvo" do gradiente da regressão logística. Do passo 3 em diante nada muda.
Não convexo: o ponto de partida importa
Na regressão logística a perda é convexa: um só mínimo, alcançado de qualquer ponto de partida. Compor camadas quebra isso. A mesma rede de 2 unidades ocultas que resolve o XOR à mão, treinada a partir de 10 inicializações aleatórias (o random_state), no XOR ruidoso:
for units in [2, 8]:
    accs = [make_pipeline(StandardScaler(), MLPClassifier(hidden_layer_sizes=(units,), max_iter=5000,
                                                          random_state=seed)).fit(X_nx, y_nx).score(X_nx, y_nx)
            for seed in range(10)]
    print(f"{units} hidden units, training accuracy for seeds 0-9:", np.round(accs, 2))
2 hidden units, training accuracy for seeds 0-9: [0.76 0.66 0.74 0.94 0.94 0.94 0.94 0.94 0.74 0.66]
8 hidden units, training accuracy for seeds 0-9: [0.98 0.98 0.97 0.98 0.98 0.96 0.99 0.99 0.97 0.95]
Com 2 unidades ocultas, 5 dos 10 inícios chegam a 0,94 de acurácia de treino, quase tão bom quanto a rede feita à mão (0,930 nesses mesmos pontos, calculado no script da figura acima). Os outros 5 param entre 0,66 e 0,76, presos num mínimo local pior. Com 8 unidades, todo início termina entre 0,95 e 0,99: unidades extras dão ao gradiente descendente mais caminhos até uma boa solução, um dos motivos de as redes usadas na prática serem mais largas do que o mínimo que funcionaria. No scikit-learn o início é definido pelo random_state: fixe-o para ter reprodutibilidade e, quando uma conclusão importar, confira que ela vale para algumas sementes.
Otimizadores e regularização
O MLPClassifier oferece três solvers. 'adam' (o padrão; Kingma & Ba, 2015) é o gradiente descendente em mini-batch (lotes de 200 linhas) com momento e um tamanho de passo por parâmetro; é a escolha habitual para conjuntos grandes. 'sgd' é o gradiente descendente em mini-batch puro, com momento opcional. 'lbfgs' usa o conjunto de treino inteiro a cada passo e uma aproximação da curvatura; em conjuntos pequenos (alguns milhares de linhas) costuma convergir mais rápido e melhor.
Regularização, no vocabulário que você já tem:
alpha, o weight decay: a penalidade L2 do Ridge, em todos os pesos de todas as camadas;early_stopping=True: separa 10% das linhas de treino, acompanha a acurácia nelas depois de cada época e para quando ela não melhora por 10 épocas (n_iter_no_change), a mesma ideia da parada antecipada no gradient boosting;- nas bibliotecas de deep learning existe também o dropout (Srivastava et al., 2014), que desliga um subconjunto aleatório de unidades a cada passo, para que nenhuma unidade dependa de outra específica; o scikit-learn não o implementa.
Treino na prática com o scikit-learn
Escalone as entradas
Etapa 5. O gradiente descendente numa rede sofre com atributos em escalas diferentes exatamente como sofria nos modelos lineares: a superfície de perda vira um vale longo e estreito, onde uma única taxa de aprendizado não serve para todas as direções. No conjunto spambase (4.601 e-mails, 57 atributos numéricos: frequências de palavras e de caracteres, além de comprimentos de sequências de letras maiúsculas que chegam aos milhares):
from sklearn.datasets import fetch_openml

spam = fetch_openml(data_id=44, as_frame=True)                 # spambase (UCI)
X_sp, y_sp = spam.data, (spam.target == '1').astype(int)       # 1 = spam
print(X_sp.shape, f"spam share {y_sp.mean():.3f}",
      f"· feature std from {X_sp.std().min():.3f} to {X_sp.std().max():.0f}")

for name, model in [('raw inputs', MLPClassifier(max_iter=1000, random_state=0)),
                    ('StandardScaler first', make_pipeline(StandardScaler(),
                                                           MLPClassifier(max_iter=1000, random_state=0)))]:
    print(f"MLP, {name:20s}: CV accuracy {cross_val_score(model, X_sp, y_sp, cv=cv).mean():.3f}")
(4601, 57) spam share 0.394 · feature std from 0.076 to 606
MLP, raw inputs          : CV accuracy 0.927
MLP, StandardScaler first: CV accuracy 0.948
Os desvios padrão dos atributos vão de 0,076 a 606. Com as entradas cruas, o MLP chega a 0,927 de acurácia na validação cruzada; com um StandardScaler na frente, 0,948: dois pontos a mais com uma linha de pré-processamento. O escalonador vai dentro do pipeline, para que cada fold o ajuste nas próprias linhas de treino, como na aula de pipelines. (O Spambase tem 394 e-mails duplicados exatos, mantidos aqui; a aula de árvores de decisão explica por que descartá-los dá escores um pouco menores e mais honestos.)
Largura: quantas unidades ocultas?
hidden_layer_sizes=(h,) define uma camada oculta de \(h\) unidades; (h1, h2) define duas camadas. Mais unidades significam mais peças para a rede combinar, portanto uma fronteira mais flexível. Em 300 pontos de duas meias-luas ruidosas, com o solver 'lbfgs' e quase nenhum weight decay (alpha=1e-4):
from sklearn.datasets import make_moons
from sklearn.model_selection import cross_validate

X_m, y_m = make_moons(n_samples=300, noise=0.3, random_state=1)


def train_and_cv(units, alpha):
    net = make_pipeline(StandardScaler(), MLPClassifier(hidden_layer_sizes=(units,), solver='lbfgs',
                                                        alpha=alpha, max_iter=5000, random_state=0))
    r = cross_validate(net, X_m, y_m, cv=cv, return_train_score=True)
    return f"train {r['train_score'].mean():.3f} · CV {r['test_score'].mean():.3f}"


print(f"logistic regression:  CV {cross_val_score(LogisticRegression(), X_m, y_m, cv=cv).mean():.3f}")
for units in [1, 3, 10, 100]:
    print(f"{units:3d} hidden units: ", train_and_cv(units, alpha=1e-4))
logistic regression:  CV 0.830
  1 hidden units:  train 0.842 · CV 0.843
  3 hidden units:  train 0.897 · CV 0.873
 10 hidden units:  train 0.938 · CV 0.893
100 hidden units:  train 0.997 · CV 0.857
Com 1 unidade oculta, a rede não é melhor que a regressão logística (0,843 contra 0,830 na validação cruzada): uma unidade traça uma reta. Com 3 e 10 unidades a fronteira se curva e a acurácia sobe para 0,873 e 0,893. Com 100 unidades, a rede ajusta os folds de treino quase perfeitamente (0,997) enquanto a acurácia de validação cai de volta para 0,857: agora ela tem unidades suficientes para contornar pontos ruidosos individuais, o mesmo sobreajuste que você viu com árvores de decisão profundas e graus polinomiais altos.
Weight decay: alpha
Mantenha as 100 unidades e aumente alpha:
for alpha in [1e-4, 0.01, 0.1, 1, 10]:
    print(f"100 units, alpha = {alpha:<6g}:", train_and_cv(100, alpha))
100 units, alpha = 0.0001: train 0.997 · CV 0.857
100 units, alpha = 0.01  : train 0.993 · CV 0.880
100 units, alpha = 0.1   : train 0.939 · CV 0.903
100 units, alpha = 1     : train 0.914 · CV 0.917
100 units, alpha = 10    : train 0.837 · CV 0.830
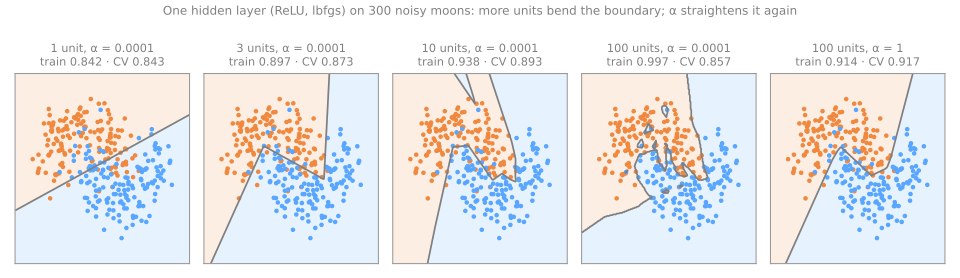
A tabela e a figura contam de novo a história do Ridge. Quase sem penalidade, as 100 unidades sobreajustam (treino 0,997, validação 0,857). Aumentar alpha encolhe os pesos, a fronteira se suaviza e a distância entre treino e validação se fecha: com alpha = 1, o treino fica em 0,914 e a validação em 0,917, a melhor configuração da página e melhor que 10 unidades sem penalidade (0,893). Penalidade demais achata a rede de volta numa reta: alpha = 10 dá 0,830, a marca da regressão logística. Repare também na forma das fronteiras: com unidades ReLU elas são feitas de segmentos retos, com uma dobra onde uma unidade liga ou desliga, o que se vê bem nos painéis de 3 e 10 unidades.
A receita prática, então, é a de todo modelo deste curso: escolha uma arquitetura generosa e ajuste alpha (e a largura) com validação cruzada. O lab faz exatamente isso.
Por que profundidade e quando usar uma rede neural
Profundidade
Uma camada oculta já é um aproximador universal: com unidades suficientes, ela aproxima qualquer função contínua numa região limitada tão bem quanto se queira (Cybenko, 1989; Hornik, 1991). O teorema garante existência, não que o treino encontre os pesos nem que o número de unidades seja razoável. Na prática, redes profundas (muitas camadas) chegam à mesma acurácia com muito menos unidades, porque cada camada constrói sobre os atributos da anterior: em imagens, as primeiras camadas de uma rede convolucional respondem a bordas, as seguintes a texturas e partes, as últimas a objetos inteiros. Essa hierarquia é o motivo de o deep learning ter tomado os problemas de percepção (imagens, áudio, texto) a partir de 2012, quando dados e GPUs ficaram abundantes (AlexNet).
Dados tabulares: uma comparação honesta
Numa tabela de colunas heterogêneas, a história é outra. Mesmos folds, mesmos dados do spambase, quatro modelos:
from sklearn.ensemble import HistGradientBoostingClassifier

candidates = {
    'logistic': make_pipeline(StandardScaler(), LogisticRegression(max_iter=5000)),
    'MLP': make_pipeline(StandardScaler(), MLPClassifier(max_iter=1000, random_state=0)),
    'MLP early stop': make_pipeline(StandardScaler(),
                                    MLPClassifier(max_iter=1000, early_stopping=True, random_state=0)),
    'boosting': HistGradientBoostingClassifier(random_state=0),
}
folds = pd.DataFrame({name: cross_val_score(m, X_sp, y_sp, cv=cv) for name, m in candidates.items()})
print(pd.concat([folds, folds.agg(['mean', 'std'])]).round(3).to_string())
print("boosting - MLP, per fold:", (folds['boosting'] - folds['MLP']).round(3).tolist())
      logistic    MLP  MLP early stop  boosting
0        0.921  0.951           0.946     0.954
1        0.928  0.953           0.950     0.955
2        0.926  0.946           0.937     0.966
3        0.934  0.949           0.942     0.965
4        0.913  0.941           0.935     0.939
mean     0.924  0.948           0.942     0.956
std      0.008  0.005           0.006     0.011
boosting - MLP, per fold: [0.003, 0.002, 0.021, 0.016, -0.002]
Nesta tabela a ordem é: gradient boosting 0,956 ± 0,011, MLP 0,948 ± 0,005, MLP com parada antecipada 0,942 ± 0,006, regressão logística 0,924 ± 0,008. O boosting vence o MLP em 4 dos 5 folds, mas por pouco (de −0,002 a 0,021): uma vantagem, não um nocaute. E ele chegou lá com os padrões e sem pré-processamento, enquanto a rede precisou de um escalonador, de uma escolha de arquitetura, de alpha e de solver. Além disso, a parada antecipada não trouxe ganho nenhum aqui.
Isso bate com benchmarks grandes: em conjuntos tabulares típicos, os ensembles de árvores continuam tão bons quanto as redes neurais ou melhores, com menos ajuste e menos computação (Shwartz-Ziv & Armon, 2022; Grinsztajn, Oyallon & Varoquaux, 2022). Árvores dividem por um atributo de cada vez, então não ligam para escala, ignoram colunas inúteis com facilidade e lidam com relações irregulares, em degraus, entre um atributo e o alvo; uma rede precisa aprender tudo isso a partir de funções suaves. Em imagens a balança se inverte, como o lab mostra com pixels.
| dados | primeira escolha |
|---|---|
| tabelas de colunas heterogêneas | gradient boosting ou uma random forest |
| imagens, áudio, vídeo | redes convolucionais, vision transformers |
| texto | transformers ou embeddings + um modelo linear |
| poucas linhas | modelos lineares, k-NN, SVM |
Para onde ir: o curso de Deep Learning
Esta aula para no perceptron multicamadas. O curso complementar Artificial Neural Networks and Deep Learning continua exatamente daqui: a aula de MLP deduz a retropropagação na forma matricial; depois, o curso segue para o treino de redes profundas (inicialização, normalização, dropout), redes convolucionais e recorrentes, transformers e modelos generativos, em PyTorch no lugar do scikit-learn.
Retropropagação, passo a passo: o simulador
O simulador refaz a conta da seção de retropropagação na mesma rede 2-2-1. O passo 1 é a passagem direta, com cada valor guardado no seu nó; os passos 2 a 6 mandam o gradiente para trás, da perda até a primeira camada, um elo da regra da cadeia de cada vez; o passo 7 aplica a atualização com \(\eta = 0{,}5\). Os números são os que o código daquela seção imprime. Use Avançar e Voltar, os pontos ou as setas do teclado.
Lab: uma rede neural em dígitos manuscritos
O problema. O conjunto digits, que vem com o scikit-learn, tem 1.797 dígitos manuscritos, digitalizados e reduzidos a imagens de 8 × 8 com 17 níveis de cinza (0 a 16), da coleção "Optical Recognition of Handwritten Digits" da UCI. Cada imagem vira uma linha de 64 valores de pixel; a tarefa é dizer qual é o dígito. Pixels não são uma tabela de colunas heterogêneas: toda coluna é o mesmo tipo de medida e o que importa é como pixels vizinhos se combinam, o tipo de estrutura que uma camada oculta consegue aprender.
O fluxo é o da aula de validação: trancar um conjunto de teste, comparar modelos nos mesmos folds de validação cruzada, ajustar com GridSearchCV e tocar o teste uma única vez. Toda saída abaixo é o que o código imprime. Para rodar você mesmo, baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook); ele roda em cerca de um minuto.
Passo 1 — carregar e olhar
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)          # 1.797 imagens de 8 × 8 pixels, uma linha de 64 valores cada
print(X.shape, "· pixel values from", X.min(), "to", X.max())
print("images per digit:", np.bincount(y))

fig, axes = plt.subplots(1, 10, figsize=(10, 1.4))
for digit, ax in enumerate(axes):
    ax.imshow(X[y == digit][0].reshape(8, 8), cmap='gray_r')
    ax.set_title(digit)
    ax.axis('off')
plt.show()
(1797, 64) · pixel values from 0.0 to 16.0
images per digit: [178 182 177 183 181 182 181 179 174 180]
São 1.797 imagens, 64 colunas de pixels com valores de 0 a 16 e entre 174 e 183 imagens por dígito: as classes estão equilibradas, então a acurácia é um bom resumo. A fileira de miniaturas mostra como 8 × 8 pixels são grosseiros. Todas as colunas estão na mesma unidade, mas a rede é treinada por gradiente descendente, então ganha um StandardScaler no pipeline mesmo assim.
Passo 2 — trancar o conjunto de teste
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42)
print(X_train.shape, X_test.shape)
São 1.347 imagens para desenvolvimento e 450 trancadas até o passo 8, as duas partes com a mesma proporção de cada dígito graças ao stratify=y. No teste, cada imagem vale 0,22 ponto de acurácia (1/450).
Passo 3 — uma baseline e os folds que todos compartilham
from sklearn.dummy import DummyClassifier
from sklearn.model_selection import StratifiedKFold, cross_val_score

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)


def cv_summary(model):
    scores = cross_val_score(model, X_train, y_train, cv=cv)
    return f"{scores.mean():.3f} ± {scores.std():.3f}"


print("always the most frequent digit:", cv_summary(DummyClassifier(strategy='most_frequent')))
Responder sempre o dígito mais frequente acerta 10,0% das vezes, sem variação entre folds porque a estratificação dá a todo fold as mesmas proporções de classe. Toda acurácia daqui em diante deve ser lida contra 0,100. O objeto cv é criado uma vez e reusado em todos os passos, então todos os modelos são avaliados nos mesmos cinco folds. A função cv_summary informa a média ± o desvio padrão entre eles.
Passo 4 — três modelos nos mesmos folds
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.neural_network import MLPClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

models = {
    'logistic regression': make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)),
    'random forest, 300 trees': RandomForestClassifier(n_estimators=300, random_state=42, n_jobs=-1),
    'MLP, defaults (100 units)': make_pipeline(StandardScaler(), MLPClassifier(max_iter=1000, random_state=42)),
}
for name, model in models.items():
    print(f"{name:26s} {cv_summary(model)}")
logistic regression        0.966 ± 0.010
random forest, 300 trees   0.976 ± 0.009
MLP, defaults (100 units)  0.974 ± 0.010
Os três ficam muito acima da baseline de 0,100. A regressão logística, um modelo linear sobre os pixels crus, já chega a 0,966; a random forest, a 0,976; o MLP com os padrões do scikit-learn (uma camada oculta de 100 unidades ReLU, alpha = 0.0001, o solver Adam), a 0,974. Esse MLP tem \((64 + 1) \cdot 100 + (100 + 1) \cdot 10 = 7.510\) parâmetros. As diferenças entre os três (0,002 a 0,010) são do tamanho de um desvio padrão entre folds (0,009 a 0,010), então nada está decidido ainda.
Passo 5 — ajustar a largura e o alpha
from sklearn.model_selection import GridSearchCV

mlp = make_pipeline(StandardScaler(), MLPClassifier(max_iter=1000, random_state=42))
param_grid = {'mlpclassifier__hidden_layer_sizes': [(16,), (64,), (256,), (64, 64)],
              'mlpclassifier__alpha': [0.0001, 1, 10]}
grid = GridSearchCV(mlp, param_grid, cv=cv, n_jobs=-1).fit(X_train, y_train)

res = pd.DataFrame(grid.cv_results_)
res['layers'] = res['param_mlpclassifier__hidden_layer_sizes'].astype(str)
table = res.pivot(index='layers', columns='param_mlpclassifier__alpha', values='mean_test_score')
print(table.reindex(['(16,)', '(64,)', '(256,)', '(64, 64)']).round(3))
best_std = res.loc[grid.best_index_, 'std_test_score']
print(f"best: {grid.best_params_} · CV accuracy {grid.best_score_:.3f} ± {best_std:.3f}")
param_mlpclassifier__alpha  0.0001   1.0000   10.0000
layers
(16,)                         0.959    0.969    0.951
(64,)                         0.977    0.977    0.951
(256,)                        0.982    0.975    0.950
(64, 64)                      0.973    0.973    0.941
best: {'mlpclassifier__alpha': 0.0001, 'mlpclassifier__hidden_layer_sizes': (256,)} · CV accuracy 0.982 ± 0.003
Leia a tabela por linhas e por colunas:
- a largura ajuda, até certo ponto: 16 unidades são poucas (0,959 sem penalidade), 64 e 256 chegam a 0,977 e 0,982;
alpha = 10prejudica todas as arquiteturas (0,941 a 0,951): a penalidade espreme os pesos até a rede subajustar.alpha = 1ajuda a rede menor (0,969 contra 0,959) e prejudica um pouco a maior (0,975 contra 0,982);- uma segunda camada oculta não ajuda aqui: (64, 64) marca 0,973, abaixo de uma camada única de 64 (0,977). A profundidade compensa em dados de percepção numa escala muito maior que 1.347 imagens de 8 × 8 pixels.
A vencedora, 256 unidades com alpha = 0.0001, marca 0,982 ± 0,003; as segundas colocadas, com 0,977, ficam a menos de dois desvios padrão entre folds. Como na aula de validação, é uma boa escolha, não um ótimo provado.
Passo 6 — a curva de perda e a parada antecipada
best = grid.best_estimator_                        # a vencedora, reajustada em todo o X_train
net = best[-1]
print(f"no early stopping: {net.n_iter_} epochs · final training loss {net.loss_curve_[-1]:.4f}")

settings = {k.split('__')[1]: v for k, v in grid.best_params_.items()}
early = make_pipeline(StandardScaler(), MLPClassifier(**settings, early_stopping=True, max_iter=1000,
                                                      random_state=42)).fit(X_train, y_train)
net_es = early[-1]
print(f"early stopping:    {net_es.n_iter_} epochs · best accuracy on its 10% validation rows "
      f"{net_es.best_validation_score_:.3f}")
print("CV accuracy with early stopping:", cv_summary(early))

fig, ax = plt.subplots(figsize=(7, 3.2))
ax.plot(net.loss_curve_, label='training loss, no early stopping')
ax.plot(net_es.loss_curve_, label='training loss, early stopping')
ax.set_xlabel('epoch')
ax.set_ylabel('training loss')
ax.set_yscale('log')
ax2 = ax.twinx()
ax2.plot(net_es.validation_scores_, color='green', label='validation accuracy (early stopping)')
ax2.set_ylabel('validation accuracy')
fig.legend(loc='center right')
plt.show()
no early stopping: 105 epochs · final training loss 0.0039
early stopping:    31 epochs · best accuracy on its 10% validation rows 0.978
CV accuracy with early stopping: 0.961 ± 0.008
Sem parada antecipada, o Adam rodou 105 épocas (passadas pelas 1.347 imagens de treino) até a perda parar de melhorar, terminando com perda de treino 0,0039: a rede ajusta as imagens de treino quase perfeitamente e com confiança. Com early_stopping=True, o scikit-learn separou 10% das linhas de treino, parou depois de 31 épocas porque a acurácia nelas não melhorava desde a época 20 e chegou a 0,978 nessas linhas (script da figura):
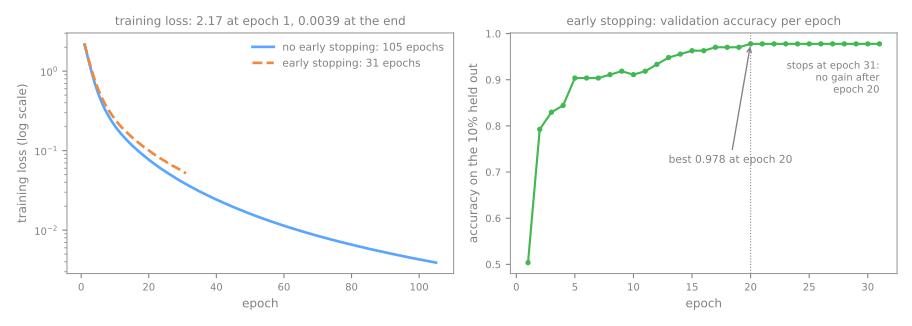
A acurácia na validação cruzada, porém, é 0,961 ± 0,008, abaixo dos 0,982 da vencedora. Num conjunto tão pequeno, abrir mão de 10% das linhas de treino e parar cedo custa mais do que o sobreajuste que isso evita; a penalidade alpha, escolhida por validação cruzada, é o melhor regularizador aqui. A parada antecipada se paga em conjuntos grandes, onde cada época é cara e sobram linhas.
Passo 7 — o MLP é mesmo melhor? Mesmos folds, fold a fold
def fold_scores(g):                                # as 5 notas por fold da vencedora de uma grade
    return np.array([g.cv_results_[f'split{k}_test_score'][g.best_index_] for k in range(5)])


lr_grid = GridSearchCV(models['logistic regression'],
                       {'logisticregression__C': [0.01, 0.1, 1, 10, 100]}, cv=cv).fit(X_train, y_train)
print("logistic regression, best C:", lr_grid.best_params_['logisticregression__C'])
folds = pd.DataFrame({'MLP': fold_scores(grid),
                      'logistic': fold_scores(lr_grid),
                      'forest': cross_val_score(models['random forest, 300 trees'], X_train, y_train, cv=cv)})
folds['MLP - logistic'] = folds['MLP'] - folds['logistic']
folds['MLP - forest'] = folds['MLP'] - folds['forest']
print(pd.concat([folds, folds.agg(['mean', 'std'])]).round(3).to_string())
logistic regression, best C: 10
        MLP  logistic  forest  MLP - logistic  MLP - forest
0     0.978     0.956   0.974           0.022         0.004
1     0.985     0.981   0.974           0.004         0.011
2     0.981     0.963   0.989           0.019        -0.007
3     0.981     0.959   0.963           0.022         0.019
4     0.985     0.978   0.981           0.007         0.004
mean  0.982     0.967   0.976           0.015         0.006
std   0.003     0.012   0.010           0.009         0.010
Ajustada em C, a regressão logística fica com C = 10 e 0,967. Depois, fold a fold:
- o MLP vence a regressão logística ajustada em todos os cinco folds, por 0,004 a 0,022, média 0,015 ± 0,009: os atributos aprendidos pela camada oculta valem cerca de 1,5 ponto de acurácia em pixels;
- contra a random forest ele vence 4 dos 5 folds e perde um (−0,007), média 0,006 ± 0,010: uma diferença menor que o próprio desvio padrão, portanto um empate.
Valem as ressalvas da aula de validação: a coluna do MLP é a melhor de 12 configurações, então é um pouco otimista, enquanto a floresta rodou com os padrões. Em pixels a rede é pelo menos tão boa quanto um ensemble de árvores forte; na tabela do spambase da aula, o boosting ficou à frente.
Passo 8 — o único teste
from sklearn.metrics import accuracy_score, confusion_matrix

pred = best.predict(X_test)
print(f"test accuracy {accuracy_score(y_test, pred):.3f} · {(pred != y_test).sum()} errors in {len(y_test)} images")
cm = confusion_matrix(y_test, pred)
errors = cm - np.diag(np.diag(cm))                 # só os erros
true_d, pred_d = np.unravel_index(errors.argmax(), errors.shape)
print(f"most frequent mistake: true {true_d}, predicted {pred_d} ({errors[true_d, pred_d]} times)")
print("errors per true digit:", errors.sum(axis=1))
test accuracy 0.982 · 8 errors in 450 images
most frequent mistake: true 8, predicted 1 (3 times)
errors per true digit: [1 1 0 0 0 1 1 0 4 0]
Uma única vez, no fim, o MLP ajustado é avaliado nas 450 imagens de teste: acurácia 0,982, 8 erros, exatamente a estimativa da validação cruzada (0,982 ± 0,003). Metade dos erros (4 de 8) são 8 verdadeiros, três deles lidos como 1, enquanto os dígitos 2, 3, 4, 7 e 9 não têm nenhum erro no teste. Com 8 × 8 pixels há pouco espaço para distinguir um 8 estreito de um 1.
Sua vez
- Profundidade. Acrescente
(128, 64)e(256, 128)à grade do passo 5. Uma segunda camada oculta supera a melhor camada única por mais de um desvio padrão entre folds? Conte os parâmetros de cada vencedora com an_paramsda aula. - Gradient boosting em pixels. Avalie
HistGradientBoostingClassifier(random_state=42)comcv_summary(demora mais que os outros). No spambase ele venceu o MLP; o que acontece com pixels? Ponha as notas por fold dele ao lado das do MLP, como no passo 7. - Solver e ativação. Reajuste a vencedora com
solver='lbfgs'e depois comactivation='tanh', nos mesmos folds. Qual configuração muda a acurácia de validação cruzada mais do que o desvio padrão dela? - Olhe os erros. Plote as imagens de teste mal classificadas (
X_test[pred != y_test], reorganizadas em 8 × 8) com os rótulos verdadeiro e previsto. Você as teria lido corretamente?
Material de aula
Vídeos
- But what is a neural network? — 3Blue1Brown, capítulo 1 de Deep Learning
- Backpropagation calculus — 3Blue1Brown, capítulo 4 de Deep Learning
Leitura complementar
- ANN-DL — Multi-Layer Perceptron — o mesmo exemplo 2-2-1, em profundidade
- TensorFlow Playground — treine uma rede pequena no navegador e observe as unidades ocultas
- Guia do usuário do scikit-learn — Neural network models (supervised)
Referências
- Rosenblatt, F. "The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain." Psychological Review 65, n. 6 (1958): 386–408. DOI
- Novikoff, A. B. J. "On Convergence Proofs on Perceptrons." Proceedings of the Symposium on the Mathematical Theory of Automata 12 (1962): 615–622 — o limite de erros \((R/\gamma)^2\).
- Minsky, M.; Papert, S. Perceptrons: An Introduction to Computational Geometry. MIT Press (1969) — a limitação dos perceptrons de uma camada no XOR.
- Rumelhart, D. E.; Hinton, G. E.; Williams, R. J. "Learning Representations by Back-propagating Errors." Nature 323 (1986): 533–536. DOI
- Cybenko, G. "Approximation by Superpositions of a Sigmoidal Function." Mathematics of Control, Signals and Systems 2 (1989): 303–314. DOI
- Hornik, K. "Approximation Capabilities of Multilayer Feedforward Networks." Neural Networks 4 (1991): 251–257. DOI
- Nair, V.; Hinton, G. E. "Rectified Linear Units Improve Restricted Boltzmann Machines." ICML (2010).
- Glorot, X.; Bordes, A.; Bengio, Y. "Deep Sparse Rectifier Neural Networks." AISTATS (2011).
- Srivastava, N.; Hinton, G.; Krizhevsky, A.; Sutskever, I.; Salakhutdinov, R. "Dropout: A Simple Way to Prevent Neural Networks from Overfitting." Journal of Machine Learning Research 15 (2014): 1929–1958.
- Kingma, D. P.; Ba, J. "Adam: A Method for Stochastic Optimization." ICLR (2015). arXiv
- Shwartz-Ziv, R.; Armon, A. "Tabular Data: Deep Learning Is Not All You Need." Information Fusion 81 (2022): 84–90. DOI
- Grinsztajn, L.; Oyallon, E.; Varoquaux, G. "Why Do Tree-Based Models Still Outperform Deep Learning on Typical Tabular Data?" NeurIPS Datasets and Benchmarks (2022). arXiv