O caminho desta parte
- Um neurônioa regressão logística como neurônio; o perceptron
- Camadas ocultasXOR, uma camada oculta, ativações não lineares
- Passagem diretaum produto de matrizes por camada; contar parâmetros
- Retropropagaçãoregra da cadeia, seis passos, um simulador
- Na práticaescala, largura, weight decay
Um neurônio é uma regressão logística
\[ z = w^\top x + b, \qquad a = \varphi(z) \]Entradas \(x\), pesos \(w\), viés \(b\), pré-ativação \(z\), função de ativação \(\varphi\). Com \(\varphi = \sigma\), a sigmoide \(\sigma(z) = 1/(1 + e^{-z})\), isso é a regressão logística: \(a\) é a probabilidade da classe positiva.
à mão
\(w = (2, -1)\), \(b = 0{,}5\), \(x = (1, 2)\): \(z = 2 \cdot 1 - 1 \cdot 2 + 0{,}5 = 0{,}5\) e \(a = \sigma(0{,}5) = 0{,}622\).
O perceptron (Rosenblatt, 1958)
Ativação: um degrau, \(\hat y = +1\) se \(z > 0\), \(-1\) caso contrário. Rótulos \(y \in \{-1, +1\}\).
Visite os pontos um a um. Se o ponto \(i\) está errado ou sobre a reta (\(y_i z_i \le 0\)), com tamanho de passo \(\eta\):
\[ w \leftarrow w + \eta \, y_i \, x_i, \qquad b \leftarrow b + \eta \, y_i \]Depois da atualização, o escore com sinal do ponto, \(y_i z_i\), cresce \(\eta(\lVert x_i \rVert^2 + 1) > 0\): a reta se inclina para classificá-lo.
Três atualizações à mão, passo a passo
Seis pontos: A, E, F são \(+1\); B, C, D são \(-1\). Início \(w = (0, 0)\), \(b = 0\), \(\eta = 1\). Preveja. Que pontos vão causar uma atualização e quantas épocas até uma passar sem erro?
XOR: por que uma reta não basta
\((0, 1)\) e \((1, 0)\) são \(+1\); \((0, 0)\) e \((1, 1)\) são \(-1\). Uma reta separadora \(w_1 x_1 + w_2 x_2 + b = 0\) precisaria de:
- \((0,0)\) negativo: \(b < 0\)
- \((0,1)\), \((1,0)\) positivos: \(w_2 + b > 0\), \(w_1 + b > 0\)
- \((1,1)\) negativo: \(w_1 + w_2 + b < 0\)
Some as duas do meio: \(w_1 + w_2 + 2b > 0\), então \(w_1 + w_2 + b > -b > 0\). Contradição.
Simulador: o perceptron no XOR
Escolha o preset XOR e aperte Época inteira algumas vezes. Preveja. Os erros por época vão chegar a zero? Para onde vão os pesos?
O mesmo muro para a regressão logística
Um XOR com ruído: 400 pontos em volta dos quatro cantos (205 e 195 por classe), validação cruzada em 5 folds.
regressão logística
suas probabilidades
Uma camada oculta resolve o XOR
- \(h_1\): \(x_1 + x_2 - 0{,}5 > 0\), OU
- \(h_2\): \(x_1 + x_2 - 1{,}5 > 0\), E
- saída: \(h_1 - h_2 - 0{,}5 > 0\), XOR
| \(x_1\) | \(x_2\) | \(h_1\) | \(h_2\) | \(z_{\text{saída}}\) | saída |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | −0,5 | 0 |
| 0 | 1 | 1 | 0 | 0,5 | 1 |
| 1 | 0 | 1 | 0 | 0,5 | 1 |
| 1 | 1 | 1 | 1 | −0,5 | 0 |
Linha \((1, 1)\): \(z_1 = 1{,}5 \Rightarrow h_1 = 1\); \(z_2 = 0{,}5 \Rightarrow h_2 = 1\); \(z_{\text{saída}} = 1 - 1 - 0{,}5 = -0{,}5 \Rightarrow 0\). Todos os pesos escolhidos à mão.
A camada oculta constrói atributos novos
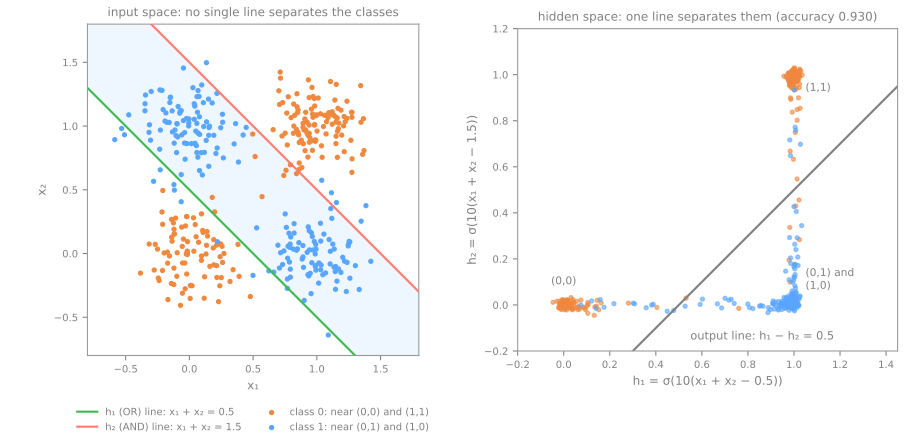
Do degrau à sigmoide: algo para derivar
O degrau tem derivada 0 em todo lugar: o gradiente não diz nada. Troque-o por uma sigmoide e multiplique cada peso por 10:
| \(x_1\) | \(x_2\) | \(h_1\) | \(h_2\) | P(XOR = 1) |
|---|---|---|---|---|
| 0 | 0 | 0,007 | 0,000 | 0,007 |
| 0 | 1 | 0,993 | 0,007 | 0,992 |
| 1 | 0 | 0,993 | 0,007 | 0,992 |
| 1 | 1 | 1,000 | 0,993 | 0,007 |
Funções de ativação
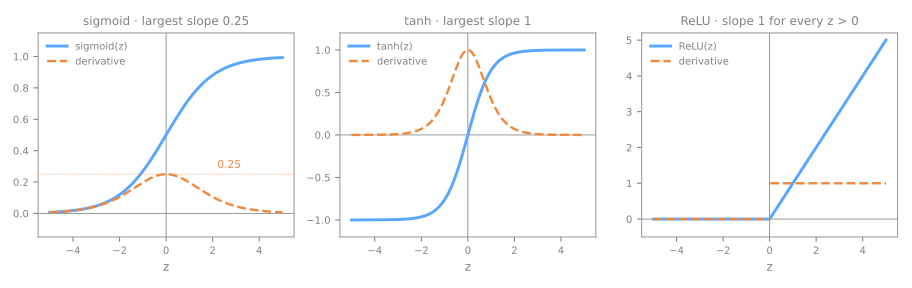
| maior derivada | |
|---|---|
| sigmoide | 0,25, em \(z = 0\) |
| tanh | 1, em \(z = 0\) |
| ReLU | 1, para todo \(z > 0\) |
Sem não linearidade, as camadas colapsam
\(W_2 (W_1 x + b_1) + b_2\) é uma camada com pesos \(W_2 W_1\) e viés \(W_2 b_1 + b_2\): função linear de função linear é linear.
duas camadas lineares
uma camada fundida
ReLU no meio
No XOR com ruído, 8 unidades ocultas:
| ativação | acurácia na validação cruzada |
|---|---|
identity | 0,510 |
relu | 0,983 |
A passagem direta: um produto de matrizes por camada
\[ z = W x + b^{h}, \quad h = \sigma(z), \quad u = v^\top h + b^{y}, \quad \hat{y} = \sigma(u) \]\(W\): uma linha de pesos por unidade oculta; \(b^h\), \(b^y\): vieses; \(v\): os pesos da saída; \(u\): a pré-ativação da saída. Para um lote de linhas \(X\): \(H = \sigma(X W^\top + b^h)\), e é por isso que as redes rodam tão bem em GPUs (graphics processing units, unidades de processamento gráfico), máquinas de multiplicar matrizes.
uma rede 2-2-1, um exemplo \(x = (0{,}5;\ 0{,}8)\), alvo \(y = 0\)
\(W = \begin{pmatrix} 0{,}2 & 0{,}4 \\ 0{,}6 & 0{,}8 \end{pmatrix}\), \(b^h = (0{,}1;\ 0{,}2)\), \(v = (0{,}3;\ 0{,}5)\), \(b^y = 0{,}4\)
Contando parâmetros
Uma camada com \(n_\text{ent}\) entradas e \(n_\text{sai}\) unidades: \(n_\text{ent} \cdot n_\text{sai}\) pesos e \(n_\text{sai}\) vieses, \((n_\text{ent} + 1) \cdot n_\text{sai}\) parâmetros. Preveja. Uma camada oculta de 256 unidades ou duas de 64: qual tem mais?
| arquitetura | parâmetros |
|---|---|
| 2 → 2 → 1 | 9 |
| 64 → 10 | 650 |
| 64 → 32 → 10 | 2.410 |
| 64 → 256 → 10 | 19.210 |
| 64 → 64 → 64 → 10 | 8.970 |
Retropropagação: a regra da cadeia, organizada
Um peso da primeira camada só chega à perda \(L = (\hat y - y)^2\) através de tudo o que vem depois dele:
\[ w_{11} \;\to\; z_1 \;\to\; h_1 \;\to\; u \;\to\; \hat y \;\to\; L \]- gradiente da perda: \(\partial L / \partial \hat y = 2(\hat y - y)\)
- delta da saída: \(\delta_y = \partial L / \partial u = 2(\hat y - y) \cdot \hat y (1 - \hat y)\), pois \(\sigma'(u) = \hat y(1 - \hat y)\)
- pesos da saída: \(\partial L / \partial v_{1j} = \delta_y \, h_j\)
- deltas ocultos: \(\delta_{h_j} = \delta_y \, v_{1j} \cdot h_j (1 - h_j)\)
- pesos ocultos: \(\partial L / \partial w_{jk} = \delta_{h_j} \, x_k\)
- atualização, com passo \(\eta\): \(p \leftarrow p - \eta \, \partial L / \partial p\) para todo parâmetro \(p\)
Retropropagação, passo a passo
A rede 2-2-1 da etapa 3. O passo 1 é a passagem direta; os passos 2 a 6 mandam o gradiente de volta; o passo 7 atualiza com \(\eta = 0{,}5\). Preveja. Qual dos 9 gradientes será o menor? (Clique no simulador para usar as setas dentro dele.)
Na prática: escalone as entradas
Spambase: 4.601 e-mails, 57 atributos, desvios-padrão de 0,076 a 606.
| MLP (multi-layer perceptron, perceptron multicamadas) | acurácia na validação cruzada |
|---|---|
| entradas cruas | 0,927 |
StandardScaler antes | 0,948 |
Largura e weight decay, nas luas com ruído
alpha, a penalidade L2 nos pesos (weight decay, decaimento de pesos), faz com as 100 unidades?| unidades ocultas | treino | validação |
|---|---|---|
| regressão logística | 0,830 | |
| 1 | 0,842 | 0,843 |
| 3 | 0,897 | 0,873 |
| 10 | 0,938 | 0,893 |
| 100 | 0,997 | 0,857 |
100 unidades, alpha | treino | validação |
|---|---|---|
| 0,0001 | 0,997 | 0,857 |
| 0,01 | 0,993 | 0,880 |
| 0,1 | 0,939 | 0,903 |
| 1 | 0,914 | 0,917 |
| 10 | 0,837 | 0,830 |
As fronteiras
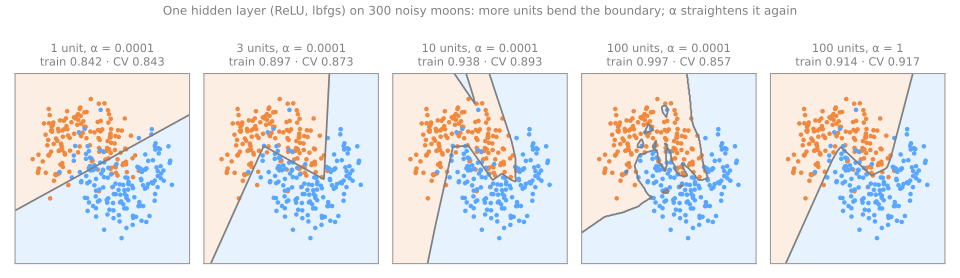
alpha (e a largura) por validação cruzada.Resumo
- Um neurônio = soma ponderada + ativação; com sigmoide, regressão logística; com degrau, o perceptron.
- Um neurônio traça uma reta: o XOR pede uma camada oculta, que calcula atributos novos.
- A ativação precisa ser não linear, senão as camadas colapsam; a ReLU impede o gradiente de desaparecer.
- Passagem direta: um produto de matrizes por camada. Retropropagação: deltas mandados de volta, um gradiente exato por peso.
- Na prática: escalonar e depois ajustar largura e
alphapor validação cruzada.
| sintoma | o que fazer |
|---|---|
| treino perto de 1, validação bem abaixo | subir o alpha ou usar menos unidades |
| treino e validação no nível da regressão logística | mais unidades, menos alpha, uma ativação não linear |
Uma rede neural em dígitos manuscritos, passos 1 a 5
- 1.797 dígitos de 8 × 8 pixels: dizer o dígito. Trancar o teste, fixar uma baseline, comparar três modelos nos mesmos folds, ajustar a largura e o
alpha. - Baixe o notebook do lab e abra no Jupyter ou no Colab; roda em cerca de um minuto.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: uma rede sem ativação (passo 4) e quão estreita a rede pode ser? (passo 5).
Ritmo: passos 1 a 3 em 6 min; passo 4 e a primeira simulação em 10 min; passo 5 e a segunda em 14 min.