O caminho desta aula
- Um neurônioa regressão logística como neurônio; o perceptron
- Camadas ocultasXOR, uma camada oculta, ativações não lineares
- Passagem diretaum produto de matrizes por camada; contar parâmetros
- Retropropagaçãoregra da cadeia, seis passos, uma perda não convexa
- Na práticaescala, largura, weight decay; dados tabulares
Um neurônio é uma regressão logística
\[ z = w^\top x + b, \qquad a = \varphi(z) \]Com \(\varphi = \sigma\) isso é a regressão logística: \(a\) é a probabilidade da classe positiva.
à mão
\(w = (2, -1)\), \(b = 0{,}5\), \(x = (1, 2)\): \(z = 2 \cdot 1 - 1 \cdot 2 + 0{,}5 = 0{,}5\) e \(a = \sigma(0{,}5) = 0{,}622\).
O perceptron (Rosenblatt, 1958)
Ativação: um degrau, \(+1\) se \(z > 0\), \(-1\) caso contrário. Rótulos \(y \in \{-1, +1\}\).
Visite os pontos um a um. Se o ponto \(i\) está errado ou sobre a reta (\(y_i z_i \le 0\)):
\[ w \leftarrow w + \eta \, y_i \, x_i, \qquad b \leftarrow b + \eta \, y_i \]Depois da atualização, o escore com sinal do ponto cresce \(\eta(\lVert x_i \rVert^2 + 1) > 0\): a reta se inclina para classificá-lo.
Três atualizações à mão
| ponto | \(x_1\) | \(x_2\) | \(y\) |
|---|---|---|---|
| A | 4 | 2 | +1 |
| B | 0 | 2 | −1 |
| C | 1 | 3 | −1 |
| D | 2 | 4 | −1 |
| E | 3 | 0 | +1 |
| F | 3 | 1 | +1 |
Início \(w = (0, 0)\), \(b = 0\), \(\eta = 1\).
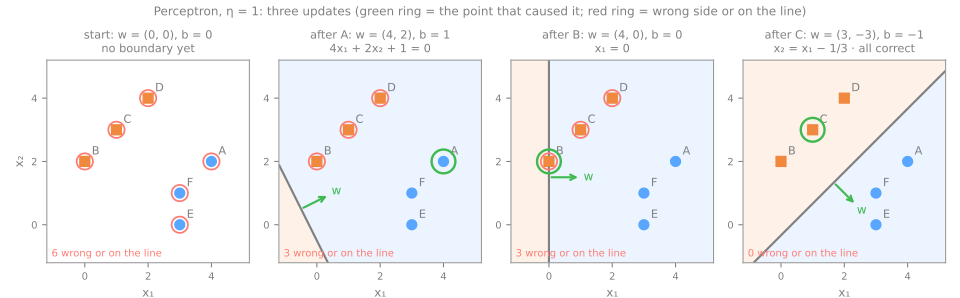
- A: \(z = 0\), erro → \(w = (4, 2)\), \(b = 1\)
- B: \(z = 5\), \(y = -1\), erro → \(w = (4, 0)\), \(b = 0\)
- C: \(z = 4\), \(y = -1\), erro → \(w = (3, -3)\), \(b = -1\)
- D, E, F: \(z = -7, 8, 5\), todos corretos
A fronteira depois de cada atualização
Simulador: o perceptron
Passo visita um ponto e mostra as contas. Preveja. No terceiro preset (XOR), os erros por época vão chegar a zero?
XOR: por que uma reta não basta
\((0, 1)\) e \((1, 0)\) são \(+1\); \((0, 0)\) e \((1, 1)\) são \(-1\). Uma reta separadora precisaria de:
- \((0,0)\) negativo: \(b < 0\)
- \((0,1)\), \((1,0)\) positivos: \(w_2 + b > 0\), \(w_1 + b > 0\)
- \((1,1)\) negativo: \(w_1 + w_2 + b < 0\)
Some as duas do meio: \(w_1 + w_2 + 2b > 0\), então \(w_1 + w_2 + b > -b > 0\). Contradição.
O mesmo muro para a regressão logística
Um XOR com ruído: 400 pontos em volta dos quatro cantos (205 e 195 por classe), validação cruzada em 5 folds.
regressão logística
suas probabilidades
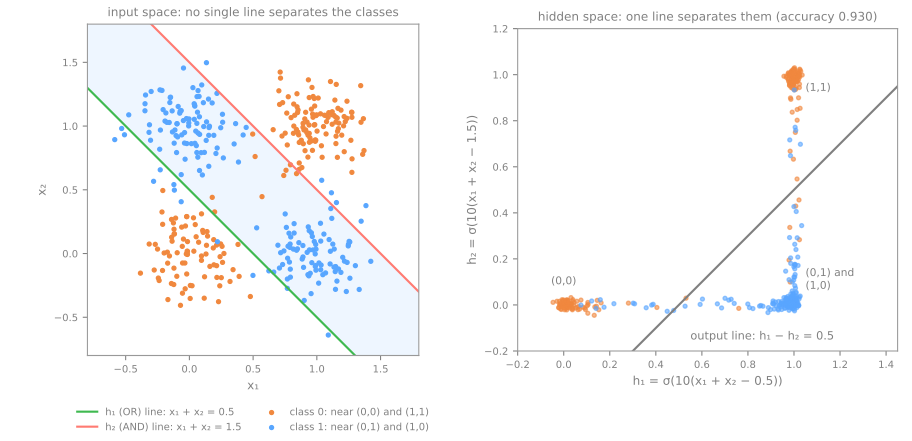
Uma camada oculta resolve o XOR
- \(h_1\): \(x_1 + x_2 - 0{,}5 > 0\), OU
- \(h_2\): \(x_1 + x_2 - 1{,}5 > 0\), E
- saída: \(h_1 - h_2 - 0{,}5 > 0\), XOR
| \(x_1\) | \(x_2\) | \(h_1\) | \(h_2\) | \(z_{\text{saída}}\) | saída |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | −0,5 | 0 |
| 0 | 1 | 1 | 0 | 0,5 | 1 |
| 1 | 0 | 1 | 0 | 0,5 | 1 |
| 1 | 1 | 1 | 1 | −0,5 | 0 |
Linha \((1, 1)\): \(z_1 = 1{,}5 \Rightarrow h_1 = 1\); \(z_2 = 0{,}5 \Rightarrow h_2 = 1\); \(z_{\text{saída}} = 1 - 1 - 0{,}5 = -0{,}5 \Rightarrow 0\). Todos os pesos escolhidos à mão.
A camada oculta constrói atributos novos
Do degrau à sigmoide: algo para derivar
O degrau tem derivada 0 em todo lugar: o gradiente não diz nada. Troque-o por uma sigmoide e multiplique cada peso por 10:
| \(x_1\) | \(x_2\) | \(h_1\) | \(h_2\) | P(XOR = 1) |
|---|---|---|---|---|
| 0 | 0 | 0,007 | 0,000 | 0,007 |
| 0 | 1 | 0,993 | 0,007 | 0,992 |
| 1 | 0 | 0,993 | 0,007 | 0,992 |
| 1 | 1 | 1,000 | 0,993 | 0,007 |
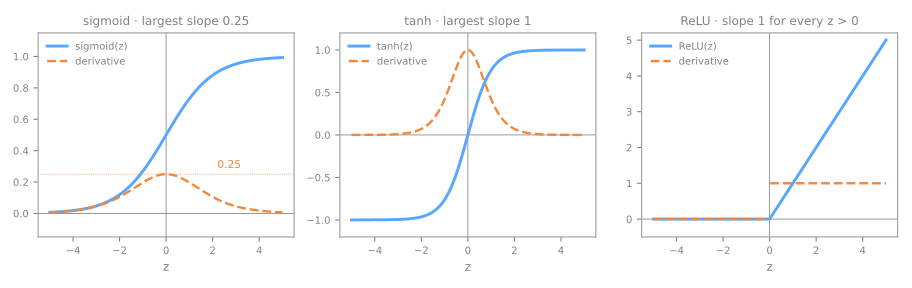
Funções de ativação
| maior derivada | |
|---|---|
| sigmoide | 0,25, em \(z = 0\) |
| tanh | 1, em \(z = 0\) |
| ReLU | 1, para todo \(z > 0\) |
Sem não linearidade, as camadas colapsam
\(W_2 (W_1 x + b_1) + b_2\) é uma camada com pesos \(W_2 W_1\): função linear de função linear é linear.
duas camadas lineares
uma camada fundida
ReLU no meio
No XOR com ruído, 8 unidades ocultas:
| ativação | acurácia na validação cruzada |
|---|---|
identity | 0,510 |
relu | 0,983 |
A passagem direta: um produto de matrizes por camada
\[ z = W x + b^{h}, \quad h = \sigma(z), \quad u = v^\top h + b^{y}, \quad \hat{y} = \sigma(u) \]Para um lote: \(H = \sigma(X W^\top + b^h)\). Por isso as redes rodam tão bem em GPUs (graphics processing units), máquinas de multiplicar matrizes.
uma rede 2-2-1, um exemplo \(x = (0{,}5;\ 0{,}8)\), alvo \(y = 0\)
\(W = \begin{pmatrix} 0{,}2 & 0{,}4 \\ 0{,}6 & 0{,}8 \end{pmatrix}\), \(b^h = (0{,}1;\ 0{,}2)\), \(v = (0{,}3;\ 0{,}5)\), \(b^y = 0{,}4\)
A rede 2-2-1, à mão
\(z_1 = 0{,}2 \cdot 0{,}5 + 0{,}4 \cdot 0{,}8 + 0{,}1 = 0{,}52\)
\(z_2 = 0{,}6 \cdot 0{,}5 + 0{,}8 \cdot 0{,}8 + 0{,}2 = 1{,}14\)
\(h = \sigma(z) = (0{,}627;\ 0{,}758)\)
\(u = 0{,}3 \cdot 0{,}627 + 0{,}5 \cdot 0{,}758 + 0{,}4 = 0{,}967\)
\(\hat y = \sigma(0{,}967) = 0{,}725\)
perda quadrática
scikit-learn, com os mesmos pesos carregados: 0,7245
Contando parâmetros
Uma camada: \((n_\text{ent} + 1) \cdot n_\text{sai}\) parâmetros.
| arquitetura | parâmetros |
|---|---|
| 2 → 2 → 1 | 9 |
| 64 → 10 | 650 |
| 64 → 32 → 10 | 2.410 |
| 64 → 256 → 10 | 19.210 |
| 64 → 64 → 64 → 10 | 8.970 |
Retropropagação: a regra da cadeia, organizada
\[ w_{11} \;\to\; z_1 \;\to\; h_1 \;\to\; u \;\to\; \hat y \;\to\; L \]- gradiente da perda: \(\partial L / \partial \hat y = 2(\hat y - y)\)
- delta da saída: \(\delta_y = 2(\hat y - y) \cdot \hat y (1 - \hat y)\)
- pesos da saída: \(\partial L / \partial v_{1j} = \delta_y \, h_j\)
- deltas ocultos: \(\delta_{h_j} = \delta_y \, v_{1j} \cdot h_j (1 - h_j)\)
- pesos ocultos: \(\partial L / \partial w_{jk} = \delta_{h_j} \, x_k\)
- atualização: \(p \leftarrow p - \eta \, \partial L / \partial p\)
Os seis passos, com números
| passo | valor | leitura |
|---|---|---|
| 1. \(\partial L/\partial \hat y\) | 1,449 | empurrar \(\hat y\) para baixo, rumo a 0 |
| 2. \(\delta_y\) | 0,2892 | \(1{,}449 \times 0{,}199\), a inclinação da sigmoide de saída |
| 3. \(\partial L/\partial v\) | 0,1814; 0,2191 | maior para \(h_2 = 0{,}758\), que contribuiu mais |
| 4. \(\delta_h\) | 0,0203; 0,0266 | dez vezes menores: pesos < 1 e inclinações < 0,25 |
| 5. \(\partial L/\partial W\) | 0,0101 a 0,0212 | os menores: o gradiente que desaparece, em miniatura |
Simulador: retropropagação, passo a passo
O passo 1 é a passagem direta; os passos 2 a 6 mandam o gradiente de volta; o passo 7 atualiza com \(\eta = 0{,}5\). Use Avançar e Voltar (clique no simulador para usar as setas dentro dele).
Por que a retropropagação importa: o custo
diferenças finitas
2 passagens diretas extras por parâmetro: 18 para os 9 parâmetros; 4.820 numa rede 64-32-10 de dígitos
retropropagação
uma passagem de volta para todos os gradientes, mais ou menos o custo da passagem direta
Não convexo: o ponto de partida importa
O XOR com ruído, 10 inícios aleatórios (random_state 0–9), acurácia de treino:
| unidades ocultas | sementes 0–9 |
|---|---|
| 2 | 0,76 0,66 0,74 0,94 0,94 0,94 0,94 0,94 0,74 0,66 |
| 8 | 0,98 0,98 0,97 0,98 0,98 0,96 0,99 0,99 0,97 0,95 |
Otimizadores e regularização
adam
o padrão: mini-lotes de 200 com momento e um passo por parâmetro
sgd
gradiente descendente em mini-lotes, momento opcional
lbfgs
o treino inteiro e a curvatura; o melhor em conjuntos pequenos
alpha: weight decay (decaimento de pesos), a penalidade L2 do Ridge em todo peso.early_stopping=True: separa 10% e para depois de 10 épocas sem melhora.- dropout nas bibliotecas de deep learning; não no scikit-learn.
Na prática: escalone as entradas
Spambase: 4.601 e-mails, 57 atributos, desvios-padrão de 0,076 a 606.
| MLP (multi-layer perceptron) | acurácia na validação cruzada |
|---|---|
| entradas cruas | 0,927 |
StandardScaler antes | 0,948 |
Largura e weight decay, nas luas com ruído
| unidades ocultas | treino | validação |
|---|---|---|
| regressão logística | 0,830 | |
| 1 | 0,842 | 0,843 |
| 3 | 0,897 | 0,873 |
| 10 | 0,938 | 0,893 |
| 100 | 0,997 | 0,857 |
100 unidades, alpha | treino | validação |
|---|---|---|
| 0,0001 | 0,997 | 0,857 |
| 0,01 | 0,993 | 0,880 |
| 0,1 | 0,939 | 0,903 |
| 1 | 0,914 | 0,917 |
| 10 | 0,837 | 0,830 |
As fronteiras
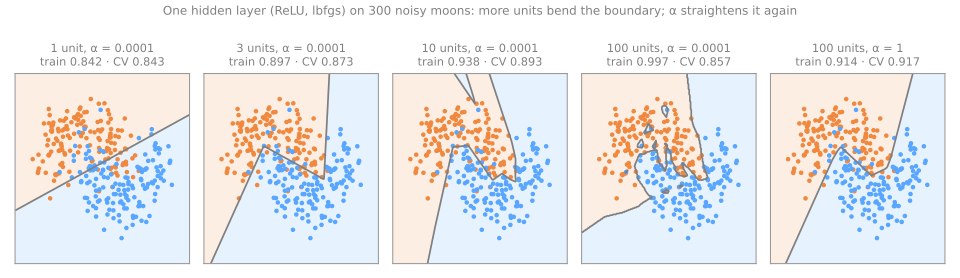
alpha (e a largura) por validação cruzada.Profundidade e quando usar uma rede
- Uma camada oculta é um aproximador universal (Cybenko, 1989; Hornik, 1991): existência, não que o treino a encontre.
- Redes profundas constroem sobre as camadas anteriores: bordas → texturas → objetos. Essa hierarquia tomou conta da percepção a partir de 2012.
| spambase, mesmos folds | média | desvio |
|---|---|---|
| logística | 0,924 | 0,008 |
| MLP | 0,948 | 0,005 |
| MLP com parada antecipada | 0,942 | 0,006 |
| gradient boosting | 0,956 | 0,011 |
Resumo
- Um neurônio = soma ponderada + ativação; com sigmoide, regressão logística.
- Um neurônio traça uma reta: o XOR pede uma camada oculta, que aprende atributos novos.
- Ativações não lineares: sem elas, as camadas colapsam; a ReLU combate o gradiente que desaparece.
- Retropropagação: deltas mandados de volta, o gradiente exato numa passagem.
- Não convexo: as sementes importam. Escalone e ajuste largura e
alphapor validação cruzada.
Uma rede neural em dígitos manuscritos
- 1.797 dígitos, 8 × 8 pixels: dizer o dígito. Baixe o notebook do lab e abra no Jupyter ou no Colab; roda em cerca de um minuto.
- Tranque o conjunto de teste; compare uma baseline e três modelos nos mesmos folds.
- Ajuste a largura e o
alpha; leia a curva de perda e a parada antecipada. - O MLP é mesmo melhor, fold a fold? Depois toque o teste uma única vez.