Pipelines
A aula de pré-processamento estabeleceu uma regra: todo passo que aprende algo com os dados (a mediana de um imputador, a média e o desvio-padrão de um scaler, a lista de categorias de um encoder) é ajustado apenas nas linhas de treino e depois reaplicado, sem mudança, a toda outra linha que o modelo vier a ver: o conjunto de teste, um split de validação, os dados do mês que vem em produção. Escrita à mão, essa regra vira uma pilha de chamadas fit e transform que precisa ficar na ordem certa, nos dados certos, para sempre. Esta aula mede o que dá errado quando uma dessas chamadas escorrega; depois, troca a pilha por um único objeto, o Pipeline do scikit-learn, que torna impossível quebrar a regra sem querer.
Esta aula tem duas abordagens. A fundamental mede o que dá errado quando a regra é mantida à mão e constrói, passo a passo, o objeto que a mantém: um Pipeline, depois um ColumnTransformer para uma tabela real, depois o vazamento que esse arranjo todo evita. A avançada abre esse objeto, salva, estende com passos seus e alcança cada configuração pelo nome, que é do que o ajuste automático precisa.
Todo número abaixo vem da execução do código desta página; cada figura é produzida por um script curto que fica ao lado dela.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | O que dá errado quando a regra treino/teste é mantida à mão e como um único objeto pode mantê-la por nós? | Como abrir, salvar, estender e ajustar esse objeto? |
| conteúdo | o fluxo manual e seus três bugs, medidos; o Pipeline e o que fit e predict fazem em cada passo; ColumnTransformer, remainder, seletores, set_output, categorias desconhecidas; o tamanho de um vazamento, scaler contra target encoder | ler o que cada passo aprendeu; um arquivo para a cadeia inteira; FunctionTransformer e um transformador seu; os nomes passo__parametro e o set_params |
| lab em aula | Titanic: das linhas cruas a uma nota honesta, passos 1 a 5 | abrir, usar, salvar e estender o pipeline, passos 6 a 9 |
| ao final, você sabe | reconhecer os três bugs de um fluxo manual e por que um deles parece certo; dizer o que fit e predict fazem com cada passo; montar um pipeline com ColumnTransformer para uma tabela crua; perceber quando uma nota vazou e por que o tamanho do vazamento depende do passo | ler qualquer valor aprendido de um pipeline ajustado; salvar e carregar a cadeia inteira; escrever um passo que aprende, seguindo as convenções do scikit-learn; mudar qualquer configuração pelo nome, como faz uma busca |
Os dois labs usam o mesmo notebook do lab: baixe-o e abra no Jupyter ou no Colab (File → Upload notebook). A parte fundamental vai do passo 1 ao 5; a avançada, do 6 ao 9.
Abordagem fundamental
Uma pergunta guia esta parte: o que dá errado quando a regra treino/teste é mantida à mão e como um único objeto pode mantê-la por nós? A resposta é medida na tabela California housing: três bugs clássicos de um fluxo manual, o Pipeline que os elimina por construção, o ColumnTransformer que trata uma tabela real, com texto e buracos, e o tamanho do vazamento que esse arranjo todo evita.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. o fluxo manual, sete chamadas e três bugs, cada um medido; 2. um Pipeline, que elimina os três bugs por construção; 3. colunas reais, com o ColumnTransformer mandando cada grupo de colunas para o seu tratamento; 4. uma nota honesta, o vazamento que um pipeline evita e por que o tamanho dele depende do que o passo aprende. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- O fluxo manualsete chamadas, três bugs, medidos
- Um Pipelinefit e predict, passo a passo
- Colunas reaisColumnTransformer: um ramo por grupo de colunas
- Uma nota honestao vazamento que ele evita, medido
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. O problema que os pipelines resolvem
O fluxo manual
Etapa 1. Os dados são a tabela California housing da aula de EDA: 20.640 distritos, oito colunas numéricas (uma delas, total_bedrooms, com valores faltantes), uma coluna categórica (ocean_proximity) e o alvo, o valor mediano das casas do distrito. Para começar simples, as primeiras seções usam só os oito números. O pré-processamento é o da aula anterior: preencher os buracos com a mediana e depois padronizar.
import numpy as np
import pandas as pd
from sklearn.impute import SimpleImputer
from sklearn.metrics import mean_absolute_error
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsRegressor
from sklearn.preprocessing import StandardScaler

url = "https://raw.githubusercontent.com/hsandmann/biblio/refs/heads/main/ml/aula02/housing.csv"
housing = pd.read_csv(url)
X = housing.drop(columns='median_house_value')          # 9 colunas: 8 números + ocean_proximity
y = housing['median_house_value']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
num = ['longitude', 'latitude', 'housing_median_age', 'total_rooms',
       'total_bedrooms', 'population', 'households', 'median_income']

# o fluxo manual: três objetos, cada um ajustado no treino e reaplicado no teste
imputer = SimpleImputer(strategy='median')
scaler = StandardScaler()
model = KNeighborsRegressor(n_neighbors=10)              # caixa-preta: veja a nota abaixo

A_train = scaler.fit_transform(imputer.fit_transform(X_train[num]))   # aprende no treino
model.fit(A_train, y_train)
A_test = scaler.transform(imputer.transform(X_test[num]))             # reaplica no teste
pred = model.predict(A_test)

def mae(p):
    return f"${mean_absolute_error(y_test, p):,.0f}"

print(f"{len(X_train)} training districts, {len(X_test)} test districts")
print("MAE, careful manual workflow:", mae(pred))
print("MAE, always the training mean:", mae(np.full(len(y_test), y_train.mean())))
16512 training districts, 4128 test districts
MAE, careful manual workflow: $43,023
MAE, always the training mean: $92,894
O modelo é uma caixa-preta nesta aula
O KNeighborsRegressor prevê o valor de um distrito como a média dos 10 distritos de treino mais parecidos; "parecido" quer dizer próximo nos oito números padronizados. Você vai estudá-lo de verdade na aula de k-NN; aqui ele só precisa de duas propriedades. Ele depende da escala das colunas, então erros de pré-processamento aparecem nas previsões. E é rápido. Qualquer outro modelo serviria para a mecânica dos pipelines.
A métrica é o erro absoluto médio (MAE, de mean absolute error): em média, a previsão erra o valor verdadeiro de um distrito de teste por US$ 43.023. Um "modelo" que ignora o distrito e sempre responde a média do treino erra por US$ 92.894. Esse é o piso que qualquer modelo de verdade precisa superar.
A versão cuidadosa exige sete chamadas em três objetos; a ordem importa nos dois sentidos: fit_transform no treino, transform no teste, imputador antes do scaler, as mesmas oito colunas na mesma ordem. Cada um dos três bugs clássicos abaixo muda uma coisa no código de previsão. O modelo treinado é o mesmo em todos os casos.
Bug 1 — reajustar nos dados que você prevê
O deslize mais comum é uma palavra: fit_transform onde deveria ser transform. O passo então reaprende suas estatísticas com as linhas que ele deveria apenas transformar. É mais fácil ver à mão. Considere uma coluna com cinco linhas de treino e duas linhas novas:
| linhas de treino | linhas novas |
|---|---|
| 200, NaN, 400, 600, 800 | NaN, 900 |
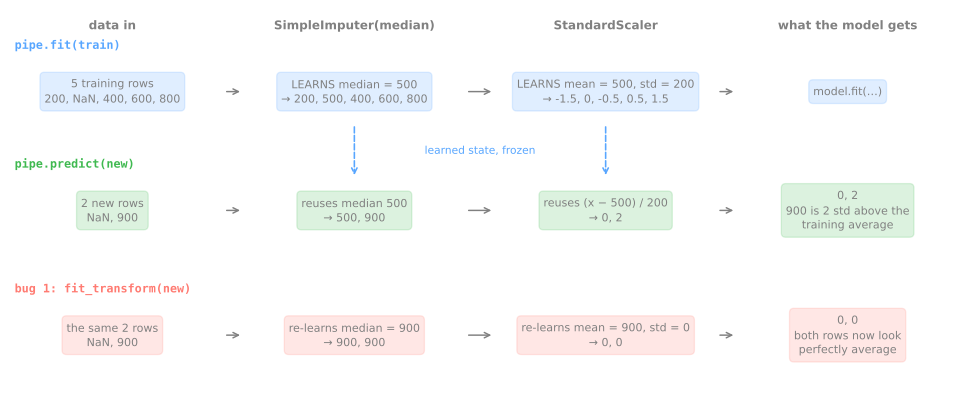
Ajuste nas linhas de treino. A mediana dos quatro valores conhecidos é \((400 + 600)/2 = 500\), então a coluna imputada fica 200, 500, 400, 600, 800. A média dela é 500 e o desvio-padrão é \(\sqrt{(300^2 + 0^2 + 100^2 + 100^2 + 300^2)/5} = \sqrt{40{.}000} = 200\). As linhas novas viram: NaN → 500 → \((500 - 500)/200 = 0\) e 900 → \((900 - 500)/200 = 2\). O segundo distrito novo está dois desvios-padrão acima da média do treino — uma informação que o modelo pode usar.
Agora reajuste nas linhas novas. A mediana delas é 900 (o único valor conhecido), então as duas linhas viram 900; a média é 900 e a dispersão é zero; as duas são transformadas em 0. O distrito com 900 quartos, dois desvios-padrão acima da média do treino, agora parece perfeitamente médio. O scikit-learn concorda:
toy_train = pd.DataFrame({'total_bedrooms': [200, np.nan, 400, 600, 800]})
toy_new = pd.DataFrame({'total_bedrooms': [np.nan, 900]})

imp, sc = SimpleImputer(strategy='median'), StandardScaler()
sc.fit(imp.fit_transform(toy_train))                       # aprende nas 5 linhas de treino
print("learned: median", imp.statistics_, "mean", sc.mean_, "std", sc.scale_)
print("right: transform         ", sc.transform(imp.transform(toy_new)).ravel())
print("wrong: fit_transform again", StandardScaler().fit_transform(
                                    SimpleImputer(strategy='median').fit_transform(toy_new)).ravel())
learned: median [500.] mean [500.] std [200.]
right: transform          [0. 2.]
wrong: fit_transform again [0. 0.]
(Quando uma coluna não tem dispersão nenhuma, o StandardScaler divide por 1 em vez de 0, então o resultado é 0 e não um erro.)
O simulador percorre a mesma conta um passo por vez: a mediana, os buracos preenchidos, a média, o desvio-padrão e o que chega ao modelo. Os três modos mudam só as linhas em que o fit aprende: as de treino (o jeito certo), de novo as linhas novas (este bug) ou as sete linhas antes da divisão, o vazamento da seção 4.
Quanto isso custa nos dados reais depende de como as linhas chegam para a previsão. Num notebook, o conjunto de teste inteiro chega de uma vez. Em produção, as linhas chegam em lotes (o escritório de uma região manda os seus distritos) ou uma de cada vez (um usuário preenche um formulário). A função abaixo reproduz o bug: o modelo treinado é o mesmo, mas o scaler é reajustado em cada lote que ele prevê.
def predict_bug1(batch):
    """BUG 1: fit_transform onde deveria ser transform: o scaler reaprende no lote."""
    return model.predict(StandardScaler().fit_transform(imputer.transform(batch[num])))

print("re-fit on the whole test set:  ", mae(predict_bug1(X_test)))
by_region = pd.concat([pd.Series(predict_bug1(batch), index=batch.index)
                       for _, batch in X_test.groupby('ocean_proximity')])
print("re-fit on each region's batch: ", mae(by_region[X_test.index]))
one_by_one = [predict_bug1(X_test.iloc[[i]])[0] for i in range(len(X_test))]
print("re-fit on one district at a time:", mae(one_by_one),
      f"({len(set(one_by_one))} distinct prediction)")
re-fit on the whole test set:   $42,814
re-fit on each region's batch:  $65,754
re-fit on one district at a time: $116,049 (1 distinct prediction)
Três resultados, um só bug:
- No conjunto de teste inteiro o bug é invisível. 4.128 distritos sorteados têm quase as mesmas médias e desvios-padrão dos 16.512 distritos de treino, então reajustar quase não muda nada; o MAE sai até US$ 209 menor que o correto, por acaso. É por isso que o bug passa pela revisão de código: o notebook parece certo.
- Em lotes por região ele custa US$ 22.731 por distrito. Cada lote é recentrado em si mesmo. Os distritos do interior são medidos contra outros distritos do interior, então uma renda modesta para os padrões do estado vira "média"; a latitude e a longitude de cada lote são levadas para o centro do mapa. Os vizinhos que o modelo encontra deixam de ser os certos.
- Um distrito de cada vez, o modelo fica pior que inútil. Uma única linha tem dispersão zero, então toda coluna vira 0 (a tabelinha acima). Todo distrito vira o mesmo ponto, recebe os mesmos 10 vizinhos e a mesma previsão: um único valor para 4.128 distritos e um MAE de US$ 116.049, pior do que sempre prever a média.
Bug 2 — um passo esquecido na hora de prever
O código de treino e o código de previsão costumam ser escritos em momentos diferentes, por pessoas diferentes, às vezes em arquivos diferentes. Um passo que está em um e falta no outro é o segundo clássico:
print("scaler forgotten:", mae(model.predict(imputer.transform(X_test[num]))))
try:
    model.predict(scaler.transform(X_test[num]))           # imputador esquecido
except ValueError as err:
    print("imputer forgotten:", str(err).splitlines()[0])
Esquecer o imputador é o caso de sorte: os valores faltantes chegam ao modelo e ele os recusa com um erro. Esquecer o scaler é silencioso. O modelo recebe números crus (um total_rooms de 2.000 onde aprendeu valores de poucas unidades em torno de 0), calcula distâncias dominadas pelas colunas maiores e devolve uma previsão confiante para cada distrito. O MAE, US$ 105.978, é de novo pior do que prever a média; nada na tela avisa.
Bug 3 — outra ordem de colunas
O modelo recebe números, não nomes: a coluna 5 do array é "population" só porque era a coluna 5 no treino. Se os dados chegam em outra ordem (uma nova exportação do banco de dados, outro cliente da API), cada coluna recebe as estatísticas e os vizinhos de outra. Aqui duas colunas de contagem trocam de lugar:
swapped = ['longitude', 'latitude', 'housing_median_age', 'total_rooms',
           'total_bedrooms', 'households', 'population', 'median_income']   # as duas penúltimas trocadas
X_new = X_test[swapped]
print("swapped, sent as an array:", mae(model.predict(scaler.transform(imputer.transform(X_new.to_numpy())))))
try:
    imputer.transform(X_new)                                # enviado como DataFrame
except ValueError as err:
    print("swapped, sent as a DataFrame:", " ".join(str(err).splitlines()[:2]))
swapped, sent as an array: $101,517
swapped, sent as a DataFrame: The feature names should match those that were passed during fit. Feature names must be in the same order as they were in fit.
Como array, a troca custa US$ 101.517 por distrito. Um distrito tem cerca de três vezes mais moradores que domicílios, então a coluna "households" fica de repente três vezes maior do que qualquer coisa que o modelo viu e a coluna "population" três vezes menor. O único indício é um UserWarning ("X does not have valid feature names") no meio dos avisos de sempre do notebook. Como DataFrame, o scikit-learn compara os nomes das colunas com os que viu no fit e recusa. Mantenha os dados num DataFrame até o modelo e deixe o primeiro passo conferir os nomes.
A figura põe os seis resultados lado a lado (script da figura):
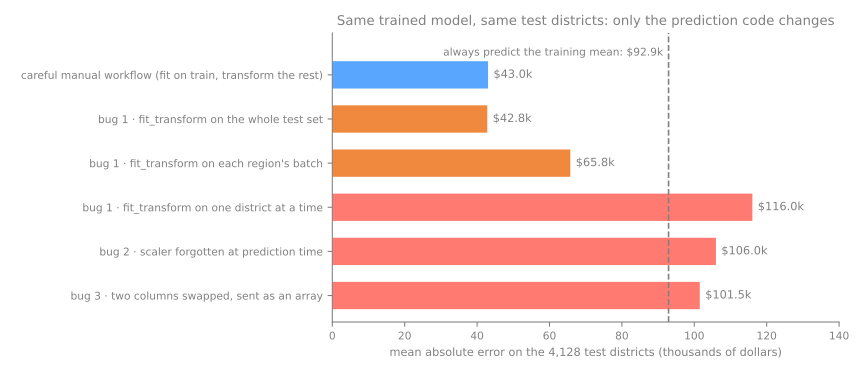
Três das seis barras são piores que o baseline que ignora os dados; a barra mais perigosa é a segunda, o bug que parece certo.
2. Pipeline: um estimador, vários passos
Etapa 2. Um Pipeline é uma lista de passos que se comporta como um único estimador. O make_pipeline monta um a partir dos passos e dá nome a eles automaticamente:
from sklearn.pipeline import make_pipeline

pipe = make_pipeline(SimpleImputer(strategy='median'), StandardScaler(),
                     KNeighborsRegressor(n_neighbors=10))
pipe.fit(X_train[num], y_train)            # todo passo aprende com as linhas de treino
pred_pipe = pipe.predict(X_test[num])      # todo passo reaplica o que aprendeu
print("MAE:", mae(pred_pipe), "· identical to the careful manual workflow:",
      np.array_equal(pred_pipe, pred))

one_by_one = [pipe.predict(X_test[num].iloc[[i]])[0] for i in range(len(X_test))]
print("one district at a time == all at once:", np.allclose(one_by_one, pred_pipe))
try:
    pipe.predict(X_new)                    # as colunas trocadas do bug 3
except ValueError as err:
    print("swapped columns:", str(err).splitlines()[0])
print(list(pipe.named_steps))
MAE: $43,023 · identical to the careful manual workflow: True
one district at a time == all at once: True
swapped columns: The feature names should match those that were passed during fit.
['simpleimputer', 'standardscaler', 'kneighborsregressor']
Duas chamadas, fit e predict, substituem sete. As previsões são exatamente as do fluxo manual cuidadoso e os três bugs somem por construção:
- Bug 1. O
pipe.predictnunca chamafitnum transformador, então o tamanho do lote deixa de importar: 4.128 previsões feitas um distrito por vez são idênticas às 4.128 feitas de uma vez. - Bug 2. Não existe código de previsão separado em que esquecer um passo. Os passos viajam dentro do objeto.
- Bug 3. O pipeline entrega o DataFrame ao primeiro passo, que confere os nomes das colunas e recusa a tabela trocada.
As regras de composição são poucas. Todo passo exceto o último precisa ser um transformador (tem fit e transform); o último pode ser qualquer coisa com fit, em geral um modelo com predict. O pipeline então expõe os métodos do último passo: pipe.predict, pipe.score e, para um classificador, pipe.predict_proba.
O que fit e predict fazem, passo a passo
O pipe.fit(X, y) percorre a lista de cima para baixo. Cada transformador é ajustado no que recebe e em seguida o transforma (fit_transform); sua saída é a entrada do passo seguinte; o último passo é só ajustado. O pipe.predict(X) percorre a mesma lista chamando apenas transform (com os parâmetros congelados no ajuste) e termina com o predict do modelo. A coluna de brinquedo do bug 1, desenhada como pipeline (script da figura):
Para ver isso acontecer nos dados reais, coloque entre os passos de verdade um passo que não faz nada e relata o que vê (como escrever uma classe assim é o assunto de seus próprios passos, na abordagem avançada). Ele imprime o formato dos dados e, para a coluna total_bedrooms, o número de faltantes e a média naquele ponto:
from sklearn.base import BaseEstimator, TransformerMixin

class Spy(BaseEstimator, TransformerMixin):
    """Um passo que não muda nada e relata o que passa por ele."""
    def __init__(self, label=''):
        self.label = label

    def fit(self, X, y=None):
        self._report('fit', X)
        return self

    def transform(self, X):
        self._report('transform', X)
        return X

    def _report(self, call, X):
        X = np.asarray(X, dtype=float)
        col = X[:, 4]                                            # total_bedrooms
        print(f"  {self.label:8s} {call:9s} {str(X.shape):11s} "
              f"missing {np.isnan(col).sum():3d} · mean {np.nanmean(col):7.2f}")

traced = make_pipeline(Spy('raw'), SimpleImputer(strategy='median'), Spy('imputed'),
                       StandardScaler(), Spy('scaled'), KNeighborsRegressor(n_neighbors=10))
print("traced.fit(X_train, y_train)")
traced.fit(X_train[num], y_train)
print("traced.predict(X_test)")
_ = traced.predict(X_test[num])
traced.fit(X_train, y_train)
  raw      fit       (16512, 8)  missing 163 · mean  538.92
  raw      transform (16512, 8)  missing 163 · mean  538.92
  imputed  fit       (16512, 8)  missing   0 · mean  537.92
  imputed  transform (16512, 8)  missing   0 · mean  537.92
  scaled   fit       (16512, 8)  missing   0 · mean    0.00
  scaled   transform (16512, 8)  missing   0 · mean    0.00
traced.predict(X_test)
  raw      transform (4128, 8)   missing  44 · mean  533.66
  imputed  transform (4128, 8)   missing   0 · mean  532.63
  scaled   transform (4128, 8)   missing   0 · mean   -0.01
Leia de cima para baixo:
- Durante o
fit, só existem linhas de treino. Todo passo vê 16.512 linhas, nunca 4.128. Cada passo é ajustado e logo em seguida transforma (os paresfit+transform), porque o passo seguinte precisa ser ajustado em dados de treino já transformados: o scaler aprende a média a partir dos valores imputados (537,92), não dos crus com buracos. - O imputador preenche 163 buracos com a mediana do treino, o que baixa a média da coluna em 1 quarto, de 538,92 para 537,92: a mediana (437) fica abaixo da média porque a coluna tem uma cauda longa à direita.
- Durante o
predict, ninguém chamafit. Os 44 buracos do conjunto de teste são preenchidos com a mediana do treino e o scaler subtrai a média do treino. É por isso que a coluna de teste padronizada tem média −0,01 e não exatamente 0: as linhas de teste são medidas com a régua das linhas de treino, que é o procedimento honesto. Uma média de exatamente 0,00 no teste seria o sintoma do bug 1.
Pipeline ou make_pipeline
O make_pipeline dá a cada passo o nome da sua classe, em minúsculas: 'simpleimputer', 'standardscaler', 'kneighborsregressor' (e 'spy-1', 'spy-2', ... quando uma classe se repete). No Pipeline, você mesmo dá os nomes, como uma lista de pares (nome, passo):
from sklearn.pipeline import Pipeline

pipe_named = Pipeline([('impute', SimpleImputer(strategy='median')),
                       ('scale', StandardScaler()),
                       ('model', KNeighborsRegressor(n_neighbors=10))])
Os dois produzem o mesmo tipo de objeto; os nomes só importam quando você se refere a um passo depois (para inspecioná-lo ou mudar uma configuração dele). Nomes curtos e explícitos valem a pena em pipelines longos.
3. Colunas heterogêneas: ColumnTransformer
Etapa 3. Um pipeline aplica todo passo a todas as colunas. Tabelas reais precisam de tratamentos diferentes para colunas diferentes: aqui os oito números precisam da mediana e do scaler, enquanto ocean_proximity, uma coluna de texto, precisa de one-hot. Um ColumnTransformer manda cada grupo de colunas para o seu próprio ramo e põe os resultados lado a lado:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

preprocess = ColumnTransformer([
    ('num', make_pipeline(SimpleImputer(strategy='median'), StandardScaler()), num),
    ('cat', OneHotEncoder(handle_unknown='ignore', sparse_output=False), ['ocean_proximity']),
])
full = make_pipeline(preprocess, KNeighborsRegressor(n_neighbors=10))
full.fit(X_train, y_train)                 # entra a tabela crua de 9 colunas
print("MAE with ocean_proximity:", mae(full.predict(X_test)))
print(preprocess.get_feature_names_out())
MAE with ocean_proximity: $41,552
['num__longitude' 'num__latitude' 'num__housing_median_age'
 'num__total_rooms' 'num__total_bedrooms' 'num__population'
 'num__households' 'num__median_income' 'cat__ocean_proximity_<1H OCEAN'
 'cat__ocean_proximity_INLAND' 'cat__ocean_proximity_ISLAND'
 'cat__ocean_proximity_NEAR BAY' 'cat__ocean_proximity_NEAR OCEAN']
Cada ramo é uma tripla (nome, transformador, colunas); um ramo pode ser ele mesmo um pipeline, como o 'num'. O conjunto todo é um único transformador e, portanto, entra num pipeline como qualquer outro passo. O modelo agora recebe a tabela crua de 9 colunas: a coluna de texto deixa de ser um problema e usá-la baixa o MAE de US$ 43.023 para US$ 41.552.
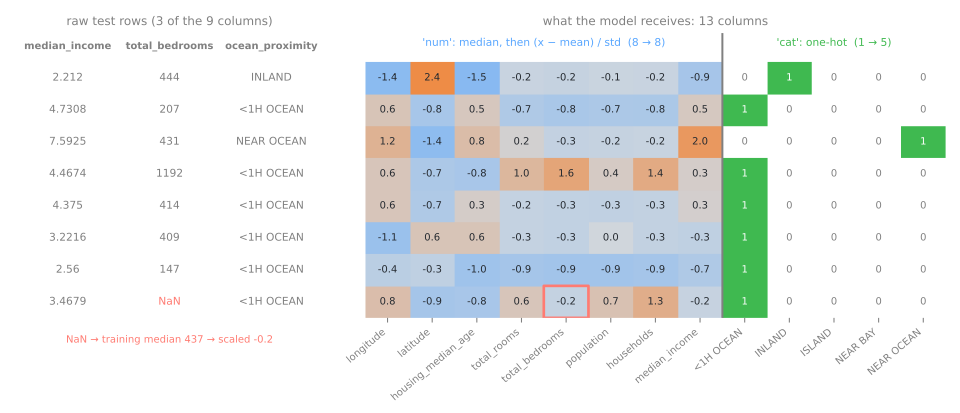
O get_feature_names_out diz o que é cada coluna de saída. O prefixo é o nome do ramo que a produziu (num__, cat__); as colunas do one-hot trazem a categoria (cat__ocean_proximity_INLAND). Sem isso, a entrada do modelo é um bloco de 13 colunas de números anônimos. O que realmente sai, para oito distritos de teste (script da figura):
Que colunas vão para onde: listas, remainder, seletores
As colunas que nenhum ramo menciona são descartadas por padrão (remainder='drop'). Com remainder='passthrough' elas são anexadas sem mudança:
two = ColumnTransformer([('num', StandardScaler(), ['median_income', 'housing_median_age'])])
print("remainder='drop':       ", two.fit_transform(X_train).shape)
two_plus = ColumnTransformer([('num', StandardScaler(), ['median_income', 'housing_median_age'])],
                             remainder='passthrough')
print("remainder='passthrough':", two_plus.fit_transform(X_train).shape)
print(two_plus.get_feature_names_out()[:4])
remainder='drop':        (16512, 2)
remainder='passthrough': (16512, 9)
['num__median_income' 'num__housing_median_age' 'remainder__longitude'
 'remainder__latitude']
O 'drop' é o padrão seguro: uma coluna de identificador ou um campo de texto livre de que você se esqueceu nunca chega ao modelo em silêncio. O 'passthrough' é para colunas que já estão prontas. Aqui seria um erro, porque as sete colunas repassadas chegam sem escala (e ocean_proximity chega como texto).
Em vez de listas de nomes, um ramo pode receber um seletor, que escolhe as colunas pelo tipo quando o transformador é ajustado:
from sklearn.compose import make_column_selector

by_type = ColumnTransformer([
    ('num', make_pipeline(SimpleImputer(strategy='median'), StandardScaler()),
     make_column_selector(dtype_include='number')),
    ('cat', OneHotEncoder(handle_unknown='ignore', sparse_output=False),
     make_column_selector(dtype_exclude='number')),
])
by_type.fit(X_train)
for name, _, columns in by_type.transformers_:
    print(name, columns)
num ['longitude', 'latitude', 'housing_median_age', 'total_rooms', 'total_bedrooms', 'population', 'households', 'median_income']
cat ['ocean_proximity']
O transformador ajustado (transformers_, com o sublinhado no final) registra as colunas que cada seletor escolheu. Seletores são práticos em tabelas largas, mas confiam nos tipos: um CEP guardado como número cai no ramo numérico. Listas explícitas dão mais trabalho, mas dizem exatamente o que acontece.
Vendo a saída: nomes das colunas e set_output
Por padrão um transformador devolve um array do NumPy. O set_output(transform='pandas') faz com que ele devolva um DataFrame com os nomes do get_feature_names_out como colunas, que é o jeito mais fácil de conferir um pré-processamento a olho:
                                 20046  3024   15663
num__longitude                   -1.41   0.60   1.16
num__latitude                     2.36  -0.84  -1.36
num__housing_median_age          -1.47   0.51   0.82
num__total_rooms                 -0.17  -0.67   0.21
num__total_bedrooms              -0.23  -0.80  -0.26
num__population                  -0.14  -0.73  -0.22
num__households                  -0.16  -0.76  -0.18
num__median_income               -0.87   0.45   1.96
cat__ocean_proximity_<1H OCEAN    0.00   1.00   0.00
cat__ocean_proximity_INLAND       1.00   0.00   0.00
cat__ocean_proximity_ISLAND       0.00   0.00   0.00
cat__ocean_proximity_NEAR BAY     0.00   0.00   0.00
cat__ocean_proximity_NEAR OCEAN   0.00   0.00   1.00
Três distritos de teste, transpostos para que cada coluna da saída seja uma linha aqui. O distrito 20046 fica no interior, 2,36 desvios-padrão ao norte do distrito de treino médio, com renda 0,87 desvio-padrão abaixo da média. O índice do DataFrame é preservado, então toda linha transformada pode ser rastreada até a sua linha crua. (A saída em pandas exige arrays densos, daí o sparse_output=False no encoder.)
Robusto à ordem das colunas e a categorias novas
Um ColumnTransformer ajustado num DataFrame escolhe suas colunas pelo nome, então o bug 3 desaparece de vez, em vez de virar um erro. E um encoder com handle_unknown='ignore' transforma uma categoria que nunca viu numa linha de zeros em vez de quebrar:
reversed_cols = X_test[X_test.columns[::-1]]              # mesmas colunas, ordem inversa
print("reversed columns, same predictions:", np.array_equal(full.predict(reversed_cols), full.predict(X_test)))
new = X_test.head(1).assign(ocean_proximity='LAKE')        # uma categoria nunca vista no treino
print(preprocess.transform(new).filter(like='ocean').to_numpy(), full.predict(new).round())
Com as nove colunas em ordem inversa, as previsões são idênticas. O distrito rebatizado de 'LAKE' recebe zeros nas cinco colunas de ocean_proximity e uma previsão, US$ 90.030, igual à que recebe com o seu rótulo verdadeiro, INLAND: seus 10 vizinhos mais próximos estão tão perto nos oito números que perder uma coluna de categoria não os mudou. Sem handle_unknown='ignore', a mesma linha levantaria ValueError: Found unknown categories; um valor novo em produção derrubaria o serviço inteiro. Categorias raras tornam isso provável mesmo sem erros de digitação: ISLAND tem 5 distritos na tabela inteira e, com este split, todos caíram no treino.
4. O vazamento que um pipeline evita
Etapa 4. A aula de pré-processamento afirmou que ajustar um passo em todos os dados antes da divisão vaza informação do conjunto de teste. Quanto depende do que o passo aprende. Compare dois passos.
O primeiro é o scaler. Vinte splits diferentes, cada um feito duas vezes: uma com o imputador e o scaler ajustados nos 20.640 distritos antes da divisão, outra dentro do pipeline. O segundo é um passo que aprende com o alvo: um target encoder, que troca cada categoria de uma coluna pela média do alvo naquela categoria nos dados de treino. É a ferramenta padrão para uma coluna categórica com milhares de valores, em que o one-hot criaria milhares de colunas. A tabela não tem uma coluna assim, então construímos uma a partir das coordenadas, arredondadas para duas casas decimais (células de cerca de 1 km, fazendo o papel de um CEP):
from sklearn.preprocessing import TargetEncoder

zone = housing['latitude'].round(2).astype(str) + '_' + housing['longitude'].round(2).astype(str)
Z = X[['median_income', 'housing_median_age']].assign(zone=zone)   # células de ~1 km, como um CEP
Z_train, Z_test = Z.loc[X_train.index], Z.loc[X_test.index]
print(zone.nunique(), "zones ·", (zone.value_counts() == 1).sum(), "with a single district ·",
      f"{(~Z_test['zone'].isin(Z_train['zone'])).mean():.0%} of test zones unseen in training")

# VAZAMENTO: o encoder aprende o preço médio de cada zona com TODAS as linhas, inclusive as de teste
enc = TargetEncoder(target_type='continuous', random_state=0).fit(Z[['zone']], y)
def encode(D):
    return D.drop(columns='zone').assign(zone_price=enc.transform(D[['zone']])[:, 0])
leaky = make_pipeline(StandardScaler(), KNeighborsRegressor(n_neighbors=10))
leaky.fit(encode(Z_train), y_train)
print("encoder fit on all rows:    ", mae(leaky.predict(encode(Z_test))))

# HONESTO: o encoder é um passo do pipeline, então só vê preços de treino
honest = make_pipeline(
    ColumnTransformer([('zone', TargetEncoder(target_type='continuous', random_state=0), ['zone'])],
                      remainder='passthrough'),
    StandardScaler(), KNeighborsRegressor(n_neighbors=10))
honest.fit(Z_train, y_train)
print("encoder inside the pipeline:", mae(honest.predict(Z_test)))
no_zone = make_pipeline(StandardScaler(), KNeighborsRegressor(n_neighbors=10))
no_zone.fit(Z_train.drop(columns='zone'), y_train)
print("no zone at all:             ", mae(no_zone.predict(Z_test.drop(columns='zone'))))
12590 zones · 8237 with a single district · 44% of test zones unseen in training
encoder fit on all rows:     $14,567
encoder inside the pipeline: $42,552
no zone at all:              $60,383
A versão com vazamento reporta um MAE de US$ 14.567, quase três vezes menor que qualquer outro erro desta aula, a partir de duas colunas e um código de zona. O mecanismo é simples. 8.237 das 12.590 zonas têm um único distrito. Quando o encoder é ajustado em todas as linhas, o "preço médio da zona" de um distrito de teste desses é o próprio preço dele (puxado um pouco em direção à média geral pela suavização do encoder) e o modelo lê a resposta na própria entrada. Dentro do pipeline o encoder só vê preços de treino: 44% dos distritos de teste caem em zonas que ele nunca viu e recebem a média geral; os outros recebem a média de outros distritos da sua zona. O MAE honesto é US$ 42.552. A zona continua útil (sem ela, US$ 60.383), só não é mágica.
(Um detalhe deste encoder: no fit_transform, que é o que um pipeline chama durante o fit, o TargetEncoder codifica cada linha de treino com médias calculadas sem aquela linha, usando uma divisão interna. Isso impede o modelo de aprender a confiar demais na codificação. O fit seguido de transform, como na versão com vazamento, não faz isso.)
Repetido em 20 splits, o contraste entre os dois tipos de passo é estável (script da figura):
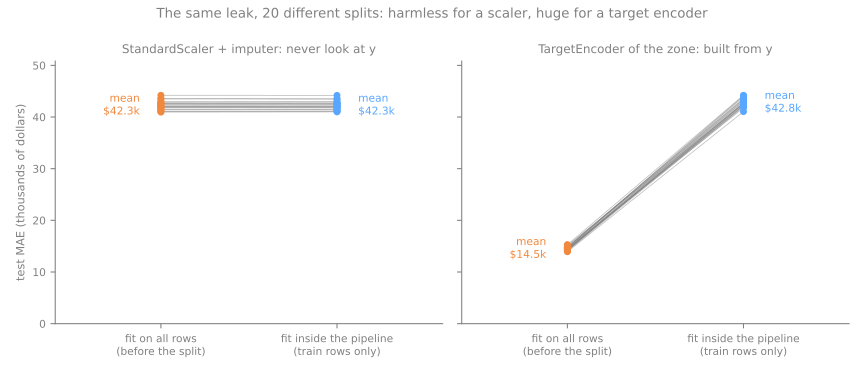
Para o scaler, o vazamento muda o MAE em US$ 4 na média e em no máximo US$ 96 em qualquer split: a média e o desvio-padrão de 16.512 ou de 20.640 distritos são praticamente os mesmos números; além disso, o scaler nunca olha para o preço. Para o target encoder, o vazamento faz o erro parecer US$ 28.300 menor na média e pelo menos US$ 27.100 menor em todo split. A regra que sai daqui não é "scalers são seguros". É: você não tem como saber o tamanho de um vazamento sem medir as duas versões; com todo passo ajustado dentro do pipeline, não há nada a medir. Quanto mais um passo usa o alvo (target encoding, seleção de atributos, sobreamostragem), maior o vazamento possível; a aula de validação cruzada e vazamento de dados mede outros.
A coluna de brinquedo do bug 1 mostra o mecanismo em miniatura. Ajuste os mesmos dois passos nas sete linhas, as cinco de treino e as duas novas, como faria um fluxo com vazamento antes da divisão:
toy_all = pd.concat([toy_train, toy_new])                  # as 5 linhas de treino + as 2 novas
leaky_toy = make_pipeline(SimpleImputer(strategy='median'), StandardScaler()).fit(toy_all)
print("learned on all 7 rows: median", leaky_toy[0].statistics_,
      "mean", leaky_toy[1].mean_.round(2), "std", leaky_toy[1].scale_.round(2))
print("new rows:", leaky_toy.transform(toy_new).ravel().round(2), "instead of [0. 2.]")
learned on all 7 rows: median [600.] mean [585.71] std [216.65]
new rows: [0.07 1.45] instead of [0. 2.]
A mediana vai de 500 para 600, a média de 500 para 585,71 e o desvio-padrão de 200 para 216,65, porque o 900, acima de todo valor de treino, agora faz parte da régua que o mede. O distrito de 900 quartos sai 1,45 desvio-padrão acima da média em vez de 2: parece menos incomum do que é. O terceiro modo do simulador passo a passo percorre esses números. Aqui as duas linhas novas são 2 de 7 e uma delas é extrema, então o vazamento aparece; 4.128 distritos sorteados entre 20.640 se parecem com os outros e o vazamento do scaler encolhe para os US$ 4 medidos acima.
Uma coluna só basta para ver por que o scaler quase não vazou numa divisão aleatória e quando ele deixaria de ser inofensivo. O simulador ajusta os dois passos da aula (imputação pela mediana, depois o scaler) numa coluna com buracos, de um de dois jeitos: só nas linhas de treino (como o pipeline faz) ou em todas as linhas antes da divisão. Compare os dois modos numa divisão aleatória; depois troque o teste por um período posterior, em que os preços subiram.
Numa divisão aleatória as linhas de teste se parecem com as de treino, então somá-las ao fit quase não muda as estatísticas: é o vazamento pequeno do scaler, medido acima. Quando o teste vem de um período posterior, a média e o desvio-padrão vazados já contêm os preços novos: o deslocamento parece menor do que é e os buracos preenchidos ficam um pouco mais perto da verdade (a mediana resiste a uma minoria de valores altos). O modelo não melhorou em nada; só a avaliação melhorou. Dentro do pipeline, as linhas de teste nunca participam de um fit, seja qual for a divisão.
5. Resumo: a regra, mantida por um objeto
- Todo passo que aprende (a mediana de um imputador, a média e o desvio-padrão de um scaler, as categorias de um encoder) é ajustado só nas linhas de treino e reaplicado, sem mudança, a toda outra linha.
- À mão, a regra quebra de três jeitos clássicos: reajustar nas linhas que se está prevendo (invisível num conjunto de teste grande, US$ 116.049 um distrito por vez), um passo esquecido na hora de prever (silencioso, US$ 105.978) e outra ordem de colunas (US$ 101.517 quando enviadas como array).
- Um
Pipelineajusta cada passo na saída do anterior comfit_transforme, na hora de prever, só chamatransform. As previsões são as mesmas do código manual cuidadoso e os três bugs somem por construção. - Um
ColumnTransformerdá a cada grupo de colunas o seu próprio ramo, escolhe as colunas pelo nome e descarta o que nenhum ramo menciona; ohandle_unknown='ignore'transforma uma categoria nova em zeros em vez de um erro. - O tamanho de um vazamento depende do que o passo aprende: US$ 4 para um scaler, US$ 28.300 para um target encoder, nos mesmos dados. Com todo passo ajustado dentro do pipeline, não há nada a medir.
| sintoma | o que está acontecendo | o que fazer |
|---|---|---|
| bom no notebook, ruim em produção | um passo se reajusta em cada lote que prevê (bug 1) | ajustar uma vez, dentro de um pipeline; o predict só transforma |
| previsão confiante, nenhum erro, nota ruim | falta um passo no código de previsão (bug 2) | entregar o pipeline inteiro, não só o modelo |
X does not have valid feature names | um array em outra ordem de colunas (bug 3) | manter um DataFrame até o modelo |
| nota muito melhor que o esperado | um passo viu as linhas de teste, pior ainda se ele aprende com o alvo | pôr todo passo ajustado dentro do pipeline |
Found unknown categories em produção | um encoder encontra uma categoria que nunca viu | OneHotEncoder(handle_unknown='ignore') |
Lab fundamental — das linhas cruas do Titanic a uma nota honesta
O roteiro de pré-processamento terminou com um ColumnTransformer que transforma os 891 passageiros crus do Titanic numa matriz de números, sem treinar modelo nenhum. Este lab termina o trabalho: o mesmo tipo de pré-processamento, agora num pipeline com um modelo no final, ajustado nas linhas de treino, avaliado uma vez nas linhas de teste e aberto para conferir de onde veio cada valor aprendido. Abrir, salvar e estender o pipeline fica para o lab avançado. O modelo é de novo uma caixa-preta, um classificador k-NN com as configurações padrão (ele prevê "sobreviveu" quando a maioria dos 5 passageiros de treino mais parecidos sobreviveu; veja k-NN).
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Baixe o notebook do lab e abra no Jupyter ou no Colab (File → Upload notebook). Rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 5 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 6.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 a 3 em 10 min; passo 4 e a primeira simulação em 10 min; passo 5 e a segunda simulação em 10 min.
Passo 1 — carregar e olhar
Preveja. Que colunas de uma lista crua de passageiros você espera que tenham buracos? Quais delas um modelo não conseguiria usar como estão?
import numpy as np
import pandas as pd

url = "https://raw.githubusercontent.com/hsandmann/biblio/refs/heads/main/ml/aula04/titanic/train.csv"
df = pd.read_csv(url)
print(df.shape)
print("missing:", df.isna().sum()[lambda s: s > 0].to_dict())
print(df[['Name', 'Sex', 'Age', 'Fare', 'Cabin', 'Embarked']].head(3).to_string())
(891, 12)
missing: {'Age': 177, 'Cabin': 687, 'Embarked': 2}
                                                  Name     Sex   Age     Fare Cabin Embarked
0                              Braund, Mr. Owen Harris    male  22.0   7.2500   NaN        S
1  Cumings, Mrs. John Bradley (Florence Briggs Thayer)  female  38.0  71.2833   C85        C
2                               Heikkinen, Miss. Laina  female  26.0   7.9250   NaN        S
891 passageiros e 12 colunas: identificadores (PassengerId, Name, Ticket), números (Age, SibSp, Parch, Fare), categorias guardadas como texto ou como número (Sex, Embarked, Pclass), a cabine e o alvo Survived. Três colunas têm buracos: Age em 177 linhas (20%), Cabin em 687 (77%) e Embarked em 2. As três primeiras linhas já mostram tudo o que o pré-processamento precisa tratar: texto, NaN e tarifas numa escala assimétrica (7,25 contra 71,28). Nada é limpo à mão. O pipeline recebe esta tabela como ela é, agora e em produção.
Passo 2 — dividir uma vez
Preveja. Com stratify=y, quão próximas vão ficar as taxas de sobrevivência das linhas de treino e de teste? Por que manter em X colunas que o modelo nunca vai usar, como Name e Ticket?
from sklearn.model_selection import train_test_split

X = df.drop(columns='Survived')              # as 11 colunas cruas, com texto e buracos
y = df['Survived']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=42)
print(X_train.shape, X_test.shape)
print(f"survival rate: train {y_train.mean():.3f} · test {y_test.mean():.3f}")
712 passageiros para treinar e 179 para testar, os dois com taxa de sobrevivência de cerca de 38% graças ao stratify. O X mantém as 11 colunas cruas, inclusive as que o modelo não vai usar: decidir o que usar é trabalho do pipeline; assim, a tabela entregue a ele na hora de prever pode ser a mesma tabela crua. As linhas de teste não são tocadas até a nota do passo 4.
Passo 3 — o pré-processamento, coluna por coluna
Preveja. Quais das 11 colunas cruas vão chegar ao modelo e o que acontece com as que nenhum ramo menciona? Alguma coisa foi ajustada quando esta célula termina?
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline, make_pipeline
from sklearn.preprocessing import FunctionTransformer, OneHotEncoder, StandardScaler

preprocess = ColumnTransformer([
    ('num',  make_pipeline(SimpleImputer(strategy='median'), StandardScaler()),
             ['Age', 'SibSp', 'Parch']),
    ('fare', make_pipeline(SimpleImputer(strategy='median'),
                           FunctionTransformer(np.log1p, feature_names_out='one-to-one'),
                           StandardScaler()),
             ['Fare']),
    ('cat',  make_pipeline(SimpleImputer(strategy='most_frequent'),
                           OneHotEncoder(handle_unknown='ignore', sparse_output=False)),
             ['Pclass', 'Sex', 'Embarked']),
])
model = Pipeline([('prep', preprocess), ('knn', KNeighborsClassifier())])

used = [c for _, _, cols in preprocess.transformers for c in cols]
for name, _, cols in preprocess.transformers:
    print(f"{name:4s} <- {cols}")
print("dropped by remainder='drop':", [c for c in X.columns if c not in used])
num  <- ['Age', 'SibSp', 'Parch']
fare <- ['Fare']
cat  <- ['Pclass', 'Sex', 'Embarked']
dropped by remainder='drop': ['PassengerId', 'Name', 'Ticket', 'Cabin']
Três ramos, como no roteiro: os números recebem a mediana e o scaler; a tarifa, muito assimétrica, recebe a mediana, depois \(\log(1 + x)\), depois o scaler; as categorias recebem o valor mais frequente e o one-hot (Pclass é tratada como categoria, sem supor que a 2ª classe fica "no meio" entre a 1ª e a 3ª). O laço imprime o roteamento. As quatro colunas que nenhum ramo menciona são descartadas pelo remainder='drop': os três identificadores e Cabin. Elas estão em X e nunca vão chegar ao modelo. Nada foi ajustado ainda: model é uma receita. No Jupyter, uma célula só com model o desenha como diagrama.
Passo 4 — ajustar no treino, avaliar no teste
Preveja. Quantas chamadas fit separadas o único model.fit dispara? Um k-NN com as configurações padrão vai superar o baseline "sempre não sobreviveu" por muito ou por pouco?
from sklearn.dummy import DummyClassifier

model.fit(X_train, y_train)
baseline = DummyClassifier(strategy='most_frequent').fit(X_train, y_train)
print(f"test accuracy · pipeline {model.score(X_test, y_test):.3f} · "
      f"always 'did not survive' {baseline.score(X_test, y_test):.3f}")
Uma chamada a fit ajusta três imputadores, dois scalers, o passo do logaritmo, o encoder e o classificador, na ordem certa, todos nos 712 passageiros de treino. Nos 179 passageiros de teste o pipeline acerta 78,2% das vezes, contra 61,5% de um "modelo" que sempre responde a classe majoritária. Não havia nada a ajustar (o classificador fica com as configurações padrão), então o conjunto de teste é usado uma vez, aqui.
Simulação: a mesma receita sem os scalers. Monte um segundo ColumnTransformer em que os ramos 'num' e 'fare' ficam só com o imputador (sem logaritmo nem scaler), ponha-o num pipeline com o mesmo KNeighborsClassifier(), ajuste nas linhas de treino e compare a acurácia de teste com o 0,782 do pipeline. Que coluna domina as distâncias quando nada é padronizado?
Solução
bare = ColumnTransformer([
    ('num',  SimpleImputer(strategy='median'), ['Age', 'SibSp', 'Parch']),     # sem scaler
    ('fare', SimpleImputer(strategy='median'), ['Fare']),                       # sem log nem scaler
    ('cat',  make_pipeline(SimpleImputer(strategy='most_frequent'),
                           OneHotEncoder(handle_unknown='ignore', sparse_output=False)),
             ['Pclass', 'Sex', 'Embarked']),
])
unscaled = Pipeline([('prep', bare), ('knn', KNeighborsClassifier())]).fit(X_train, y_train)
print(f"test accuracy · with scalers {model.score(X_test, y_test):.3f} · without {unscaled.score(X_test, y_test):.3f}")
Sem os scalers a acurácia cai de 0,782 para 0,676, pouco acima dos 0,615 do baseline. As tarifas vão de 0 a mais de £ 500 e as idades até 80, enquanto as colunas do one-hot valem 0 ou 1; assim, as distâncias do k-NN ficam dominadas pela tarifa e pela idade: uma diferença de 1 na coluna do sexo pesa tanto quanto uma diferença de £ 1 na tarifa. Mudar a receita exigiu uma edição num só lugar e as duas versões foram ajustadas nas mesmas linhas de treino. É um experimento para entender por que os scalers estão ali, não um jeito de escolher modelo: o conjunto de teste não serve para escolher.
Passo 5 — o que cada passo aprendeu
Preveja. A mediana da idade dos 891 passageiros é 28,0. O imputador dentro do pipeline aprendeu 28,0 ou outro número? Quantas linhas o scaler viu?
prep = model.named_steps['prep']
num_imputer, num_scaler = prep.named_transformers_['num']
print("Age, SibSp, Parch medians:", num_imputer.statistics_)
print("means after imputing:     ", num_scaler.mean_.round(3))
print("standard deviations:      ", num_scaler.scale_.round(3))
print("rows the scaler saw:      ", num_scaler.n_samples_seen_)
print("Age median, train only vs all 891 rows:", X_train['Age'].median(), "vs", X['Age'].median())
fare_imputer, _, fare_scaler = prep.named_transformers_['fare']
print(f"Fare: median {fare_imputer.statistics_[0]:.2f} · mean of log1p(Fare) {fare_scaler.mean_[0]:.3f}")
print("categories:", [c.tolist() for c in prep.named_transformers_['cat'][-1].categories_])
Age, SibSp, Parch medians: [28.5  0.   0. ]
means after imputing:      [29.556  0.493  0.39 ]
standard deviations:       [13.016  1.06   0.838]
rows the scaler saw:       712.0
Age median, train only vs all 891 rows: 28.5 vs 28.0
Fare: median 14.45 · mean of log1p(Fare) 2.951
categories: [[1, 2, 3], ['female', 'male'], ['C', 'Q', 'S']]
Todo valor aprendido pode ser lido e cada um prova onde foi aprendido:
- A mediana da idade é 28,5, não 28,0. 28,0 é a mediana dos 891 passageiros; 28,5 é a mediana dos 712 passageiros de treino. O imputador nunca viu as linhas de teste. O
n_samples_seen_confirma para o scaler: 712. - O scaler aprendeu com valores imputados. A idade média, 29,556, é a média das idades de treino depois que os buracos foram preenchidos com 28,5, porque o pipeline ajusta cada passo na saída do anterior.
- O ramo da tarifa aprendeu nas suas próprias unidades. O imputador dele aprendeu uma tarifa mediana de £ 14,45 e o scaler aprendeu a média de \(\log(1 + \text{tarifa})\), 2,951, porque o scaler fica depois do logaritmo.
- O encoder aprendeu três listas de categorias. Qualquer outro valor na hora de prever é "desconhecido" (passo 7).
Simulação: o pré-processamento ajustado nos 891 passageiros. Reproduza no Titanic o vazamento da seção 4: ajuste uma cópia de preprocess em todo o X (use o clone de sklearn.base), ajuste um KNeighborsClassifier() só nas linhas de treino transformadas e avalie nas linhas de teste transformadas. Que mediana de idade a cópia aprende? A acurácia de teste muda? Depois ajuste uma cópia do model inteiro nas 891 linhas e avalie nas linhas de teste.
Solução
from sklearn.base import clone

prep_all = clone(preprocess).fit(X)                     # VAZAMENTO: o pré-processamento vê as 891 linhas
knn_all = KNeighborsClassifier().fit(prep_all.transform(X_train), y_train)
print("Age median learned on all rows:", prep_all.named_transformers_['num'][0].statistics_[0])
print(f"test accuracy · honest {model.score(X_test, y_test):.3f} · "
      f"preprocessing fit on all rows {knn_all.score(prep_all.transform(X_test), y_test):.3f}")
whole = clone(model).fit(X, y)                          # muito pior: o classificador vê as linhas de teste
print(f"whole pipeline fit on all rows: {whole.score(X_test, y_test):.3f}")
Age median learned on all rows: 28.0
test accuracy · honest 0.782 · preprocessing fit on all rows 0.782
whole pipeline fit on all rows: 0.860
A cópia com vazamento aprende a mediana dos 891 passageiros, 28,0, e a acurácia de teste não se mexe: 0,782 nos dois casos. É de novo o scaler da seção 4, um vazamento pequeno demais para aparecer numa divisão aleatória, e é exatamente por isso que ninguém o nota. Ajustar o pipeline inteiro em todas as linhas é outra história: 0,860, porque agora o k-NN guarda os 179 passageiros de teste e encontra cada um entre os seus próprios 5 vizinhos. Nenhum dos dois números é uma estimativa honesta. Só o primeiro vazamento é o que um pipeline evita em silêncio; o segundo é a razão de as linhas de teste ficarem trancadas.
Para fechar a parte fundamental. Em uma frase cada: (1) por que o bug que reajusta um scaler no conjunto de teste é o mais perigoso dos três? (2) O que o model.predict faz com cada transformador e por que isso torna o tamanho do lote irrelevante? (3) Por que ajustar o scaler em todas as linhas quase não mudou a nota, enquanto o target encoder a fez parecer cerca de três vezes melhor?
Sua vez (fundamental)
Para casa:
- À mão. Uma coluna tem valores de treino 10, NaN, 30, 50 e valores novos NaN, 70. Calcule a mediana, a média e o desvio-padrão que
SimpleImputer(strategy='median')seguido deStandardScaler()aprendem, bem como os dois valores novos transformados. Confira com um pipeline. Depois calcule o que ofit_transformnas duas linhas novas daria. - O bug 1 com outro scaler. Repita o experimento dos lotes por região do bug 1 com
MinMaxScalerno lugar deStandardScaler, no modelo e no bug. O estrago fica maior ou menor? Que estatística de um lote o min–max reaprende? Por que ela é mais frágil que uma média? - O tamanho de um vazamento. Repita o experimento do target encoding da seção 4 com zonas arredondadas para uma casa decimal (cerca de 10 km) em vez de duas. Quantas zonas têm um único distrito agora? A distância entre o MAE com vazamento e o honesto cresce ou diminui? Por quê?
- Quebre de propósito. Faça previsões em
X_testcom as colunas em ordem inversa; emX_test.to_numpy(); e emX_test.drop(columns='Cabin'). Quais das três funcionam e quais falham? O que no pipeline explica cada resultado?
Abordagem avançada
A parte fundamental construiu um objeto honesto e mediu o que ele evita. Esta parte o abre: lê o que cada passo aprendeu e salva a cadeia inteira como um arquivo, acrescenta passos seus, sem nada a aprender ou com um estado aprendido nas linhas de treino, e alcança pelo nome cada configuração de cada passo, que é do que uma busca precisa. Os blocos de código continuam os das seções 1 a 4.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. abrir e salvar o pipeline ajustado; 2. passos seus, sem estado e com estado; 3. ajustar através dele, com os nomes passo__parametro. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Abrir e salvarpassos pelo nome, valores aprendidos, um arquivo
- Passos seusFunctionTransformer e uma classe que aprende
- Ajustar através delepasso__parametro e set_params
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
6. Inspeção e persistência
Etapa 1. Um pipeline ajustado é um contêiner que você pode abrir. Os passos são acessados pelo nome (named_steps) ou pela posição, com a mesma indexação de uma lista do Python; uma fatia é um pipeline menor:
print(list(full.named_steps))
print(full[-1])                                           # indexação, como numa lista
print(full.named_steps['columntransformer'].named_transformers_['num'][0].statistics_.round(1))
print(full[:-1].transform(X_test.head(2)).shape)          # tudo menos o modelo
['columntransformer', 'kneighborsregressor']
KNeighborsRegressor(n_neighbors=10)
[-118.5   34.2   29.  2129.   437.  1169.   411.     3.5]
(2, 13)
O named_transformers_ faz o mesmo dentro de um ColumnTransformer, então qualquer valor aprendido pode ser lido: aqui as oito medianas de treino que o imputador vai usar para preencher buracos (437 quartos, como na figura). O full[:-1] é "só o pré-processamento", útil para ver exatamente o que o modelo recebe.
No Jupyter, um pipeline deixado como última expressão de uma célula é desenhado como um diagrama interativo (set_config(display='diagram'), o padrão), com cada caixa expansível até os seus parâmetros. O print dá a versão em texto:
from sklearn import set_config

set_config(display='diagram')                             # o padrão: um diagrama clicável no Jupyter
print(full)
Pipeline(steps=[('columntransformer',
                 ColumnTransformer(transformers=[('num',
                                                  Pipeline(steps=[('simpleimputer',
                                                                   SimpleImputer(strategy='median')),
                                                                  ('standardscaler',
                                                                   StandardScaler())]),
                                                  ['longitude', 'latitude',
                                                   'housing_median_age',
                                                   'total_rooms',
                                                   'total_bedrooms',
                                                   'population', 'households',
                                                   'median_income']),
                                                 ('cat',
                                                  OneHotEncoder(handle_unknown='ignore',
                                                                sparse_output=False),
                                                  ['ocean_proximity'])])),
                ('kneighborsregressor', KNeighborsRegressor(n_neighbors=10))])
Só aparecem as configurações diferentes do padrão.
Como a cadeia inteira é um objeto só, ela é salva como um arquivo, que contém o estado aprendido de todos os passos:
import os
import joblib

joblib.dump(full, 'housing-knn.joblib')                   # um arquivo: pré-processamento + modelo
loaded = joblib.load('housing-knn.joblib')
print(f"{os.path.getsize('housing-knn.joblib') / 1e6:.1f} MB on disk")
print("identical predictions after the round trip:",
      np.array_equal(loaded.predict(X_test), full.predict(X_test)))
O pipeline carregado recebe linhas cruas e devolve as mesmas previsões, até o último dígito. Quem o usa não tem como esquecer um passo, reajustar um scaler ou reordenar as colunas: os três bugs da primeira seção precisam de pedaços de código separados para acontecer, mas aqui não existe nenhum. (O arquivo é grande porque o k-NN guarda os 16.512 distritos de treino para achar vizinhos; a maioria dos modelos guarda bem menos.) Um pipeline salvo também traz riscos próprios, como as versões das bibliotecas e a segurança de carregar o arquivo de outra pessoa; esses riscos são o assunto de MLOps.
7. Seus próprios passos
Etapa 2. A parte fundamental usou só os passos que vêm com o scikit-learn. Qualquer coisa que aprende com os dados e os transforma pode virar um passo de pipeline. Há dois caminhos, dependendo de o passo ter algo a aprender ou não.
Sem estado: FunctionTransformer
A aula de pré-processamento recomendou \(\log(1 + x)\) para colunas assimétricas à direita. Um logaritmo não aprende nada com os dados, então o FunctionTransformer transforma a função num passo diretamente:
from sklearn.preprocessing import FunctionTransformer

counts = ['total_rooms', 'total_bedrooms', 'population', 'households']
log = FunctionTransformer(np.log1p, feature_names_out='one-to-one')   # nada a aprender
print("skewness before:", X_train[counts].skew().round(2).to_list())
print("skewness after: ", log.fit_transform(X_train[counts]).skew().round(2).to_list())
As quatro colunas de contagem vão de uma assimetria forte à direita (de 3,3 a 5,2) para uma assimetria mais leve à esquerda (cerca de −1). O fit dele não faz nada, então ele não tem como vazar. O feature_names_out='one-to-one' avisa ao passo que a coluna de saída i é a coluna de entrada i; assim, o get_feature_names_out continua funcionando depois dele.
Com estado: um transformador seu
Quando o passo precisa aprender algo, ele precisa de uma classe com fit e transform. O exemplo é um "cortador" (clipper). O total_rooms vai até 39.320 numa tabela cuja mediana é cerca de 2.100; um único valor extremo (ou um erro de digitação nos dados novos) pode dominar as distâncias do modelo. O cortador aprende os percentis 1 e 99 de cada coluna só nas linhas de treino e puxa todo valor fora dessa faixa de volta para o limite mais próximo:
from sklearn.base import OneToOneFeatureMixin
from sklearn.utils.validation import check_is_fitted, validate_data

class Clipper(OneToOneFeatureMixin, TransformerMixin, BaseEstimator):
    """Corta cada coluna nos percentis aprendidos nos dados de treino."""
    def __init__(self, low=1, high=99):
        self.low = low                     # hiperparâmetros: guardados como vieram, nada mais
        self.high = high

    def fit(self, X, y=None):
        X = validate_data(self, X)         # vira array; guarda os nomes e o número de colunas
        self.lower_ = np.percentile(X, self.low, axis=0)     # o estado aprendido termina em "_"
        self.upper_ = np.percentile(X, self.high, axis=0)
        return self

    def transform(self, X):
        check_is_fitted(self)
        X = validate_data(self, X, reset=False)             # mesmas colunas do fit ou erro
        return np.clip(X, self.lower_, self.upper_)

clipped = make_pipeline(
    ColumnTransformer([
        ('num', make_pipeline(SimpleImputer(strategy='median'), Clipper(), StandardScaler()), num),
        ('cat', OneHotEncoder(handle_unknown='ignore', sparse_output=False), ['ocean_proximity'])]),
    KNeighborsRegressor(n_neighbors=10))
clipped.fit(X_train, y_train)
clip = clipped[0].named_transformers_['num'][1]
print(pd.DataFrame({'lower_': clip.lower_, 'upper_': clip.upper_}, index=num).round(1))
print("MAE:", mae(clipped.predict(X_test)))
                    lower_   upper_
longitude           -123.2   -116.3
latitude              32.7     40.6
housing_median_age     4.0     52.0
total_rooms          162.2  11248.0
total_bedrooms        35.0   2245.6
population            88.0   5825.3
households            30.0   2006.6
median_income          1.1     10.7
MAE: $41,361
As convenções são o que fazem de uma classe um passo do scikit-learn:
- O
__init__só guarda os hiperparâmetros, com os mesmos nomes dos argumentos; não faz mais nada. OBaseEstimatoros lê dali para oferecerget_params,set_paramse a representação impressa. - O
fitaprende e devolveself. Tudo o que é aprendido com os dados ganha um nome terminado em sublinhado (lower_,upper_), a mesma convenção demean_estatistics_. Ovalidate_dataconverte a entrada num array e registra o número e os nomes das colunas. - O
transformaplica o que foi aprendido, depois de conferir que o objeto foi ajustado e que as colunas são as mesmas. - O
TransformerMixinoferece ofit_transform(e oset_output); oOneToOneFeatureMixinoferece oget_feature_names_outpara um passo que mantém suas colunas uma a uma.
A tabela é o estado aprendido: os limites vêm dos 16.512 distritos de treino. Neste conjunto de teste o cortador melhora o MAE só um pouco, de US$ 41.552 para US$ 41.361, porque poucos valores de teste ficam fora dos limites. O trabalho de verdade dele é proteger contra valores que ninguém viu. Tome o primeiro distrito de teste e multiplique o total_rooms dele por 1.000, um erro de unidade do tipo que aparece quando uma fonte de dados nova começa a mandar os cômodos em outra unidade:
typo = X_test.head(1).copy()
typo['total_rooms'] *= 1000                # um erro de unidade numa linha nova
print(f"true value ${y_test.iloc[0]:,.0f} · correct row ${full.predict(X_test.head(1))[0]:,.0f}")
print(f"with the typo: no clipper ${full.predict(typo)[0]:,.0f} · clipper ${clipped.predict(typo)[0]:,.0f}")
Variar o multiplicador de 1 a 1.000 mostra de onde vem a diferença (script da figura):
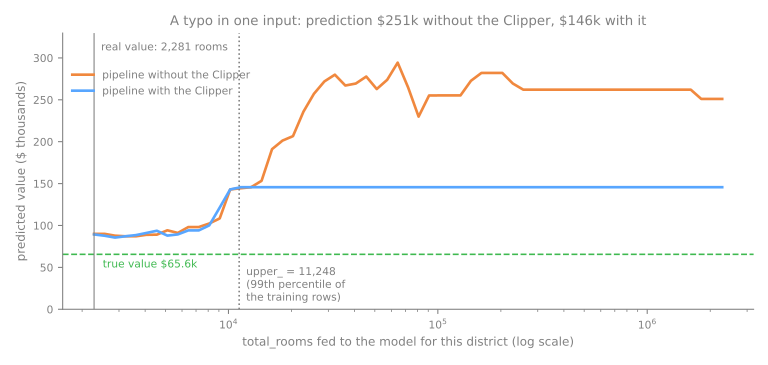
Até 11.248 cômodos (o upper_ aprendido) os dois pipelines quase concordam. Depois disso, o pipeline sem corte segue o erro de digitação para regiões dos dados em que os únicos vizinhos são distritos enormes e a previsão vagueia até US$ 251.020. O pipeline com corte vê no máximo 11.248 e fica em US$ 145.690. Continua sendo uma resposta errada para um distrito que vale US$ 65.600: nenhum transformador conserta uma entrada ruim. Mas o estrago tem limite, um limite aprendido só com dados de treino.
8. Olhando adiante: ajuste através do pipeline
Etapa 3. Toda configuração de todo passo é acessível de fora por um caminho com duplo sublinhado, passo__parametro, aninhado tão fundo quanto o pipeline (columntransformer__num__simpleimputer__strategy). O get_params lista todos e o set_params muda qualquer um sem reconstruir o pipeline:
params = full.get_params()
print(len(params), "parameters, e.g.:")
for name in params:
    if name.endswith(('n_neighbors', 'strategy', 'handle_unknown')):
        print("  ", name, "=", params[name])
full.set_params(kneighborsregressor__n_neighbors=20)
print(full[-1])
46 parameters, e.g.:
   columntransformer__num__simpleimputer__strategy = median
   columntransformer__cat__handle_unknown = ignore
   kneighborsregressor__n_neighbors = 10
KNeighborsRegressor(n_neighbors=20)
Depois do set_params, o próximo fit usa o valor novo. É isso que torna possível o ajuste automático: uma busca experimenta vários valores de kneighborsregressor__n_neighbors ou de columntransformer__num__simpleimputer__strategy. Como cada tentativa reajusta o pipeline inteiro, o pré-processamento é reaprendido para cada candidato nas linhas usadas para treinar, nunca nas usadas para avaliar. Escolher esses valores de forma honesta exige avaliá-los em dados que não são nem o treino nem o teste; o GridSearchCV do scikit-learn faz isso com o pipeline e esses nomes; ele é o assunto da aula de validação cruzada. Até lá, uma regra: nunca escolha uma configuração olhando a nota de teste.
9. Resumo: abrir, estender, ajustar
- Um pipeline ajustado é um contêiner:
named_steps, a indexação de lista e onamed_transformers_alcançam qualquer passo, todo valor aprendido pode ser lido e ofull[:-1]é exatamente o que o modelo recebe. - Um arquivo guarda a cadeia inteira: o
joblib.dumpsalva cada passo com o que ele aprendeu e o pipeline carregado recebe linhas cruas e devolve as mesmas previsões. - Um passo sem nada a aprender é um
FunctionTransformer. Um passo que aprende é uma classe cujo__init__só guarda hiperparâmetros, cujofitaprende atributos terminados em_e devolveselfe cujotransformos aplica. - Toda configuração é acessível como
passo__parametroe uma busca que reajusta o pipeline inteiro reaprende o pré-processamento nas suas próprias linhas de treino para cada candidato.
Hábito de projeto
Comece todo projeto escrevendo o esqueleto do pipeline, antes mesmo de escolher o modelo. Isso impõe a disciplina treino/teste desde a primeira linha de código. Além disso, o modelo pode ser trocado mudando uma linha e o objeto que você avalia é exatamente o que você vai entregar.
Lab avançado — abrir, usar, salvar e estender o pipeline
O lab fundamental terminou com um pipeline que acerta 0,782 dos passageiros de teste e cujos valores aprendidos vêm todos dos 712 passageiros de treino. Esta parte olha o que esse pipeline entrega ao modelo, usa-o em passageiros novos crus, salva-o em disco e o estende com um transformador seu. Continue no mesmo notebook, na mesma sessão: os passos abaixo usam preprocess, model, prep, X_train e X_test dos passos 1 a 5.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Continue no notebook do lab, a partir do passo 6. Se a sessão caiu, rode antes as células dos passos 1 a 5.
- Como no lab fundamental: Preveja antes de rodar, compare com esta página e tente as Simulações antes de abrir a solução.
- Ritmo sugerido: passos 6 e 7 e a primeira simulação em 12 min; passo 8 em 5 min; passo 9 e a segunda simulação em 13 min.
Passo 6 — o que o modelo vê
Preveja. Quantas colunas chegam ao modelo: as 7 colunas que os ramos usam ou mais? Um homem da terceira classe terá um 1 numa coluna de Pclass ou em várias?
names = prep.get_feature_names_out()
print(len(names), "columns reach the model:", list(names))
prep.set_output(transform='pandas')
print(prep.transform(X_test.head(3)).round(2).T)
12 columns reach the model: ['num__Age', 'num__SibSp', 'num__Parch', 'fare__Fare', 'cat__Pclass_1', 'cat__Pclass_2', 'cat__Pclass_3', 'cat__Sex_female', 'cat__Sex_male', 'cat__Embarked_C', 'cat__Embarked_Q', 'cat__Embarked_S']
                  565   160   553
num__Age        -0.43  1.11 -0.58
num__SibSp       1.42 -0.47 -0.47
num__Parch      -0.47  0.73 -0.47
fare__Fare       0.28 -0.11 -0.86
cat__Pclass_1    0.00  0.00  0.00
cat__Pclass_2    0.00  0.00  0.00
cat__Pclass_3    1.00  1.00  1.00
cat__Sex_female  0.00  0.00  0.00
cat__Sex_male    1.00  1.00  1.00
cat__Embarked_C  0.00  0.00  1.00
cat__Embarked_Q  0.00  0.00  0.00
cat__Embarked_S  1.00  1.00  0.00
Chegam 12 colunas ao modelo: 3 números, a tarifa e 3 + 2 + 3 colunas de one-hot. Os três passageiros de teste mostrados são homens da terceira classe. Uma conferência à mão com os números do passo 5: o primeiro passageiro tem dois irmãos ou cônjuges a bordo, \((2 - 0{,}493)/1{,}060 = 1{,}42\); o segundo viaja com um pai, mãe ou filho, \((1 - 0{,}390)/0{,}838 = 0{,}73\); um passageiro sem pais nem filhos recebe \((0 - 0{,}390)/0{,}838 = -0{,}47\). Com o set_output, todo valor transformado tem nome e toda linha mantém seu índice (565, 160, 553), então qualquer número suspeito pode ser rastreado até a linha crua.
Passo 7 — passageiros novos, crus
Preveja. Um passageiro novo embarcou num porto que os dados de treino nunca viram e outro não tem idade. O pipeline vai quebrar ou responder? Que número vai substituir a idade faltante?
new = pd.DataFrame({
    'PassengerId': [901, 902, 903], 'Pclass': [3, 1, 2],
    'Name': ['Doe, Mr. John', 'Roe, Mrs. Jane', 'Poe, Miss. Ann'],
    'Sex': ['male', 'female', 'female'], 'Age': [25, np.nan, 30],
    'SibSp': [0, 1, 0], 'Parch': [0, 0, 0], 'Ticket': ['A1', 'B2', 'C3'],
    'Fare': [8.05, 80.0, 15.0], 'Cabin': [np.nan, 'C85', np.nan],
    'Embarked': ['S', 'C', 'B'],             # 'B' (Belfast) nunca aparece nos dados de treino
})
print(prep.transform(new)[['num__Age', 'cat__Embarked_C', 'cat__Embarked_Q', 'cat__Embarked_S']].round(2))
print("P(survived):", model.predict_proba(new)[:, 1].round(2), "· prediction:", model.predict(new))
   num__Age  cat__Embarked_C  cat__Embarked_Q  cat__Embarked_S
0     -0.35              0.0              0.0              1.0
1     -0.08              1.0              0.0              0.0
2      0.03              0.0              0.0              0.0
P(survived): [0. 1. 1.] · prediction: [0 1 1]
Três passageiros inventados, no formato cru da tabela original: 11 colunas, com texto, uma idade faltante e um porto que não existe nos dados. O pipeline não se importa com as colunas que descarta (Name, Ticket, Cabin), preenche a idade faltante do segundo passageiro com a mediana do treino (\((28{,}5 - 29{,}556)/13{,}016 = -0{,}08\)) e dá ao terceiro, que embarcou em "B", zeros nas três colunas de Embarked em vez de um erro. As probabilidades são a fração de sobreviventes entre os 5 passageiros de treino mais próximos, então andam de 0,2 em 0,2; aqui os vizinhos são unânimes: o homem da terceira classe não sobreviveu, as duas mulheres sobreviveram.
Simulação: um encoder que recusa categorias novas. Faça uma cópia de model (com clone) cujo encoder one-hot do ramo 'cat' tenha handle_unknown='error'; o caminho é prep__cat__onehotencoder__handle_unknown, mudado com set_params. Ajuste nas linhas de treino e preveja os dois primeiros passageiros novos, depois os três. O que acontece? O que isso significaria para um serviço que responde um pedido por vez?
Solução
from sklearn.base import clone

strict = clone(model).set_params(prep__cat__onehotencoder__handle_unknown='error')
strict.fit(X_train, y_train)
print("first two new passengers:", strict.predict(new.head(2)))
try:
    strict.predict(new)
except ValueError as err:
    print("all three:", str(err).splitlines()[0])
first two new passengers: [0 1]
all three: Found unknown categories ['B'] in column 2 during transform
Os dois primeiros passageiros recebem as mesmas previsões de antes. Acrescente o terceiro, que embarcou em "B", e a chamada inteira falha: um valor desconhecido numa linha derruba a previsão de todas as linhas enviadas com ela. Um serviço que responde pedidos devolveria um erro para cada passageiro de Belfast; um processamento em lote perderia o lote inteiro. Com handle_unknown='ignore' a mesma linha recebe zeros nas três colunas de Embarked e uma resposta. Qual comportamento é o certo depende do problema (às vezes o erro é a resposta honesta), mas deve ser uma decisão, não uma surpresa em produção.
Passo 8 — salvar, carregar, comparar
Preveja. O arquivo salvo terá alguns kilobytes ou centenas? O modelo carregado vai dar exatamente as mesmas probabilidades ou só aproximadamente?
import os
import joblib

joblib.dump(model, 'titanic-knn.joblib')
loaded = joblib.load('titanic-knn.joblib')
print(f"{os.path.getsize('titanic-knn.joblib') / 1e3:.0f} kB")
print("same test predictions:", np.array_equal(loaded.predict(X_test), model.predict(X_test)))
print("same probabilities for the new rows:",
      np.array_equal(loaded.predict_proba(new), model.predict_proba(new)))
O arquivo guarda a cadeia inteira (imputadores, scalers, encoder e classificador, com tudo o que aprenderam) em 162 kB, a maior parte deles os 712 passageiros de treino que o k-NN guarda. Carregado de volta, ele dá as mesmas previsões e as mesmas probabilidades, até o último dígito, a partir das mesmas linhas cruas. Esse arquivo é o que um serviço carregaria para responder pedidos. Carregá-lo exige uma versão compatível do scikit-learn; além disso, carregar um arquivo de alguém em quem você não confia é um risco de segurança: as duas coisas são discutidas em MLOps.
Passo 9 — um transformador seu: o título
Preveja. A lista de títulos "frequentes" deve ser aprendida nas linhas de treino ou pode ser escrita à mão a partir dos 891 passageiros? O título vai melhorar a acurácia? 179 passageiros de teste bastam para ter certeza?
from sklearn.base import BaseEstimator, TransformerMixin

class TitleExtractor(TransformerMixin, BaseEstimator):
    """Nome -> título ('Mr', 'Mrs', ...); títulos com menos de min_count no TREINO viram 'Rare'."""
    def __init__(self, min_count=10):
        self.min_count = min_count

    def _titles(self, X):
        names = pd.Series(np.asarray(X).ravel())
        return names.str.extract(r',\s*([^.]+)\.')[0].str.strip()

    def fit(self, X, y=None):
        counts = self._titles(X).value_counts()
        self.titles_ = sorted(counts[counts >= self.min_count].index)   # aprendido no treino
        return self

    def transform(self, X):
        t = self._titles(X)
        return t.where(t.isin(self.titles_), 'Rare').to_frame('title')

    def get_feature_names_out(self, input_features=None):
        return np.array(['title'])

prep2 = ColumnTransformer(preprocess.transformers + [
    ('title', make_pipeline(TitleExtractor(), OneHotEncoder(handle_unknown='ignore', sparse_output=False)),
     ['Name'])])
model2 = Pipeline([('prep', prep2), ('knn', KNeighborsClassifier())]).fit(X_train, y_train)
print("titles learned on train:", model2['prep'].named_transformers_['title'][0].titles_)
print("titles of the new rows: ", TitleExtractor().fit(X_train[['Name']]).transform(new[['Name']])['title'].to_list())
print(f"test accuracy · without title {model.score(X_test, y_test):.3f} · with title {model2.score(X_test, y_test):.3f}")
titles learned on train: ['Master', 'Miss', 'Mr', 'Mrs']
titles of the new rows:  ['Mr', 'Mrs', 'Miss']
test accuracy · without title 0.782 · with title 0.816
O TitleExtractor tem algo a aprender, então é uma classe e não um FunctionTransformer: no fit ele conta os títulos dos passageiros de treino e guarda os que têm pelo menos 10 (Master, Miss, Mr, Mrs); no transform, qualquer outro título (Dr, Rev, Col, ...) vira 'Rare'. Um título frequente só no conjunto de teste também viraria 'Rare', que é o comportamento honesto. O get_feature_names_out permite que o encoder seguinte dê nome às suas colunas. O ramo novo é somado aos três existentes e a acurácia vai de 78,2% para 81,6%: "Master" marca meninos e "Miss", com frequência, moças solteiras; por isso, o título carrega informação de idade mesmo para passageiros cuja idade falta. Uma ressalva: 3,4 pontos em 179 passageiros são 6 passageiros. Decidir manter o título por causa desse número seria uma decisão tomada no conjunto de teste; o jeito honesto é um split de validação (item 3 de Sua vez (avançado)) ou a validação cruzada que você vai conhecer mais adiante.
Simulação: quão raro é "Rare"? O min_count é um hiperparâmetro do TitleExtractor; por isso o pipeline o alcança como prep__title__titleextractor__min_count. Para min_count em 1, 5, 10 e 40, ajuste uma cópia de model2 (com clone e set_params) e imprima os títulos que ela aprendeu e a acurácia de teste. Que títulos sobrevivem a cada limiar? A acurácia diz qual limiar é o melhor?
Solução
for k in [1, 5, 10, 40]:
    m = clone(model2).set_params(prep__title__titleextractor__min_count=k).fit(X_train, y_train)
    titles = m['prep'].named_transformers_['title'][0].titles_
    print(f"min_count {k:2d}: {len(titles):2d} titles · test accuracy {m.score(X_test, y_test):.3f} · {titles}")
min_count  1: 14 titles · test accuracy 0.810 · ['Col', 'Don', 'Dr', 'Jonkheer', 'Lady', 'Major', 'Master', 'Miss', 'Mlle', 'Mr', 'Mrs', 'Ms', 'Rev', 'Sir']
min_count  5:  6 titles · test accuracy 0.816 · ['Dr', 'Master', 'Miss', 'Mr', 'Mrs', 'Rev']
min_count 10:  4 titles · test accuracy 0.816 · ['Master', 'Miss', 'Mr', 'Mrs']
min_count 40:  3 titles · test accuracy 0.816 · ['Miss', 'Mr', 'Mrs']
Com min_count=1, todo título visto no treino ganha a sua coluna, 14 ao todo, inclusive títulos de um único passageiro (Don, Jonkheer, Lady, Sir); com 40 só sobram Miss, Mr e Mrs e até Master vira "Rare". A acurácia quase não se mexe: 0,810 com os 14 títulos e 0,816 nos outros três limiares, um passageiro em 179 de diferença. Duas lições. A configuração é estado aprendido como qualquer outro, reajustado nas linhas de treino de cada cópia, e o caminho pelo pipeline a alcança como alcança knn__n_neighbors. E o conjunto de teste não consegue ordenar essas escolhas: uma diferença de um passageiro é ruído. Escolher o min_count é trabalho para um split de validação ou para a aula de validação cruzada.
Para fechar a aula. Em uma frase cada: (1) por que salvar o pipeline inteiro e não só o classificador treinado? (2) Quando um passo seu precisa ser uma classe em vez de um FunctionTransformer? (3) Por que uma busca que testa configurações pelo set_params nunca deixa as linhas de avaliação entrarem no pré-processamento?
Sua vez (avançado)
Para casa, com mais tempo:
- Razões como um passo. Cômodos por domicílio, quartos por cômodo e pessoas por domicílio dizem mais que as contagens cruas. Escreva-as como um
FunctionTransformer(use uma função que recebe um DataFrame e devolve outro com as três colunas novas; emfeature_names_out, passe uma função que devolve os nomes delas), coloque-o no ramo numérico da seção 3 e compare o MAE de teste com os US$ 41.552 da aula. - O deck. A primeira letra de
Cabiné o deck (de A a G, além de T) e uma cabine faltante também é informação (quase sempre terceira classe). Acrescente um ramo que transformaCabinno deck, com'U'para faltante, seguido de one-hot. Escreva a conversão primeiro como umalambdadentro de umFunctionTransformer, ajuste e tentejoblib.dumpno modelo. O que acontece? Por que uma função definida comdefresolve? - Escolha o
kde forma honesta. Separe um split de validação de dentro deX_train(25% dele, estratificado). Parakem 1, 5, 15, 45, usemodel.set_params(knn__n_neighbors=k), ajuste no resto das linhas de treino e avalie nas linhas de validação. Escolha o melhork, reajuste em todo oX_traine só então olhe a acurácia de teste, uma vez. (A aula de validação cruzada vai tornar essa escolha mais robusta.) - Corte a tarifa. Troque o
log1pdo ramo'fare'peloClipperda aula (percentis 1 e 99). Imprima oupper_dele e compare com a maior tarifa das linhas de treino. A acurácia de teste muda? Você esperaria que o k-NN fosse mais sensível aos valores extremos da tarifa do que um modelo que só compara um valor com um limiar?
Referências
- Buitinck, L.; Louppe, G.; Blondel, M.; Pedregosa, F.; Mueller, A.; Grisel, O.; Niculae, V.; Prettenhofer, P.; Gramfort, A.; Grobler, J.; Layton, R.; VanderPlas, J.; Joly, A.; Holt, B.; Varoquaux, G. "API design for machine learning software: experiences from the scikit-learn project." ECML PKDD Workshop: Languages for Data Mining and Machine Learning (2013): 108–122 — as interfaces de estimador, transformador e pipeline usadas nesta aula e a razão de serem como são. arXiv
- Pedregosa, F.; Varoquaux, G.; Gramfort, A.; Michel, V.; Thirion, B.; Grisel, O.; Blondel, M.; Prettenhofer, P.; Weiss, R.; Dubourg, V.; Vanderplas, J.; Passos, A.; Cournapeau, D.; Brucher, M.; Perrot, M.; Duchesnay, É. "Scikit-learn: Machine Learning in Python." Journal of Machine Learning Research 12 (2011): 2825–2830. texto completo
- Micci-Barreca, D. "A Preprocessing Scheme for High-Cardinality Categorical Attributes in Classification and Prediction Problems." ACM SIGKDD Explorations 3, n. 1 (2001): 27–32 — target encoding com suavização, o método por trás do
TargetEncoder. DOI - Kaufman, S.; Rosset, S.; Perlich, C.; Stitelman, O. "Leakage in Data Mining: Formulation, Detection, and Avoidance." ACM TKDD 6, n. 4 (2012) — uma taxonomia do vazamento com casos reais de competições. DOI
- Sculley, D.; Holt, G.; Golovin, D.; Davydov, E.; Phillips, T.; Ebner, D.; Chaudhary, V.; Young, M.; Crespo, J.-F.; Dennison, D. "Hidden Technical Debt in Machine Learning Systems." Advances in Neural Information Processing Systems 28 (NeurIPS 2015): 2503–2511 — as "selvas de pipelines" e o custo de um código de treino e um código de serving que se afastam. texto completo
Quiz
O quiz cobre a abordagem fundamental.