O caminho desta parte
- Abrir e salvarpassos pelo nome, valores aprendidos, um arquivo
- Passos seusFunctionTransformer e uma classe que aprende
- Ajustar através delepasso__parametro e set_params
Um pipeline ajustado é um contêiner que você pode abrir
list(full.named_steps)
full[-1]                   # indexação, como numa lista
full.named_steps['columntransformer'] \
    .named_transformers_['num'][0].statistics_
full[:-1].transform(X_test.head(2)).shape
['columntransformer', 'kneighborsregressor']
KNeighborsRegressor(n_neighbors=10)
[-118.5 34.2 29. 2129. 437. 1169. 411. 3.5]
(2, 13)
- O
named_transformers_abre um ramo doColumnTransformer: as oito medianas de treino que o imputador vai usar (437 quartos). - Uma fatia é um pipeline menor:
full[:-1]é só o pré-processamento, exatamente o que o modelo recebe. - O
print(full)dá o diagrama em texto; no Jupyter o pipeline é desenhado como um diagrama clicável.
Um arquivo: pré-processamento + modelo
joblib.dump(full, 'housing-knn.joblib')
loaded = joblib.load('housing-knn.joblib')
np.array_equal(loaded.predict(X_test), full.predict(X_test))   # True
3,9 MB em disco
O k-NN (k vizinhos mais próximos, do inglês k-nearest neighbors) guarda os 16.512 distritos de treino para achar vizinhos; a maioria dos modelos guarda bem menos.
previsões idênticas
O pipeline carregado recebe linhas cruas e devolve as mesmas previsões, até o último dígito.
Seus próprios passos: sem estado
log = FunctionTransformer(np.log1p, feature_names_out='one-to-one') # nada a aprender
| assimetria das quatro colunas de contagem | |
|---|---|
| antes | 3,85; 3,32; 5,17; 3,26 |
| depois de \(\log(1+x)\) | −1,09; −1,0; −1,04; −1,06 |
fit dele não faz nada, então ele não tem como vazar. O 'one-to-one' mantém o get_feature_names_out funcionando.Seus próprios passos: um transformador que aprende
Um cortador (clipper): aprende os percentis 1 e 99 de cada coluna nas linhas de treino e puxa todo valor fora deles de volta para o limite.
- O
__init__só guarda os hiperparâmetros. - O
fitaprende e devolveself; o estado aprendido termina em_(lower_,upper_). - O
transformaplica o que foi aprendido, depois de conferir que houve ajuste. - O
TransformerMixindá ofit_transform; oOneToOneFeatureMixin, os nomes das colunas.
aprendido em 16.512 distritos
total_rooms: de 162,2 a 11.248,0
Um transformador que aprende: o código
class Clipper(OneToOneFeatureMixin, TransformerMixin, BaseEstimator):
    def __init__(self, low=1, high=99):
        self.low = low                     # hiperparâmetros: guardados, nada mais
        self.high = high

    def fit(self, X, y=None):
        X = validate_data(self, X)         # guarda os nomes e o número de colunas
        self.lower_ = np.percentile(X, self.low, axis=0)   # o estado aprendido termina em "_"
        self.upper_ = np.percentile(X, self.high, axis=0)
        return self

    def transform(self, X):
        check_is_fitted(self)
        X = validate_data(self, X, reset=False)            # mesmas colunas do fit
        return np.clip(X, self.lower_, self.upper_)
Ele entra no ramo numérico, entre o imputador e o scaler: make_pipeline(SimpleImputer(strategy='median'), Clipper(), StandardScaler()).
Para que o cortador serve de verdade
total_rooms multiplicado por 1.000 (um erro de unidade). O que acontece com a previsão dele, com e sem o cortador?| valor verdadeiro | US$ 65.600 |
| linha correta | US$ 90.030 |
| erro, sem cortador | US$ 251.020 |
| erro, com cortador | US$ 145.690 |
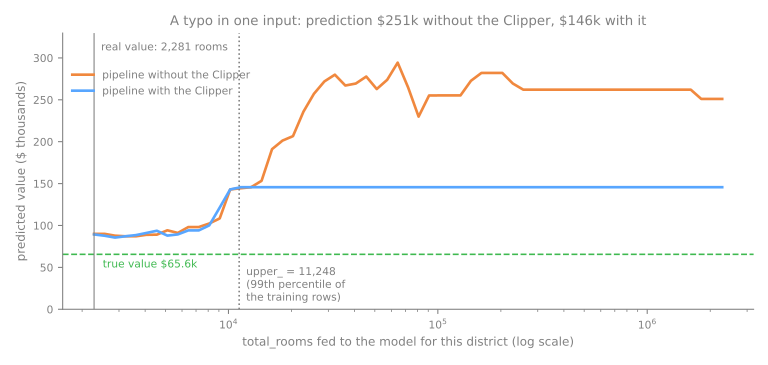
Continua errado: nenhum transformador conserta uma entrada ruim. Mas o estrago tem limite, um limite aprendido só com dados de treino.
Olhando adiante: ajuste através do pipeline
full.get_params()        # 46 parâmetros, p. ex. columntransformer__num__simpleimputer__strategy
full.set_params(kneighborsregressor__n_neighbors=20)
- Toda configuração de todo passo é acessível como
passo__parametro. - Uma busca que reajusta o pipeline inteiro reaprende o pré-processamento nas linhas de treino de cada tentativa.
GridSearchCV e esses nomes.Resumo
- Um pipeline ajustado é um contêiner:
named_steps, indexação,named_transformers_; todo valor aprendido pode ser lido. - Um arquivo guarda a cadeia inteira; o pipeline carregado recebe linhas cruas.
- Nada a aprender:
FunctionTransformer. Algo a aprender: uma classe cujofitguarda atributos terminados em_. - Toda configuração é acessível como
passo__parametro; uma busca reajusta o pipeline inteiro.
Abrir, usar, salvar e estender o pipeline, passos 6 a 9
- Mesmo notebook, mesma sessão: os passos usam
preprocess,model,prep,X_traineX_testdos passos 1 a 5. - O que o modelo vê (
set_output); passageiros novos crus; salvar, carregar, comparar; um transformador seu: o título. - Notebook do lab, a partir do passo 6.
- Simulações: um encoder que recusa categorias novas (passo 7) e quão raro é "Rare"? (passo 9).
Ritmo: passos 6 e 7 e a primeira simulação em 12 min; passo 8 em 5 min; passo 9 e a segunda em 13 min.