A regra da aula de pré-processamento
- Todo passo que aprende algo com os dados: a mediana de um imputador, a média e o desvio-padrão de um scaler, a lista de categorias de um encoder.
- Ele é ajustado apenas nas linhas de treino.
- Depois é reaplicado, sem mudança, a toda outra linha: o conjunto de teste, um split de validação, os dados do mês que vem em produção.
fit e transform que precisa ficar na ordem certa, nos dados certos, para sempre.O caminho desta aula
- O fluxo manualsete chamadas, três bugs, medidos
- Um Pipelinefit e predict, passo a passo
- Colunas reaisColumnTransformer e passos seus
- Inspecionar e confiarinspeção, persistência, o vazamento evitado
Os dados e o modelo
California housing
- 20.640 distritos
- 8 colunas numéricas (
total_bedroomstem buracos) - 1 coluna de texto,
ocean_proximity - alvo: o valor mediano das casas
uma caixa-preta: k-NN (k vizinhos mais próximos)
Prevê um distrito como a média dos 10 distritos de treino mais parecidos.
Duas propriedades importam aqui: ele depende da escala das colunas e é rápido.
Pré-processamento: preencher os buracos com a mediana e depois padronizar. A aula de k-NN estuda o modelo em si.
O fluxo manual cuidadoso
imputer = SimpleImputer(strategy='median')
scaler = StandardScaler()
model = KNeighborsRegressor(n_neighbors=10)

A_train = scaler.fit_transform(imputer.fit_transform(X_train[num]))   # aprende no treino
model.fit(A_train, y_train)
A_test = scaler.transform(imputer.transform(X_test[num]))             # reaplica no teste
pred = model.predict(A_test)
fluxo cuidadoso
sempre a média do treino
Sete chamadas em que a ordem importa
fit_transformno treino,transformno teste.- Imputador antes do scaler.
- As mesmas oito colunas, na mesma ordem.
Cada bug abaixo muda uma coisa no código de previsão. O modelo treinado é o mesmo em todos os casos.
Bug 1 à mão: reajustar nos dados que você prevê
| linhas de treino | linhas novas |
|---|---|
| 200, NaN, 400, 600, 800 | NaN, 900 |
NaN (not a number) marca um valor faltante.
certo: ajustar no treino
mediana 500 → coluna 200, 500, 400, 600, 800
média 500, desvio \(\sqrt{40{.}000} = 200\)
linhas novas: NaN → 500 → 0; 900 → \((900-500)/200\) = 2
errado: reajustar nas linhas novas
mediana 900 → as duas linhas viram 900
média 900, dispersão zero
linhas novas: 0 e 0
Bug 1 nos dados reais: depende de como as linhas chegam
| o scaler é reajustado em… | MAE |
|---|---|
| todo o conjunto de teste de uma vez | US$ 42.814 |
| o lote de cada região | US$ 65.754 |
| um distrito de cada vez | US$ 116.049 |
- Invisível no teste inteiro: 4.128 distritos sorteados têm quase as estatísticas do treino; o MAE sai até US$ 209 menor, por acaso.
- Lotes por região são recentrados em si mesmos: os vizinhos encontrados deixam de ser os certos.
- Uma linha tem dispersão zero: todo distrito vira o mesmo ponto, uma única previsão para 4.128 distritos.
Bug 2: um passo esquecido na hora de prever
imputador esquecido
o modelo recusa: Input X contains NaN.
o caso de sorte: um erro
scaler esquecido
silencioso: números crus (um total_rooms de 2.000 onde aprendeu valores em torno de 0), uma previsão confiante para cada distrito
Bug 3: outra ordem de colunas
O modelo recebe números, não nomes: a coluna 5 é "population" só porque era a coluna 5 no treino. Troque households e population:
enviado como array
um distrito tem cerca de três vezes mais moradores que domicílios; o único indício é um UserWarning
enviado como DataFrame
o scikit-learn compara os nomes com os do fit e recusa.
Seis versões do código de previsão
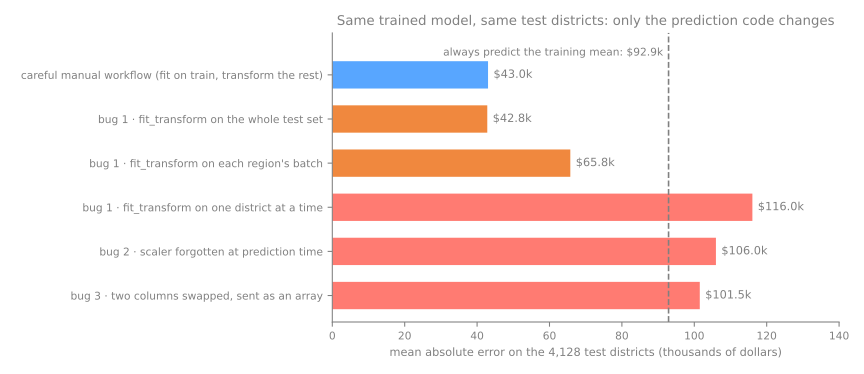
Três das seis barras são piores que ignorar os dados. A mais perigosa é a segunda: o bug que parece certo.
Pipeline: um estimador, vários passos
pipe = make_pipeline(SimpleImputer(strategy='median'), StandardScaler(),
                     KNeighborsRegressor(n_neighbors=10))
pipe.fit(X_train[num], y_train)            # todo passo aprende com as linhas de treino
pred_pipe = pipe.predict(X_test[num])      # todo passo reaplica o que aprendeu
MAE
um de cada vez
4.128 previsões uma a uma = todas de uma vez
colunas trocadas
recusadas: os nomes precisam bater com os do fit
Os três bugs, eliminados por construção
- Bug 1. O
pipe.predictnunca chamafitnum transformador: o tamanho do lote deixa de importar. - Bug 2. Não existe código de previsão separado em que esquecer um passo: os passos viajam dentro do objeto.
- Bug 3. O pipeline entrega o DataFrame ao primeiro passo, que confere os nomes.
fit + transform); o último pode ser qualquer coisa com fit. O pipeline expõe os métodos do último passo: predict, score, predict_proba.O que fit e predict fazem, passo a passo
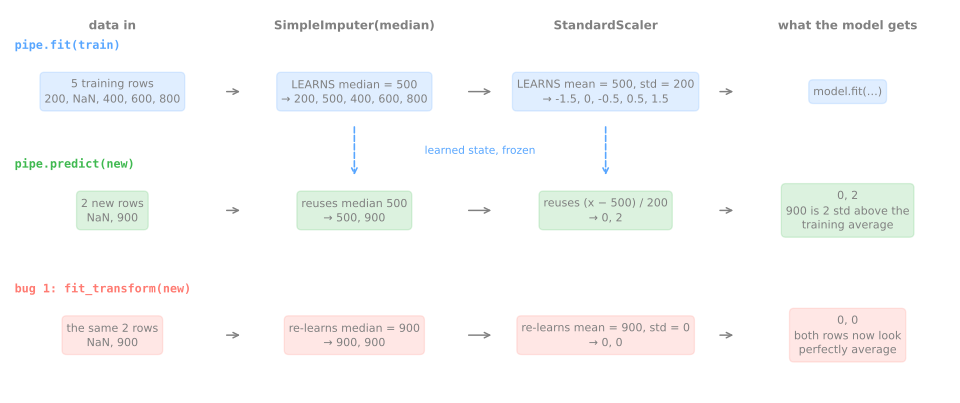
fit: cada transformador é ajustado no que recebe e o transforma para o seguinte; o último passo é só ajustado. predict: só transform, com os parâmetros congelados no ajuste.
Um espião entre os passos
Um passo que não faz nada e relata, para total_bedrooms, os faltantes e a média.
| chamada | linhas | faltantes | média |
|---|---|---|---|
| fit · cru | 16.512 | 163 | 538,92 |
| fit · imputado | 16.512 | 0 | 537,92 |
| predict · cru | 4.128 | 44 | 533,66 |
| predict · padronizado | 4.128 | 0 | −0,01 |
Não: as linhas de teste são medidas com a régua das linhas de treino. Uma média de exatamente 0,00 no teste seria o sintoma do bug 1.
Durante o fit, só existem as 16.512 linhas de treino. Os 44 buracos do teste recebem a mediana do treino.
Pipeline ou make_pipeline
pipe_named = Pipeline([('impute', SimpleImputer(strategy='median')),
                       ('scale', StandardScaler()),
                       ('model', KNeighborsRegressor(n_neighbors=10))])
- O
make_pipelinedá a cada passo o nome da sua classe:'simpleimputer','standardscaler','kneighborsregressor'. - No
Pipeline, você mesmo dá os nomes.
O mesmo tipo de objeto; os nomes só importam quando você se refere a um passo depois. Nomes curtos e explícitos valem a pena em pipelines longos.
Colunas diferentes, tratamentos diferentes: ColumnTransformer
preprocess = ColumnTransformer([
    ('num', make_pipeline(SimpleImputer(strategy='median'), StandardScaler()), num),
    ('cat', OneHotEncoder(handle_unknown='ignore', sparse_output=False), ['ocean_proximity']),
])
full = make_pipeline(preprocess, KNeighborsRegressor(n_neighbors=10))
full.fit(X_train, y_train)                 # entra a tabela crua de 9 colunas
com ocean_proximity
cada ramo
uma tripla (nome, transformador, colunas); um ramo pode ser ele mesmo um pipeline
Veja as colunas viajarem
O que realmente sai
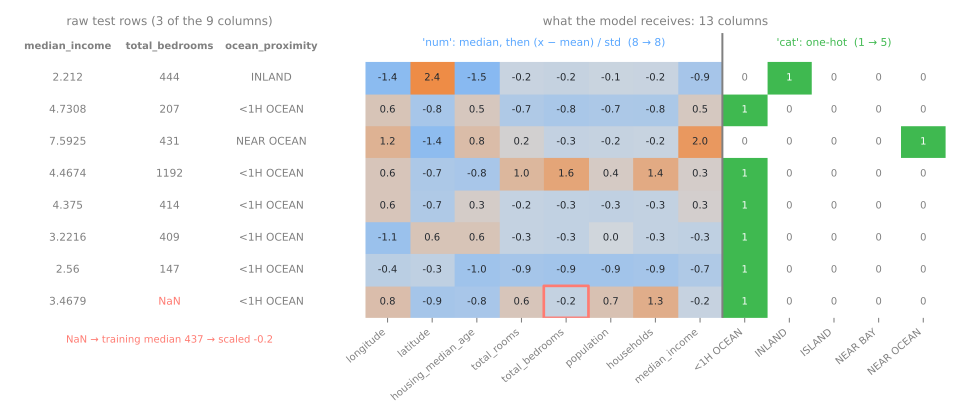
O get_feature_names_out diz o que é cada uma das 13 colunas: o prefixo é o ramo (num__, cat__); as colunas do one-hot trazem a categoria. O total_bedrooms faltante recebe a mediana de treino, 437.
Que colunas vão para onde
remainder
As colunas que nenhum ramo menciona são descartadas por padrão: saem 2 colunas.
O 'passthrough' as anexa sem mudança: 9 colunas, mas sem escala (e uma é texto).
seletores
make_column_selector(dtype_include='number') escolhe as colunas pelo tipo no ajuste.
Eles confiam nos tipos: um CEP guardado como número cai no ramo numérico.
'drop' é o padrão seguro: um identificador esquecido nunca chega ao modelo em silêncio. Listas explícitas dizem exatamente o que acontece.Robusto à ordem das colunas e a categorias novas
- As nove colunas em ordem inversa: previsões idênticas. O
ColumnTransformerescolhe pelo nome, então o bug 3 desaparece. - Um distrito rebatizado de
'LAKE', uma categoria nunca vista: zeros nas cinco colunas do one-hot e uma previsão, US$ 90.030, igual à do seu rótulo verdadeiro.
handle_unknown='ignore', a mesma linha levanta Found unknown categories; um valor novo em produção derruba o serviço inteiro. ISLAND tem só 5 distritos na tabela inteira.Seus próprios passos: sem estado
log = FunctionTransformer(np.log1p, feature_names_out='one-to-one') # nada a aprender
| assimetria das quatro colunas de contagem | |
|---|---|
| antes | 3,85; 3,32; 5,17; 3,26 |
| depois de \(\log(1+x)\) | −1,09; −1,0; −1,04; −1,06 |
fit dele não faz nada, então ele não tem como vazar. O 'one-to-one' mantém o get_feature_names_out funcionando.Seus próprios passos: um transformador que aprende
Um cortador (clipper): aprende os percentis 1 e 99 de cada coluna nas linhas de treino e puxa todo valor fora deles de volta para o limite.
- O
__init__só guarda os hiperparâmetros. - O
fitaprende e devolveself; o estado aprendido termina em_(lower_,upper_). - O
transformaplica o que foi aprendido, depois de conferir que houve ajuste. - O
TransformerMixindá ofit_transform; oOneToOneFeatureMixin, os nomes das colunas.
aprendido em 16.512 distritos
total_rooms: de 162,2 a 11.248,0
Para que o cortador serve de verdade
total_rooms multiplicado por 1.000 (um erro de unidade). O que acontece com a previsão dele, com e sem o cortador?| valor verdadeiro | US$ 65.600 |
| linha correta | US$ 90.030 |
| erro, sem cortador | US$ 251.020 |
| erro, com cortador | US$ 145.690 |
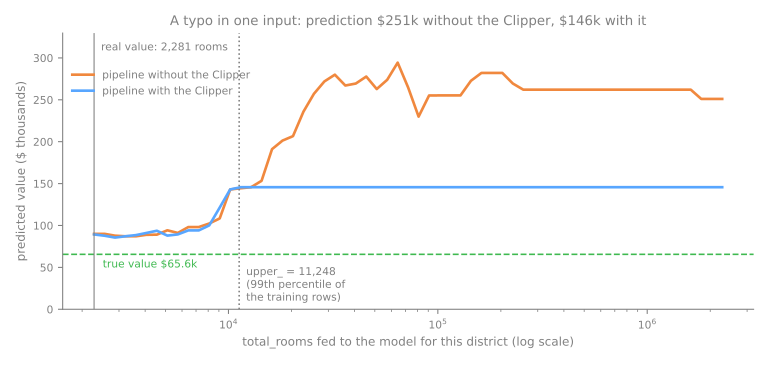
Continua errado: nenhum transformador conserta uma entrada ruim. Mas o estrago tem limite, um limite aprendido só com dados de treino.
Inspeção e persistência
abrir o contêiner
full.named_stepsou a indexação de uma lista:full[-1]named_transformers_['num'][0].statistics_: as oito medianas de treino (437 quartos)full[:-1]= só o pré-processamento: (2, 13)
um arquivo
joblib.dump(full, 'housing-knn.joblib')
3,9 MB (o k-NN guarda todos os distritos de treino); previsões idênticas depois de salvar e carregar.
O vazamento que um pipeline evita
Ajuste um passo em todos os 20.640 distritos antes da divisão ou dentro do pipeline. Dois tipos de passo:
um scaler
aprende médias e desvios-padrão; nunca olha para o preço
um target encoder
troca cada zona pelo preço médio daquela zona (zonas: coordenadas arredondadas, células de ~1 km)
12.590 zonas · 8.237 com um único distrito · 44% dos distritos de teste em zonas nunca vistas no treino
O tamanho de um vazamento depende do que o passo aprende
| encoder ajustado em todas as linhas | US$ 14.567 |
| encoder dentro do pipeline | US$ 42.552 |
| sem zona nenhuma | US$ 60.383 |
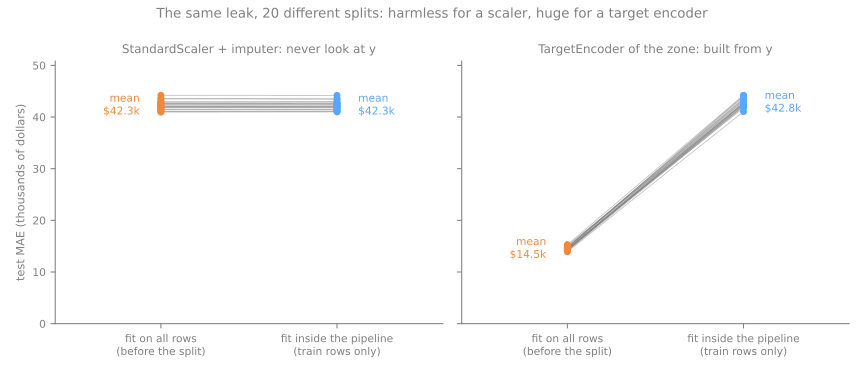
- Um distrito sozinho na sua zona: o "preço da zona" dele é o próprio preço e o modelo lê a resposta na entrada.
- Em 20 splits: o vazamento do scaler muda o MAE em US$ 4 na média; o do encoder faz o erro parecer US$ 28.300 menor.
Simulador: fit em quais linhas?
Preveja. Passe para teste = período posterior e depois para fit em todas as linhas. As linhas de teste parecem mais ou menos deslocadas? O modelo ficou melhor?
Olhando adiante: ajuste através do pipeline
full.get_params()        # 46 parâmetros, p. ex. columntransformer__num__simpleimputer__strategy
full.set_params(kneighborsregressor__n_neighbors=20)
- Toda configuração de todo passo é acessível como
passo__parametro. - Uma busca que reajusta o pipeline inteiro reaprende o pré-processamento nas linhas de treino de cada tentativa.
GridSearchCV e esses nomes.Resumo
- Passos ajustados: ajustar no treino, reaplicar sem mudança. À mão, a regra quebra.
- O bug mais perigoso é o que parece certo num conjunto de teste de notebook.
Pipeline: duas chamadas, as mesmas previsões, os três bugs eliminados por construção.ColumnTransformer: um ramo por grupo de colunas, escolhidas pelo nome.- Seus próprios passos:
FunctionTransformerou uma classe comfit/transform. - Todo passo ajustado dentro do pipeline: nenhum vazamento a medir.
Das linhas cruas do Titanic a um modelo salvo
- Baixe o notebook do lab e abra no Jupyter ou no Colab (File → Upload notebook).
- 891 passageiros crus; um classificador k-NN como caixa-preta.
- Rode os blocos em ordem, numa mesma sessão.
1. carregar e olhar
2. dividir uma vez
3. o pré-processamento, coluna por coluna
4. ajustar no treino, avaliar no teste
5. o que cada passo aprendeu
6. o que o modelo vê
7. passageiros novos, crus
8. salvar, carregar, comparar
9. um transformador seu: o título