Pré-processamento de Dados
Um algoritmo de aprendizado recebe uma matriz de números e uma função de custo. Ele não sabe que a coluna Fare do Titanic está em libras de 1912, que Sex não tem ordem nem que 177 idades simplesmente nunca foram registradas. Ele minimiza o custo com os números que você entregou e, se esses números estiverem mal preparados, minimiza a coisa errada, com toda a convicção. O pré-processamento transforma colunas brutas em números que um algoritmo consegue usar sem ser enganado. Três problemas aparecem em quase toda tabela:
| problema | como o algoritmo sofre | no Titanic (891 passageiros) |
|---|---|---|
| escalas incompatíveis | em qualquer método baseado em distâncias ou penalidades, a coluna com os maiores números domina | Fare vai de 0 a 512, SibSp de 0 a 8 |
| texto | não existe aritmética com "female" | Sex, Embarked, Cabin, Ticket, Name |
| buracos | a maioria das implementações recusa NaN; as que aceitam descartam a linha inteira | Age falta em 19,9% dos passageiros, Cabin em 77,1% |
Esta aula trata deles nesta ordem: escala, forma (colunas assimétricas), codificação e imputação, cada um medido em exemplos pequenos que dá para conferir na calculadora e depois na lista de passageiros do Titanic (891 passageiros da viagem de 1912, uma linha cada). A EDA era sobre olhar uma tabela; esta aula é sobre mudá-la. Uma regra atravessa tudo: cada etapa de pré-processamento aprende algo com os dados (uma média, uma mediana, uma lista de categorias) e precisa aprender só com as linhas de treino. A próxima aula, Pipelines, transforma essa regra em código que não se quebra por descuido.
Nada disso precisa de modelo (e nenhum foi ensinado ainda). O único que aparece é um classificador k-NN no fim do lab, usado como caixa-preta, com esse rótulo explícito, para mostrar que o pré-processamento muda os resultados que um modelo reporta.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Como colunas brutas viram números que um modelo usa sem ser enganado? | O que as receitas simples deixam passar e como escolher entre as alternativas? |
| conteúdo | por que escalonar, quatro escalonadores e o outlier que define a escala, ajustar só no treino, assimetria e log1p, categorias nominais e ordinais, one-hot e categorias inéditas, por que faltam valores, imputação pela média e pela mediana, a flag de ausência | escala e gradiente descendente, Box-Cox, Yeo-Johnson e quantis, one-hot e o intercepto, alta cardinalidade e target encoding, imputar a partir das outras colunas, o mapa do pré-processamento |
| lab em aula | Titanic, coluna por coluna: passos 1 a 6 | um único objeto, um modelo caixa-preta e imputadores mais espertos: passos 7 a 9 |
| ao final, você sabe | calcular à mão um z-score e um valor min-max; dizer quais modelos precisam de escala; ajustar no treino e só transformar o resto; reconhecer uma coluna assimétrica e tirar o log; fazer o one-hot de uma coluna nominal sem quebrar com uma categoria nova; prever quanto a imputação pela média encolhe uma coluna | deixar os dados escolherem uma transformação de potência; decidir quando descartar uma coluna do one-hot; codificar centenas de níveis sem vazar o alvo; imputar a partir das outras colunas e conferir o resultado; montar uma receita coluna a coluna |
Os dois labs usam o mesmo notebook do lab: baixe-o e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook). A parte fundamental vai do passo 1 ao 6; a avançada, do 7 ao 9.
Abordagem fundamental
Uma pergunta guia esta parte: como colunas brutas viram números que um modelo usa sem ser enganado? Cada resposta é medida primeiro em poucos números que dá para conferir na calculadora e depois no Titanic.
Esta parte segue um caminho em cinco etapas, desenhado abaixo: 1. escalonar, para que nenhuma coluna mande na distância por causa da unidade; 2. ajustar só no treino, a regra que todo passo obedece; 3. corrigir a forma das colunas assimétricas, o que um escalonador não faz; 4. codificar categorias como números sem inventar uma ordem; 5. imputar faltantes, depois de perguntar por que eles estão lá. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Escalonara unidade decide a distância; quatro escalonadores
- Ajustar só no treinofit uma vez nas linhas de treino, transform no resto
- Corrigir a formaassimetria; um log, não um escalonador
- Codificar categoriasordinal, one-hot, categorias inéditas
- Imputar faltantespor que falta; um valor; uma flag
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Por que escalonar atributos?
Três passageiros, à mão
Etapa 1. Considere três passageiros reais da lista do Titanic, descritos por duas colunas, idade e tarifa:
import numpy as np
import pandas as pd

url = "https://raw.githubusercontent.com/hsandmann/biblio/refs/heads/main/ml/aula04/titanic/train.csv"
df = pd.read_csv(url)
trio = df.set_index('PassengerId').loc[[1, 117, 152], ['Name', 'Age', 'Fare']]
print(trio)
                                          Name   Age   Fare
PassengerId
1                      Braund, Mr. Owen Harris  22.0   7.25
117                       Connors, Mr. Patrick  70.5   7.75
152          Pears, Mrs. Thomas (Edith Wearne)  22.0  66.60
Chame-os de A (22 anos, bilhete de terceira classe de £7,25), B (70,5 anos, bilhete igualmente barato) e C (22 anos, pagou £66,60 pela primeira classe). Qual deles está mais perto de A? A distância euclidiana soma as diferenças ao quadrado, coluna a coluna:
| par | diferença de idade | diferença de tarifa | distância |
|---|---|---|---|
| A–B | 48,5 anos | £0,50 | \(\sqrt{48{,}5^2 + 0{,}5^2} = 48{,}50\) |
| A–C | 0 anos | £59,35 | \(\sqrt{0^2 + 59{,}35^2} = 59{,}35\) |
Em unidades brutas, o senhor de 70 anos é o vizinho mais próximo de A, porque uma diferença de 48,5 anos é um número menor que uma diferença de 59,35 libras. Nada diz que um ano e uma libra deveriam pesar o mesmo; é só o que acontece quando se subtraem números brutos. Agora expresse cada coluna em desvios padrão em vez da unidade original: subtraia a média da coluna e divida pelo desvio padrão da coluna (\(z = (x - \mu)/\sigma\), calculados sobre os 714 passageiros com idade conhecida).
X = trio[['Age', 'Fare']].to_numpy()
dist = lambda a, b: np.sqrt(((a - b) ** 2).sum())
print(f"raw units:    d(A,B) = {dist(X[0], X[1]):.2f}   d(A,C) = {dist(X[0], X[2]):.2f}")

known = df.dropna(subset=['Age'])                         # os 714 passageiros com idade
mu = known[['Age', 'Fare']].mean().to_numpy()
sd = known[['Age', 'Fare']].std(ddof=0).to_numpy()
Z = (X - mu) / sd
print(f"mean {mu.round(2)}   std {sd.round(2)}")
print(f"standardized: d(A,B) = {dist(Z[0], Z[1]):.2f}   d(A,C) = {dist(Z[0], Z[2]):.2f}")
raw units:    d(A,B) = 48.50   d(A,C) = 59.35
mean [29.7  34.69]   std [14.52 52.88]
standardized: d(A,B) = 3.34   d(A,C) = 1.12
Com \(\sigma_{\text{Age}} = 14{,}52\) e \(\sigma_{\text{Fare}} = 52{,}88\), a diferença de 48,5 anos entre A e B vale \(48{,}5 / 14{,}52 = 3{,}34\) desvios padrão, enquanto a de £59,35 entre A e C vale só \(59{,}35 / 52{,}88 = 1{,}12\). Depois de padronizar, a ordem se inverte e C passa a ser o vizinho mais próximo (script da figura):
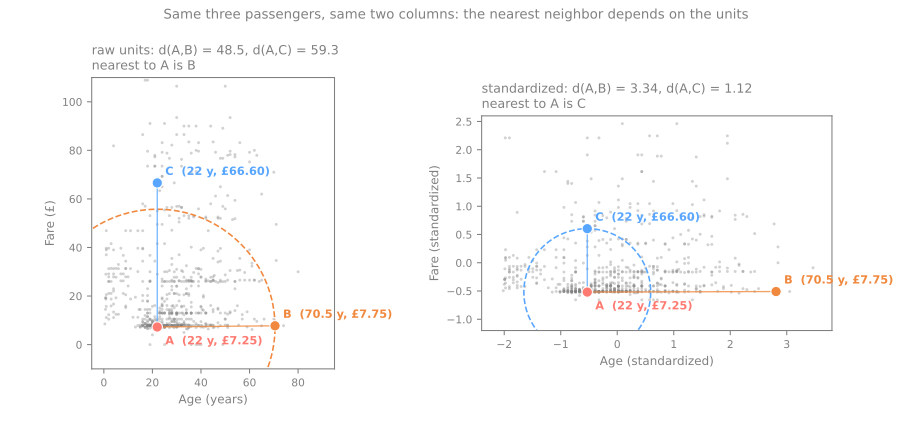
Nenhuma das duas respostas é "a verdadeira": a bruta é um acidente das unidades; a padronizada é uma escolha que dá a cada coluna o mesmo peso. O simulador torna o acidente visível. Ele mostra as mesmas quarenta pessoas e as mesmas duas colunas; a única coisa que muda é a unidade impressa em uma delas.
Deslize a unidade de milhares para centavos e veja os cinco vizinhos mais próximos do ponto vermelho virarem outros cinco. Nada mudou em ninguém. Mas o k-NN passaria a devolver outra resposta, o k-means encontraria outros grupos e a PCA apontaria a primeira componente para a coluna que por acaso carrega números maiores. É esse o sentido preciso em que métodos baseados em distância são "sensíveis à escala": o algoritmo não está lendo os atributos, está lendo as magnitudes numéricas deles. Aperte padronizar e a lista de vizinhos deixa de depender da unidade.
Qual coluna manda na distância?
O exemplo não é coincidência de três linhas. Para duas linhas sorteadas ao acaso, a diferença ao quadrado esperada numa coluna é o dobro da variância dessa coluna, então a fatia de cada coluna na distância quadrática média é a fatia dela na variância total:
Nas colunas brutas do Titanic, 92,9% da distância entre dois passageiros é diferença de tarifa, 7,0% é idade e as duas contagens de família não contribuem com nada visível. Um k-NN nas colunas brutas é, na prática, um k-NN na tarifa. Depois de padronizar, toda coluna tem variância 1 e cada uma das quatro fica com 25%.
Quais modelos se importam
- Métodos baseados em distância: k-NN, k-means, SVMs com kernel; a distância é dominada pelo atributo de maior escala.
- Métodos baseados em variância: a PCA procura direções de variância máxima, então o atributo de maior escala vence por padrão.
- Modelos treinados por gradiente e penalizados: regressão linear e logística treinadas por gradiente descendente, redes neurais e Ridge/Lasso, cuja penalidade trata todos os coeficientes como se os atributos fossem comparáveis.
- Árvores não se importam. Árvores de decisão, florestas aleatórias e gradient boosting cortam um atributo de cada vez ("
Age< 12?"). Qualquer transformação crescente de uma coluna move o limiar, mas manda as mesmas linhas para cada lado.
2. Métodos de escalonamento
Um escalonador é uma transformação linear aplicada a cada coluna separadamente, \(x' = (x - \text{centro}) / \text{espalhamento}\). Os quatro mais comuns diferem apenas nas estatísticas que usam para o centro e para o espalhamento:
| escalonador | fórmula | centro | espalhamento | resultado |
|---|---|---|---|---|
StandardScaler (padronização, z-score) | \((x - \mu) / \sigma\) | média | desvio padrão | média 0, desvio 1 |
MinMaxScaler (normalização min-max) | \((x - x_{\min}) / (x_{\max} - x_{\min})\) | mínimo | amplitude | valores em \([0, 1]\) |
RobustScaler | \((x - \text{mediana}) / \text{IQR}\) | mediana | intervalo interquartil \(Q_3 - Q_1\) | mediana 0, IQR 1 |
MaxAbsScaler | \(x / \max \lvert x \rvert\) | nenhum (0 continua 0) | maior valor absoluto | valores em \([-1, 1]\) |
À mão, numa coluna com um outlier
Cinco famílias informam a renda mensal, em milhares de reais: 1, 2, 3, 4 e 40. A quinta é um outlier. As estatísticas de que cada escalonador precisa, à mão (note que o desvio padrão do scikit-learn divide por \(n\), não por \(n-1\)):
- média \(\mu = (1+2+3+4+40)/5 = 10\); desvios \(-9, -8, -7, -6, 30\); \(\sigma = \sqrt{(81+64+49+36+900)/5} = \sqrt{226} = 15{,}03\);
- mínimo 1, máximo 40, amplitude 39;
- mediana 3; quartis \(Q_1 = 2\), \(Q_3 = 4\), logo IQR = 2;
- maior valor absoluto 40.
Aplicando as fórmulas à primeira família (renda 1): padrão \((1-10)/15{,}03 = -0{,}599\); min-max \((1-1)/39 = 0\); robusto \((1-3)/2 = -1\); max-abs \(1/40 = 0{,}025\). O scikit-learn confirma a tabela inteira:
from sklearn.preprocessing import MaxAbsScaler, MinMaxScaler, RobustScaler, StandardScaler

income = np.array([[1.], [2.], [3.], [4.], [40.]])       # milhares de R$; a última é um outlier
table = pd.DataFrame({'raw': income.ravel()})
for scaler in [StandardScaler(), MinMaxScaler(), RobustScaler(), MaxAbsScaler()]:
    table[type(scaler).__name__] = scaler.fit_transform(income).ravel()
print(table.round(3))

std = StandardScaler().fit(income)
rob = RobustScaler().fit(income)
print("StandardScaler learned mean_", std.mean_, "scale_", std.scale_.round(3))
print("RobustScaler   learned center_", rob.center_, "scale_", rob.scale_)
    raw  StandardScaler  MinMaxScaler  RobustScaler  MaxAbsScaler
0   1.0          -0.599         0.000          -1.0         0.025
1   2.0          -0.532         0.026          -0.5         0.050
2   3.0          -0.466         0.051           0.0         0.075
3   4.0          -0.399         0.077           0.5         0.100
4  40.0           1.996         1.000          18.5         1.000
StandardScaler learned mean_ [10.] scale_ [15.033]
RobustScaler   learned center_ [3.] scale_ [2.]
As estatísticas aprendidas ficam guardadas no objeto ajustado, em atributos cujo nome termina em sublinhado (mean_, scale_, center_): a convenção do scikit-learn para "aprendido com os dados".
O simulador refaz a conta inteira, uma estatística ou uma linha por passo: a média e o desvio padrão, depois o z-score e o valor min-max de cada família lado a lado, depois a mediana e o IQR do escalonador robusto e o máximo do max-abs, cada valor posto no eixo do seu escalonador. Antes de avançar, preveja qual eixo vai manter as quatro famílias comuns afastadas.
Quem define a escala
Olhe as quatro famílias comuns em cada coluna. No StandardScaler elas vão de \(-0{,}599\) a \(-0{,}399\), uma largura de 0,2; no MinMaxScaler e no MaxAbsScaler, menos de 0,08. Quem define a escala é o outlier: ele infla \(\sigma\) (15,03, contra 1,12 para os quatro valores comuns sozinhos) e ele é o máximo. No RobustScaler, mediana e IQR vêm do meio dos dados, então as famílias comuns mantêm uma largura de 1,5 e o outlier fica longe, em 18,5 (script da figura):
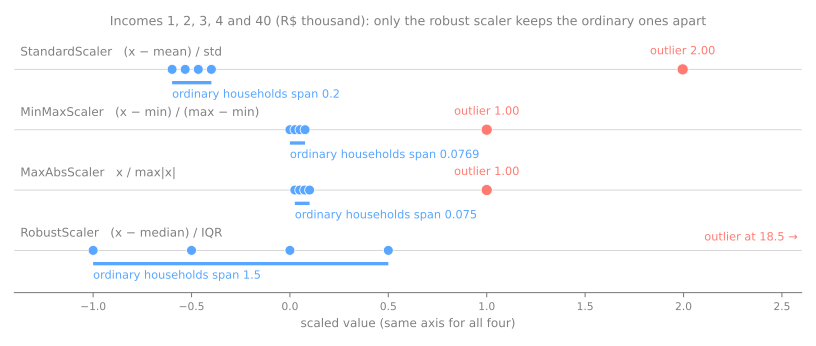
Dentro de uma única coluna, todo escalonador preserva a geometria: nas quatro versões, as famílias comuns ocupam os mesmos 8% da amplitude da coluna, porque uma transformação linear não muda proporções. O que muda é o tamanho das diferenças entre elas comparado com as outras colunas; é isso que uma distância soma. Se esta coluna de renda estiver ao lado de uma coluna de idade com desvio padrão 1, no MinMaxScaler duas famílias comuns parecem quase idênticas em renda e a idade decide tudo. O RobustScaler mantém o espalhamento comum num tamanho comparável ao de outras colunas escalonadas de forma robusta.
| escalonador | ancorado em | efeito dos outliers | uso típico |
|---|---|---|---|
StandardScaler | média, desvio | moderado: eles inflam \(\sigma\) | o padrão para modelos lineares, SVM, PCA, redes neurais |
MinMaxScaler | mínimo, máximo | forte: um único valor extremo comprime todo o resto | quando é preciso um intervalo fixo (intensidade de pixels, entradas de algumas redes neurais) |
RobustScaler | mediana, IQR | fraco: eles apenas ficam longe | colunas com outliers que você decidiu manter |
MaxAbsScaler | máx |x| | forte, como o min-max | dados esparsos: não desloca o zero, então mantém esparsa uma matriz esparsa |
Dois avisos, sobre nomes e vizinhos. Normalização é ambíguo: em ML tabular quase sempre quer dizer min-max; em estatística pode querer dizer "deixar com cara de normal". Já o Normalizer do scikit-learn é outra coisa ainda: ele reescala cada linha para ter norma 1 (usado em vetores de texto), não cada coluna. Diga qual você quer dizer ou escreva a fórmula. E um valor novo fora da amplitude do treino sai do intervalo prometido: uma renda de 80 viraria \((80-1)/39 = 2{,}03\) no escalonador min-max ajustado acima.
3. Ajuste no treino, transforme todo o resto
Etapa 2. Todo escalonador acima aprendeu alguma coisa: uma média, um desvio padrão, uma mediana, uma amplitude. Esses são parâmetros do modelo tanto quanto os pesos, então obedecem à mesma regra dos pesos: aprenda-os nas linhas de treino e depois aplique-os, congelados, a todas as outras linhas. No scikit-learn os dois momentos são métodos separados: fit aprende e guarda, transform aplica e fit_transform faz os dois nos mesmos dados.
Um exemplo mínimo: o treino tem cinco passageiros de 20 a 40 anos; mais tarde chegam dois passageiros novos, de 60 e 70 anos.
train = np.array([[20.], [25.], [30.], [35.], [40.]])
test = np.array([[60.], [70.]])

scaler = StandardScaler().fit(train)
print("learned on train: mean", scaler.mean_, "std", scaler.scale_.round(2))
print("RIGHT  transform(test):        ", scaler.transform(test).ravel().round(2))
print("WRONG  fit_transform(test):    ", StandardScaler().fit_transform(test).ravel().round(2))
print("WRONG  fit_transform(one row): ", StandardScaler().fit_transform([[70.]]).ravel())
both = np.vstack([train, test])
print("WRONG  fit before the split: mean", both.mean().round(2), "std", both.std().round(2))
learned on train: mean [30.] std [7.07]
RIGHT  transform(test):         [4.24 5.66]
WRONG  fit_transform(test):     [-1.  1.]
WRONG  fit_transform(one row):  [0.]
WRONG  fit before the split: mean 40.0 std 17.11
Leia as quatro linhas como quatro situações (script da figura):
- Certo. Com a média de treino 30 e o desvio 7,07, o passageiro de 60 anos vira \((60-30)/7{,}07 = 4{,}24\): "muito mais velho que qualquer um visto no treino", que é a verdade.
- Reajustar no teste. Um escalonador novo ajustado nas duas linhas de teste usa a média (65) e o espalhamento (5) delas e as leva a \(-1\) e \(+1\). No treino, \(-1\) significava \(30 - 7{,}07 = 22{,}9\) anos. O passageiro de 60 anos agora está codificado como alguém de 23; tudo o que o modelo aprendeu sobre pessoas de 23 anos é aplicado a ele.
- Reajustar numa única linha. Em produção, as previsões costumam chegar uma de cada vez. Um escalonador ajustado numa linha leva qualquer valor a 0, a média daquela linha: todo passageiro vira "perfeitamente médio".
- Ajustar antes da divisão. Ajustar nas sete linhas dá média 40 e desvio 17,11; as linhas de teste influenciaram os números usados para transformar as de treino. Este não produz valor absurdo. Ele vaza: informação do teste chega ao treino e a avaliação fica otimista.
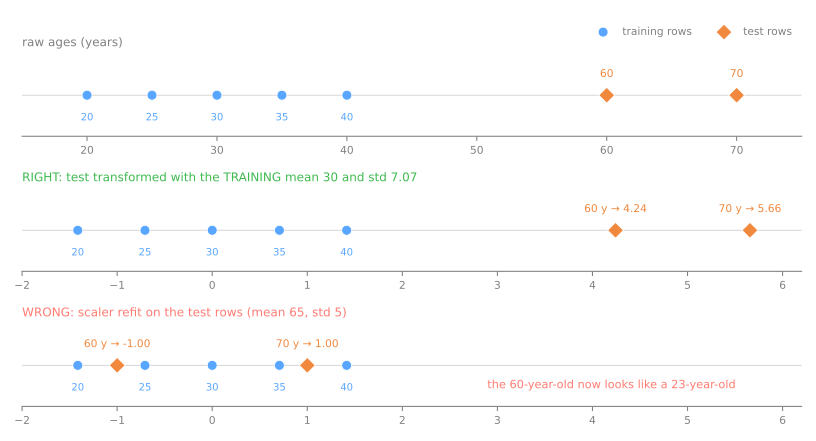
O simulador percorre as quatro situações com as contas à vista: o que cada chamada do escalonador aprende e onde os dois passageiros novos caem no eixo escalonado. Antes de cada passo, preveja se o passageiro de 60 anos ainda vai parecer mais velho que todos os do treino.
Ajuste no treino, transforme no teste
fit (ou fit_transform) é chamado uma vez, nas linhas de treino. Linhas de validação, de teste e o tráfego de produção só veem transform. Isso vale para todas as etapas desta aula: escalonadores, transformações de potência, codificadores, imputadores.
Quanto o vazamento custa depende do que a etapa aprende. Para um escalonador sobre centenas de linhas, muitas vezes quase nada: a aula de validação cruzada mede 97,9% nos dois jeitos. Para uma etapa que olha o alvo, como o target encoding da seção 11, ele pode fabricar acurácia do nada. Em vez de julgar caso a caso, torne a regra impossível de quebrar: os Pipelines empacotam cada etapa com o modelo, de modo que um único fit só toca linhas de treino.
4. Atributos assimétricos
Etapa 3. Um escalonador desloca e estica o eixo; ele não consegue mudar a forma de uma distribuição. As tarifas do Titanic têm uma cauda longa à direita: metade dos bilhetes custou menos de £14,46 e três custaram £512. A assimetria que você viu na EDA resume isso: é a média dos z-scores ao cubo, \(\frac{1}{n}\sum z_i^3\) (o pandas aplica uma correção para amostras pequenas). Vale 0 para uma distribuição simétrica e é positiva quando a cauda longa fica à direita.
fare = df[['Fare']]
print(f"zero fares: {(fare['Fare'] == 0).sum()}   median: {fare['Fare'].median()}   max: {fare['Fare'].max()}")
print(f"skewness raw            {fare['Fare'].skew():.2f}")
print(f"skewness standardized   {pd.Series(StandardScaler().fit_transform(fare).ravel()).skew():.2f}")
print(f"skewness sqrt           {np.sqrt(fare['Fare']).skew():.2f}")
print(f"skewness log1p          {np.log1p(fare['Fare']).skew():.2f}")
zero fares: 15   median: 14.4542   max: 512.3292
skewness raw            4.79
skewness standardized   4.79
skewness sqrt           2.09
skewness log1p          0.39
A assimetria bruta é 4,79 e padronizar a mantém exatamente em 4,79, como tem de ser. É preciso uma transformação não linear:
- log, \(x' = \log x\), comprime a cauda direita: multiplicações viram somas, então £8 → £80 e £50 → £500 viram passos iguais. Preços, rendas e populações costumam parecer aproximadamente normais em escala log. O Titanic tem 15 bilhetes gratuitos e \(\log 0 = -\infty\); por isso, a versão prática é \(\log(1 + x)\),
np.log1p. Ela leva a assimetria de 4,79 para 0,39. - raiz quadrada é uma compressão mais suave, usada muitas vezes para contagens. Aqui só chega a 2,09.
Alguns cuidados:
- Confira depois de transformar. Uma transformação é uma hipótese, não uma receita: o único jeito de saber que o log foi boa ideia é recalcular a assimetria (ou olhar o histograma) depois.
- Ordem: forma, depois escala. Tire o log primeiro e padronize a coluna já em log. Escalonar primeiro e tirar o log depois desfaria o escalonamento e falharia nos valores negativos que o escalonador criou.
- Quem se importa: modelos lineares e tudo o que calcula distâncias ou médias. Árvores não: o log é crescente, então manda as mesmas linhas para cada lado de qualquer limiar.
Escolher a potência à mão, como aqui, é um bom primeiro passo. A abordagem avançada deixa os dados escolherem.
5. Codificação de atributos categóricos
Etapa 4. Algoritmos precisam de números. Uma coluna categórica pode ser de três tipos, cada um com sua codificação natural:
- nominal: categorias sem ordem (porto de embarque, cor, cidade) → one-hot;
- ordinal: categorias com ordem real (classe do bilhete 1ª > 2ª > 3ª, escolaridade, tamanho P < M < G) → inteiros nessa ordem;
- binária: duas categorias (
Sex) → uma única coluna 0/1.
Códigos inteiros inventam distâncias
O atalho tentador é numerar as categorias. O OrdinalEncoder faz exatamente isso, em ordem alfabética: para os portos do Titanic, Cherbourg = 0, Queenstown = 1, Southampton = 2. Qualquer método que faça contas com esses números passa a acreditar em coisas que ninguém disse:
from sklearn.metrics import pairwise_distances
from sklearn.preprocessing import OneHotEncoder, OrdinalEncoder

ports = pd.DataFrame({'Embarked': ['C', 'Q', 'S']})
codes = OrdinalEncoder().fit_transform(ports)
onehot = OneHotEncoder(sparse_output=False).fit_transform(ports)
print("integer codes:", codes.ravel())
print(pairwise_distances(codes))
print("one-hot rows:")
print(onehot)
print(pairwise_distances(onehot).round(3))
integer codes: [0. 1. 2.]
[[0. 1. 2.]
 [1. 0. 1.]
 [2. 1. 0.]]
one-hot rows:
[[1. 0. 0.]
 [0. 1. 0.]
 [0. 0. 1.]]
[[0.    1.414 1.414]
 [1.414 0.    1.414]
 [1.414 1.414 0.   ]]
Com códigos inteiros, Queenstown fica "entre" Cherbourg e Southampton; Cherbourg–Southampton fica "duas vezes mais longe" que Cherbourg–Queenstown. Com one-hot, cada porto ganha uma coluna própria e os três pares ficam à mesma distância \(\sqrt{1^2 + 1^2} = 1{,}414\): sem ordem, sem par preferido (script da figura).
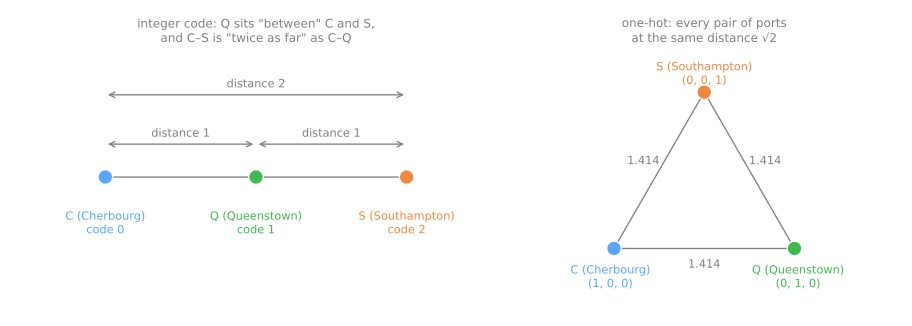
O simulador codifica os três portos uma linha de cada vez, primeiro como códigos inteiros e depois como vetores one-hot, e calcula todas as distâncias entre pares nas duas codificações. Preveja as três distâncias do one-hot antes do passo que as calcula.
Um modelo linear é enganado de outro jeito. Ele dá um único coeficiente à coluna inteira, então o efeito de ir do código 0 para o 1 é obrigado a ser igual ao de ir do 1 para o 2. As taxas de sobrevivência por porto mostram o quanto isso é falso:
De C para Q a sobrevivência cai 16,4 pontos, de Q para S mais 5,3; uma única inclinação sobre os códigos não representa os dois degraus. Além disso, com outro alfabeto (ou outra língua), a ordem dos códigos mudaria, levando junto a inclinação. O one-hot dá a cada porto o seu coeficiente. As árvores são de novo a exceção: uma árvore pode cortar em 0,5 e depois em 1,5, isolando cada código numa folha, então códigos inteiros são aceitáveis (e mais compactos) para modelos de árvore.
Codificação ordinal: você declara a ordem
Quando a ordem é real, inteiros são a codificação certa, desde que você dê a ordem. O alfabeto não entende de escolaridade:
levels = pd.DataFrame({'education': ['high school', 'master', 'bachelor', 'high school']})
print(OrdinalEncoder().fit(levels).categories_)
enc = OrdinalEncoder(categories=[['high school', 'bachelor', 'master']])
print(enc.fit_transform(levels).ravel())
Por padrão, as categorias são ordenadas alfabeticamente, o que põe high school (ensino médio) entre bachelor (graduação) e master (mestrado). Com categories= explícito, os códigos seguem a ordem real (0, 1, 2). O Pclass do Titanic já vem guardado como 1, 2, 3 numa ordem com sentido; tratá-lo como ordinal (uma coluna) ou nominal (três colunas one-hot) é uma escolha de modelagem: a versão ordinal supõe que ir da 1ª para a 2ª classe importa tanto quanto ir da 2ª para a 3ª.
One-hot: categorias inéditas
Um OneHotEncoder ajustado conhece as categorias que viu no fit e, por padrão, recusa qualquer outra. Suponha que as linhas de treino só tenham S, C e Q e que depois apareça um passageiro que embarcou em Belfast (B):
train_ports = pd.DataFrame({'Embarked': ['S', 'C', 'S', 'Q', 'S', 'C']})
new = pd.DataFrame({'Embarked': ['Q', 'B']})              # 'B' nunca apareceu no treino

enc = OneHotEncoder(sparse_output=False).fit(train_ports)
try:
    enc.transform(new)
except ValueError as e:
    print("default:", e)

enc = OneHotEncoder(sparse_output=False, handle_unknown='ignore').fit(train_ports)
print(enc.get_feature_names_out())
print(enc.transform(new))
default: Found unknown categories ['B'] in column 0 during transform
['Embarked_C' 'Embarked_Q' 'Embarked_S']
[[0. 1. 0.]
 [0. 0. 0.]]
No padrão, um único valor inédito derruba a previsão. Com handle_unknown='ignore', o porto desconhecido vira só zeros, o que diz honestamente "nenhuma das categorias que conheço". Isso é comum na prática: uma categoria rara pode simplesmente não cair na divisão de treino.
O OneHotEncoder tem uma segunda opção, drop='first', que remove uma coluna por variável; a seção 10 mostra quais modelos precisam dela.
6. Imputação de valores faltantes
Por que falta?
Etapa 5. A aula de EDA apresentou os três mecanismos (Rubin, 1976). Eles decidem o que um conserto pode e não pode fazer:
| mecanismo | o que significa | exemplo no Titanic |
|---|---|---|
| MCAR, ausência completamente aleatória | a chance de faltar não depende de nada | os 2 Embarked faltantes, plausivelmente |
| MAR, ausência aleatória condicional | depende de outras colunas observadas | Age, que falta muito mais na 3ª classe |
| MNAR, ausência não aleatória | depende do próprio valor que falta | Cabin: passageiros sem cabine própria |
print(df['Age'].isna().groupby(df['Pclass']).mean().round(3))
print(df.groupby(df['Age'].isna())['Survived'].mean().round(3))
Pclass
1    0.139
2    0.060
3    0.277
Name: Age, dtype: float64
Age
False    0.406
True     0.294
Name: Survived, dtype: float64
A idade falta em 27,7% dos passageiros da terceira classe e em 6,0% dos da segunda, o que é evidência contra MCAR. E quem não tem idade registrada sobreviveu menos (29,4% contra 40,6%). Os dois fatos pesam na escolha a seguir.
Descartar linhas ou colunas
O dropna() remove todo passageiro com algum valor faltante. Isso só é aceitável quando pouquíssimas linhas são afetadas e a ausência é MCAR. Para Age custaria 177 linhas (19,9%) e, como as linhas faltantes se concentram na 3ª classe, os dados restantes sub-representariam justamente os passageiros que mais morreram. Descartar uma coluna é a decisão certa quando a ausência é a regra e não a exceção, como no Cabin bruto (77,1% faltante), embora mesmo ali dê para extrair a letra do deck e manter "desconhecido" como categoria própria.
Preencher com um único valor encolhe a variância
O SimpleImputer preenche cada coluna com uma estatística aprendida nas linhas de treino: mean (média), median (mediana, mais segura para colunas assimétricas), most_frequent (a moda, a única que funciona com texto) ou uma constant (por exemplo "unknown"). É rápido e simples, mas sempre faz a mesma coisa com a distribuição: empilha todas as linhas faltantes num único valor, o que encolhe o espalhamento. À mão, em seis valores dos quais dois faltam:
from sklearn.impute import SimpleImputer

x = np.array([[2.], [4.], [np.nan], [6.], [np.nan], [8.]])
filled = SimpleImputer(strategy='mean').fit_transform(x)
print(filled.ravel())
print(f"variance of the 4 observed values: {np.nanvar(x):.3f}")
print(f"variance after mean imputation:    {filled.var():.3f}   ratio {filled.var() / np.nanvar(x):.3f}")
[2. 4. 5. 6. 5. 8.]
variance of the 4 observed values: 5.000
variance after mean imputation:    3.333   ratio 0.667
Os valores observados têm média 5 e variância \((9+1+1+9)/4 = 5\). Os dois 5 imputados não somam nada aos desvios ao quadrado, mas somam à contagem, então a variância vira \(20/6 = 3{,}33\): multiplicada por \(4/6\), a fração de valores observados. É uma lei geral da imputação pela média. No Titanic, 714 das 891 idades são observadas, então o desvio padrão deveria encolher por \(\sqrt{713/890} = 0{,}895\) (na convenção \(n-1\) que o pandas usa):
age = df[['Age']]
filled = SimpleImputer(strategy='mean').fit_transform(age).ravel()
n_obs, n = age['Age'].notna().sum(), len(age)
print(f"std observed {age['Age'].std():.2f}   after mean imputation {filled.std(ddof=1):.2f}   "
      f"predicted {age['Age'].std() * np.sqrt((n_obs - 1) / (n - 1)):.2f}")
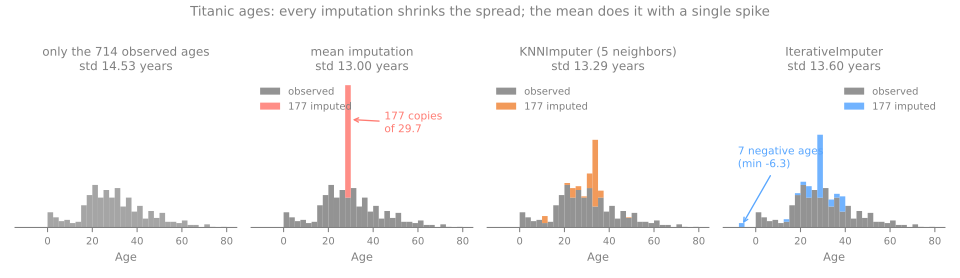
De 14,53 para 13,00 anos, exatamente como previsto. O modelo agora acredita que as idades são mais homogêneas do que são; 177 passageiros dividem uma mesma idade inventada, 29,7.
O simulador repete o exemplo dos seis valores passo a passo: o que o imputador aprende (fit), o que ele escreve nos buracos (transform) e por que a variância cai para exatamente 4/6 do que era. O último passo aplica a mesma regra às idades de treino do lab. Preveja a nova variância antes do passo que a calcula.
Guarde o fato de que faltava
A imputação apaga uma informação: quais valores foram inventados. E no Titanic a idade faltante anda junto com menor sobrevivência (29,4% contra 40,6%). O add_indicator=True acrescenta uma coluna 0/1 que registra isso, para que um modelo possa usar a própria ausência:
imp = SimpleImputer(strategy='median', add_indicator=True)
out = imp.fit_transform(df[['Age']])
print(imp.get_feature_names_out())
print(out[[0, 5]])                                        # o passageiro 1 tem idade, o 6 não
A flag custa uma coluna e deixa o modelo decidir se a ausência informa algo. Para colunas categóricas, o equivalente é uma categoria própria (SimpleImputer(strategy='constant', fill_value='unknown')), muitas vezes melhor que a moda.
Nunca impute o alvo
Linhas com alvo faltante saem do treino supervisionado. Inventar rótulos fabrica um sinal que não existe.
7. Resumo: o pré-processamento em seis linhas
- As unidades decidem as distâncias por acidente. Escalone o que distâncias, variâncias e penalidades usam; árvores não se importam.
- Escalonadores diferem no centro e no espalhamento. Padrão (média, desvio padrão), min-max (mínimo, amplitude), robusto (mediana, IQR) e max-abs; um outlier define a escala de todos menos o robusto.
- Ajuste no treino, transforme todo o resto. Toda etapa aprende números e só os aprende com as linhas de treino.
- Um escalonador não muda a forma. Uma cauda longa à direita pede uma transformação não linear como o
log1p; confira a assimetria depois. - One-hot para nominais, ordem declarada para ordinais. Códigos inteiros inventam distâncias;
handle_unknown='ignore'impede que uma categoria nova derrube a previsão. - Pergunte por que falta; preencher encolhe o espalhamento. A imputação pela média ou pela mediana multiplica a variância pela fração observada;
add_indicator=Trueguarda o fato de que o valor faltava.
| sintoma | o que está acontecendo | o que fazer |
|---|---|---|
| uma coluna decide todos os vizinhos | a unidade dá a ela os maiores números | padronizar (ou escalonar de forma robusta) as colunas numéricas |
| colunas de teste escalonadas com média exatamente 0 e desvio exatamente 1 | o escalonador foi ajustado nas linhas de teste | ajustar no treino; no teste, só transform |
| a assimetria não muda depois de escalonar | uma transformação linear não muda a forma | np.log1p, depois escalonar |
| o codificador quebra com uma categoria nova | ele só conhece as categorias vistas no fit | OneHotEncoder(handle_unknown='ignore') |
| centenas de linhas dividem um mesmo valor imputado | a imputação pela média ou pela mediana as empilha | guardar uma flag de ausência; a parte avançada imputa a partir das outras colunas |
Lab fundamental — preparando o Titanic, coluna por coluna
A lista de passageiros do Titanic, do CSV bruto até uma matriz numérica sem buracos, sem texto e com escalas comparáveis. Toda escolha é medida; toda estatística é aprendida só nas linhas de treino. Esta parte faz o inventário, divide os dados, pergunta por que falta a idade, imputa-a, codifica as categorias e escalona os números; empacotar tudo num único objeto e medir o que o pré-processamento muda num modelo fica para o lab avançado.
Como fazer este lab em aula (cerca de 30 min, em duplas)
- Baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook). Rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 6 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 7.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 a 3 em 8 min; passo 4 e a primeira simulação em 10 min; passos 5 e 6 e a segunda simulação em 12 min.
Passo 1 — carregar e fazer o inventário
Preveja. Antes de olhar: que colunas de uma lista de passageiros você espera que tenham buracos? Quais são texto e quais números não são de fato quantidades?
import numpy as np
import pandas as pd

url = "https://raw.githubusercontent.com/hsandmann/biblio/refs/heads/main/ml/aula04/titanic/train.csv"
df = pd.read_csv(url)
print(df.shape)
inventory = pd.DataFrame({'numeric': [pd.api.types.is_numeric_dtype(df[c]) for c in df.columns],
                          'missing': df.isna().sum(),
                          'distinct': df.nunique()})
print(inventory)
(891, 12)
             numeric  missing  distinct
PassengerId     True        0       891
Survived        True        0         2
Pclass          True        0         3
Name           False        0       891
Sex            False        0         2
Age             True      177        88
SibSp           True        0         7
Parch           True        0         7
Ticket         False        0       681
Fare            True        0       248
Cabin          False      687       147
Embarked       False        2         3
891 passageiros, 12 colunas. A primeira tarefa é decidir o que cada coluna é, o que nem sempre coincide com o que o pandas guardou:
Survivedé o alvo. Nunca entra na matriz de atributos.PassengerIdé um identificador, um número de linha. Se ficar, um modelo pode achar cortes sem sentido nele. Sai.Age,SibSp,ParcheFaresão quantidades numéricas.Sex(binária),Embarked(nominal, 3 portos) ePclasssão categóricas.Pclassestá guardada como número (numeric: True), mas 1, 2 e 3 são rótulos de uma categoria ordenada, não uma quantidade.Name(891 valores distintos),Ticket(681) eCabin(147; 687 faltantes) são quase identificadores: inúteis como estão, mas escondem estrutura (um título, um deck). Este lab os deixa de fora; a Sua vez do lab avançado extrai o título.
Três colunas têm buracos: Age (177), Cabin (687) e Embarked (2).
Passo 2 — dividir antes de qualquer coisa
Preveja. A divisão vem antes de qualquer imputação ou escalonamento. O que daria errado se você calculasse a mediana das idades nos 891 passageiros e só depois dividisse?
from sklearn.model_selection import train_test_split

features = ['Pclass', 'Sex', 'Age', 'SibSp', 'Parch', 'Fare', 'Embarked']
X, y = df[features], df['Survived']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=42)
print(X_train.shape, X_test.shape)
print("missing in train:", X_train.isna().sum()[lambda s: s > 0].to_dict())
print("missing in test: ", X_test.isna().sum()[lambda s: s > 0].to_dict())
A divisão vem antes de qualquer estatística, porque cada passo a seguir aprende algo (uma mediana, uma moda, uma média e um desvio padrão) e precisa aprender só com os 712 passageiros de treino. É a mesma divisão que o lab de regressão logística vai usar mais adiante: 20% para o teste, estratificada pela sobrevivência. O teste tem 40 idades faltantes e nenhum porto faltante; os dois Embarked faltantes caíram nas linhas de treino.
Passo 3 — por que falta a idade?
Preveja. Você espera que a idade falte com a mesma frequência nas três classes? E descartar os passageiros sem idade mudaria a cara do treino?
missing = X_train['Age'].isna()
print("share of missing Age by class:", missing.groupby(X_train['Pclass']).mean().round(3).to_dict())
print("survival rate, Age present / missing:", y_train.groupby(missing).mean().round(3).to_dict())
kept = X_train.dropna(subset=['Age'])
print(f"dropna keeps {len(kept)} of {len(X_train)} rows; "
      f"3rd-class share {(X_train['Pclass'] == 3).mean():.3f} -> {(kept['Pclass'] == 3).mean():.3f}")
share of missing Age by class: {1: 0.152, 2: 0.06, 3: 0.261}
survival rate, Age present / missing: {False: 0.405, True: 0.292}
dropna keeps 575 of 712 rows; 3rd-class share 0.549 -> 0.503
Olhando só as linhas de treino: a idade falta em 26,1% dos passageiros da terceira classe, contra 6,0% na segunda e 15,2% na primeira. A ausência depende de uma coluna observada, então não é MCAR. E ela também se relaciona com o desfecho: 29,2% dos passageiros sem idade sobreviveram, contra 40,5% dos outros. Descartar essas linhas manteria 575 dos 712 passageiros e reduziria a fatia da terceira classe de 54,9% para 50,3%: o treino deixaria de se parecer com o navio e o sinal da idade faltante sumiria. Em vez disso, imputamos e mantemos a opção de uma flag de ausência (Sua vez do lab avançado, exercício 1).
Passo 4 — comparar estratégias de imputação para a idade
Preveja. Depois de preencher 137 buracos com um único valor, o desvio padrão das idades sobe, fica igual ou cai? Que idade vai virar a mais frequente?
from sklearn.impute import SimpleImputer

cols = ['Age', 'Pclass', 'SibSp', 'Parch']
imputers = {'mean': SimpleImputer(strategy='mean'),
            'median': SimpleImputer(strategy='median')}
observed = X_train['Age'].dropna()
rows = {'observed only': [len(observed), observed.mean(), observed.std(), observed.min(),
                          observed.value_counts().iloc[0]]}
for name, imp in imputers.items():
    ages = pd.Series(imp.fit(X_train[cols]).transform(X_train[cols])[:, 0])
    rows[name] = [len(ages), ages.mean(), ages.std(), ages.min(), ages.value_counts().iloc[0]]
print(pd.DataFrame(rows, index=['n', 'mean', 'std', 'min', 'largest pile']).T.round(2))
                   n   mean    std   min  largest pile
observed only  575.0  29.81  14.49  0.42          26.0
mean           712.0  29.81  13.02  0.42         137.0
median         712.0  29.56  13.03  0.42         139.0
Cada imputador é ajustado nas linhas de treino (fit) e aplicado a elas (transform); os mesmos objetos ajustados depois transformam as linhas de teste, cujas 40 idades faltantes recebem a média ou a mediana do treino, nunca uma estatística do teste. Como ler a tabela:
- observed only: as 575 idades reais, desvio padrão 14,49 anos; a idade mais frequente (22) aparece 26 vezes.
- mean e median: 137 passageiros empilhados num único valor (29,81 ou 28,5; a pilha da mediana tem 139 porque dois passageiros reais têm exatamente 28,5) e o desvio padrão cai para 13,02, que é \(14{,}49 \times \sqrt{574/711}\), a lei de encolhimento da seção 6.
Nenhum dos dois recupera 14,49: preencher com um único valor sempre encolhe o espalhamento. No resto deste lab usamos a mediana, a escolha robusta mais simples. O passo 9, no lab avançado, testa dois imputadores que olham as outras colunas.
Simulação: a lei do encolhimento, em buracos que você faz. Pegue as 575 idades reais das linhas de treino e apague 20%, 50% e 80% delas ao acaso (MCAR). Preencha os buracos com a média e compare o desvio padrão com a lei da seção 6, o desvio padrão das idades que ficaram vezes \(\sqrt{(n_{\text{ficaram}} - 1)/(n - 1)}\). A lei vale todas as vezes? Quanto a coluna preenchida se afasta dos 14,49 das idades reais?
Solução
rng = np.random.default_rng(0)
real = X_train['Age'].dropna()                                  # as 575 idades que temos
print(f"all 575 real ages: std {real.std():.2f}")
for erase in [0.2, 0.5, 0.8]:
    holed = real.copy()
    holed[rng.random(len(real)) < erase] = np.nan               # apaga idades ao acaso (MCAR)
    filled = SimpleImputer(strategy='mean').fit_transform(holed.to_frame()).ravel()
    n_kept = holed.notna().sum()
    law = holed.std() * np.sqrt((n_kept - 1) / (len(holed) - 1))
    print(f"erase {erase:.0%}: {n_kept} ages kept, std {holed.std():.2f} · after mean imputation "
          f"{filled.std(ddof=1):.2f} · law {law:.2f}")
all 575 real ages: std 14.49
erase 20%: 463 ages kept, std 14.65 · after mean imputation 13.15 · law 13.15
erase 50%: 285 ages kept, std 13.98 · after mean imputation 9.83 · law 9.83
erase 80%: 120 ages kept, std 13.62 · after mean imputation 6.20 · law 6.20
A lei vale até a segunda casa decimal todas as vezes: 13,15, 9,83 e 6,20. Apagar ao acaso deixa o espalhamento das idades que ficaram perto do real (14,65, 13,98 e 13,62, contra 14,49), que é o que MCAR quer dizer. A coluna preenchida é outra história: o desvio padrão dela cai a cada buraco e, com 80% apagados, ela reporta 6,20, menos da metade do espalhamento real. Quanto mais buracos, mais um único valor preenchido mente sobre a coluna.
Passo 5 — codificar Sex, Embarked e Pclass
Preveja. Três colunas categóricas com 2, 3 e 3 níveis: viram quantas colunas one-hot? E quantos 1s cada linha vai ter?
from sklearn.preprocessing import OneHotEncoder

cat_cols = ['Sex', 'Embarked', 'Pclass']
cat_imp = SimpleImputer(strategy='most_frequent').set_output(transform='pandas')
cats_train = cat_imp.fit_transform(X_train[cat_cols])            # aprende as modas no treino
cats_test = cat_imp.transform(X_test[cat_cols])
print("modes learned on train:", cat_imp.statistics_)

ohe = OneHotEncoder(handle_unknown='ignore', sparse_output=False).fit(cats_train)
print(ohe.get_feature_names_out())
print(X_test[cat_cols].head(3).to_numpy().tolist())
print(ohe.transform(cats_test.head(3)))
modes learned on train: ['male' 'S' 3]
['Sex_female' 'Sex_male' 'Embarked_C' 'Embarked_Q' 'Embarked_S' 'Pclass_1'
 'Pclass_2' 'Pclass_3']
[['male', 'S', 3], ['male', 'S', 3], ['male', 'C', 3]]
[[0. 1. 0. 0. 1. 0. 0. 1.]
 [0. 1. 0. 0. 1. 0. 0. 1.]
 [0. 1. 1. 0. 0. 0. 0. 1.]]
As modas são aprendidas nas linhas de treino: male, S e 3, então os dois portos faltantes viram Southampton. O one-hot transforma as 3 colunas em 8 (2 sexos + 3 portos + 3 classes), com nomes coluna_valor. Cada linha tem exatamente três 1s, um por coluna original: o primeiro passageiro de teste é um homem que embarcou em Southampton na terceira classe; o terceiro embarcou em Cherbourg. Duas escolhas foram feitas aqui. Pclass é tratada como nominal (três colunas, sem supor que a 2ª classe fica exatamente no meio entre a 1ª e a 3ª). E handle_unknown='ignore' faz com que uma categoria nunca vista no treino vire zeros em vez de derrubar o transform. Não há drop='first': o modelo caixa-preta do passo 8 calcula distâncias; para distâncias, toda categoria deve manter a própria coluna.
Passo 6 — escalonar as colunas numéricas
Preveja. Em unidades brutas, que coluna numérica vai mandar na distância entre dois passageiros? E, depois de escalonar com as estatísticas do treino, as colunas de teste terão média exatamente 0?
from sklearn.preprocessing import StandardScaler

num_cols = ['Age', 'SibSp', 'Parch', 'Fare']
num_imp = SimpleImputer(strategy='median').set_output(transform='pandas').fit(X_train[num_cols])
num_train, num_test = num_imp.transform(X_train[num_cols]), num_imp.transform(X_test[num_cols])
scaler = StandardScaler().set_output(transform='pandas').fit(num_train)
z_train, z_test = scaler.transform(num_train), scaler.transform(num_test)

share = lambda M: (100 * M.var() / M.var().sum()).round(1)     # fatia da distância quadrática
print(pd.DataFrame({'raw %': share(num_train), 'scaled %': share(z_train)}))
print(pd.DataFrame({'train mean': z_train.mean(), 'train std': z_train.std(ddof=0),
                    'test mean': z_test.mean(), 'test std': z_test.std(ddof=0)}).round(3))
       raw %  scaled %
Age      6.8      25.0
SibSp    0.0      25.0
Parch    0.0      25.0
Fare    93.1      25.0
       train mean  train std  test mean  test std
Age           0.0        1.0     -0.036     0.995
SibSp        -0.0        1.0      0.141     1.178
Parch        -0.0        1.0     -0.053     0.791
Fare         -0.0        1.0      0.040     1.160
A primeira tabela é o argumento da variância, da aula, em dados reais: nas unidades brutas, a tarifa responde por 93,1% da distância quadrática entre dois passageiros, a idade por 6,8% e as contagens de família por nada visível. Depois de escalonar, cada coluna contribui com 25%.
A segunda tabela torna visível a regra do ajuste no treino. Nas linhas de treino, toda média é 0 e todo desvio padrão é 1, por construção. Nas de teste, não: as médias vão de \(-0{,}053\) a 0,141 e os desvios de 0,791 a 1,178, porque os passageiros de teste foram transformados com as estatísticas do treino. Essa imperfeição é o resultado correto. Se as colunas de teste saíssem com média exatamente 0 e desvio exatamente 1, o escalonador teria sido ajustado nelas.
Simulação: de quem são os vizinhos? Pegue o primeiro passageiro de teste e encontre os 5 passageiros de treino mais próximos dele nas quatro colunas numéricas, uma vez em unidades brutas (num_train, num_test) e outra escalonadas (z_train, z_test). Quantos passageiros aparecem nas duas listas? O que os vizinhos de cada lista têm em comum?
Solução
from sklearn.metrics import pairwise_distances

first = X_test.index[0]                                         # o primeiro passageiro de teste
print("test passenger", first, num_test.loc[first].to_dict())
nearest = {}
for name, A, q in [('raw', num_train, num_test.loc[[first]]), ('scaled', z_train, z_test.loc[[first]])]:
    d = pairwise_distances(q, A).ravel()
    nearest[name] = A.index[np.argsort(d)[:5]]                  # os 5 passageiros de treino mais próximos
    print(f"{name} units, 5 nearest:")
    print(num_train.loc[nearest[name]].to_string())
print("in both lists:", len(set(nearest['raw']) & set(nearest['scaled'])))
test passenger 565 {'Age': 24.0, 'SibSp': 2.0, 'Parch': 0.0, 'Fare': 24.15}
raw units, 5 nearest:
      Age  SibSp  Parch  Fare
316  24.0    1.0    0.0  26.0
600  24.0    2.0    1.0  27.0
312  26.0    1.0    1.0  26.0
551  27.0    0.0    0.0  26.0
874  28.0    1.0    0.0  24.0
scaled units, 5 nearest:
      Age  SibSp  Parch     Fare
330  28.5    2.0    0.0  23.2500
301  28.5    2.0    0.0  23.2500
48   28.5    2.0    0.0  21.6792
69   26.0    2.0    0.0   8.6625
392  28.0    2.0    0.0   7.9250
in both lists: 0
O passageiro de teste tem 24 anos, viaja com 2 irmãos ou cônjuge e sem pais e pagou £24,15. Em unidades brutas, os cinco vizinhos pagaram entre £24 e £27, mas as contagens de família variam (de 0 a 2 irmãos, dois deles com um dos pais): quem os escolheu foi a tarifa. Escalonados, os cinco viajam com exatamente 2 irmãos e sem pais, com idades de 26 a 28,5, enquanto as tarifas vão de £7,93 a £23,25: agora toda coluna tem voz. Nenhum passageiro está nas duas listas. E três dos vizinhos escalonados têm exatamente 28,5 anos: a idade deles faltava e recebeu a mediana do treino, um lembrete de que valores imputados entram em toda distância.
Para fechar a parte fundamental. Em uma frase cada: (1) por que um k-NN nas colunas brutas do Titanic é, na prática, um k-NN na tarifa? (2) De onde vem a mediana do passo 4 e o que recebem as idades faltantes dos passageiros de teste? (3) Por que as colunas de teste escalonadas no passo 6 não têm exatamente média 0 e desvio padrão 1? Por que isso está certo?
Sua vez (fundamental)
Para casa:
- Outro escalonador. Refaça o passo 6 com o
RobustScalerno lugar doStandardScaler. Imprima oscale_: que colunas ficam com espalhamento exatamente 1? Por quê, em cada caso? Como mudam as fatias da distância quadrática? - A forma da tarifa. Calcule a assimetria de
X_train['Fare'], denp.log1p(X_train['Fare'])e da coluna em log depois de umStandardScaler. Que etapa muda a forma e qual não muda? - Pclass como ordinal. No passo 5, tire
Pclassdo one-hot e mantenha-a como uma única coluna (1, 2, 3). Quantas colunas a codificação produz agora? O que essa escolha supõe sobre as três classes?
Abordagem avançada
A parte fundamental preparou cada coluna com a ferramenta correta mais simples. Esta parte pergunta o que essas ferramentas deixam passar e como escolher entre as alternativas: por que o gradiente descendente também quer atributos escalonados, como deixar os dados escolherem uma transformação de potência, por que um modelo linear engasga com um one-hot completo, o que fazer com centenas de categorias sem vazar o alvo e como as outras colunas podem preencher um buraco. Os blocos de código continuam os das seções 1 a 6.
Esta parte segue um caminho em cinco etapas, desenhado abaixo: 1. escalonar para o gradiente; 2. escolher a potência; 3. codificar para o modelo; 4. imputar pelas outras colunas; 5. montar a receita. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Escalonar para o gradientea curvatura da perda; uma só taxa de aprendizado
- Escolher a potênciaBox-Cox, Yeo-Johnson, quantis
- Codificar para o modeloa coluna descartada; centenas de níveis; target encoding
- Imputar pelas outras colunas
KNNImputer,IterativeImputer; conferir os valores - Montar a receitao mapa, coluna a coluna
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
8. Escala e gradiente descendente
Etapa 1. A escala importa por um segundo motivo, que você vai encontrar em Gradiente Descendente. O gradiente descendente desce uma superfície de perda; com uma perda quadrática, a curvatura dessa superfície em cada direção é dada pela variância dos atributos. Quando um atributo tem números muito maiores que outro, a tigela vira um vale comprido e estreito: uma taxa de aprendizado pequena o bastante para não ultrapassar o fundo na direção íngreme se arrasta na direção plana. A razão entre a maior e a menor curvatura mede o quanto o vale é alongado:
A = known[['Age', 'Fare']].to_numpy()
for name, M in [('raw', A - A.mean(0)), ('standardized', (A - A.mean(0)) / A.std(0))]:
    curv = np.linalg.eigvalsh(M.T @ M / len(M))           # curvaturas de uma perda quadrática
    print(f"{name:13s} curvatures {curv.round(2)}   ratio {curv.max() / curv.min():.1f}")
Com idade e tarifa nas unidades brutas, o vale é 13,4 vezes mais curvo numa direção que na outra; depois de padronizar, a razão é 1,2 (o resto vem da pequena correlação entre idade e tarifa). Uma tigela quase redonda é o que permite ao gradiente descendente usar uma só taxa de aprendizado para todos os pesos.
9. Deixe os dados escolherem a potência
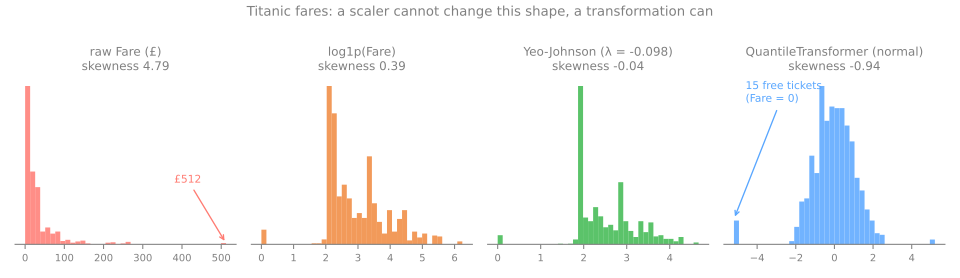
Etapa 2. A seção 4 escolheu a transformação à mão: um log ou uma raiz quadrada. Em vez de escolher a potência à mão, o Box-Cox (Box & Cox, 1964) a estima a partir dos dados. É uma família indexada por \(\lambda\), \(x' = (x^\lambda - 1)/\lambda\), com \(\lambda = 0\) significando \(\log x\). O PowerTransformer escolhe o \(\lambda\) que deixa o resultado o mais próximo possível de uma normal (por máxima verossimilhança). O Box-Cox exige valores estritamente positivos. O Yeo-Johnson (Yeo & Johnson, 2000) estende a família para zero e valores negativos; para \(x \ge 0\) ele é o Box-Cox aplicado a \(x + 1\), então \(\lambda = 0\) é exatamente o log1p. O QuantileTransformer vai além: troca cada valor pelo seu posto (o seu quantil) e leva o posto para uma distribuição normal (ou uniforme), forçando qualquer forma a virar a forma-alvo.
from sklearn.preprocessing import PowerTransformer, QuantileTransformer

try:
    PowerTransformer(method='box-cox').fit(fare)
except ValueError as e:
    print("Box-Cox on all fares:", e)
bc = PowerTransformer(method='box-cox', standardize=False).fit(fare[fare['Fare'] > 0])
print(f"Box-Cox on the 876 positive fares: lambda = {bc.lambdas_[0]:.3f}")

yj = PowerTransformer(method='yeo-johnson', standardize=False).fit(fare)
print(f"Yeo-Johnson: lambda = {yj.lambdas_[0]:.3f}   skewness {pd.Series(yj.transform(fare).ravel()).skew():.2f}")

qt = QuantileTransformer(n_quantiles=100, output_distribution='normal').fit(fare)
fare_q = qt.transform(fare).ravel()
print(f"Quantile (normal): skewness {pd.Series(fare_q).skew():.2f}   "
      f"the 15 free tickets all map to {fare_q.min():.2f}")
Box-Cox on all fares: The Box-Cox transformation can only be applied to strictly positive data
Box-Cox on the 876 positive fares: lambda = -0.524
Yeo-Johnson: lambda = -0.098   skewness -0.04
Quantile (normal): skewness -0.94   the 15 free tickets all map to -5.20
O Box-Cox recusa a coluna de cara por causa das tarifas zero. O Yeo-Johnson escolhe \(\lambda = -0{,}098\), perto de 0, ou seja, os dados basicamente pediram um log, um pouco mais forte. A assimetria cai para \(-0{,}04\). A transformação por quantis é a mais agressiva e ainda termina em \(-0{,}94\): postos não conseguem separar empates, então os 15 bilhetes gratuitos se empilham em \(-5{,}20\), o fundo da sua escala (script da figura):
Alguns cuidados:
- \(\lambda\) e os quantis são aprendidos, então as transformações de potência e por quantis seguem a regra do ajuste no treino como qualquer escalonador. (Acima olhamos a coluna inteira, como numa EDA. Num modelo, elas são ajustadas nas linhas de treino.)
- Forma, depois escala, embutido. O
PowerTransformerpadroniza a saída por padrão (standardize=True), pelo motivo dado na seção 4. - A transformação por quantis guarda só a ordem. A distância em libras entre duas tarifas deixa de importar; importa só quantos passageiros ficam entre elas. É útil para colunas extremamente irregulares, mas deve ser usada com cuidado.
10. One-hot para modelos lineares: a coluna descartada
Etapa 3. A seção 5 manteve todas as colunas do one-hot. Outra opção do OneHotEncoder, drop='first', remove uma coluna por variável. Eis por que ela existe. Num one-hot completo, as colunas de uma variável sempre somam 1 (todo passageiro embarcou em algum lugar), que é exatamente a coluna constante que o intercepto de um modelo linear multiplica:
full = OneHotEncoder(sparse_output=False).fit_transform(train_ports)
first = OneHotEncoder(sparse_output=False, drop='first').fit_transform(train_ports)
ones = np.ones((len(train_ports), 1))                     # a coluna que o intercepto multiplica
print("row sums of the full one-hot:", full.sum(axis=1))
print("rank of [intercept | full one-hot]  :", np.linalg.matrix_rank(np.hstack([ones, full])),
      "for", 1 + full.shape[1], "columns")
print("rank of [intercept | drop='first']  :", np.linalg.matrix_rank(np.hstack([ones, first])),
      "for", 1 + first.shape[1], "columns")
row sums of the full one-hot: [1. 1. 1. 1. 1. 1.]
rank of [intercept | full one-hot]  : 3 for 4 columns
rank of [intercept | drop='first']  : 3 for 3 columns
Quatro colunas com posto 3 significa que uma coluna é combinação das outras (intercepto = C + Q + S): os pesos de um modelo linear deixam de ser únicos, já que somar 5 aos três pesos de porto e subtrair 5 do intercepto dá as mesmas previsões. Descartar uma categoria (a primeira, C, vira a referência) restaura o posto completo; cada coeficiente restante passa a ser lido "em comparação com Cherbourg". O lab de regressão logística, mais adiante no curso, usa exatamente isso. A regra prática:
drop='first'para modelos lineares com intercepto e sem penalidade, quando você quer ler os coeficientes;- mantenha todas as colunas para árvores, k-NN e modelos regularizados: descartar uma categoria torna a referência especial (para uma distância, "referência" e "desconhecida" viram o mesmo vetor de zeros).
11. Alta cardinalidade e target encoding
Portos e sexos têm dois ou três níveis. Bilhetes, cabines e nomes têm centenas; aí o one-hot deixa de ser uma opção.
Alta cardinalidade
O número de valores distintos decide o que é razoável:
for col in ['Sex', 'Embarked', 'Pclass', 'Cabin', 'Ticket', 'Name']:
    print(f"{col:9s} {df[col].nunique():4d} distinct values")

title = df['Name'].str.extract(r',\s*([^.]+)\.')[0].to_frame('title')
print(title['title'].value_counts().head(5).to_dict(), '...', title['title'].nunique(), 'titles')
enc = OneHotEncoder(min_frequency=10, sparse_output=False).fit(title)
print(enc.get_feature_names_out())
Sex          2 distinct values
Embarked     3 distinct values
Pclass       3 distinct values
Cabin      147 distinct values
Ticket     681 distinct values
Name       891 distinct values
{'Mr': 517, 'Miss': 182, 'Mrs': 125, 'Master': 40, 'Dr': 7} ... 17 titles
['title_Master' 'title_Miss' 'title_Mr' 'title_Mrs'
 'title_infrequent_sklearn']
Com 2 ou 3 níveis, o one-hot é trivial. Um one-hot em Ticket criaria 681 colunas quase só de zeros para 891 linhas: mais colunas que informação e sobreajuste garantido. Antes de codificar uma coluna de alta cardinalidade, procure a estrutura escondida dentro dela: a primeira letra de Cabin é o deck (8 níveis) e Name contém um título (Mr, Miss, Mrs, Master, ...) que codifica sexo, idade aproximada e estado civil de uma vez. Depois agrupe os níveis raros: min_frequency=10 mantém os quatro títulos que aparecem pelo menos 10 vezes e junta os outros 13 numa única coluna infrequent.
Target encoding e por que ele vaza
Para colunas com centenas de níveis há uma opção mais compacta: trocar cada categoria pela média do alvo naquela categoria (Micci-Barreca, 2001). Um bilhete compartilhado por três passageiros, dos quais dois sobreviveram, vira 0,667. É uma coluna só, qualquer que seja a cardinalidade. É também a codificação mais perigosa desta aula, porque é construída a partir do próprio alvo.
Para ver o perigo, construa uma coluna sem informação nenhuma: 2.000 passageiros, cada um com um de 800 números de bilhete aleatórios e um rótulo de sobrevivência sorteado no cara ou coroa. Codifique-a com a média ingênua por categoria (calculada nas linhas de treino) e teste a regra mais simples possível, "prever sobreviveu se o valor codificado passar de 0,5":
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import TargetEncoder

rng = np.random.default_rng(0)
noise = pd.DataFrame({'ticket': rng.integers(0, 800, 2000).astype(str),   # 800 bilhetes aleatórios
                      'survived': rng.integers(0, 2, 2000)})             # cara ou coroa
tr, te = train_test_split(noise, test_size=0.3, random_state=0)
rule = lambda enc, y: ((enc > 0.5) == y).mean()                          # "sobreviveu se > 0,5"

means = tr.groupby('ticket')['survived'].mean()                          # target encoding ingênuo
naive_tr = tr['ticket'].map(means)
naive_te = te['ticket'].map(means).fillna(tr['survived'].mean())
print(f"naive:        train {rule(naive_tr, tr['survived']):.3f}   test {rule(naive_te, te['survived']):.3f}")

te_enc = TargetEncoder(random_state=0)
cf_tr = te_enc.fit_transform(tr[['ticket']], tr['survived']).ravel()     # com cross-fitting
cf_te = te_enc.transform(te[['ticket']]).ravel()
print(f"cross-fitted: train {rule(cf_tr, tr['survived']):.3f}   test {rule(cf_te, te['survived']):.3f}")
Em puro ruído, a codificação ingênua "explica" 77,5% dos rótulos de treino, mas cai para o acaso (50,5%) em linhas novas. O mecanismo: a maioria dos bilhetes aparece uma ou duas vezes, então o valor codificado de uma linha é, em boa parte, o próprio rótulo dela. Qualquer modelo treinado nessa coluna aprende a ler a resposta, não a prevê-la. O TargetEncoder do scikit-learn evita isso com cross-fitting: o fit_transform divide as linhas de treino em folds e codifica cada fold com médias calculadas nos outros folds, de modo que nenhuma linha vê o próprio rótulo; ele também puxa a média das categorias raras em direção à média global. O acerto dele no treino fica no nível do acaso, como deve ser.
Daí saem duas regras. Nunca calcule um target encoding em dados que incluem as linhas em que você avalia. E use-o via fit_transform no treino (que faz o cross-fitting), depois transform no teste. A aula de validação cruzada trata dessa família de erros em geral. Duas outras opções compactas, sem o alvo: codificação por frequência (trocar a categoria por quantas vezes ela aparece) e hashing (um número fixo de colunas, colisões aceitas).
12. Imputar a partir das outras colunas
Etapa 4. A seção 6 preencheu cada buraco com um único valor. Sob MAR, as outras colunas carregam informação sobre o valor que falta. Dois imputadores a usam:
- O
KNNImputer(Troyanskaya et al., 2001) encontra as \(k\) linhas mais parecidas com a incompleta (medindo a distância só nas colunas que as duas têm) e tira a média dos valores delas. Como calcula distâncias, ele precisa de escalas comparáveis, exatamente como o k-NN. - O
IterativeImputermodela cada coluna incompleta como uma regressão sobre as outras, preenche com as previsões e percorre as colunas algumas vezes. É a versão do scikit-learn do procedimento MICE (van Buuren & Groothuis-Oudshoorn, 2011), ainda marcada como experimental; por isso, precisa de um import extra.
O KNNImputer à mão, em cinco passageiros reais, um dos quais (Mr. James Moran, tarifa £8,46) não tem idade:
from sklearn.impute import KNNImputer

toy = df.loc[[0, 1, 2, 3, 5], ['Age', 'Fare']]
print(toy)
print("KNNImputer (k=2):", KNNImputer(n_neighbors=2).fit_transform(toy)[-1])
print("mean imputation: ", SimpleImputer(strategy='mean').fit_transform(toy)[-1])
    Age     Fare
0  22.0   7.2500
1  38.0  71.2833
2  26.0   7.9250
3  35.0  53.1000
5   NaN   8.4583
KNNImputer (k=2): [24.      8.4583]
mean imputation:  [30.25    8.4583]
As diferenças de tarifa em relação a £8,46 são 1,2, 62,8, 0,5 e 44,6, então os dois passageiros mais próximos são os que pagaram £7,925 e £7,25, com 26 e 22 anos; a média deles, 24, é a idade imputada. O imputador pela média ignora a tarifa e responde 30,25. (Aqui só uma coluna entra na distância, então a escala dela não importa; com várias colunas, importaria.)
Na coluna inteira, usando classe, irmãos e pais como as outras colunas:
from sklearn.experimental import enable_iterative_imputer  # noqa: F401  (libera o IterativeImputer)
from sklearn.impute import IterativeImputer

cols = df[['Age', 'Pclass', 'SibSp', 'Parch']]
for name, imp in [('KNNImputer', KNNImputer(n_neighbors=5)),
                  ('IterativeImputer', IterativeImputer(random_state=0)),
                  ('Iterative, min_value=0', IterativeImputer(random_state=0, min_value=0))]:
    ages = imp.fit_transform(cols)[:, 0]
    print(f"{name:23s} std {ages.std(ddof=1):.2f}   min {ages.min():6.2f}   negative ages {(ages < 0).sum()}")
KNNImputer              std 13.29   min   0.42   negative ages 0
IterativeImputer        std 13.60   min  -6.26   negative ages 7
Iterative, min_value=0  std 13.48   min   0.00   negative ages 0
Os dois espalham os valores imputados em vez de empilhá-los (desvio padrão 13,29 e 13,60, contra 13,00 da média e 14,53 das idades observadas), porque um passageiro com três irmãos na 3ª classe recebe um palpite mais jovem que um viajante sozinho da 1ª. Nenhum imputador recupera o espalhamento original: a informação se perdeu na coleta. E o imputador baseado em regressão produziu 7 idades negativas, todas para os filhos de uma mesma família que viajava com 8 irmãos: a regressão estende a tendência "mais irmãos, passageiro mais jovem" para além do zero, porque não sabe que idade é positiva. min_value=0 remove os valores impossíveis, mas só cortando-os: esses 7 passageiros agora são imputados como recém-nascidos. Uma regressão sobre classe e contagens de família é um modelo grosseiro de idade; conferir os valores imputados faz parte do trabalho (script da figura).
13. O mapa do pré-processamento
Etapa 5. Tudo junto, coluna a coluna. Por coluna, nesta ordem: ausentes → forma → escala. O escalonador deve aprender suas estatísticas com a coluna como o modelo vai recebê-la, buracos preenchidos e forma corrigida; um log aplicado depois de escalonar desfaria o escalonamento (e falharia nos valores negativos). Toda etapa é ajustada só nas linhas de treino.
| situação | transformação | por quê |
|---|---|---|
| numérica, aproximadamente simétrica | StandardScaler | uma unidade comum para todas as colunas |
| numérica, com outliers que você mantém | RobustScaler | mediana e IQR ignoram os extremos |
| é preciso um intervalo fixo | MinMaxScaler | saída em \([0, 1]\), mas um outlier comprime o resto |
| matriz esparsa | MaxAbsScaler | zeros continuam zeros |
| cauda longa à direita, valores ≥ 0 | np.log1p ou PowerTransformer('yeo-johnson') | comprime a cauda; confira a assimetria depois |
| qualquer forma, precisa parecer normal/uniforme | QuantileTransformer | força a forma; perde empates e distâncias |
| nominal, poucos níveis | OneHotEncoder(handle_unknown='ignore') | sem ordem inventada; categorias inéditas não derrubam |
| nominal, modelo linear com intercepto | OneHotEncoder(drop='first') | remove a coluna redundante; categoria de referência |
| ordinal | OrdinalEncoder(categories=[...]) | inteiros na ordem que você declara |
| nominal, centenas de níveis | extrair estrutura, min_frequency, TargetEncoder | menos colunas; target encoding só com cross-fitting |
| numérica com poucos buracos | SimpleImputer('median') + add_indicator=True | preenchimento robusto; o fato de faltar fica guardado |
| numérica, ausência que depende de outras colunas | KNNImputer (entradas escalonadas) ou IterativeImputer | usa as outras colunas; confira os valores imputados |
| categórica com buracos | SimpleImputer('most_frequent') ou 'constant' | uma categoria própria guarda a informação |
Quais famílias se importam com qual etapa:
| família de modelos | escala | forma | codificação | valores faltantes |
|---|---|---|---|---|
| k-NN, k-means, SVM, PCA | obrigatória | ajuda | one-hot | precisam ser imputados |
| regressão linear/logística, redes neurais | obrigatória (gradiente descendente, penalidades) | ajuda | one-hot, drop='first' se não houver penalidade | precisam ser imputados |
| árvores de decisão, florestas aleatórias, gradient boosting | desnecessária | desnecessária | códigos ordinais servem | as árvores, florestas e o HistGradientBoosting do scikit-learn aceitam NaN diretamente |
Lab avançado — um único objeto, um modelo caixa-preta e imputadores mais espertos
O lab fundamental construiu a matriz com quatro objetos ajustados separadamente. Esta parte os junta num só, usa um classificador k-NN como caixa-preta (a aula de k-NN vem mais adiante no curso) para mostrar que o pré-processamento muda o resultado que um modelo reporta e testa os imputadores que usam as outras colunas. Continue no mesmo notebook, na mesma sessão: os passos abaixo usam X_train, X_test, num_cols, cat_cols, cols e rows dos passos 1 a 6.
Como fazer este lab em aula (cerca de 25 min, em duplas)
- Continue no notebook do lab, a partir do passo 7. Se a sessão caiu, rode antes as células dos passos 1 a 6.
- Como no lab fundamental: Preveja antes de rodar, compare com esta página e tente as Simulações antes de abrir a solução.
- Ritmo sugerido: passo 7 em 5 min; passo 8 e a primeira simulação em 10 min; passo 9 e a segunda simulação em 10 min.
Passo 7 — tudo num único objeto: uma prévia do ColumnTransformer
Preveja. Os passos 5 e 6 usaram quatro objetos ajustados. Juntos num só, quantas colunas terá a saída? Vai sobrar algum NaN nas linhas de teste?
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import make_pipeline

preprocess = ColumnTransformer([
    ('num', make_pipeline(SimpleImputer(strategy='median'), StandardScaler()), num_cols),
    ('cat', make_pipeline(SimpleImputer(strategy='most_frequent'),
                          OneHotEncoder(handle_unknown='ignore')), cat_cols)])
M_train = preprocess.fit_transform(X_train)       # toda estatística é aprendida aqui, só no treino
M_test = preprocess.transform(X_test)             # ... e só aplicada aqui
print(M_train.shape, M_test.shape, "NaN left in test:", int(np.isnan(M_test).sum()))
print(preprocess.get_feature_names_out())
print(M_test[:2].round(2))
(712, 12) (179, 12) NaN left in test: 0
['num__Age' 'num__SibSp' 'num__Parch' 'num__Fare' 'cat__Sex_female'
 'cat__Sex_male' 'cat__Embarked_C' 'cat__Embarked_Q' 'cat__Embarked_S'
 'cat__Pclass_1' 'cat__Pclass_2' 'cat__Pclass_3']
[[-0.43  1.42 -0.47 -0.16  0.    1.    0.    0.    1.    0.    0.    1.  ]
 [ 1.11 -0.47  0.73 -0.33  0.    1.    0.    0.    1.    0.    0.    1.  ]]
Os passos 5 e 6 precisaram de quatro objetos ajustados (dois imputadores, um codificador e um escalonador) e cada um tinha de ser ajustado nas linhas certas. Um ColumnTransformer encaminha cada lista de colunas pela sua própria cadeia (mediana e escalonamento para os números; moda e one-hot para as categorias) e põe os resultados lado a lado. Uma chamada a fit_transform nas linhas de treino aprende todas as estatísticas; transform aplica todas elas às linhas de teste. O resultado tem 12 colunas (4 numéricas + 8 do one-hot), nenhum NaN e nenhum texto; os nomes carregam o ramo que as produziu (num__, cat__). O primeiro passageiro de teste é o mesmo do passo 5: num__Age = \(-0{,}43\) (um pouco mais novo que o passageiro médio); depois vem o bloco one-hot 0 1 | 0 0 1 | 0 0 1: homem, Southampton, terceira classe.
Isto é uma prévia. A próxima aula trata de Pipeline e ColumnTransformer com calma: como acoplar um modelo no fim, inspecionar cada etapa ajustada e deixar a validação cruzada reajustar a cadeia inteira em cada fold.
Passo 8 — faz diferença? Um k-NN caixa-preta com e sem escalonamento
Preveja. O baseline que sempre responde "não sobreviveu" acerta 61,5%. Um k-NN em colunas não escalonadas fica muito acima disso? Quanto o escalonamento acrescenta?
from sklearn.dummy import DummyClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import MinMaxScaler, RobustScaler

baseline = DummyClassifier(strategy='most_frequent').fit(X_train, y_train)
print(f"baseline (always 'did not survive')   test accuracy {baseline.score(X_test, y_test):.3f}")
for name, scaler in [('no scaling', 'passthrough'), ('StandardScaler', StandardScaler()),
                     ('MinMaxScaler', MinMaxScaler()), ('RobustScaler', RobustScaler())]:
    prep = ColumnTransformer([
        ('num', make_pipeline(SimpleImputer(strategy='median'), scaler), num_cols),
        ('cat', make_pipeline(SimpleImputer(strategy='most_frequent'),
                              OneHotEncoder(handle_unknown='ignore')), cat_cols)])
    knn = make_pipeline(prep, KNeighborsClassifier(n_neighbors=5)).fit(X_train, y_train)
    print(f"k-NN (black box), {name:15s}     test accuracy {knn.score(X_test, y_test):.3f}")
baseline (always 'did not survive')   test accuracy 0.615
k-NN (black box), no scaling          test accuracy 0.676
k-NN (black box), StandardScaler      test accuracy 0.821
k-NN (black box), MinMaxScaler        test accuracy 0.804
k-NN (black box), RobustScaler        test accuracy 0.771
O classificador aqui é uma caixa-preta: um k-NN prevê o desfecho de um passageiro por uma votação entre os 5 passageiros de treino mais próximos dele (a aula de k-NN o explica mais adiante no curso). A única coisa que muda entre as quatro linhas é o escalonador das colunas numéricas; dados, imputação, codificação e modelo são idênticos.
- O baseline que sempre responde "não sobreviveu" acerta 61,5% dos passageiros de teste. Qualquer modelo precisa superar isso.
- Sem escalonamento, o k-NN chega a 67,6%, pouco acima do baseline: os vizinhos são escolhidos quase só pela tarifa (93,1% da distância, passo 6) e as colunas de sexo e classe, que valem 0 ou 1, mal contam.
- Com StandardScaler, 82,1%: 14,5 pontos a mais, com o mesmo modelo e os mesmos dados.
- MinMaxScaler dá 80,4% e RobustScaler 77,1%. O escalonador robusto deixa os extremos longe, como foi projetado para fazer: ajustado nestas linhas de treino, uma tarifa de £512 vira 21,5 e 8 irmãos viram 8, enquanto as colunas one-hot continuam em 0 ou 1, então alguns passageiros extremos voltam a ser dominados pela tarifa e pelo tamanho da família.
Dois cuidados. Com 179 passageiros de teste, cada um vale 0,56 ponto, então as diferenças entre escalonadores (alguns passageiros) não são um ranking confiável; escolher entre eles se faz em dados de validação ou com validação cruzada, nunca testando várias versões no conjunto de teste, como foi feito aqui só para ilustrar. Já a diferença entre escalonar e não escalonar é grande e se repete com outras divisões aleatórias.
Simulação: forma antes da escala. A tarifa é a coluna mais assimétrica. Dê a ela um ramo próprio no transformador de colunas: mediana, depois FunctionTransformer(np.log1p), depois StandardScaler, com as outras colunas numéricas no ramo de sempre. A assimetria das tarifas de treino cai? O k-NN do passo 8 melhora?
Solução
from sklearn.preprocessing import FunctionTransformer

rest = ['Age', 'SibSp', 'Parch']
logfare = ColumnTransformer([
    ('num', make_pipeline(SimpleImputer(strategy='median'), StandardScaler()), rest),
    ('fare', make_pipeline(SimpleImputer(strategy='median'), FunctionTransformer(np.log1p),
                           StandardScaler()), ['Fare']),                 # forma, depois escala
    ('cat', make_pipeline(SimpleImputer(strategy='most_frequent'),
                          OneHotEncoder(handle_unknown='ignore')), cat_cols)])
knn_log = make_pipeline(logfare, KNeighborsClassifier(n_neighbors=5)).fit(X_train, y_train)
fares = num_train['Fare']
print(f"skewness of the training fares: raw {fares.skew():.2f} · log1p {np.log1p(fares).skew():.2f}")
print("share of the squared distance, log1p(Fare) unscaled:",
      share(num_train.assign(Fare=np.log1p(fares))).to_dict())
print(f"k-NN, log1p(Fare) then StandardScaler   test accuracy {knn_log.score(X_test, y_test):.3f}")
skewness of the training fares: raw 4.65 · log1p 0.31
share of the squared distance, log1p(Fare) unscaled: {'Age': 98.4, 'SibSp': 0.7, 'Parch': 0.4, 'Fare': 0.6}
k-NN, log1p(Fare) then StandardScaler   test accuracy 0.782
O log faz com a forma o que a seção 4 prometeu: a assimetria das tarifas de treino cai de 4,65 para 0,31. A linha do meio mostra por que o escalonador ainda precisa vir depois: sem escala, as tarifas em log variam tão pouco que a idade passaria a responder por 98,4% da distância. Mas o k-NN piora: 0,782 contra 0,821, 7 passageiros em 179. Uma transformação é uma hipótese, não uma melhora por definição; aqui a cauda longa das tarifas ajuda a separar os passageiros da primeira classe; comprimi-la aproxima os bilhetes caros dos baratos. Uma única divisão de 179 passageiros não decide a questão para nenhum dos lados: só a validação decide.
Passo 9 — imputadores que usam as outras colunas
Preveja. Um imputador que olha a classe e o tamanho da família: as idades imputadas por ele se espalham mais ou menos que as da mediana? Ele pode produzir uma idade impossível?
O passo 4 comparou imputadores que usam um único valor. A seção 12 apresentou dois que usam as outras colunas; este passo ajusta os dois nas linhas de treino e os acrescenta à mesma tabela (cols e rows vêm do passo 4):
from sklearn.experimental import enable_iterative_imputer  # noqa: F401
from sklearn.impute import IterativeImputer, KNNImputer

others = {'knn': KNNImputer(n_neighbors=5),
          'iterative': IterativeImputer(random_state=0, min_value=0)}
for name, imp in others.items():
    ages = pd.Series(imp.fit(X_train[cols]).transform(X_train[cols])[:, 0])
    rows[name] = [len(ages), ages.mean(), ages.std(), ages.min(), ages.value_counts().iloc[0]]
print(pd.DataFrame(rows, index=['n', 'mean', 'std', 'min', 'largest pile']).T.round(2))
                   n   mean    std   min  largest pile
observed only  575.0  29.81  14.49  0.42          26.0
mean           712.0  29.81  13.02  0.42         137.0
median         712.0  29.56  13.03  0.42         139.0
knn            712.0  29.99  13.36  0.42          75.0
iterative      712.0  29.54  13.46  0.00          75.0
- knn e iterative usam a classe e as contagens de família, então as idades imputadas variam de passageiro para passageiro e o espalhamento encolhe menos que com a média ou a mediana (13,36 e 13,46, contra 13,02). A maior pilha deles é de 75: muitos passageiros incompletos têm classe e contagens de família idênticas e, por isso, recebem imputações idênticas. Com
min_value=0, o imputador iterativo não produz mais idades negativas, mas o mínimo de 0,00 diz que alguns passageiros foram cortados para recém-nascidos.
Nenhum recupera 14,49. Qual deles leva a um modelo melhor só se mede com um modelo e um procedimento de validação.
Simulação: um imputador mais esperto dentro do pipeline. No ramo numérico do pipeline do passo 8 (com StandardScaler), troque a mediana por KNNImputer(n_neighbors=5), uma vez em unidades brutas e outra entre dois escalonadores (o imputador mede distâncias, então a seção 12 diz que ele precisa de escalas comparáveis). A acurácia de teste do k-NN melhora?
Solução
branches = {'median, then scale': make_pipeline(SimpleImputer(strategy='median'), StandardScaler()),
            'KNNImputer on raw units, then scale': make_pipeline(KNNImputer(n_neighbors=5),
                                                                 StandardScaler()),
            'scale, KNNImputer, scale again': make_pipeline(StandardScaler(), KNNImputer(n_neighbors=5),
                                                            StandardScaler())}
for name, branch in branches.items():
    ct = ColumnTransformer([('num', branch, num_cols),
                            ('cat', make_pipeline(SimpleImputer(strategy='most_frequent'),
                                                  OneHotEncoder(handle_unknown='ignore')), cat_cols)])
    model = make_pipeline(ct, KNeighborsClassifier(n_neighbors=5)).fit(X_train, y_train)
    print(f"{name:37s} test accuracy {model.score(X_test, y_test):.3f}")
median, then scale                    test accuracy 0.821
KNNImputer on raw units, then scale   test accuracy 0.810
scale, KNNImputer, scale again        test accuracy 0.799
Nenhuma das versões supera a mediana simples: 0,821, 0,810 e 0,799, uma diferença de 2 e 4 passageiros de teste, dentro do ruído de um teste com 179 passageiros. O imputador que guarda mais do espalhamento (tabela acima) não faz o melhor modelo aqui; a versão escalonada ainda fica em último. Imputar é uma escolha de modelagem como qualquer outra: escolhe-se com validação; a opção robusta mais simples é um padrão forte.
Para fechar a aula. Em uma frase cada: (1) o que um ColumnTransformer garante que quatro objetos ajustados separadamente não garantem? (2) Por que um log que corrige a forma da tarifa ainda pode piorar o k-NN? (3) Por que um imputador que guarda mais do espalhamento não dá necessariamente um modelo melhor?
Sua vez (avançado)
Para casa, com mais tempo:
- A flag de ausência. Use
SimpleImputer(strategy='median', add_indicator=True)no ramo numérico. Quantas colunas a saída tem agora? Qual é o nome da nova? O k-NN do passo 8 muda? - Títulos. Extraia o título de
Name(df['Name'].str.extract(r',\s*([^.]+)\.')), acrescente-o aos atributos e acat_cols; codifique-o comOneHotEncoder(handle_unknown='ignore', min_frequency=10). Depois imputeAgecom a mediana de idade de cada título, aprendida nas linhas de treino (groupby('Title')['Age'].median()). O que isso dá aos meninos com título Master cuja idade falta (3 deles nas linhas de treino), em comparação com a mediana global de 28,5? - O vazamento, em números. Ajuste
preprocessnas 891 linhas em vez deX_train. Compare a mediana de idade aprendida e a média e o desvio padrão da tarifa (preprocess.named_transformers_['num']) com a versão ajustada só no treino. Qual estatística se move mais? Por que é justamente a que depende de poucas linhas extremas?
Material de aula
Roteiro completo de transformação — Titanic (em português)
Material de referência de 3 h partindo dos dados faltantes: mecanismos MCAR / MAR / MNAR com evidência empírica, diagrama de decisão de técnicas por tipo de variável, escalonamento e transformação de forma, codificação de categóricas, vazamento medido em quatro cenários e um exercício de aula em sete checkpoints que constrói a matriz de atributos sem usar modelo algum.
Referências
- Box, G. E. P.; Cox, D. R. "An Analysis of Transformations." Journal of the Royal Statistical Society B 26, n. 2 (1964): 211–252 — a família Box-Cox e a escolha de \(\lambda\) por máxima verossimilhança. DOI
- Yeo, I.-K.; Johnson, R. A. "A New Family of Power Transformations to Improve Normality or Symmetry." Biometrika 87, n. 4 (2000): 954–959 — a extensão para zero e valores negativos. DOI
- Rubin, D. B. "Inference and Missing Data." Biometrika 63, n. 3 (1976): 581–592 — a distinção MCAR / MAR / MNAR. DOI
- Troyanskaya, O. et al. "Missing Value Estimation Methods for DNA Microarrays." Bioinformatics 17, n. 6 (2001): 520–525 — imputação pelos k vizinhos mais próximos. DOI
- van Buuren, S.; Groothuis-Oudshoorn, K. "mice: Multivariate Imputation by Chained Equations in R." Journal of Statistical Software 45, n. 3 (2011): 1–67 — o procedimento de equações encadeadas por trás do
IterativeImputer. DOI - Micci-Barreca, D. "A Preprocessing Scheme for High-Cardinality Categorical Attributes in Classification and Prediction Problems." ACM SIGKDD Explorations Newsletter 3, n. 1 (2001): 27–32 — target encoding com encolhimento em direção à média global. DOI
- Desenvolvedores do scikit-learn. "Preprocessing data" e "Imputation of missing values", scikit-learn User Guide. Pré-processamento · Imputação
Quiz
O quiz cobre a abordagem fundamental.